G1 보행 정책의 한 실험에서는 느린 명령 구간의 이동거리가 0.187m 늘었습니다. 넘어지거나 발이 교차하는 문제도 없었습니다. 숫자만 보면 정책이 좋아진 것처럼 보입니다. 하지만 같은 평가에서 경로 조건을 만족한 표본은 기준보다 187개 줄었고, 바꾸려던 팔과 다리의 형태 지표는 0.01도 움직이지 않았습니다. 결국 저는 이 체크포인트를 채택하지 않았습니다.
강화학습에서 자주 마주치는 함정이 여기에 있습니다. 보상이 증가했다는 사실과 우리가 원한 행동이 좋아졌다는 사실은 같지 않습니다. 정책은 개발자의 의도를 읽지 않습니다. 매 step에 계산되는 숫자를 키울 방법을 찾을 뿐입니다. 그 숫자가 의도를 불완전하게 대리하면, 정책은 사람의 눈에는 편법으로 보이는 경로까지 정직하게 최적화합니다.
이번 글에서는 교과서적인 보상 함수 목록보다 제가 G1 보행을 학습시키며 실제로 겪은 네 번의 판단 변화를 기록하려 합니다. 발을 들수록 손해를 보던 부호 오류, 전진보다 버티기가 유리했던 우선순위 오류, 형태 보상을 피하기 위해 경로 품질을 희생한 것으로 보이는 실험, 그리고 세 번의 정체 뒤 보상 계수 조정을 멈춘 이유입니다.
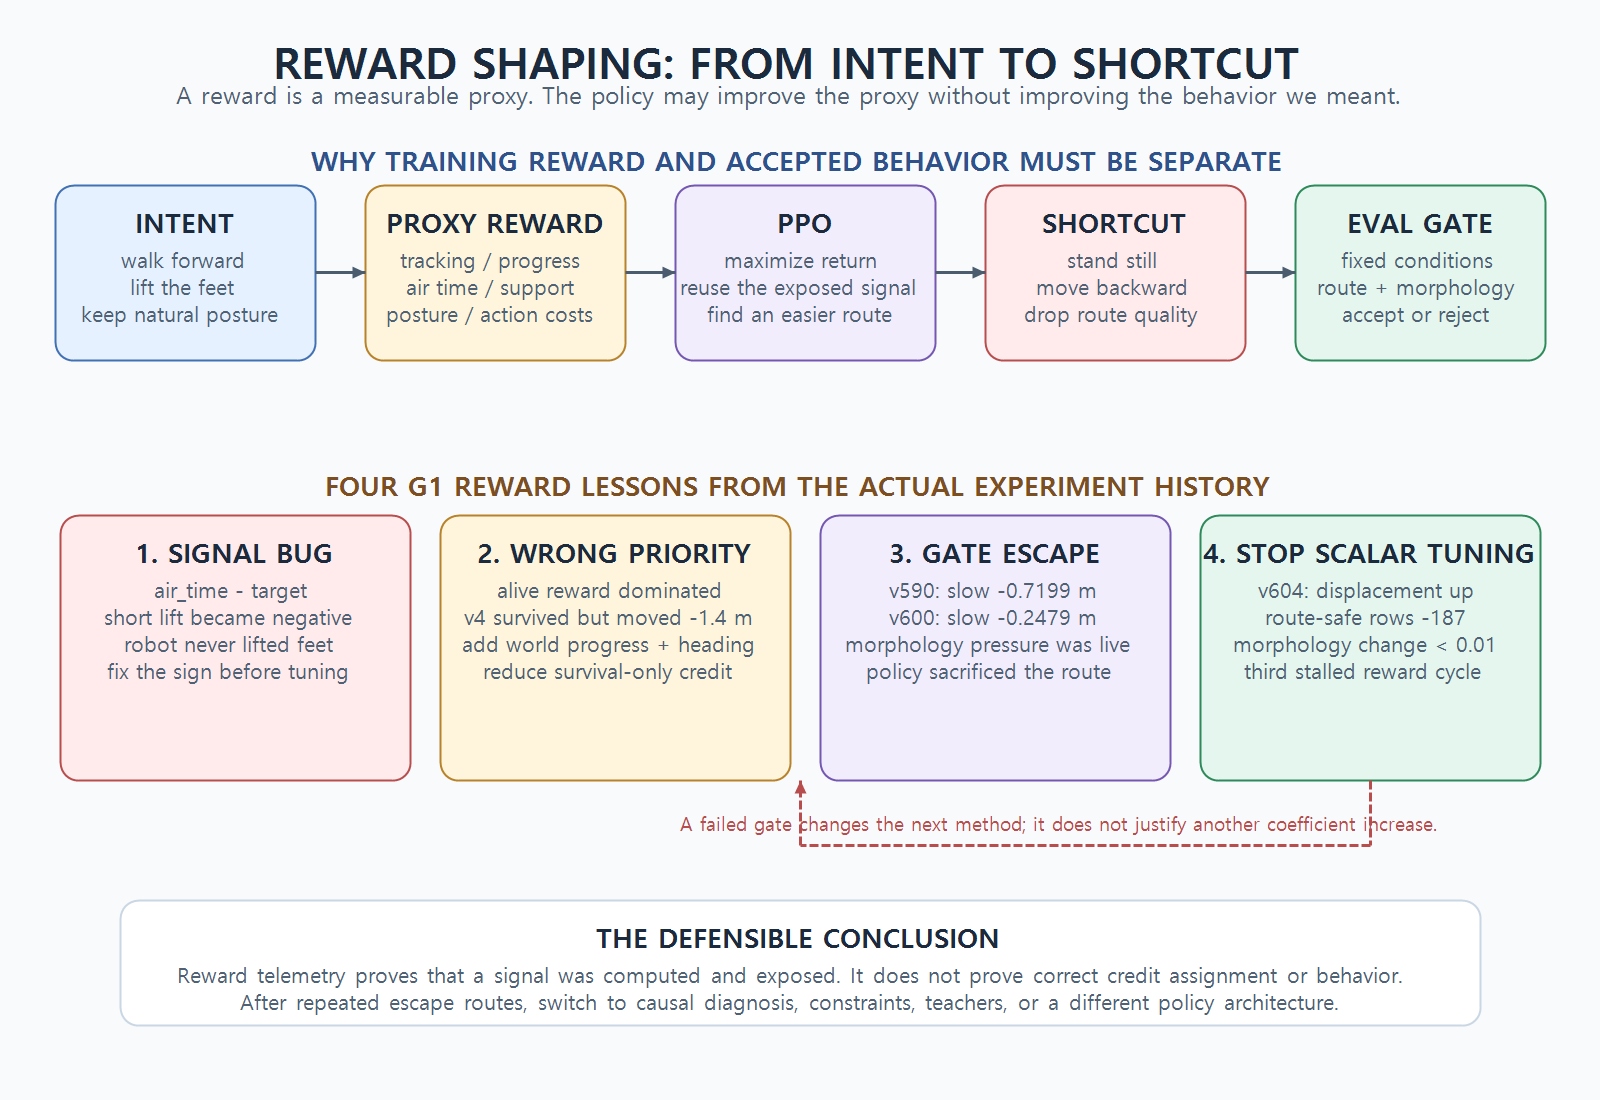
보상은 목표가 아니라 측정 가능한 대리값입니다
“자연스럽게 앞으로 걸어라”는 요구는 사람에게는 분명하지만 시뮬레이터가 바로 계산할 수 있는 값은 아닙니다. 그래서 이 문장을 여러 측정값으로 분해합니다. 명령 속도를 얼마나 잘 따라갔는지, 월드 좌표계에서 실제로 전진했는지, 몸통이 목표 방향을 향하는지, 발이 충분히 들렸는지, 발이 미끄러지지 않았는지, 관절 토크와 action 변화량이 지나치지 않은지를 각각 수치로 만듭니다.
r_t = Σ w_i · r_i(s_t, a_t, s_(t+1))r_i는 각 보상 또는 페널티 항목이고, w_i는 그 항목의 계수입니다. PPO는 여러 환경에서 수집한 rollout을 이용해 할인된 누적 보상 G_t가 커지는 방향으로 정책을 갱신합니다. 여기서 중요한 점은 PPO가 “좋은 보행”을 직접 보는 것이 아니라는 사실입니다. PPO가 보는 것은 우리가 작성한 보상식과 그 보상식이 만들어 낸 수많은 transition뿐입니다.
따라서 보상 설계에는 두 종류의 오차가 생깁니다. 첫째는 식 자체가 의도와 다르게 계산되는 신호 오류입니다. 부호, 좌표계, 단위, clipping, 조건문의 실수 등이 여기에 속합니다. 둘째는 각 항목은 올바르게 계산되지만 합쳤을 때 다른 행동이 더 유리해지는 우선순위와 신용 할당의 오류입니다. 아래의 G1 실험에서는 두 문제가 모두 나타났습니다.
첫 번째 실패: 발을 들었는데 오히려 손해를 봤습니다
초기 환경에는 발의 공중 시간을 늘리기 위한 항목이 있었습니다. 당시 식은 접촉이 발생했을 때 air_time - target_air_time을 계산했습니다. 목표 공중 시간이 0.4초라면 0.1초 동안 발을 들었다가 내려놓은 step의 값은 -0.3이 됩니다. 걷기 시작 단계에서 나오는 짧은 swing이 모두 음의 신호가 된 셈입니다.
초기 식: reward = air_time - target
0.1초 lift, target 0.4초 → -0.3

수정 방향: 실제 air_time을 양의 신호로 사용하고
목표값은 bounded shaping 또는 별도 조건으로 다룬다.
그 결과는 명확했습니다. 로봇은 발을 거의 들지 않았습니다. PPO가 이상한 것이 아니라, 발을 드는 초기 시도를 손해로 기록한 환경에 충실하게 반응한 것이었습니다. 이때 필요한 조치는 계수를 더 키우는 일이 아니었습니다. 먼저 reward term을 step 단위로 출력해 짧은 lift가 어떤 값으로 기록되는지 확인하고, 식의 부호와 기준점을 고치는 일이었습니다.
이 경험 이후 저는 보상 항목을 추가할 때 학습부터 돌리지 않습니다. 몇 개의 수동 상태를 만들어 “좋아져야 할 방향으로 상태를 바꿨을 때 값이 실제로 증가하는가”를 먼저 확인합니다. 발 높이를 올렸을 때 clearance reward가 커지는지, 뒤로 움직였을 때 backward penalty가 더 음수가 되는지, 목표 방향으로 몸을 돌렸을 때 heading 값이 좋아지는지를 작은 단위 테스트처럼 검증합니다. 보상 설계에서 가장 싼 실패는 PPO를 시작하기 전에 발견한 실패입니다.
두 번째 실패: 걷는 것보다 살아 있는 편이 유리했습니다
부호를 고친 뒤에는 보상 사이의 상대적인 힘이 문제가 됐습니다. 초기 구성에서는 살아 있는 매 step마다 받는 alive reward가 1.0이었고, 명령 속도 추종 보상은 2.0이었습니다. 겉으로는 전진 보상이 더 커 보이지만, 속도 추종은 오차에 따라 감소하고 실제로 움직이면 균형·에너지·action 변화 페널티도 함께 발생합니다. 반면 가만히 버티는 정책은 비교적 안정적으로 생존 보상을 축적할 수 있었습니다.
자동 조정으로 tracking 계수를 1.6배 올리고 alive reward를 0.4배로 낮춘 v4는 넘어지지 않는 데는 성공했습니다. 하지만 정지 명령에서는 이동거리가 -0.1m였고, 느린 전진 명령에서는 -1.4m였습니다. “생존”이라는 한 지표는 좋아졌지만 로봇은 앞으로 걷지 못했고 오히려 뒤로 이동했습니다.
여기에는 좌표계 문제도 숨어 있었습니다. 몸통 기준 속도 추종만 보면 로봇이 yaw 방향을 틀었을 때 사람이 기대한 월드 좌표계의 전진과 다른 결과가 생길 수 있습니다. 그래서 이후 환경에는 월드 좌표계 명령 방향의 progress, 목표 방향과의 heading alignment, backward penalty를 추가했습니다. alive reward는 더 낮추고 air-time은 무작정 커지지 않도록 bounded 형태로 바꿨습니다.
이 변경은 “전진 보상을 크게 주자”보다 구체적입니다. 속도를 따라가는 것과 실제 경로를 따라가는 것을 분리하고, 몸의 방향을 포함해 뒤로 걷는 우회로를 닫은 것입니다. 보상 함수에서 좌표계는 구현 세부사항이 아닙니다. 무엇을 전진이라고 정의하는지를 결정하는 문제입니다.
Reward hacking은 버그가 없어도 발생합니다
Reward hacking은 정책이 코드 오류를 악용할 때만 생기는 현상이 아닙니다. 측정 가능한 대리값과 사람이 원하는 목표 사이에 빈틈이 있으면 발생합니다. 예를 들어 발 높이만 보상하면 로봇은 전진하지 않고 제자리에서 발만 들 수 있습니다. 에너지 페널티가 너무 강하면 걷지 않는 것이 최적이 됩니다. 정해진 경로 안에서만 자세 보상을 주면 정책은 경로 조건을 벗어나 자세 보상 자체를 비활성화할 수 있습니다.
마지막 예가 실제 v590과 v600을 해석할 때 중요했습니다. 이 실험들의 목적은 느린 보행에서 팔과 다리의 형태를 개선하는 것이었습니다. 보상 로그를 확인하면 형태 압력은 죽어 있지 않았습니다. v589 구성에서 일반 5초 조건은 2,000개 중 1,992개 row, 느린 경로 조건은 666개 row, morphology-authority 조건은 1,326개 row에서 실제로 활성화됐습니다.
그런데 v590의 느린 명령 이동거리는 기준 체크포인트 v585보다 0.7199m 나빠졌습니다. v600도 0.2479m 나빠졌습니다. 일반 속도의 이동거리는 거의 보존됐고 넘어짐과 발 교차는 모두 0이었지만, 느린 조건에서 요구한 전진 품질과 형태 gate를 함께 통과하지 못했습니다.
| 실험 | 느린 명령 이동거리 변화 | 확인된 사실 | 판정 |
|---|---|---|---|
| v590 | -0.7199m | morphology pressure가 실제로 활성화됨 | 경로 품질 저하, reject |
| v600 | -0.2479m | 일반 속도와 안정성은 보존됨 | 전체 morphology/raw gate 실패, reject |
| v604 | +0.187m | 이동거리는 개선됐지만 route-safe row -187, morphology 변화 <0.01 | 목표 형태 개선 실패, reject |
v600을 15초 동안 추적한 로그에서는 최종 이동거리 차이가 -0.5444m였고, 초반·중반·후반의 progress 차이가 각각 -0.1027, -0.1566, -0.2835m로 더 벌어졌습니다. route-safe row도 세 구간에서 각각 64, 130, 99개 줄었습니다. 형태 보상이 활성화된 사실과 별개로 정책이 느린 전진 속도나 heading 품질을 희생해 그 압력이 적용되는 경로를 벗어났을 가능성이 보였습니다.
이것을 저는 현재 route-gate escape라는 기전 가설로 부르고 있습니다. 로그가 보여 주는 것은 “형태 신호가 계산돼 정책에 노출됐다”는 사실과 “경로 품질이 함께 나빠졌다”는 사실입니다. 팔 동작이 직접 경로 저하를 일으켰다고 인과까지 확정한 것은 아닙니다. 그래서 같은 계수를 더 세게 주는 대신, 경로 적합성과 형태 압력을 분리하고 정책이 경로를 포기해 형태 항목을 끌 수 없도록 v603에서 guard를 재구성했습니다.
세 번째 조정에서도 목적 지표가 움직이지 않았습니다
v604는 분리한 보상 구조로 한 번의 PPO iteration을 수행한 결과입니다. 느린 조건 이동거리는 기준보다 0.187m, 일반 조건은 0.046m 좋아졌습니다. 넘어짐과 발 교차도 없었습니다. 여기까지만 보면 이전 실패를 해결한 것처럼 보입니다.
하지만 seeded 평가에서 route-safe row가 기준보다 187개 감소했고, 그중 182개는 heading eligibility 감소로 설명됐습니다. 정작 바꾸려던 morphology와 raw action 평균은 0.01 미만으로만 움직였습니다. 즉 정책은 이동거리라는 한 축을 개선했지만, 경로 조건을 덜 만족했고 목표로 한 신체 형태도 실질적으로 바꾸지 못했습니다.
이 지점에서 저는 v596, v600, v604를 세 번의 정체된 reward-only cycle로 묶었습니다. 다음 계수를 추측해 또 학습시키지 않고 scalar reward tuning을 중단했습니다. 같은 관측과 정책 구조 안에서 계수만 조정하는 방식이 목표 행동에 충분한 신용을 할당하지 못한다는 증거가 쌓였기 때문입니다.
중단은 실패를 숨기는 결정이 아니라 실험 결과입니다. 현재 다음 단계는 PPO 재개가 아니라 post-policy와 pre-physics 사이에서 어떤 action·상태 변화가 일어나는지 비학습 방식으로 분리해 보는 M160a 진단입니다. 원인을 확인한 뒤 constraint, teacher signal, recurrent state 또는 다른 정책 구조가 필요한지 판단할 계획입니다. reward를 더 넣는 것은 그 뒤의 선택지입니다.
Reward telemetry와 평가 gate는 다른 질문에 답합니다
학습 로그에서 특정 reward가 0이 아니라고 해서 그 보상이 원하는 행동을 만들었다고 결론 내릴 수는 없습니다. telemetry는 신호가 계산됐는지, 조건문을 통과했는지, 어느 정도 크기로 노출됐는지를 답합니다. 반면 고정된 seed와 명령으로 수행하는 외부 평가는 행동이 실제 기준을 통과했는지를 답합니다.
| 검사 층 | 답하는 질문 | G1에서 본 예 |
|---|---|---|
| 단위 계산 | 상태가 좋아질 때 reward 방향이 맞는가? | air-time 부호와 기준점 확인 |
| 활성화 telemetry | reward와 gate가 rollout에서 실제로 노출됐는가? | v589 morphology-authority 1,326/2,000 rows |
| 고정 조건 평가 | 같은 명령·seed에서 행동이 좋아졌는가? | 느린/일반 이동거리, fall, foot crossing |
| 형태·raw gate | 목표로 한 관절 형태와 action이 바뀌었는가? | v604 morphology/raw 평균 변화 <0.01 |
| 채택 판정 | 모든 필수 기준을 동시에 통과했는가? | 한 지표만 좋아진 checkpoint는 reject |
이 층을 분리하면 “보상이 작동했다”라는 모호한 문장을 피할 수 있습니다. 구현이 실행됐다는 뜻인지, PPO가 그 신호에 반응했다는 뜻인지, 눈에 보이는 행동이 달라졌다는 뜻인지, 최종 체크포인트가 채택됐다는 뜻인지 각각 따로 기록할 수 있습니다.
보상 함수를 추가하기 전에 확인하는 순서
현재 저는 새 reward term을 넣을 때 다음 순서를 따릅니다.
- 의도를 관측 가능한 문장으로 바꿉니다. “자연스럽게” 대신 팔 각도, 발 높이, 월드 전진량, 몸통 방향처럼 계산 가능한 지표를 적습니다.
- 좌표계와 단위를 명시합니다. body frame인지 world frame인지, m/s인지 step당 displacement인지 확인합니다.
- 좋은 상태와 나쁜 상태를 손으로 넣어 부호를 검증합니다. 계수 조정 전에 raw term의 단조성과 범위를 봅니다.
- 조건부 gate의 분모를 기록합니다. 값이 0인 이유가 행동 때문인지 gate가 닫혔기 때문인지 구분합니다.
- 다른 reward와의 상대 규모를 rollout 분포에서 봅니다. 설정 파일의 계수만 비교하지 않고 실제 step contribution을 비교합니다.
- 학습 reward와 외부 평가 지표를 분리합니다. reward 합계는 채택 기준이 아닙니다.
- 한 번의 실험에서 하나의 가설만 검증합니다. 관측·action scale·reward·curriculum을 동시에 바꾸면 원인을 되짚기 어렵습니다.
- 중단 기준을 먼저 정합니다. 같은 우회 행동이 반복되면 다음 계수보다 측정, 제약 또는 정책 구조를 검토합니다.
보상 설계의 핵심은 숫자를 더하는 일이 아닙니다
G1 실험에서 제가 얻은 가장 큰 교훈은 reward 항목의 개수가 전문성을 보장하지 않는다는 점입니다. 부호가 틀린 한 항목은 발을 들지 않게 만들었고, 생존 보상의 우세는 전진하지 않는 정책을 만들었습니다. 조건부 형태 보상은 실제로 노출됐지만 정책은 목표 형태보다 경로를 희생하는 쪽으로 움직였습니다. 경로 gate를 분리한 뒤에는 이동거리만 좋아지고 형태는 그대로였습니다.
결국 보상 함수는 의도를 완벽하게 표현하는 명세서가 아니라 불완전한 계측 장치에 가깝습니다. 좋은 실험은 reward 합계가 상승한 장면을 찾는 데서 끝나지 않습니다. 어떤 신호가 노출됐고, 정책이 어떤 우회로를 선택했으며, 고정된 평가에서 무엇이 좋아지고 무엇이 나빠졌는지를 함께 남겨야 합니다. 그리고 같은 실패가 반복되면 보상 계수 바깥의 원인을 볼 줄 알아야 합니다.
함께 읽기: 로봇 강화학습 환경 읽기 — G1의 관측·행동·보상 · PPO는 로봇을 어떻게 학습시키는가 · G1 보행 정책을 어떻게 학습하고 있는가 · 보행 정책을 생존율만으로 평가할 수 없는 이유 · 실험을 언제 멈출 것인가
참고 자료: Concrete Problems in AI Safety · Learning to Walk in Minutes Using Massively Parallel Deep Reinforcement Learning
기술 기준 시점: 2026-07-21. 수치와 구현 설명은 origin/main@ee4d96e의 G1 환경·보상 가이드·평가 기록을 기준으로 작성했습니다. v590·v600·v604는 모두 비교 실험이며 채택된 새 기준 체크포인트가 아닙니다. 현재 M160a는 PPO 재개가 아닌 비학습 인과 진단 단계입니다.