H1 보행에서 처음 얻은 체크포인트는 평균 episode length가 743까지 올라갔지만, 저는 그것을 자연 보행이라고 받아들이지 않았습니다. 넘어지지 않는 시간과 사람이 보기에 안정적인 걸음은 다른 기준이기 때문입니다. 이 차이 때문에 지금의 보행 파이프라인은 ‘PPO를 실행해 모델을 저장하는 과정’보다, 어떤 관찰을 정책에 주고 무엇을 보상하며 어떤 장면에서 탈락시킬지를 서로 분리하는 구조에 더 가깝습니다.
한 환경이 하는 일: 물리 상태를 47개 숫자와 19개 목표로 바꿉니다
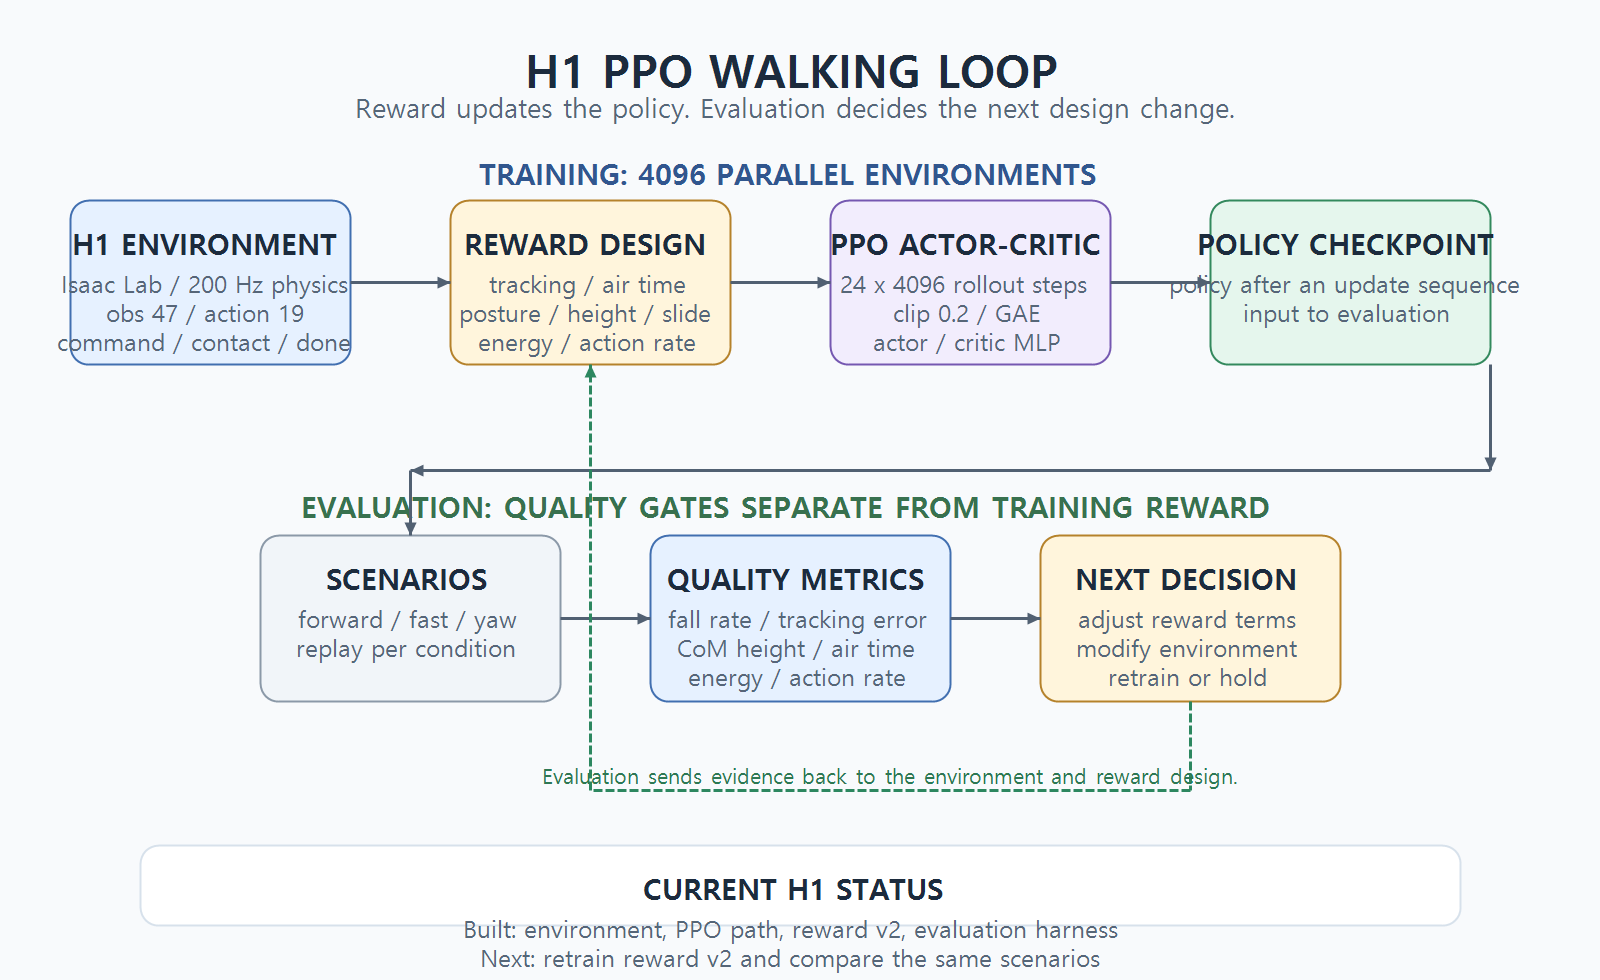
sim/envs/h1_walk/의 H1 환경은 Isaac Lab의 DirectRLEnv로 구성했습니다. 물리는 200 Hz로 계산하고, 정책은 네 번의 물리 step마다 한 번씩 행동을 냅니다. 즉 정책의 제어 주기는 50 Hz입니다. 한 환경에서 보는 47차원 관측은 몸통 각속도 3개, 몸통 좌표계에서 본 중력 방향 3개, 속도 명령 3개, 기준 자세와의 관절 위치 차이 19개, 관절 속도 19개로 이루어집니다.
정책의 출력은 19차원입니다. 각 값은 H1의 기준 관절 자세에서 얼마나 움직일지를 뜻하는 offset이고, 환경은 이를 목표 관절 위치로 바꾼 뒤 하위 제어기에 전달합니다. 정책이 직접 토크를 내는 구조로 시작하지 않은 이유는, 보행의 상위 선택과 관절 수준의 안정화를 한 번에 섞으면 어느 단계에서 문제가 생겼는지 알아보기 어려워지기 때문입니다.
4096개의 H1이 동시에 만드는 경험
학습은 화면에 보이는 한 대의 H1을 오래 움직여 보는 방식이 아닙니다. 같은 H1 환경 4096개가 서로 다른 초기 상태와 속도 명령 아래에서 동시에 진행됩니다. 각 환경은 24 step의 rollout을 만든 뒤 관측, action, reward, 종료 여부를 PPO runner에 넘깁니다. 이 묶음이 한 번의 정책 갱신에 쓰이는 경험입니다.
rsl_rl의 actor와 critic은 각각 512–256–128 크기의 MLP를 씁니다. actor는 다음 19차원 action의 분포를 만들고, critic은 현재 상태에서 앞으로 기대되는 return을 추정합니다. PPO는 새 정책이 직전 정책에서 너무 멀리 움직이지 않게 clip parameter 0.2를 둡니다. 여기서 clip은 더 큰 보상을 찾더라도 한 번의 업데이트가 기존 행동을 급격히 지워 버리지 않게 하는 안전장치입니다. GAE의 gamma=0.99, lambda=0.95는 당장의 보상과 뒤늦게 나타나는 낙상 비용을 함께 반영하기 위한 추정 설정입니다.
기본 설정에서 한 업데이트가 보는 transition은 4096×24, 즉 98,304개입니다. 각 transition에는 47차원 관측과 19차원 action, reward, done, value 추정이 연결됩니다. 병렬 환경 수가 크다는 사실만으로 이 경험이 다양해지는 것은 아닙니다. reset 분포와 명령이 충분히 달라야 하고, 모든 환경이 같은 실패 모드에 갇히지 않는지도 확인해야 합니다. rollout 크기는 학습 속도의 조건이지 보행 품질의 증거가 아닙니다.
보상은 ‘앞으로 가라’보다 더 구체적인 질문입니다
속도 추종 보상만 있으면 H1은 명령 방향으로 움직이면서도 발을 끌거나 몸을 낮추는 식의 해법을 찾을 수 있습니다. 그래서 H1Walk reward v2에서는 선형 속도와 yaw 속도 추종 외에 발 체공시간, 정지 명령에서의 불필요한 관절 움직임, 몸통 높이, roll·pitch 안정성, hip yaw, 발 미끄럼, 에너지와 action 변화량을 함께 봅니다.
특히 feet_air_time의 가중치를 1.0에서 2.0으로 올리고, stand_still, base_height, hip_yaw, feet_slide 항을 추가했습니다. 이는 자연 보행이 부족했던 원인을 하나로 단정한 수정은 아닙니다. 발을 끄는 현상, 쪼그려 에너지를 줄이는 현상, 정지 명령에서도 남는 움직임처럼 서로 다른 관찰을 분리해 다음 재학습에서 확인하기 위한 가설들입니다.
여러 항을 동시에 바꿨기 때문에 reward v2가 좋아져도 기여도를 바로 분리할 수 없다는 대가가 있습니다. 첫 재학습의 목적은 전체 묶음이 기존 기준선보다 나은지를 확인하는 것이고, 실패하면 지표별 차이를 보고 ablation을 정해야 합니다. 예를 들어 발 체공은 좋아졌지만 속도 추종이나 높이가 나빠지면 단순히 총 reward가 높은 checkpoint를 택하지 않습니다.
학습 담당과 평가 담당을 분리한 이유
학습 runner가 보는 reward는 설계자가 넣은 목표의 합계입니다. reward가 올랐다는 사실만으로 보행 품질이 좋아졌다고 할 수 없는 이유가 여기에 있습니다. training/eval/eval_rl.py는 체크포인트를 별도로 불러 전진·고속 전진·yaw 같은 시나리오를 실행하고, 낙상률·에피소드 길이·속도 추종 오차·CoM 높이·에너지·발 체공시간·action 변화량을 계산합니다.
이 평가 층은 policy에게 보상을 주지 않습니다. 대신 어떤 지표가 통과 기준을 만족하는지 보고서를 남기고, 그 결과가 다음 reward 조정이나 환경 수정의 입력이 됩니다. 현재 H1의 기존 체크포인트는 이 관문을 통과한 자연 보행 결과가 아니며, reward v2 조건에서 다시 학습하고 동일한 시나리오로 비교하는 것이 다음 단계입니다.
한 장의 재생 화면과 한 개의 JSON을 함께 남깁니다
수치만으로는 발을 끄는 모양이나 팔·몸통의 보상을 모두 설명하기 어렵고, 영상만으로는 여러 episode의 낙상률과 속도 오차를 알 수 없습니다. 그래서 평가 결과에는 checkpoint·환경·명령 시나리오·seed가 들어간 JSON과, 같은 조건의 Isaac Sim 캡처가 함께 필요합니다. 화면은 원인을 확정하는 증거가 아니라 수치가 놓친 실패 서명을 찾는 보조 자료로 씁니다.
두 자료가 충돌하면 합격을 보류합니다. 오래 버티고 이동거리도 나왔지만 발이 지속적으로 교차하거나 상체가 극단적으로 보상하면 형태 관문을 추가해야 합니다. 반대로 한 장면이 자연스러워 보여도 반복 episode에서 저속 전진이나 yaw 추종이 무너지면 대표 영상으로 정책을 승인하지 않습니다. H1에서 얻은 이 원칙은 이후 G1의 morphology·raw-action gate로 더 구체화됐습니다.
각 구성요소가 서로에게 넘기는 것
- H1 환경은 물리 상태를 관측·reward·종료 신호로 변환합니다.
- PPO runner는 여러 환경의 rollout을 모아 actor와 critic을 갱신합니다.
- 체크포인트는 특정 환경 설정과 PPO 설정 아래에서 얻은 정책의 스냅샷입니다.
- 평가 harness는 체크포인트를 같은 관측 형식으로 실행하되, reward와 분리된 품질 지표를 계산합니다.
- Theory.md와 실험 기록은 왜 관측·보상·평가 기준을 바꿨는지를 다음 작업에서 찾을 수 있게 연결합니다.
지금 이 루프에서 검증된 것은 H1 환경, PPO 실행 경로, reward v2의 구성, 평가 harness의 역할입니다. 자연 보행의 개선은 아직 이 루프를 다시 통과해 확인해야 하는 결과입니다. 다음 비교에서는 체크포인트가 오래 버티는가보다, 같은 속도 명령에서 발이 얼마나 안정적으로 교대하고 몸통 높이와 속도 추종이 함께 유지되는지를 먼저 보게 됩니다.
함께 읽기: 로봇 강화학습 환경의 관측·행동·보상 · PPO의 rollout과 clipping · 보행 평가 · 중단 판단 · 현재 G1 학습 방법과 중단 이유