보행 중 팔 흔들기는 보기 좋은 동작을 위한 장식일까요, 아니면 균형 제어의 일부일까요. Learning Humanoid Arm Motion via Centroidal Momentum Regularized Multi-Agent Reinforcement Learning은 팔의 움직임을 전신 균형과 연결해 이 질문을 다룹니다. 저는 휴머노이드의 상체 동작을 검토하면서, 팔 관절을 독립적으로 맞추는 문제로만 보면 놓치는 것이 무엇인지 확인하기 위해 이 논문을 읽었습니다.
팔을 따로 보지 않는 이유
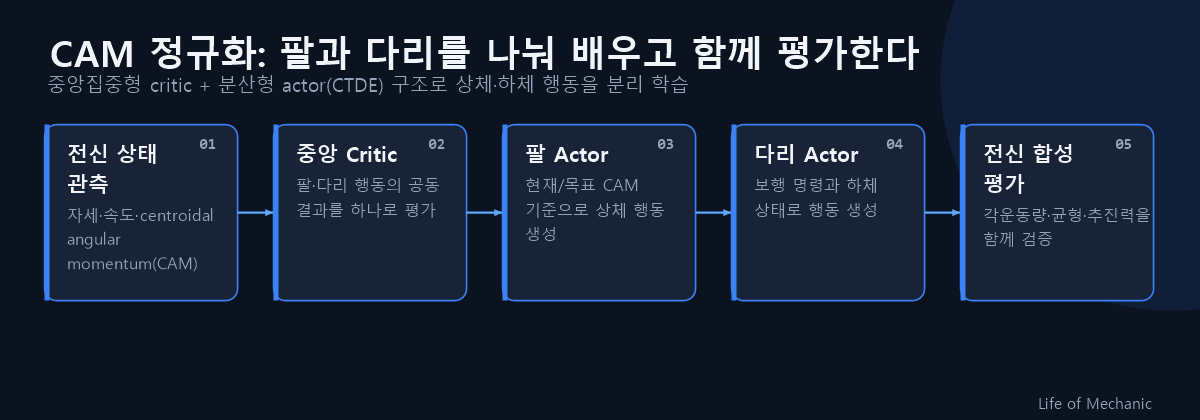
논문은 중심질량 각운동량(CAM)을 관찰과 보상에 사용합니다. CAM은 몸 전체가 회전하려는 경향을 요약한 물리량으로, 팔이 어느 방향으로 움직이면 몸통과 발 접촉의 부담이 어떻게 달라지는지 읽는 단서가 됩니다. 연구진은 팔과 다리에 분리된 actor를 두되, 중앙 critic이 전체 상태를 보게 하는 다중 에이전트 강화학습 구조를 사용했습니다. 핵심은 팔의 궤적을 미리 정해 두는 것이 아니라, 보행 중 생기는 전신 회전 문제에 팔이 반응할 수 있게 만든 데 있습니다.
하지만 이 결과가 ‘팔을 흔들면 균형이 좋아진다’는 단순 규칙을 뜻하지는 않습니다. 논문의 효과는 특정 로봇, 관측, 보상, 교란 조건 안에서 검증된 것입니다. 팔 동작을 현재 G1 정책에 곧바로 추가하면, 보행의 문제를 가리거나 새로운 접촉·충돌 문제를 만들 수 있습니다. 그래서 저는 지금 이 논문을 정책 이식의 근거가 아니라, 상체를 평가할 때 전신 운동량과 안전 경계를 함께 봐야 한다는 참고로 사용하고 있습니다.
프로젝트 적용 위치
제가 현재 적용하는 원칙은 상체 동작을 시각적 자연스러움으로 판단하지 않는 것입니다. 먼저 보행과 균형의 기준선을 분리해 평가하고, 그 다음에야 상체 동작이 어떤 조건에서 도움이 되는지 관찰할 수 있습니다. 검증 예정인 것은 전신 회전과 접촉 상태를 진단 신호로 기록하는 일이며, 별도 팔 정책이나 다중 에이전트 구조의 도입은 그 진단이 필요성을 보일 때만 검토합니다.
이 글은 G1 보행 정책과 학습 루프의 구조적 문제를 함께 읽을 때 의미가 있습니다. 모델을 복잡하게 만들기 전에, 어떤 물리량을 보고 무엇을 성공으로 볼지부터 정해야 한다는 공통된 판단 때문입니다.
논문이 다시 정의한 팔 흔들기
휴머노이드 보행에서 팔 궤적을 사람처럼 보이게 만드는 것과 실제 균형에 기여하게 만드는 것은 다릅니다. 이 논문은 팔 동작의 목표를 미리 정한 관절각 추종이 아니라 질량중심 주변의 전체 회전량인 centroidal angular momentum(CAM)을 조절하는 문제로 정의했습니다. 다리와 몸통이 만든 각운동량을 팔이 반대 방향으로 보상하는지를 직접 상태와 보상에 넣었습니다.
왜 팔과 다리를 다른 에이전트로 나눴을까요
하나의 정책과 하나의 보상으로 전신을 학습하면 생존과 속도 추종을 주로 담당하는 다리 신호가 팔의 작은 균형 기여를 덮을 수 있습니다. 연구진은 팔 actor와 다리 actor에 서로 다른 관측과 반환값을 주고, 학습 때만 전신 상태를 보는 중앙 critic을 사용했습니다. 이를 중앙집중 학습·분산 실행(CTDE)이라 부르며, 배포 시 각 actor는 필요한 국소 정보로 행동하지만 학습 시 critic은 두 부분의 상호작용을 더 정확히 평가합니다.
기저 자세·속도·CAM
팔·다리 행동의 공동 결과 평가
현재/목표 CAM으로 상체 행동
보행 명령과 하체 상태로 행동
각운동량·균형·추종을 함께 평가
CAM 목표와 보상의 의미
논문은 몸통과 다리가 만드는 CAM을 기준으로 팔이 만들어야 할 보상 성분을 계산하고, 목표 CAM 추종과 수평 방향 각운동량 증가 억제를 팔 보상에 둡니다. 다리는 속도 추종과 안정성을 담당합니다. 이 구조의 논리는 예쁜 팔 자세를 강제하는 대신, 현재 보행이 실제로 만든 회전 효과에 따라 팔의 역할을 바꾸는 것입니다.
실험은 외란과 보행 조건에서 균형과 전신 동작을 비교하지만, 특정 로봇과 시뮬레이터의 결과가 다른 휴머노이드에 그대로 전이된다고 보기는 어렵습니다. 제 프로젝트에서는 CAM을 측정 지표로 추가하는 원리는 적용할 수 있습니다. 반면 독립된 팔·다리 actor와 중앙 critic을 갖춘 전체 CTDE 학습은 아직 검증 예정이며, 단순 팔 궤적이나 단일 보상 계수 조정이 이 논문을 재현했다고 표현하지 않습니다.
무엇을 비교해야 이 방법을 검증했다고 말할 수 있을까요
팔 동작의 외형만 비교해서는 부족합니다. 최소한 팔을 고정한 기준선, 미리 정한 관절 궤적, CAM 목표를 관측하는 팔 actor를 같은 보행 조건과 외란에서 비교해야 합니다. 평가 항목도 생존 여부뿐 아니라 몸통 기울기, 속도 추종, 축별 CAM, 팔이 다리·몸통 CAM을 실제로 상쇄했는지를 포함해야 합니다.
또한 중앙 critic을 쓰는 학습과 단일 critic의 residual 정책은 구조적으로 다른 방법입니다. 후자가 좋아졌더라도 논문의 CTDE를 재현했다고 부를 수 없습니다. 이 구분은 제 구현에서 가장 중요한 검증 기준이며, 다이어그램의 각 박스가 실제 관측·보상·학습 저장소로 분리됐는지 확인한 뒤에만 논문 적용으로 기록할 예정입니다.
원문 보기: Learning Humanoid Arm Motion via Centroidal Momentum Regularized MARL (arXiv 2507.04140)