G1 정책에 과거 관측을 붙이기 전에 먼저 정보량부터 재봤습니다. M99에서는 현재 160차원 observation 한 장과 최근 다섯 장을 이어 붙인 800차원 입력이 0.10초 뒤의 양발 접촉 전환을 얼마나 잘 구분하는지 비교했습니다. 예상과 달리 한 장만 쓴 선형 probe의 최소 balanced accuracy가 이미 0.94946이었습니다. 다섯 장을 썼을 때의 전환 예측 이득은 seed 17·42·73에서 각각 0.00757, 0.00829, 0.00947에 그쳤습니다.
이 결과만 보고 “로봇 정책에는 memory가 필요 없다”고 결론 내리면 곤란합니다. M99가 답한 질문은 훨씬 좁습니다. 현재 M83 계열 observation으로 특정 접촉 실패를 예측할 때, 0.10초 history가 한 장보다 새로운 정보를 주는가였습니다. 그 조건에서는 답이 아니었습니다. 그래서 recurrent PPO를 돌리지 않았습니다. history는 네트워크를 고급스럽게 보이게 하는 옵션이 아니라, 현재 관측에서 빠진 상태가 과거 신호에 남아 있다는 가설이기 때문입니다.
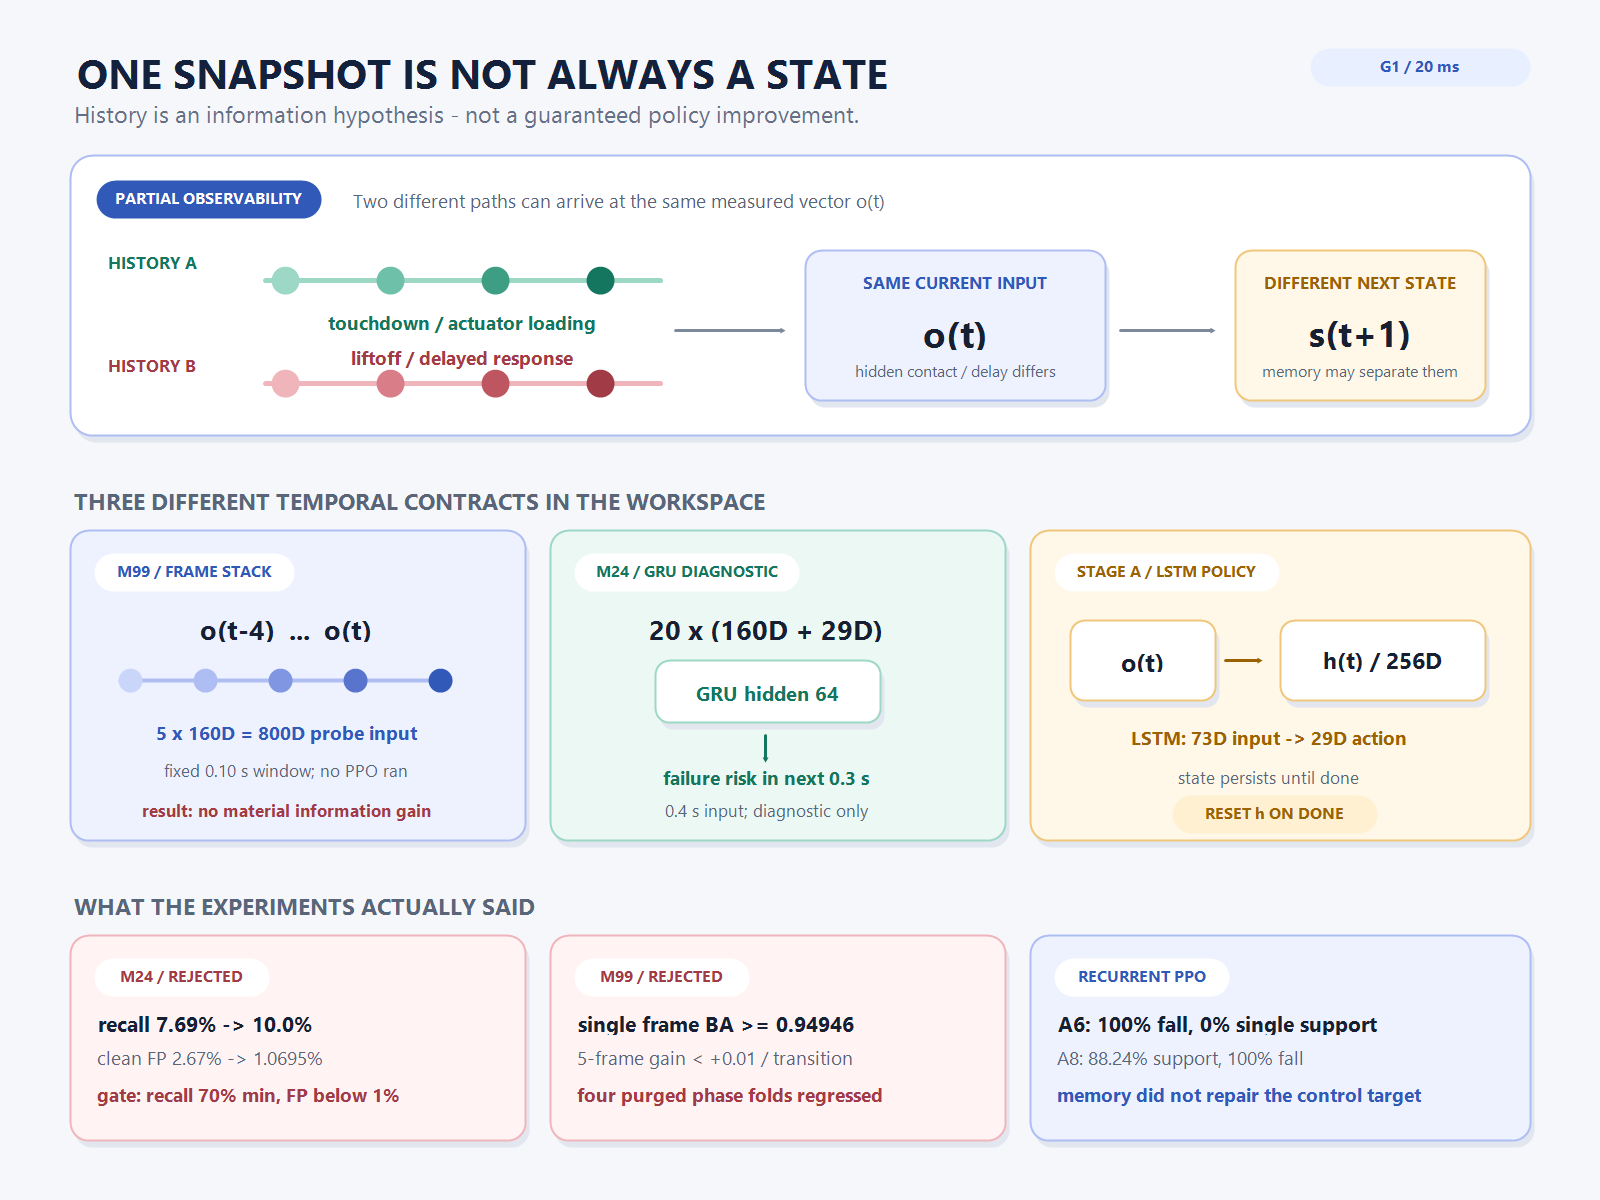
observation은 센서가 보여준 값이고 state는 다음 변화를 결정하는 값입니다
G1 강화학습 환경의 observation·action 계약에서 관절 위치와 속도, base 각속도, projected gravity, command, 이전 action처럼 정책이 한 제어 시점에 받는 항목을 정리했습니다. 이 벡터는 정책의 입력이지 물리계의 완전한 state와 같은 말은 아닙니다. 바닥 접촉력, 구동기 내부 상태, 통신 지연, 마찰 상태처럼 다음 움직임에 영향을 주지만 actor가 직접 보지 못하는 변수가 남을 수 있습니다.
완전한 state를 알고 있다면 다음 상태의 분포는 현재 state와 action으로 정해지는 Markov 관계로 쓸 수 있습니다.
P(s_(t+1) | s_t, a_t)

observation:  o_t ~ O(s_t)
policy:       a_t ~ pi(o_t)             # 한 장만 보는 정책
history:      a_t ~ pi(o_(0:t), a_(0:t-1))
하지만 actor가 보는 것은 s_t가 아니라 o_t입니다. 서로 다른 실제 상태가 같은 관측으로 투영될 수 있으면 이 문제는 부분관측, 즉 POMDP(Partially Observable Markov Decision Process)가 됩니다. 같은 관절 각도와 비슷한 속도를 보고 있어도 방금 발이 닿으며 하중이 실리는 중인지, 접촉에서 빠져나오는 중인지, 이전 명령이 구동기 지연을 거쳐 아직 반영되는 중인지에 따라 다음 20ms가 달라질 수 있습니다.
이때 history의 역할은 과거를 많이 저장하는 것 자체가 아닙니다. 과거 신호로 현재의 숨은 상태에 대한 belief, 다시 말해 “지금 실제로 어느 경우에 더 가까운가”라는 내부 추정을 만드는 것입니다. Belief-Grounded Networks도 부분관측 로봇 문제를 observation-action history에서 belief를 재구성하는 문제로 다룹니다. 다만 history가 길어졌다고 belief가 자동으로 정확해지는 것은 아닙니다.
과거가 유용하려면 현재 한 장으로 구분되지 않는 두 경우를 실제로 갈라야 합니다
history가 도움이 되는 조건은 비교적 명확합니다. 숨은 변수가 시간에 걸쳐 변하고, 그 변화가 관측 시퀀스에 서로 다른 흔적을 남겨야 합니다. 구동기 응답 지연이라면 이전 action과 이후 관절 응답의 차이가, 접촉 전환이라면 발 높이·속도·base 반응의 순서가 그 흔적이 될 수 있습니다. 반대로 현재 observation에 이미 필요한 정보가 충분히 들어 있거나, 실패 원인이 관측 부족이 아니라 잘못된 action target과 제어 권한이라면 과거 frame은 같은 정보를 반복합니다.
여기서 자주 생기는 오류는 정책 성능만으로 정보의 존재를 판단하는 것입니다. recurrent PPO가 실패했다고 memory에 정보가 없다고 단정할 수 없고, 반대로 학습 reward가 올랐다고 hidden state가 올바른 물리 상태를 복원했다고 말할 수도 없습니다. 네트워크 최적화, reward, action 표현, 데이터 분포가 동시에 결과에 섞이기 때문입니다. 그래서 M99에서는 PPO보다 싼 probe로 “한 장 대비 다섯 장의 추가 예측력”을 먼저 측정했습니다.
frame stacking은 기억을 학습하는 대신 고정된 시간창을 입력으로 만듭니다
가장 단순한 방법은 최근 k개의 observation을 이어 붙이는 frame stacking입니다.
x_t = [o_(t-k+1), ..., o_(t-1), o_t]
a_t ~ pi(x_t)
현재 observation이 160차원이고 다섯 frame을 쓰면 입력은 800차원이 됩니다. M99의 800차원은 정책 입력이 아니라 정보량을 재기 위한 ridge probe 입력이었습니다. 이 구분이 중요합니다. M99는 기존 정책을 바꾸거나 simulator를 다시 실행하지 않았고, M98에서 보존한 세 seed trace를 재사용했습니다.
Isaac Lab ObservationManager도 observation term 또는 group 단위의 history_length와 history 차원 flatten을 지원하며, 순서는 오래된 frame에서 최신 frame 방향입니다. 구현은 간단하지만 시간창의 의미는 frame 개수가 아니라 초 단위로 계산해야 합니다. G1의 policy step은 0.02초이므로 다섯 frame은 0.10초입니다. physics step과 policy step의 차이를 무시하고 frame 수만 복사하면 같은 설정 이름이 서로 다른 물리 시간을 가리키게 됩니다.
frame stack의 장점은 입력과 출력이 명시적이라는 점입니다. export할 때 hidden state를 따로 보존하지 않아도 되고, 어느 시점이 입력에 들어갔는지 추적하기 쉽습니다. 대신 입력 차원이 window 길이에 비례하고, 가장 오래된 frame과 가장 최근 frame을 어떻게 결합할지는 뒤의 MLP나 encoder가 다시 학습해야 합니다. 필요한 기억 길이가 상황마다 달라지는 문제에도 고정 창은 둔감합니다.
GRU와 LSTM은 과거 전체 대신 hidden state를 다음 제어 스텝으로 넘깁니다
recurrent policy는 최근 frame을 모두 외부 입력으로 펼치지 않습니다. GRU나 LSTM이 현재 observation과 직전 hidden state를 받아 새로운 hidden state를 만들고, actor가 그 표현에서 action을 계산합니다.
h_t = RNN(h_(t-1), o_t)
a_t ~ pi(h_t)

episode done for env i:
    h_t[i] = 0
현재 Stage A 설정은 ActorCriticRecurrent, LSTM 한 층, hidden dimension 256입니다. actor는 매 step 73차원 observation을 받고 29차원 action을 냅니다. 고정된 5-frame 창과 달리 LSTM은 어떤 과거를 얼마나 유지할지 학습할 수 있지만, runtime 계약에는 이제 observation뿐 아니라 hidden state도 포함됩니다. Isaac Lab의 RSL-RL recurrent 설정도 GRU/LSTM 종류, hidden dimension, layer 수를 별도 정책 계약으로 둡니다.
episode reset은 이 계약의 일부입니다. 4,096개 병렬 환경 중 넘어지거나 timeout에 도달한 환경만 새 episode를 시작하므로 해당 index의 hidden state만 초기화해야 합니다. 그렇지 않으면 이전 episode의 넘어지기 직전 기억이 새 초기 자세로 넘어옵니다. G1 A13/A14 진단에서는 trace·eval 경로의 recurrent hidden-state reset을 실제로 수정했습니다. 이 수정 전후 결과가 섞이면 정책 성능 차이를 memory 효과로 잘못 해석할 수 있습니다.
RSL-RL처럼 rollout을 잘라 recurrent PPO를 학습하는 구현은 각 시퀀스의 초기 hidden state, done mask, padding과 unpadding까지 보존해야 합니다. 현재 프로젝트에서도 A8 보조 손실이 LSTM을 mask와 hidden state 없이 다시 호출하던 결함을 고치고, 공식 trajectory unpadding과 PPO actor mean을 재사용한 뒤에야 recurrent 실험을 계속했습니다. memory layer를 설정 파일에 한 줄 추가하는 것과 올바른 recurrent 학습 경로를 만드는 것은 다른 작업입니다.
시간 정렬이 한 step만 어긋나도 history는 미래 정보를 보거나 잘못된 action을 배웁니다
시간축 모델에서는 feature보다 먼저 “이 행이 어느 물리 시점을 뜻하는가”를 고정해야 합니다. G1 evaluator는 action을 적용한 뒤의 물리 접촉을 기록하고, 다음 policy observation을 만듭니다. M98과 M99에서는 이 호출 순서를 반영해 post-step contact t를 policy observation t+1과 짝지었습니다. 다섯 step 뒤의 접촉 전환을 예측하는 target도 이 정렬 위에서 만들었습니다.
이런 정렬 없이 단순히 같은 CSV 행을 묶으면 probe가 아직 actor에게 도착하지 않은 접촉을 현재 observation과 함께 볼 수도 있고, 반대로 이전 action을 다음 state의 label로 잘못 연결할 수도 있습니다. 실제 A13 진단에서도 기존 behavior cloning pair가 post_state → previous_action으로 한 칸 어긋나 있었고, 이를 policy_obs_t → action_t로 수정했습니다. recurrent model의 높은 학습 정확도가 시간축 누수에서 나온 것이라면 배포 시 재현되지 않습니다.
phase leakage도 따로 막았습니다. 같은 reference motion을 서로 다른 seed로 재생하면 seed를 나눠도 보행 phase가 train과 test 양쪽에 반복될 수 있습니다. M99는 leave-one-seed-out 외에 reference phase를 네 block으로 나누고 경계에서 아홉 step을 제거한 holdout을 추가했습니다. history window가 train 영역에서 test 영역으로 걸쳐 들어오는 것을 막기 위한 purge였습니다.
M24의 0.4초 GRU는 실패를 일찍 찾지 못해 제어 경로로 들어가지 않았습니다
M24는 정책이 아니라 temporal safety critic 진단이었습니다. seed 48에서 138개, seed 49에서 130개의 고유 failure episode를 수집했고, 각 event에는 0.7초 history와 phase가 맞는 control window가 있었습니다. GRU 입력은 0.4초, 즉 20 step의 정규화된 160차원 policy observation과 29차원 frozen-teacher action이었습니다. 발 간격과 termination margin 같은 privileged 값은 입력이 아니라 다음 0.3초의 실패 label과 회귀 target을 만드는 데만 사용했습니다.
처음 모델은 holdout failure 130개 중 10개만 검출해 recall 7.69%를 기록했습니다. clean episode false positive는 2.67%, 검출된 경우의 평균 선행 시간은 0.174초였습니다. M24b에서는 seed 42·43에서 미리 정한 phase-balanced safe negative 459개를 추가하고 seed 44를 threshold calibration용으로 남겼습니다. recall은 13/130, 10.0%로 올랐고 false positive는 1.0695%, 평균 선행 시간은 0.205초가 됐습니다.
일부 숫자는 좋아졌지만 채택 기준은 recall 70% 이상, false positive 1% 미만이었습니다. 둘 다 통과하지 못했습니다. threshold를 더 만지거나 negative를 다시 고르면 같은 holdout에 맞춘 사후 튜닝이 되므로 M24c는 금지했습니다. 이 결과는 “GRU가 나쁘다”는 뜻이 아닙니다. 현재 observation+teacher-action 계약에서는 흔한 crossing을 제어 개입에 쓸 만큼 일찍 분리하지 못했다는 관측입니다. 데이터 범위 부족과 label 설계가 다른 설명으로 남아 있으므로 물리적 원인까지 확정하지 않았습니다.
M99의 다섯 frame은 현재 한 장보다 새로운 접촉 정보를 주지 못했습니다
M24 이후에도 history가 다른 역할에서 유효할 가능성은 남아 있었습니다. M98은 현재 observation 한 장만으로 실제 양발 접촉과 false contact가 상당 부분 관측 가능한지 확인했습니다. M99는 같은 세 seed 17·42·73 trace를 이용해 0.10초 뒤의 두 사건을 다시 물었습니다. 하나는 각 발의 contact transition, 다른 하나는 reference상 swing인데 새로 발생하는 false-contact onset이었습니다.
각 fold에서는 두 seed로 표준화와 ridge weight, balanced-accuracy threshold를 정하고 남은 한 seed만 평가했습니다. 다섯 frame을 채택하려면 transition과 onset 모두 한 장보다 balanced accuracy가 0.03 이상 좋아지고, history의 최소 accuracy가 0.75 이상이며, 발마다 positive test row가 100개 이상이어야 했습니다.
| 검사 | 한 장 기준 또는 history 변화 | 판정 |
|---|---|---|
| 미래 contact transition | 한 장 최소 BA 0.94946, history 이득 +0.00757 / +0.00829 / +0.00947 | +0.03 정보량 gate 미달 |
| false-contact onset | history 이득 -0.01245 / +0.02475 / -0.01253 | 세 seed 중 두 곳에서 악화 |
| purged phase 4-fold | transition 이득 -0.32229 / -0.24930 / -0.30495 / -0.21173 | 네 fold 모두 거절 |
| positive support | fold별 751–3,393 rows | 빈 class 때문에 생긴 실패는 아님 |
phase holdout에서 history accuracy는 0.43040–0.60509로 내려갔습니다. 같은 phase를 외운 효과를 제거하자 일반화가 더 나빠진 것입니다. 따라서 현재 측정한 접촉 실패에 5-frame actor history를 추가하거나 recurrent PPO 비용을 지불할 근거가 없다고 판정했습니다. M99에서는 simulator도 PPO도 실행하지 않았고 policy·reward·checkpoint도 바꾸지 않았습니다.
실제 recurrent PPO에서도 memory가 잘못된 제어 목표를 대신 고쳐주지는 않았습니다
프로젝트에 recurrent 실행 경험이 없었던 것은 아닙니다. Stage A는 73차원 observation, 29차원 action, 256차원 단층 LSTM으로 실제 PPO를 수행했습니다. A6는 기존 unilateral checkpoint를 물려받지 않고 14개 active reward 아래 fresh recurrent policy를 네 개의 50-update block 동안 학습했습니다.
A6의 fall rate는 네 block 동안 100%였고 single support는 0%, double support는 100%였습니다. slow displacement는 두 번째 block에서 0.796m까지 올라갔다가 model 196에서 0.308m로 다시 내려갔습니다. 15초 trace에서는 tilt termination 37개와 lateral termination 1개, 큰 waist·arm raw action이 기록됐습니다. 반복해서 발을 들지 못하는 attractor가 유지됐기 때문에 남은 여섯 block을 실행하지 않고 중단했습니다.
A8에서는 recurrent phase teacher로 bilateral foot-off를 먼저 만들고 다섯 update를 수행했습니다. single support는 88.24%로 살아났지만 모든 episode가 평균 0.68초 부근에서 넘어졌고 feet crossing은 32.35%, 마지막 발 간격은 -0.0817m였습니다. 시간 기억은 발을 드는 목표를 보존했지만 lateral placement와 capture stability를 만들어내지 못했습니다. 원인은 memory 부족이 아니라 teacher가 제공한 action 구조와 횡방향 제어의 문제에 더 가까웠고, 다음 실험은 reward나 LSTM 크기 대신 cross-free lower-body teacher 쪽으로 이동했습니다.
이 두 결과는 recurrent policy가 무용하다는 증거가 아닙니다. A6는 reward로 foot-off를 발견하지 못했고, A8은 발을 들었지만 옆으로 받치는 action이 부족했습니다. memory는 과거 정보를 압축할 수 있지만 없는 제어 목표를 발명하거나 잘못된 teacher를 자동으로 교정하지 않습니다. Miki 등의 perceptive locomotion처럼 recurrent encoder가 효과를 낸 사례도 있지만, 그 논문에서는 noisy exteroception과 proprioception을 통합해 숨은 지형 belief를 유지한다는 구체적인 정보 문제가 있었습니다.
frame stack과 recurrent policy는 편의가 아니라 숨은 변수의 시간 규모로 고릅니다
| 방법 | 적합한 문제 | 추가 계약 | 현재 G1 근거 |
|---|---|---|---|
| 현재 frame MLP | 현재 관측만으로 target을 충분히 구분 | observation schema와 normalizer | M99 접촉 probe에서는 우선 유지 |
| frame stacking | 고정된 짧은 지연·속도·전환 패턴 | window 길이, 순서, reset padding | 5×160D, 0.10초 정보량 gate 실패 |
| GRU/LSTM 진단기 | 가변 길이 시퀀스로 미래 event 위험 추정 | sequence label, threshold, hidden reset | M24 0.4초 safety critic 거절 |
| recurrent actor–critic | 행동에 필요한 belief를 online으로 유지 | hidden state, done mask, sequence PPO, export feedback | Stage A 실행됨, A6·A8 미채택 |
| privileged critic | 학습 중 value 추정에 simulator state 사용 | actor input과 critic input 분리 | 시간 memory와 별개의 비대칭 계약 |
고정 지연이 100ms라는 물리 근거가 있다면 다섯 frame은 해석하기 쉽습니다. 필요한 기억 길이가 접촉과 외란에 따라 달라진다면 recurrent state가 더 맞을 수 있습니다. 하지만 후자는 학습·평가·export 모두에서 hidden state 소유권을 추가합니다. 입력 차원만 줄어드는 것이 아니라 실패할 수 있는 상태가 하나 더 생깁니다.
그래서 현재 작업에서는 다음 순서를 사용합니다. 먼저 한 장으로 예측할 수 없는 구체적인 hidden variable이나 future event를 정합니다. 동일 trace에서 single-frame baseline과 history candidate를 비교하고, seed뿐 아니라 phase·episode 경계를 분리합니다. 미리 고정한 정보량 gate를 통과한 뒤에만 actor 구조를 바꾸고 PPO를 실행합니다. 마지막으로 done index별 hidden reset, observation-action 정렬, 배포 시 recurrent state 입출력을 따로 검사합니다.
현재 결론은 history를 배제하는 것이 아니라 근거 없이 추가하지 않는 것입니다
현재 M83/M40e 계열의 접촉 문제에 대해서는 결론이 분명합니다. M99의 0.10초 history는 한 장보다 material information을 주지 않았고, 네 개의 purged phase fold에서도 악화됐습니다. 따라서 이 실패를 이유로 observation을 다섯 배로 늘리거나 recurrent PPO를 다시 여는 것은 허용되지 않습니다. M24도 같은 관측 계약에서 실용적인 recovery selector 기준을 넘지 못했습니다.
동시에 Stage A 기록은 LSTM 자체가 실행 가능하다는 것과 memory만으로 잘못된 foot-off·lateral-placement 계약을 고칠 수 없다는 것을 보여줍니다. observation history를 쓸지 말지는 “POMDP니까 RNN”이라는 분류로 결정할 일이 아닙니다. 어떤 숨은 상태를, 몇 초의 과거가, 현재 한 장보다 얼마나 더 잘 구분하는지를 먼저 보여야 합니다.
history를 다시 검토할 조건도 여기서 정할 수 있습니다. 새로운 actuator-delay 또는 sensor-latency trace가 생기면, 현재 frame이 설명하지 못하는 다음-step residual을 target으로 삼아 single-frame과 시간창을 held-out 조건에서 비교해야 합니다. 그 검사는 아직 구현하지 않았습니다. 최소한 M99와 같은 0.03 balanced-accuracy 이득과 episode·phase 경계 purge를 통과하기 전에는 recurrent PPO 비용을 쓰지 않는다는 것이 지금 남길 수 있는 가장 방어적인 결정입니다.