처음에는 폴더를 잘 나누면 작업도 자연스럽게 정리될 거라고 생각했습니다. 하지만 G1 보행 실험이 수백 개의 계획·실행·평가 산출물로 늘어나자, sim/이나 training/이라는 폴더 이름만으로는 다음 행동을 고를 수 없었습니다. 좋아진 수치 하나가 정책 승격을 뜻하는지, CPU에서 통과한 설계가 Isaac Sim 실행까지 허가하는지, 비교용 체크포인트가 라우터에 연결 가능한지를 따로 판정해야 했습니다.
그래서 지금의 워크스페이스는 폴더 지도가 아니라 변경 하나가 증거 게이트를 통과하는 경로로 읽습니다. 질문과 설계가 실행으로 넘어가고, 실행 결과가 평가와 적대검토를 받은 뒤, 승인된 항목만 다음 단계의 입력이 됩니다.
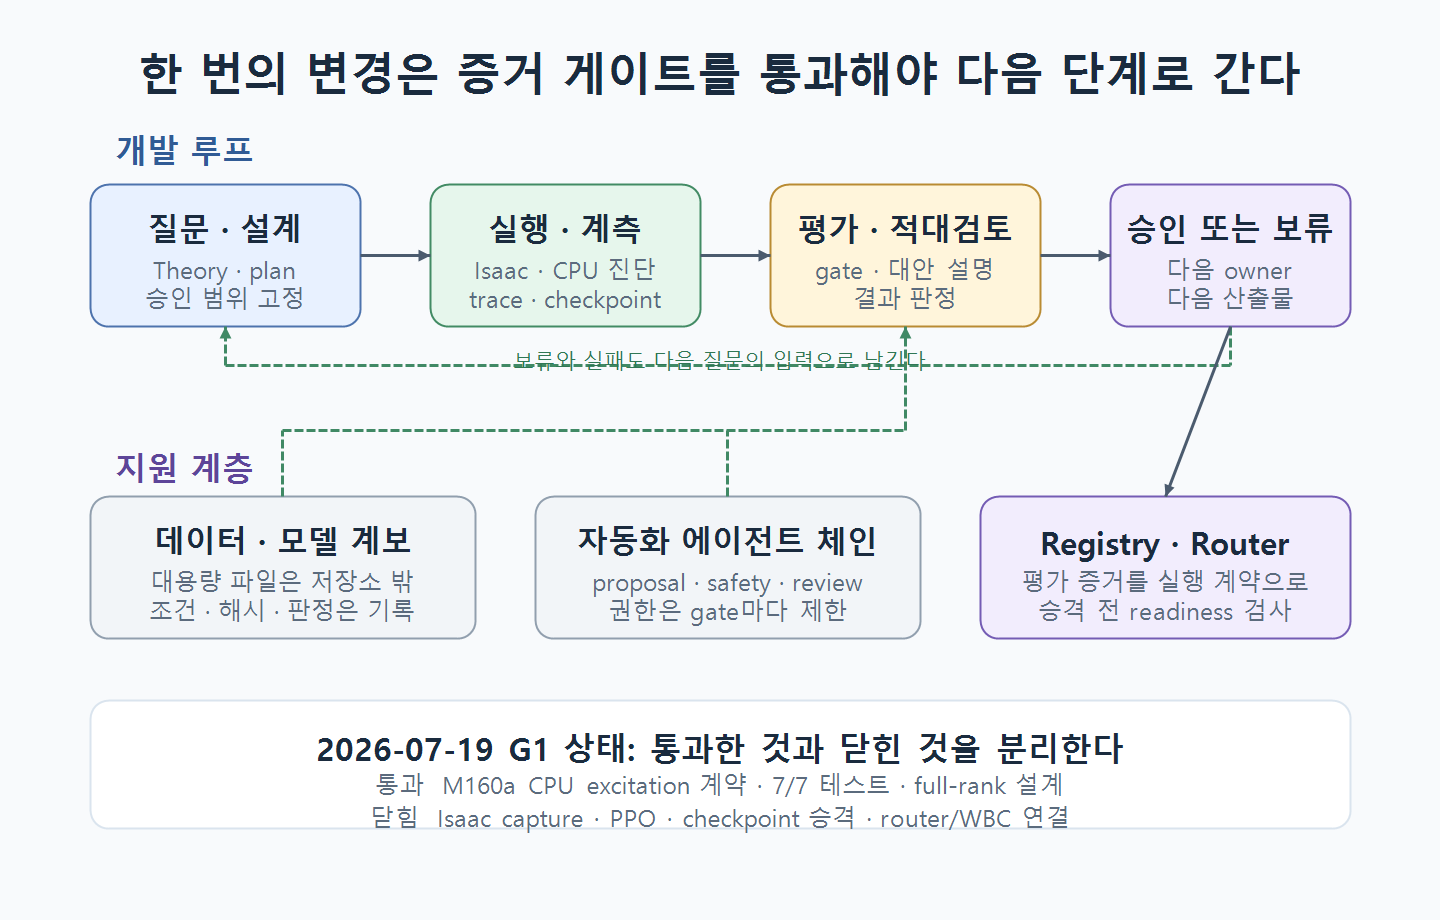
한 번의 변경은 네 단계를 지납니다
첫 단계는 질문과 설계입니다. 논문이나 이전 실험에서 관찰한 문제를 바로 코드로 옮기지 않고, 무엇을 바꿀지와 무엇을 그대로 둘지 적습니다. G1의 M160a는 오른팔만 독립적으로 자극해 관절 응답을 식별하려는 비학습 실험입니다. 128개의 reset pair와 44열 설계를 먼저 만들었고, 이 단계에서는 PPO나 actor 선택을 열지 않았습니다.
두 번째는 실행과 계측입니다. 설계가 CPU 계약을 통과하더라도 Isaac Sim 실행은 별도 제안과 검토를 거칩니다. M160a의 CPU 구현 테스트는 7/7을 통과했고, 정규화 조건수 17.457, leave-one-pair-out 최대 조건수 17.758을 확인했습니다. 이것이 승인한 것은 스케줄 생성과 식별 가능성이지, 로봇 동작이나 체크포인트 개선이 아닙니다.
세 번째는 평가와 적대검토입니다. 결과가 좋아 보이는 방향만 찾지 않고 반대 증거를 먼저 봅니다. M158d는 접촉 횟수를 87회에서 71회로, 충격량을 9.8347 N·s에서 7.6006 N·s로 줄였지만 최소 clearance가 -0.151 mm에서 -0.826 mm로 나빠졌고 washout gate를 통과하지 못했습니다. 따라서 일부 접촉 지표의 개선을 정책 승격으로 바꾸지 않았습니다.
네 번째는 승인 또는 보류입니다. 현재 M148 model 1850은 비교용이고, M157–M159 teacher-overlay 계열은 중단됐습니다. M160a도 CPU 계약만 승인된 상태입니다. Isaac runtime capture, PPO, actor 선택, checkpoint 승격, keyboard 제어, router, WBC 연결은 여전히 닫혀 있습니다.
폴더는 이 게이트를 지원하는 책임 단위입니다
research-notes/와 Theory.md는 질문·근거·연결을 기록하는 지식층입니다. sim/은 로봇 자산과 Isaac Lab 환경, 계측 코드를 맡습니다. training/은 IL·RL 학습과 평가를 분리하고, data/와 models/는 Git 밖의 실제 데이터와 가중치를 보관합니다. robot-control-router/는 승인된 제어 경로를 공통 요청과 로봇별 명령으로 연결합니다.
여기서 중요한 것은 코드가 존재하는 것과 현재 실험에서 사용 승인을 받은 것을 구분하는 일입니다. 라우터에는 RL 체크포인트를 불러오는 경로가 있어도, 현재 G1 후보가 승격되지 않았다면 실행 입력으로 쓸 수 없습니다. WBC 모듈의 컴포넌트 테스트가 통과했어도 M160a에 WBC 연결 권한이 자동으로 생기지 않습니다.
레지스트리와 핸드오프가 약하면 결과가 다시 고립됩니다
대용량 데이터와 체크포인트는 Git에 넣지 않습니다. 대신 데이터 ID, 생성 조건, 코드 SHA, 평가 결과, 저장 위치를 레지스트리에 남겨야 합니다. 지금 워크스페이스에서 가장 약한 연결도 이 레지스트리와 라우터로 넘어가는 인수인계입니다. 실험 산출물이 많아질수록 “어떤 결과가 다음 단계의 정식 입력인가”를 한 곳에서 찾기 어려워지기 때문입니다.
그래서 다음 구조의 원칙은 단순합니다. 작업 하나에는 소유자 하나, 입력 산출물 하나, 출력 산출물 하나, 통과 게이트 하나, 다음 인수인계 하나를 둡니다. 이 규칙을 지켜야 자동화 에이전트가 많아져도 책임이 흐려지지 않습니다.
예를 들어 M160a runtime capture를 하나의 작업 단위로 보면 입력은 승인된 CPU 자극 계약이고, 출력은 별도 경로에 저장된 시뮬레이터 계측 묶음입니다. 게이트는 스케줄 ID와 reset pair가 실제 trace에 보존됐는지, post-policy/pre-physics 위치의 값이 누락되지 않았는지, 기존 산출물이 덮어써지지 않았는지를 검사해야 합니다. 통과한 뒤에만 응답 분석 작업으로 넘깁니다. ‘G1 실험’처럼 큰 이름 하나로 묶으면 누가 어느 파일을 승인했는지 다시 추적하기 어렵습니다.
라우터는 가장 마지막에 증거를 소비합니다
robot-control-router는 자연어 또는 태스크 요청을 BackendRequest로 만들고, Selector가 로봇·태스크 규칙에 따라 scripted·WBC·RL·VLA 중 하나를 고른 뒤, Adapter가 로봇별 joint command로 바꾸는 실행층입니다. 인터페이스가 존재한다는 것은 새 백엔드를 같은 형식으로 호출할 수 있다는 뜻이지, 그 백엔드의 정책이 승인됐다는 뜻은 아닙니다.
현재 scripted와 WBC 경로는 동작하고 RL checkpoint loading 경로도 구현돼 있습니다. VLA는 서버가 없을 때 dummy fallback을 반환합니다. 여기에 비교용 G1 checkpoint를 바로 넣으면 라우터 테스트의 성공과 정책 품질의 승격이 섞입니다. 그래서 레지스트리는 어떤 model ID가 어느 평가 게이트를 통과했는지 알려 주고, 라우터는 승인된 ID만 소비해야 합니다. 지금 워크스페이스에서 레지스트리–라우터 인수인계가 약하다고 제가 판단한 이유가 바로 이 부분입니다.
자동화가 늘어날수록 산출물 수를 줄여야 합니다
계획, 실행, 검토를 여러 도구가 나누면 문서는 빠르게 늘어납니다. 하지만 계획서·검토서·요약서가 서로 같은 사실을 복사하면 어느 문서가 결정을 소유하는지 불분명해집니다. 제가 원하는 자동화는 여러 에이전트가 각각 긴 보고서를 만드는 구조가 아니라, 하나의 입력 산출물을 받아 하나의 출력과 판정만 남기고 다음 소유자에게 넘기는 구조입니다.
이 원칙은 현재 구조의 완성 선언이 아닙니다. 오히려 지금 쌓인 산출물의 양과 레지스트리 빈칸을 실패 신호로 보고 정한 축소 규칙입니다. 다음 구조 변경은 새 에이전트를 추가하는 것보다, 같은 사실을 가리키는 문서를 합치고 승인 경로를 한 곳으로 만드는 데 먼저 쓰여야 합니다.
지금 이 지도가 가리키는 다음 단계
가장 가까운 다음 일은 M160a를 바로 Isaac Sim에서 실행하는 것이 아닙니다. post-policy/pre-physics 지점에 계측을 넣고 기존 산출물을 덮어쓰지 않는 runtime-capture 제안을 별도로 작성한 뒤, 다시 적대검토를 받는 것입니다. 이 지도의 목적은 완성도를 과시하는 데 있지 않습니다. 지금 열 수 있는 문과 아직 닫아 둬야 하는 문을 한눈에 구분하는 데 있습니다.
관련 글: Physical AI 전체 파이프라인 · 학습과 실험을 멈추는 기준 · 워크스페이스를 읽는 순서