G1 모션 트래킹 정책을 처음 학습했을 때, 환경에는 이미 9개의 reward term이 있었습니다. 몸통의 위치와 자세, 여러 링크의 위치와 자세, 선속도와 각속도까지 비교하니 필요한 항은 거의 다 들어간 것처럼 보였습니다. 실제로 첫 정책은 10초 평가에서 95.31%의 환경이 끝까지 살아남았고, 평균 body position error도 0.0666m였습니다. 그런데 로봇은 같은 시간 동안 1.670m만 이동했습니다. reference는 3.720m를 전진했으므로 진행률은 43.35%, 평면 경로 오차는 2.256m였습니다.
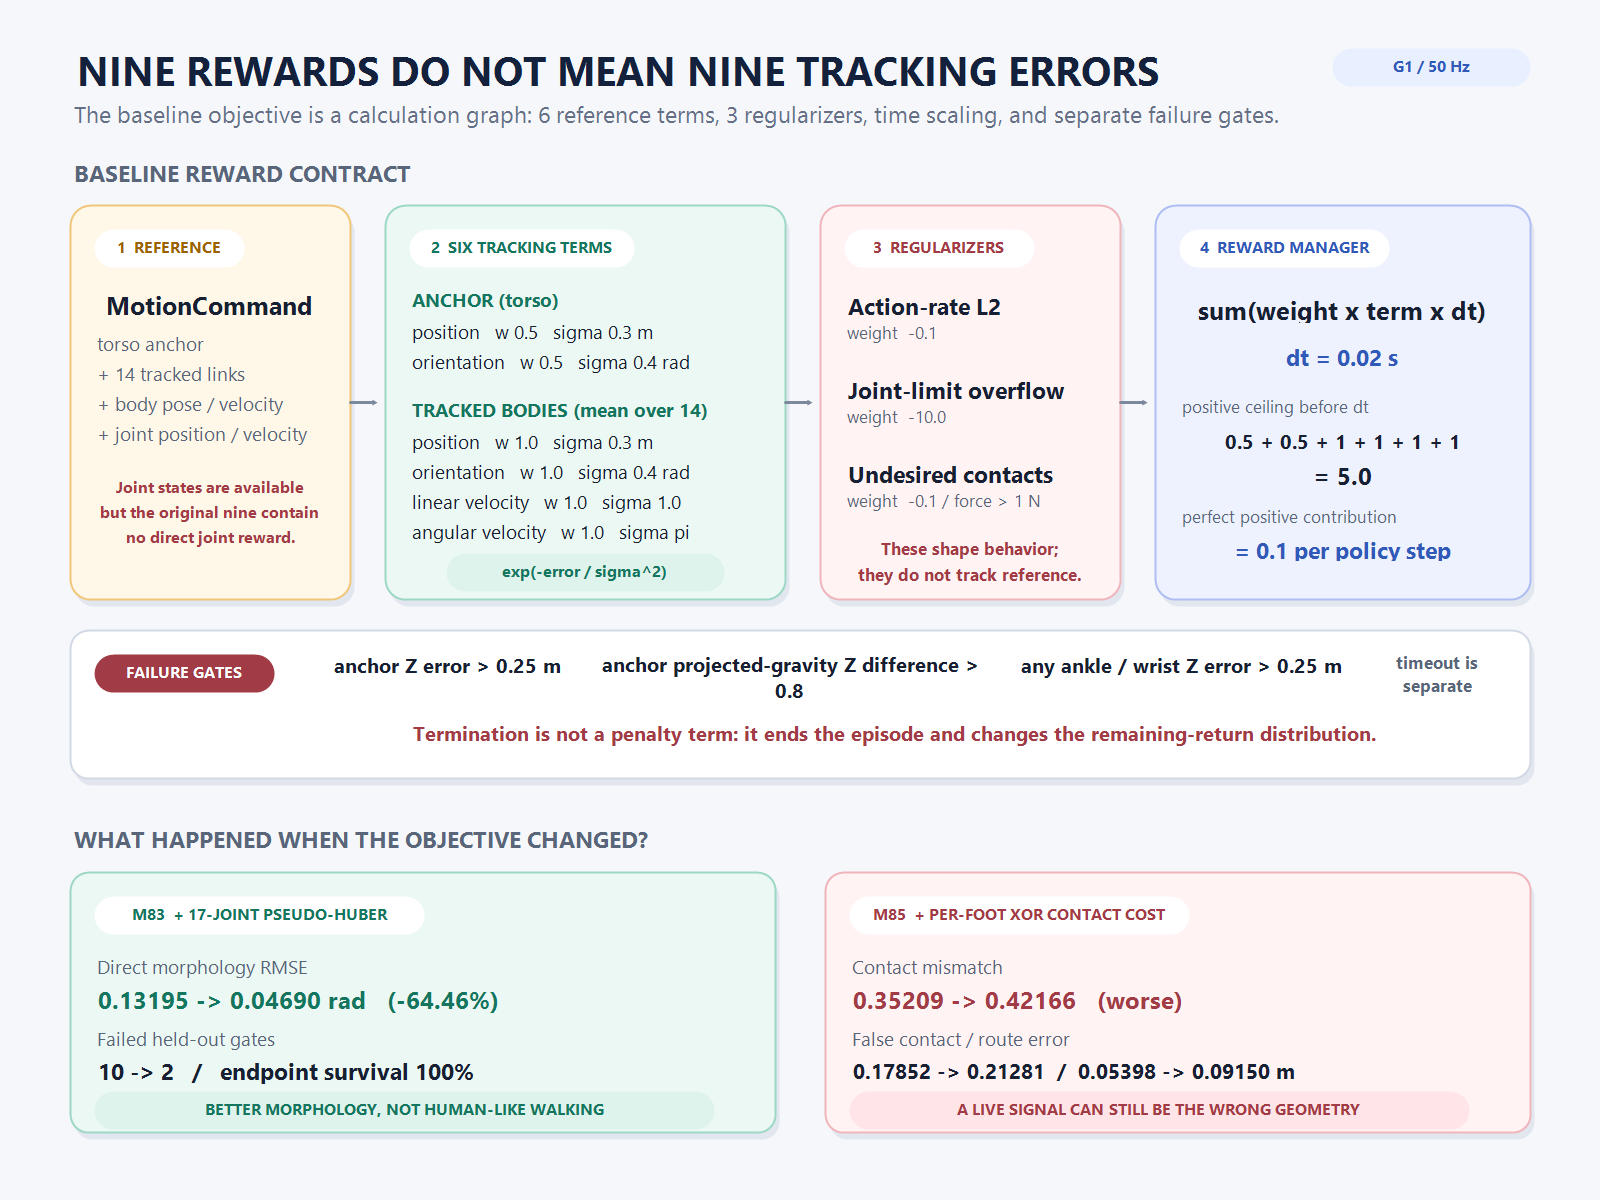
더 뒤의 실험에서는 문제가 한층 구체적으로 드러났습니다. 기준 정책의 17개 관절 직접 추적 RMSE는 0.13195rad였고, 미리 정한 형태·경로·접촉 평가 항목 가운데 10개를 통과하지 못했습니다. “reward가 9개나 있는데 왜 관절은 reference 자세를 놓치는가?”라는 질문이 생겼습니다. 설정 파일을 다시 읽고서야 전제가 틀렸다는 것을 확인했습니다. 기본 9개는 9개의 reference 오차가 아니었습니다. 6개만 reference를 추적했고, 나머지 3개는 행동 변화·관절 한계·원치 않는 접촉을 억제하는 규제 항이었습니다. 더 중요한 사실은 원래 보상식에 관절 위치나 관절 속도를 직접 비교하는 항이 없었다는 점입니다.
이 글은 사람 모션을 G1의 50Hz reference trajectory로 만드는 과정 다음 단계의 기록입니다. reference frame이 준비된 뒤 어떤 tensor끼리 비교되고, 지수형 보상과 가중치가 어떻게 한 스텝의 reward가 되며, 종료 조건이 왜 penalty와 다른지 실제 구현을 기준으로 정리합니다. PPO의 일반적인 계산은 PPO 소개글, 로그 해석은 PPO 학습 로그 읽는 법, 보상 우회 행동의 일반적인 사례는 reward hacking 실험 기록에 분리해 두었습니다.
한 프레임에서 reference와 robot state가 만나는 방법
현재 환경은 whole_body_tracking의 BeyondMimic형 구성을 바탕으로 합니다. MotionCommand는 50Hz NPZ에서 현재 frame index에 해당하는 reference를 꺼냅니다. 여기에는 29개 관절의 위치·속도와 각 body의 위치·자세·선속도·각속도가 함께 들어 있습니다. 로봇 쪽에서는 같은 이름의 articulation state를 읽습니다. 보상 함수는 이 두 상태 전체를 자동으로 비교하지 않습니다. 각 reward term이 명시적으로 선택한 tensor만 비교합니다.
G1 설정에서 anchor는 torso_link입니다. body 추적에는 pelvis, 양쪽 hip roll, knee, ankle roll, torso, shoulder roll, elbow, wrist yaw까지 14개 링크를 사용합니다. 여기서 anchor와 body를 나누는 이유는 몸통의 전역 기준을 별도로 고정하면서, 나머지 링크의 상대적인 전신 움직임을 평균으로 묶기 위해서입니다.
reference frame at t
  joint_pos, joint_vel                   # command에는 존재
  anchor pose                            # torso_link
  14 body poses and velocities

robot state at t
  joint_pos, joint_vel
  anchor pose
  14 body poses and velocities

baseline reward
  compares anchor/body pose and velocity
  does not directly compare joint_pos or joint_vel
이 구분이 중요합니다. 손목과 팔꿈치의 Cartesian 위치가 대략 맞더라도 어깨와 팔꿈치 관절각 조합은 여러 개일 수 있습니다. 더구나 body term은 14개 링크의 오차를 평균냅니다. 특정 shoulder·waist·hip 관절의 오차가 커도 나머지 링크가 잘 맞으면 평균 안에서 희석될 수 있습니다. body 추적이 관절을 전혀 제약하지 않는다는 뜻은 아닙니다. forward kinematics로 연결되어 있으므로 간접적인 제약은 생깁니다. 다만 “각 관절이 reference 관절각을 얼마나 놓쳤는가”에 독립적인 학습 신호를 주는 것과는 다릅니다.
reference를 직접 추적하는 항은 여섯 개입니다
공식 환경 설정과 reward 구현을 기준으로 기본 추적 항을 풀면 다음과 같습니다.
| reward term | 비교하는 오차 | weight | 표준 폭 σ | 집계 방식 |
|---|---|---|---|---|
motion_global_anchor_pos |
torso anchor의 world position | 0.5 | 0.3m | 3축 제곱거리 합 |
motion_global_anchor_ori |
torso anchor의 quaternion 자세 | 0.5 | 0.4rad | quaternion 거리 제곱 |
motion_body_pos |
14개 body의 Cartesian position | 1.0 | 0.3m | body별 제곱거리의 평균 |
motion_body_ori |
14개 body의 quaternion 자세 | 1.0 | 0.4rad | body별 자세 오차 제곱의 평균 |
motion_body_lin_vel |
14개 body의 3D 선속도 | 1.0 | 1.0m/s | body별 속도 오차 제곱의 평균 |
motion_body_ang_vel |
14개 body의 3D 각속도 | 1.0 | 3.14rad/s | body별 각속도 오차 제곱의 평균 |
여섯 항은 모두 오차가 0일 때 1에 가까워지고 오차가 커질수록 0으로 내려가는 지수형 kernel을 사용합니다. 코드에서는 위치 차이의 제곱합이나 body 평균 제곱오차를 먼저 error로 만든 뒤 다음 형태로 변환합니다.
score = exp(-error / sigma^2)
weighted_score = weight * score
σ는 단순한 단위 변환값이 아닙니다. 오차에 얼마나 민감하게 반응할지를 정합니다. 한 축이 아니라 RMS 크기로 단순화해 보면 오차가 σ와 같을 때 점수는 exp(-1) ≈ 0.368입니다. anchor position의 σ가 0.3m이므로 거리 오차가 0.15m일 때 약 0.779, 0.3m일 때 0.368, 0.6m일 때 0.018까지 떨어집니다.
| anchor position error | exp(-d² / 0.3²) |
해석 |
|---|---|---|
| 0m | 1.000 | reference와 일치 |
| 0.15m | 0.779 | 완만한 감소 구간 |
| 0.30m | 0.368 | σ에 해당하는 오차 |
| 0.60m | 0.018 | 거의 포화된 큰 오차 |
지수형 보상의 장점은 목표 근처에서 부드럽고 유한한 점수를 만든다는 것입니다. 반대로 reference에서 아주 멀어지면 값이 0에 가까워져 추가 오차에 대한 차이가 작아집니다. 따라서 초기 상태가 목표와 멀거나 특정 관절만 크게 빗나간 경우, 해당 방향의 gradient가 충분히 선명하지 않을 수 있습니다. 이것만으로 모든 실패 원인을 증명할 수는 없지만, 이후 직접 관절 항을 지수형이 아닌 pseudo-Huber 형태로 추가한 이유는 설명합니다.
나머지 세 항은 reference 추적이 아니라 규제입니다
기본 9개 중 남은 세 항은 점수를 주는 reference tracking 항이 아니라 비용을 빼는 regularizer입니다. 이름과 부호를 함께 봐야 역할이 보입니다.
| reward term | 계산 | weight | 의도 |
|---|---|---|---|
action_rate_l2 |
현재 action과 이전 action 차이의 제곱합 | -0.1 | 스텝마다 명령이 급격히 바뀌는 것을 억제 |
joint_limit |
soft joint position limit 밖으로 나간 거리의 합 | -10.0 | 관절 한계 초과 억제 |
undesired_contacts |
접촉력이 1N을 넘은 원치 않는 body의 수 | -0.1 | 발목·손목 말단 이외 body 충돌 억제 |
action_rate_l2는 부드러운 동작을 유도하지만 reference 관절 속도를 추적하는 항은 아닙니다. action이 계속 같은 값이면 관절 운동이 틀려도 비용이 작을 수 있습니다. joint_limit도 reference 관절각과의 차이가 아니라 허용 범위 밖으로 벗어난 양만 봅니다. 범위 안에서는 reference와 0.2rad 차이가 나든 0.02rad 차이가 나든 이 항의 값은 같습니다. undesired_contacts는 특정 body가 바닥이나 다른 물체와 부딪히는 것을 세지만, 좌우 발이 reference phase에 맞춰 디뎠는지는 말해 주지 않습니다.
세 항 모두 필요합니다. 그러나 이들을 “추적 오차”로 세면 목표 함수가 실제보다 촘촘하다고 착각하게 됩니다. 보상 목록을 검토할 때는 term 개수가 아니라 어떤 tensor를 읽고, 어떤 차이를 만들고, body·joint·time 축을 어떻게 합치는가를 확인해야 합니다.
한 스텝의 reward에는 0.02초가 곱해집니다
Isaac Lab의 RewardManager는 각 term의 함수값에 weight와 환경의 dt를 곱한 뒤 합합니다. 현재 policy step은 0.02초, 즉 50Hz입니다.
reward_per_step
  = sum(term_value * weight * dt)
  = sum(term_value * weight * 0.02)
여섯 positive term의 최대 가중치 합은 0.5 + 0.5 + 1 + 1 + 1 + 1 = 5.0입니다. 모든 추적 오차가 0이고 penalty가 없다면 한 policy step의 positive contribution은 5.0 × 0.02 = 0.1입니다. 50스텝, 즉 1초 동안 완벽하게 추적하면 penalty 전 누적값은 약 5가 됩니다.
여기서 흔한 실수가 두 가지입니다. 첫째, 50Hz에서 얻은 weight를 100Hz 환경에 그대로 옮기면서 한 스텝 값만 비교하는 것입니다. dt를 포함하면 시간당 적분값은 비슷할 수 있지만 action-rate처럼 스텝 간 차이를 쓰는 항은 제어 주기가 바뀌면 물리적 의미까지 달라집니다. 둘째, RewardManager가 로그에 term을 dt로 다시 나눈 형태로 보고할 수 있는데, 그 값을 실제 return에 더해진 값으로 해석하는 것입니다. 학습 로그와 reward 함수를 대조할 때는 “함수값, weight 적용값, dt 적용값, episode 누적값” 중 무엇을 보고 있는지 먼저 고정해야 합니다.
종료 조건은 큰 음수 reward가 아닙니다
기본 설정에는 timeout과 세 가지 조기 실패 gate가 있습니다. 구현은 terminations.py에서 확인할 수 있습니다.
| 조건 | 현재 threshold | 실제로 비교하는 값 |
|---|---|---|
| anchor position failure | 0.25m | reference torso와 robot torso의 수직 Z 오차만 비교 |
| anchor orientation failure | 0.8 | 두 torso frame으로 투영한 gravity의 Z 성분 차이 |
| end-effector body failure | 0.25m | 좌우 ankle·wrist 중 하나라도 reference와 수직 Z 오차 초과 |
| time out | episode length | 정해진 시간에 도달한 정상 truncation 경로 |
두 번째 조건을 “자세 오차가 0.8rad를 넘으면 종료”라고 읽으면 틀립니다. quaternion geodesic distance가 아니라 projected gravity의 특정 성분 차이를 봅니다. 첫 번째와 세 번째도 3D 거리가 아니라 Z축만 봅니다. 설정 이름이나 threshold 숫자만 보지 않고 함수가 반환하는 물리량까지 읽어야 하는 이유입니다.
종료는 reward term과 별도입니다. threshold를 넘는 순간 episode가 끝나고 이후에 받을 수 있었던 모든 return이 사라집니다. 따라서 -10 같은 penalty 하나를 더하는 것과 학습 효과가 같지 않습니다. timeout은 실패 termination과 bootstrap 의미도 다릅니다. terminated·truncated·reset·terminal snapshot의 일반적인 처리 과정은 G1 종료 조건과 reset 계약에 따로 정리했습니다.
M1: 살아남는 것과 경로를 따라가는 것은 달랐습니다
첫 전체 motion-tracking 학습 M1은 4,096개 병렬 환경에서 PPO를 model 298까지 학습했습니다. actor observation 160차원, critic observation 286차원, action 29차원, tracked link 14개, 기본 reward 9개라는 wiring을 확인했습니다. 결정론적 64환경, 10초 평가 결과는 survival 95.31%, body position error 0.0666m, body orientation error 0.2948rad였습니다.
그러나 이동 경로를 별도로 측정하자 reference가 3.720m 가는 동안 robot은 1.670m만 이동했습니다. 진행률 43.35%, planar tracking error 2.256m였습니다. body 평균 오차와 생존율이 좋아 보여도 전역 경로를 따라갔다고 말할 수 없었습니다. 이때부터 survival은 안전 gate로, route progress와 planar error는 별도 acceptance gate로 분리했습니다. checkpoint를 학습 로그가 아니라 고정 scenario와 held-out gate로 판단하는 절차는 checkpoint 평가 계약에서 설명합니다.
M82에서 actuator 부족보다 목적함수의 빈칸을 먼저 의심했습니다
관절 오차를 곧바로 reward 문제라고 단정하지는 않았습니다. M82에서는 특히 오른쪽 shoulder 목표가 물리적으로 가능한지, 명령이 관절에 도달하기 전에 actuator나 frozen policy loop에서 막히는지 확인했습니다. 필요한 shoulder 속도는 1.618rad/s, 단순 torque proxy는 1.458Nm였고 모델 한계인 37rad/s와 25Nm보다 충분히 작았습니다. command-to-joint delay도 약 0.04초였습니다.
반면 이전 one-joint residual 실험에서는 target을 0.0369rad 바꿨는데 실제 관절 행동 변화는 0.00018rad뿐이었습니다. 동결된 whole-body loop가 한 관절에 준 작은 residual을 상쇄하고 있었습니다. 즉 “모터가 못 움직인다”보다 “기존 목적함수와 정책이 그 변화를 유지할 이유가 없다”는 설명이 측정값에 더 잘 맞았습니다. 이 진단 뒤에야 reward graph에 직접 관절 항을 추가했습니다.
M83: 17개 관절을 직접 비교하자 형태 오차는 줄었습니다
M83은 M50/model 1875에서 시작해 단 하나만 바꿨습니다. waist 3개, 좌우 hip pitch·roll·yaw 6개, 좌우 shoulder pitch·roll·yaw와 elbow 8개, 총 17개 관절의 reference position과 robot position을 직접 비교하는 pseudo-Huber cost를 추가했습니다. observation, action, actuator, 기존 9개 reward, termination threshold, reference motion은 그대로 유지했습니다.
e = (robot_joint_pos - reference_joint_pos) / 0.1 rad
cost = mean(sqrt(1 + e^2) - 1)   # pseudo-Huber, delta = 1
reward contribution = -1.0 * cost
지수형 tracking reward는 큰 오차에서 0 근처로 포화되지만 pseudo-Huber cost는 작은 오차에서는 제곱형으로 부드럽고, 큰 오차에서는 거의 선형으로 계속 증가합니다. 17개 관절을 각각 비교한 뒤 평균내므로 shoulder 하나의 오차가 body Cartesian 평균 속에서 완전히 사라지지도 않습니다.
one-update canary는 wiring 확인용으로만 사용하고 버렸습니다. 이후 4,096환경, 250 PPO update, 24.576M transition의 독립 continuation을 실행했습니다. 25 update 간격의 여섯 checkpoint를 모두 같은 64환경·10초 평가로 비교했습니다.
| checkpoint | route error (m) | action rate | 17-joint RMSE (rad) | right shoulder excursion error (rad) | 실패 gate |
|---|---|---|---|---|---|
| M50/1875 baseline | 0.05561 | 0.08701 | 0.13195 | 0.15874 | 10 |
| M83/1900 | 0.09142 | 0.10257 | 0.11921 | 0.20933 | 12 |
| M83/1950 | 0.05034 | 0.08724 | 0.07622 | 0.18708 | 7 |
| M83/2000 | 0.08440 | 0.08223 | 0.06151 | 0.16875 | 5 |
| M83/2050 | 0.07219 | 0.07708 | 0.05329 | 0.10446 | 3 |
| M83/2100 | 0.07796 | 0.07450 | 0.04861 | 0.04670 | 2 |
| M83/2124 | 0.05398 | 0.07305 | 0.04690 | 0.06256 | 2 |
endpoint에서 17-joint RMSE는 0.13195rad에서 0.04690rad로 64.46% 줄었고, right shoulder excursion error는 60.59% 감소했습니다. 실패 gate는 10개에서 2개로 줄었으며 survival은 100%, foot crossing은 0이었습니다. 첫 checkpoint인 1900에서는 오히려 shoulder 오차와 실패 gate가 악화됐다가 뒤에서 개선됐습니다. 한 번의 update나 마지막 checkpoint 하나만 보고 결론을 내렸다면 방향을 잘못 판단할 수 있었습니다.
그렇다고 M83을 “사람처럼 걷는 정책”으로 승인하지는 않았습니다. foot-lane mean error는 0.09587m에서 0.05261m로 좋아졌지만 여전히 gate를 통과하지 못했습니다. reference double-support 구간의 hip-phase error는 0.02379rad에서 0.06204rad로 나빠졌습니다. route와 action quality도 연속 세 sentinel에서 승격 조건을 만족하지 못했습니다. M83은 직접 형태 오차를 줄이는 새 subsystem parent이지 완성된 보행 정책이 아닙니다.
M84: 남은 hip 실패는 관절 gradient 부족이 아니었습니다
여기서 hip reward를 더 세게 주는 선택은 쉬웠습니다. 하지만 M84에서는 PPO를 돌리지 않고 M50과 M83의 같은 reference·contact trace를 정렬해 실패 구간을 다시 봤습니다. M83의 reference double-support 중 hip RMSE는 좋아졌지만, robot이 같은 support 상태에 있던 비율은 85.06%에서 71.17%로 떨어졌습니다. 어느 발이든 contact가 다른 비율은 35.21%로 남았습니다.
이 결과는 double-support hip gate가 “hip 관절에 gradient가 부족하다”기보다 contact alignment와 phase occupancy에 민감하다는 쪽을 지지했습니다. 그래서 hip joint weight를 추가로 올리는 안은 기각했습니다. 하나의 gate 이름에 hip이 들어 있어도 그 gate가 실제로 측정하는 실패 원인은 다른 계층에 있을 수 있습니다.
M85: 접촉 신호를 직접 넣었는데 접촉은 더 나빠졌습니다
M85에서는 M83을 유지하고 좌우 발마다 reference contact와 robot contact가 다르면 비용을 주는 항 하나만 추가했습니다. 두 발이 모두 맞으면 0, 한 발이 다르면 0.5, 두 발이 다르면 1인 이진 XOR cost이며 weight는 -0.25였습니다. robot contact 판정에는 10N threshold를 사용했습니다.
reference_contact = [left_ref, right_ref]
robot_contact     = [left_robot, right_robot]
cost = mean(reference_contact != robot_contact)  # 0, 0.5, or 1
reward contribution = -0.25 * cost
canary를 버린 뒤 4,096환경, 150 PPO update, 14.746M transition을 독립적으로 학습했습니다. 하지만 여섯 checkpoint가 모두 세 개의 접촉 목표를 함께 악화시켰습니다. endpoint M85/2273에서 contact mismatch는 0.35209에서 0.42166으로, false contact는 0.17852에서 0.21281로, route error는 0.05398m에서 0.09150m로 나빠졌습니다. morphology RMSE만 0.04690rad에서 0.04598rad로 비슷하게 유지됐습니다. M85 계열은 전부 기각하고 M83을 parent로 남겼습니다.
관측 정보가 없어서 binary contact 항을 배울 수 없었던 것인지도 검사했습니다. M86의 no-PPO ridge probe는 기존 160차원 actor observation에서 좌우 reference contact를 서로 분리된 환경·시간 holdout 기준 최소 balanced accuracy 98.86%로 복원했습니다. 이 결과는 “support bit가 observation에 없어서 실패했다”는 설명을 약하게 만듭니다. 대신 불연속적인 0/0.5/1 비용이 작은 timing 차이를 같은 크기의 실패로 묶고, 기존의 부드러운 body·velocity tracking 신호와 충돌했을 가능성이 더 잘 남습니다. 이것이 모든 환경에 대한 인과 증명은 아니지만, 현재 측정 안에서는 M85 weight를 반복 조정하거나 support bit를 무작정 추가할 이유가 없었습니다.
reward를 추가하기 전에 확인하는 일곱 가지
이 일련의 실험 뒤에는 reward term을 이름이나 개수로 관리하지 않습니다. 새 항을 넣기 전에 다음 질문을 계산 그래프 순서대로 적습니다.
- 목표 tensor는 무엇인가. world body position인지, joint position인지, 접촉 상태인지 먼저 고정합니다.
- robot tensor와 같은 좌표계·단위·시간을 쓰는가. reference와 current state alias도 별도로 검사합니다.
- 오차의 geometry는 무엇인가. L2, quaternion distance, pseudo-Huber, binary XOR은 서로 다른 gradient를 만듭니다.
- 어느 축으로 합치는가. 14개 body 평균은 특정 관절 오차를 희석할 수 있고, 양발 평균은 한 발의 timing 차이를 0.5로 압축합니다.
- weight와 dt 뒤의 실제 크기는 얼마인가. 로그에 표시된 값과 return에 더해진 값을 구분합니다.
- 다른 term·termination과 경쟁하지 않는가. 관절 형태를 더 맞추면서 support phase나 route를 악화시킬 수 있습니다.
- held-out gate가 무엇인가. 새 term 자체의 평균이 좋아진 것만으로 정책을 승격하지 않습니다.
M83은 target이었던 17-joint RMSE를 크게 줄였지만 contact·phase gate를 모두 해결하지 못했습니다. M85는 학습 가능한 신호였지만 선택한 이진 geometry가 원하는 접촉 행동으로 이어지지 않았습니다. “신호가 존재한다”, “정책이 그 신호를 관측할 수 있다”, “그 reward를 높이면 실제 행동이 좋아진다”는 서로 다른 주장입니다.
현재 결론: reward는 요구사항 목록이 아니라 계산 그래프입니다
기본 환경에 reward가 9개 있다는 사실만으로 reference motion이 촘촘히 감독된다고 말할 수는 없었습니다. 실제 구성은 torso anchor와 14개 body의 pose·velocity를 추적하는 여섯 항, action rate·joint limit·undesired contact를 억제하는 세 항이었습니다. 관절 상태는 command와 observation에 존재했지만 기본식에는 직접 관절 추적 항이 없었습니다.
직접 pseudo-Huber 관절 항을 추가하자 해당 형태 오차는 분명히 줄었습니다. 그러나 보행 전체가 완성되지는 않았습니다. 반대로 contact mismatch를 직접 penalty로 만들었을 때는 신호가 살아 있고 관측에서도 복원 가능했지만 실제 접촉과 경로가 더 나빠졌습니다. 결국 reward는 “원하는 행동을 적어 둔 문장”이 아니라 tensor 선택, 오차 geometry, aggregation, weight, 시간 적분, termination, 검증 gate가 서로 경쟁하는 계산 그래프입니다. 다음 실험은 term을 하나 더 넣는 데서 시작하지 않고, 남은 실패가 어느 tensor와 시간축에서 처음 발생하는지 찾는 데서 시작해야 합니다.
기술 기준 시점: 2026-07-22. 구현 설명은 origin/main@ee4d96e의 G1 motion-tracking 설정, training/rl/g1_motion_tracking_rewards.py, M1·M82~M86 실험 기록과 official whole_body_tracking·Isaac Lab 소스를 기준으로 작성했습니다. 수치는 64개 시뮬레이션 환경의 결정론적 10초 평가이며 실제 G1 하드웨어 배포 결과가 아닙니다. 방법 배경은 BeyondMimic 논문과 프로젝트 페이지를 참고했습니다.