M68의 one-update canary가 저장한 shape는 actor 205차원, critic 286차원, action 29차원이었습니다. 이후 seed 42에서 100 update를 두 block 실행했고, model_2225.pt는 M62 대비 vertical CAM z RMSE가 3.77%, arm contribution이 6.43% 개선됐습니다. 여기까지는 한 seed 결과였습니다. 그래서 seed 43·44를 M62/2100에서 새로 시작해 각각 125 update를 실행했습니다. 세 seed 모두 두 효과를 재현했지만 seed 44에서 right-shoulder-pitch residual saturation이 0.003125% 발생해 사전 고정한 zero-saturation gate를 통과하지 못했습니다.
후속 M69는 극단적인 CAM error가 bilinear 입력을 크게 만드는 경로만 tanh로 제한했습니다. seed 42·43·44를 각각 125 update 학습한 endpoint는 vertical CAM z RMSE를 3.54–4.37%, arm contribution을 5.48–6.66% 개선했고 termination·crossing·saturation tail이 모두 0이었습니다. 이것으로 승인된 것은 bounded arm subsystem입니다. whole-body visual과 randomized gate가 남아 있어 parent policy와 실제 로봇 경로는 여전히 승격하지 않았습니다.
M28에도 privileged라는 이름이 붙어 있었습니다. 하지만 구조는 전혀 달랐습니다. recovery actor와 critic이 모두 303차원 privileged observation을 받았습니다. 접촉, 발 간격, 기준 동작 오차, 외력 변화와 recovery mode가 actor의 action 계산에 직접 들어갔습니다. 실제 no-PPO smoke에서 배선은 검증됐지만 coast stance bias가 +0.060679 m로 허용치 +0.053304 m를 넘었습니다. PPO를 시작하지 않았고 checkpoint도 만들지 않았습니다.
두 경로를 같은 “privileged learning”으로 부르면 핵심 차이가 사라집니다. M68은 critic만 더 많이 보는 asymmetric actor–critic입니다. M28은 actor도 simulator-only 정보를 보는 privileged expert입니다. 전자는 actor 입력만 실제 시스템에서 만들 수 있다면 actor-only 추론이 가능합니다. 후자는 그대로 배포할 수 없으며, 별도 student로 증류하거나 같은 정보를 실제 센서·추정기로 복원해야 합니다.
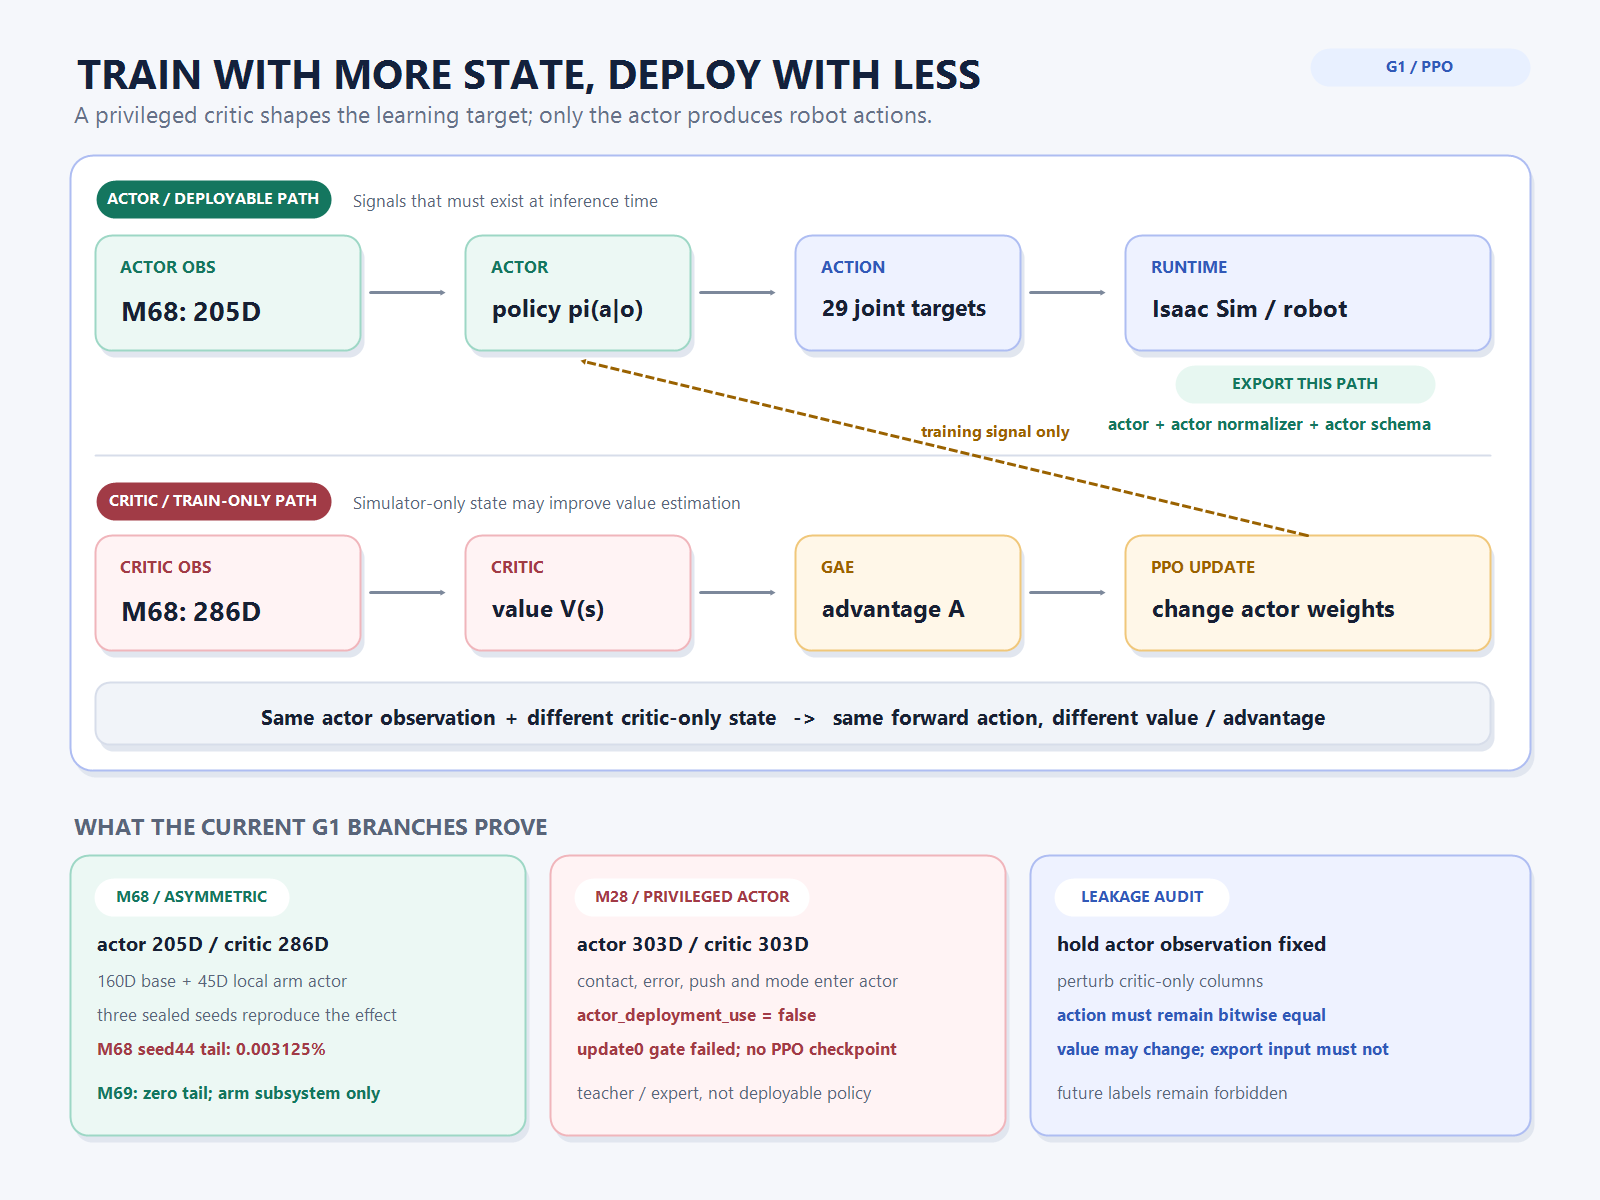
asymmetric actor–critic은 입력 비대칭이지 행동 경로 이중화가 아닙니다
PPO 소개글에서 actor는 행동 분포를 만들고 critic은 앞으로 받을 return의 기대값을 추정한다고 설명했습니다. 일반적인 actor–critic 설명은 두 network가 같은 observation을 받는 것처럼 그려집니다. asymmetric actor–critic에서는 역할은 그대로 두고 입력만 다르게 줍니다.
actor:  a_t ~ pi_theta(a | o_actor,t)
critic: V_phi(o_critic,t)

o_actor,t  = 실제 배포 시 만들 수 있는 관측
o_critic,t = o_actor,t + 시뮬레이터에서만 정확히 아는 상태
Pinto 등이 제안한 asymmetric actor–critic은 actor에 렌더링된 영상만 주고 critic에는 simulator의 full state를 주었습니다. critic은 더 완전한 상태에서 return을 예측하지만, 실제 행동은 영상만 받은 actor가 만듭니다. 이 구조의 목적은 simulator가 가진 정보를 버리지 않으면서도 배포 policy의 입력 제한을 지키는 데 있습니다.
critic이 별도의 action을 내거나 actor를 runtime에서 보정하는 것은 아닙니다. 학습 중 두 network가 같은 rollout을 보되, actor는 자신의 observation으로 action 확률을 계산하고 critic은 더 넓은 observation으로 value를 계산합니다. 추론 단계에서는 critic을 호출하지 않습니다. 이 경계를 놓치면 “critic이 접촉력을 봤으니 배포 policy도 접촉력 센서가 필요하다”거나, 반대로 “privileged라는 이름이 있으니 actor는 배포 가능하다”는 잘못된 결론이 나옵니다.
Isaac Lab은 observation group을 actor와 critic 입력으로 따로 매핑합니다
Isaac Lab의 RSL-RL 설정은 environment가 만든 observation group을 algorithm의 observation set에 매핑합니다. 공식 문서의 예시는 policy와 image를 actor 쪽에, policy와 privileged group을 critic 쪽에 묶습니다.
obs_groups = {
    "policy": ["policy", "images"],
    "critic": ["policy", "privileged"],
}
현재 RSL-RL 5 계열에서는 actor와 critic이 별도 model입니다. PPO는 하나의 TensorDict를 두 model에 전달하지만, 각 model은 자신에게 설정된 observation set만 읽습니다. observation normalization 글에서 actor와 critic의 running statistics를 따로 본 이유도 같습니다. 차원과 feature 분포가 다른 입력을 같은 normalizer로 처리하면 입력 계약 자체가 섞입니다.
강화학습 환경의 observation 계약에서 어떤 feature를 만들지 정했다면, 여기서는 그 feature를 어느 network가 읽을지 정합니다. group 이름보다 중요한 것은 실제 mapping입니다. critic이라는 key가 존재해도 actor model이 그 group을 함께 읽도록 설정했다면 asymmetric 경계가 아닙니다. 반대로 한 TensorDict 안에 privileged tensor가 있어도 actor가 policy group만 선택한다면 action forward path에는 들어가지 않습니다. 따라서 배포 가능성은 변수 이름이 아니라 model의 입력 dependency로 판정해야 합니다.
privileged state는 advantage를 통해 actor의 학습 방향에만 영향을 줍니다
RSL-RL PPO 구현의 act()는 같은 pre-step observation에서 actor action과 critic value를 각각 계산해 rollout에 저장합니다. rollout 마지막에는 critic으로 bootstrap value를 구하고, TD error와 GAE를 역순으로 계산합니다.
a_t = actor(o_actor,t)
V_t = critic(o_critic,t)

delta_t = r_t + gamma * V_(t+1) - V_t
A_t = delta_t + gamma * lambda * A_(t+1)

PPO actor update uses A_t
critic update fits V_t to the return target
critic-only feature는 action 식의 입력이 아닙니다. 대신 V_t와 A_t를 바꿔 어떤 행동이 기대보다 좋았는지를 구분하는 기준에 영향을 줍니다. 같은 actor observation과 같은 action이라도 simulator의 숨은 상태가 달라 앞으로 넘어질 가능성이 다르면 critic은 서로 다른 value를 낼 수 있습니다. actor는 그 차이를 직접 보지 못하지만, 여러 rollout에서 계산된 advantage를 통해 자신의 제한된 observation으로 구분 가능한 패턴을 학습합니다.
이것이 critic을 단순한 학습 보조 장치라고 부르기 어려운 이유입니다. critic parameter는 배포하지 않아도, critic이 만든 advantage는 actor parameter가 어떤 방향으로 움직였는지에 이미 반영돼 있습니다. actor-only inference 재현에는 actor state만 필요하지만, 동일한 학습을 재현하려면 critic state와 critic observation, critic normalizer까지 필요합니다.
G1 기본 경로에는 160차원 actor와 286차원 critic 계약이 있습니다
현재 motion-tracking baseline은 actor 160차원, critic 286차원, action 29차원입니다. 이 경계는 M28 recovery actor를 M15와 동일하게 초기화하는 코드에서 더 명확하게 드러납니다. 286차원 critic observation 가운데 0:67과 193:286 구간을 골라 160차원 policy observation을 복원합니다.
policy_indices = concat(
    range(0, 67),
    range(193, 286),
)

policy_obs = critic_obs[:, policy_indices]  # 67 + 93 = 160
즉 중간 126개 값은 actor가 보지 않는 critic-only 구간입니다. 이 숫자는 단순한 network input size가 아니라 정보 접근 권한입니다. actor가 126개 feature를 사용하지 않는다는 사실과, critic이 그 feature로 value를 계산한다는 사실을 함께 보존해야 checkpoint를 다른 runtime에서 해석할 수 있습니다.
| 경로 | 입력 차원 | 출력 | runtime 책임 |
|---|---|---|---|
| M15/M62 actor | 160D policy observation | 29D action distribution | action 생성에 필요 |
| M15/M62 critic | 286D critic observation | 1D value | 학습·return 계산에 필요 |
| critic-only slice | 126D | 직접 출력 없음 | actor forward에서는 접근 금지 |
| actor-only inference | 160D + actor normalizer | 29D deterministic action | critic 없이 실행 |
현재 local code는 차원과 subset 경계를 hash·shape로 검사하지만, 126개 feature의 이름·단위·frame을 하나의 공통 manifest로 export하는 단계까지는 완성되지 않았습니다. 실제 로봇 연결을 주장하려면 “actor가 critic-only slice를 안 본다”는 검사와 함께 actor 160개 feature를 실제 센서·추정기에서 같은 순서로 만들 수 있는지도 확인해야 합니다.
M68에서는 205차원 actor와 286차원 critic을 실제로 따로 학습했습니다
M68은 M62 whole-body actor를 고정한 뒤 여덟 개 shoulder·elbow action만 수정하는 state-conditioned arm actor를 붙였습니다. actor observation은 기존 160차원 base와 45차원 arm-local observation을 합친 205차원입니다. local observation에는 base 높이·heading·속도·gravity, 여덟 arm joint의 현재-기준 위치·속도 오차, 이전 arm action, phase·support, 현재·기준 CAM이 들어갑니다.
critic은 기존 286차원 whole-body privileged observation을 유지했습니다. optimizer는 새 arm_feedback과 critic parameter만 소유했고, M62 actor와 action distribution은 frozen contract로 묶었습니다. 환경 step 뒤 critic normalizer만 갱신하고, isolated arm return으로 advantage를 계산했습니다. 이것은 “팔 actor는 자신에게 허용된 state로 행동하고, critic은 전신 상태로 그 행동의 장기 결과를 평가한다”는 centralized training, actor-only execution 경계입니다.
| 검증 단계 | 조건 | 관찰 | 판정 |
|---|---|---|---|
| one-update canary | 4,096 env × 24 step | 98,304 transition, 1,104개 arm feedback weight 변화, base actor bitwise 고정 | 배선·소유권만 통과 |
| block 1 | seed 42, 100 update | 9.83M transition, model 2199에서 z RMSE +2.71%, arm contribution +4.17% | 두 1% gate 통과, 계속 학습 |
| block 2 | 추가 100 update | model 2225에서 +3.77% / +6.43%, route 0.05506 m, saturation 0% | Pareto candidate 선택 |
| M68 multi-seed | seed 43·44 fresh 125 update + seed 42 endpoint | 세 seed에서 z +3.67–4.09%, arm +5.88–6.43%; seed 44 saturation 0.003125% | 효과 재현, strict gate 실패 |
| M69 bounded input | seed 42·43·44 fresh 125 update | z +3.54–4.37%, arm +5.48–6.66%; termination·crossing·tail 0 | arm subsystem만 승인 |
이 결과는 privileged critic이 성능을 보장한다는 증거가 아닙니다. M68의 architecture와 credit path가 세 seed에서 재현됐다는 증거이고, M69는 입력 tail을 제한하면 arm subsystem gate를 통과할 수 있다는 증거입니다. 그것만으로 whole-body policy가 승인되지는 않습니다. 현재 G1 학습 방법에서 학습 실행, subsystem 승인, parent checkpoint 승격을 분리한 원칙을 그대로 적용했습니다.
M28은 critic-only 구조가 아니라 simulation-only recovery expert입니다
M28의 privileged observation은 기존 286차원 critic observation에 contact support 2개, foot separation·closing speed 2개, anchor error 4개, end-effector 높이 오차 1개, push velocity delta 6개, mode·assistance 2개를 더한 303차원입니다. recovery actor와 recovery critic이 모두 이 303차원을 입력으로 받습니다.
M28 privileged observation =
    286D critic observation
  + 2D contact support
  + 2D foot separation / closing speed
  + 4D anchor errors
  + 1D end-effector z error
  + 6D push delta velocity
  + 2D recovery mode / assistance
  = 303D
설계 문서에도 actor_deployment_use: false가 명시돼 있습니다. clean mode에서는 M15 action을 bitwise 그대로 복사하고, risk switch가 켜진 환경 ID에만 recovery actor를 호출합니다. risk는 current pre-step state로만 계산하고 future termination label은 금지했습니다. 이것은 배포 actor의 critic을 강화한 것이 아니라, simulator-only 정보를 쓸 수 있는 별도 expert를 격리한 구조입니다.
실제 16-env no-PPO smoke에서는 recovery dispatch 441회, clean prefix·coast dispatch 0회, NaN/Inf 0, coast crossing 0을 확인했습니다. 그러나 robot/reference stance가 0.318934/0.258255 m였고 bias +0.060679 m가 M15 허용치 +0.053304 m를 넘었습니다. assistance를 1.0에서 0.5로 줄이거나 exit ramp를 바꿔도 개선되지 않았습니다. M28b wiring은 validated였지만 acceptance gate는 실패했습니다. 따라서 learning은 parse-time block 상태로 남았고 recovery checkpoint는 존재하지 않습니다.
privileged actor, asymmetric critic, teacher–student는 서로 다른 계약입니다
| 구조 | actor가 privileged state를 보는가 | critic이 보는가 | 그대로 actor-only 배포 가능한가 |
|---|---|---|---|
| 대칭 actor–critic | 아니오 | 아니오 | 가능 |
| asymmetric actor–critic | 아니오 | 예 | actor observation을 실제로 만들 수 있으면 가능 |
| privileged expert/teacher | 예 | 선택 사항 | 직접 배포 불가 |
| teacher–student distillation | teacher만 예 | 학습 방식에 따라 다름 | privileged input이 없는 student만 가능 |
teacher가 privileged state로 좋은 action을 만든 뒤 student가 제한된 observation으로 그 action을 모방하는 것은 별도 학습 단계입니다. M28에는 아직 그 student가 없습니다. 따라서 “privileged expert를 만들었다”와 “실제 로봇용 policy를 만들었다” 사이에 distillation·estimation·evaluation이 남아 있습니다. 구조 이름을 섞지 않아야 현재 구현 상태를 과장하지 않을 수 있습니다.
critic이 더 많이 보는 것이 항상 actor를 돕는 것은 아닙니다
critic의 추가 정보가 같은 observation에서 서로 다른 미래를 구분해 value error를 줄이면 advantage의 분산을 낮출 수 있습니다. 그러나 actor가 그 차이를 자신의 observation이나 history에서 전혀 추론할 수 없다면 최적 action을 상황별로 나눌 방법이 없습니다. critic은 “왜 결과가 달랐는지” 더 잘 설명해도 actor는 평균적인 대응만 학습할 수 있습니다. 이 상태를 관측 aliasing이라고 볼 수 있습니다.
또한 privileged feature가 current state가 아니라 미래의 낙상 label, 다음 reference 정답, post-step 결과처럼 action 이후에만 알 수 있는 정보라면 causal contract가 깨집니다. value loss가 낮아져도 실제 decision time에 존재하지 않는 답을 학습 기준으로 쓴 셈입니다. M28 spec이 risk 계산을 pre-step current state로 고정하고 future termination label을 금지한 이유입니다.
마지막으로 낮은 critic loss는 정책 품질 지표가 아닙니다. critic이 return을 더 정확히 맞췄다는 뜻이지 actor가 안정된 보행을 만들었다는 뜻은 아닙니다. M68은 세 seed에서 효과를 재현했지만 한 seed의 saturation tail 때문에 strict promotion이 닫혔고, M69가 tail을 제거한 뒤에도 승인 범위는 arm subsystem으로 제한됐습니다. critic 성능, actor update, subsystem gate, parent behavior gate를 따로 기록해야 합니다.
배포 누수는 같은 actor input에서 critic state만 바꿔 검사할 수 있습니다
현재 코드의 shape·hash guard를 privileged boundary까지 확장한다면 가장 직접적인 검사는 fixed-tape parity입니다. 같은 policy observation을 두 개의 TensorDict에 넣고 critic-only 구간만 바꿉니다. actor action은 bitwise 같아야 하고 critic value는 달라질 수 있습니다.
obs_a = {"policy": fixed_policy, "critic": critic_state_a}
obs_b = {"policy": fixed_policy, "critic": critic_state_b}

assert bitwise_equal(actor(obs_a), actor(obs_b))
assert finite(critic(obs_a)) and finite(critic(obs_b))

value difference is allowed; action difference means leakage| 검사 | 고정할 것 | 바꿀 것 | 통과 조건 |
|---|---|---|---|
| forward dependency | actor observation·weight·normalizer | critic-only feature | actor action bitwise equal |
| critic sensitivity | critic weight | privileged feature | value finite, 의도한 feature에 비영(非零) 반응 |
| time alignment | pre-step index | 환경 seed | future label·post-step 결과 없음 |
| export dependency | accepted actor checkpoint | critic 제거 | export graph 입력이 actor schema와 정확히 일치 |
| sensor availability | actor feature order | simulator 제거 | 각 feature가 sensor·estimator·command source에 매핑 |
| evaluation immutability | actor input tape | 반복 실행 | actor·normalizer hash와 action 동일 |
RSL-RL의 inference 경로는 algorithm을 eval mode로 바꾸고 policy model만 반환합니다. 하지만 library가 actor만 반환한다는 사실만으로 실제 로봇 배포가 증명되지는 않습니다. M68의 45차원 local observation 중 현재 CAM·reference CAM·support를 실제 runtime에서 어떤 sensor와 estimator로 만들지 아직 검증하지 않았습니다. software graph의 actor-only 경계와 physical sensing의 배포 가능성은 별도 gate입니다.
현재 구현 상태와 다음 leakage audit
| 항목 | 상태 | 근거 |
|---|---|---|
| M15/M62 160D actor·286D critic | implemented·executed | motion-tracking compatibility preflight와 checkpoint |
| M68 205D actor·286D critic | implemented·executed | canary, seed 42 두 block, seed 43·44 fresh 125-update 재현 |
| M68 model 2225 | observed, not accepted | 세 seed에서 효과 재현, seed 44 zero-saturation gate 실패 |
| M69 bounded arm subsystem | accepted for subsystem only | 세 fresh seed에서 효과 재현, termination·crossing·tail 0 |
| M69 parent whole-body policy | not accepted | whole-body visual·randomized gate 미완 |
| M28 303D privileged expert | implemented·executed smoke | 실제 no-PPO wiring 검증, update0 morphology gate 실패 |
| M28 recovery checkpoint | not created | PPO parse-time block 유지 |
| 공통 actor/critic leakage report | designed, not implemented | shape·hash 검사는 있으나 dependency audit artifact 없음 |
| real-robot actor feature mapping | not verified | M68 local CAM·support estimator 계약 미완 |
다음 구현은 M15와 M68 각각에 대해 privileged_leakage_audit.json을 만드는 것입니다. actor·critic schema SHA, actor-only export input, critic-only perturbation 전후 action parity, value delta, normalizer hash와 pre-step timing을 한 파일에 기록합니다. M68에는 205개 actor feature마다 sensor·estimator·command·simulator-only 중 하나의 source를 붙여 simulator-only actor 입력이 남아 있으면 export gate를 닫습니다.
critic이 더 많은 정보를 보는 목적은 배포할 때 몰래 답을 들고 가기 위해서가 아닙니다. 학습 중에 더 정확한 기준선을 만들되, 행동을 고르는 network에는 실제로 확보할 수 있는 정보만 남기기 위해서입니다. 현재 G1에서 M68은 이 software 경계를 유지한 학습 경로이고, M28은 의도적으로 그 경계를 넘은 simulation-only expert입니다. 앞으로는 privileged라는 이름만 기록하지 않고, 그 정보가 value에만 들어갔는지 action에도 들어갔는지를 별도 계약으로 남깁니다.