Epoch·iteration·step의 차이를 숫자만으로 읽으면 현재 두 학습 코드는 서로 모순처럼 보인다. Octo fine-tuning은 epoch 변수가 하나도 없는데 10,000 steps를 실행한다. G1 PPO는 iteration 하나 안에서 다시 5 learning epochs를 돈다. 그렇다면 Octo의 10,000 step과 PPO의 5 epoch 중 어느 쪽이 더 많이 학습한 것일까.
그 질문에는 숫자만으로 답할 수 없다. 먼저 한 번의 카운트가 닫는 루프를 봐야 한다. 현재 Octo 코드에서 step은 batch 하나로 loss와 gradient를 계산하고 parameter를 한 번 갱신하는 사건이다. 현재 G1의 RSL-RL 코드에서 iteration은 새 rollout을 모은 뒤 그 rollout으로 PPO update를 끝내는 바깥 루프다. 그 안의 epoch는 방금 모은 같은 rollout storage를 다시 읽는 횟수다.
나는 이 글에서 학습 횟수를 성능의 대리 지표로 사용하지 않는다. 대신 현재 코드가 실제로 세는 sample, batch, optimizer update를 공통 장부로 바꾼다. PPO 하이퍼파라미터 변경 순서가 update budget을 어떻게 조절할지를 다뤘다면, 이번 글은 그보다 앞에서 서로 다른 학습 루프의 카운터를 어떻게 번역할 것인가를 맡는다.
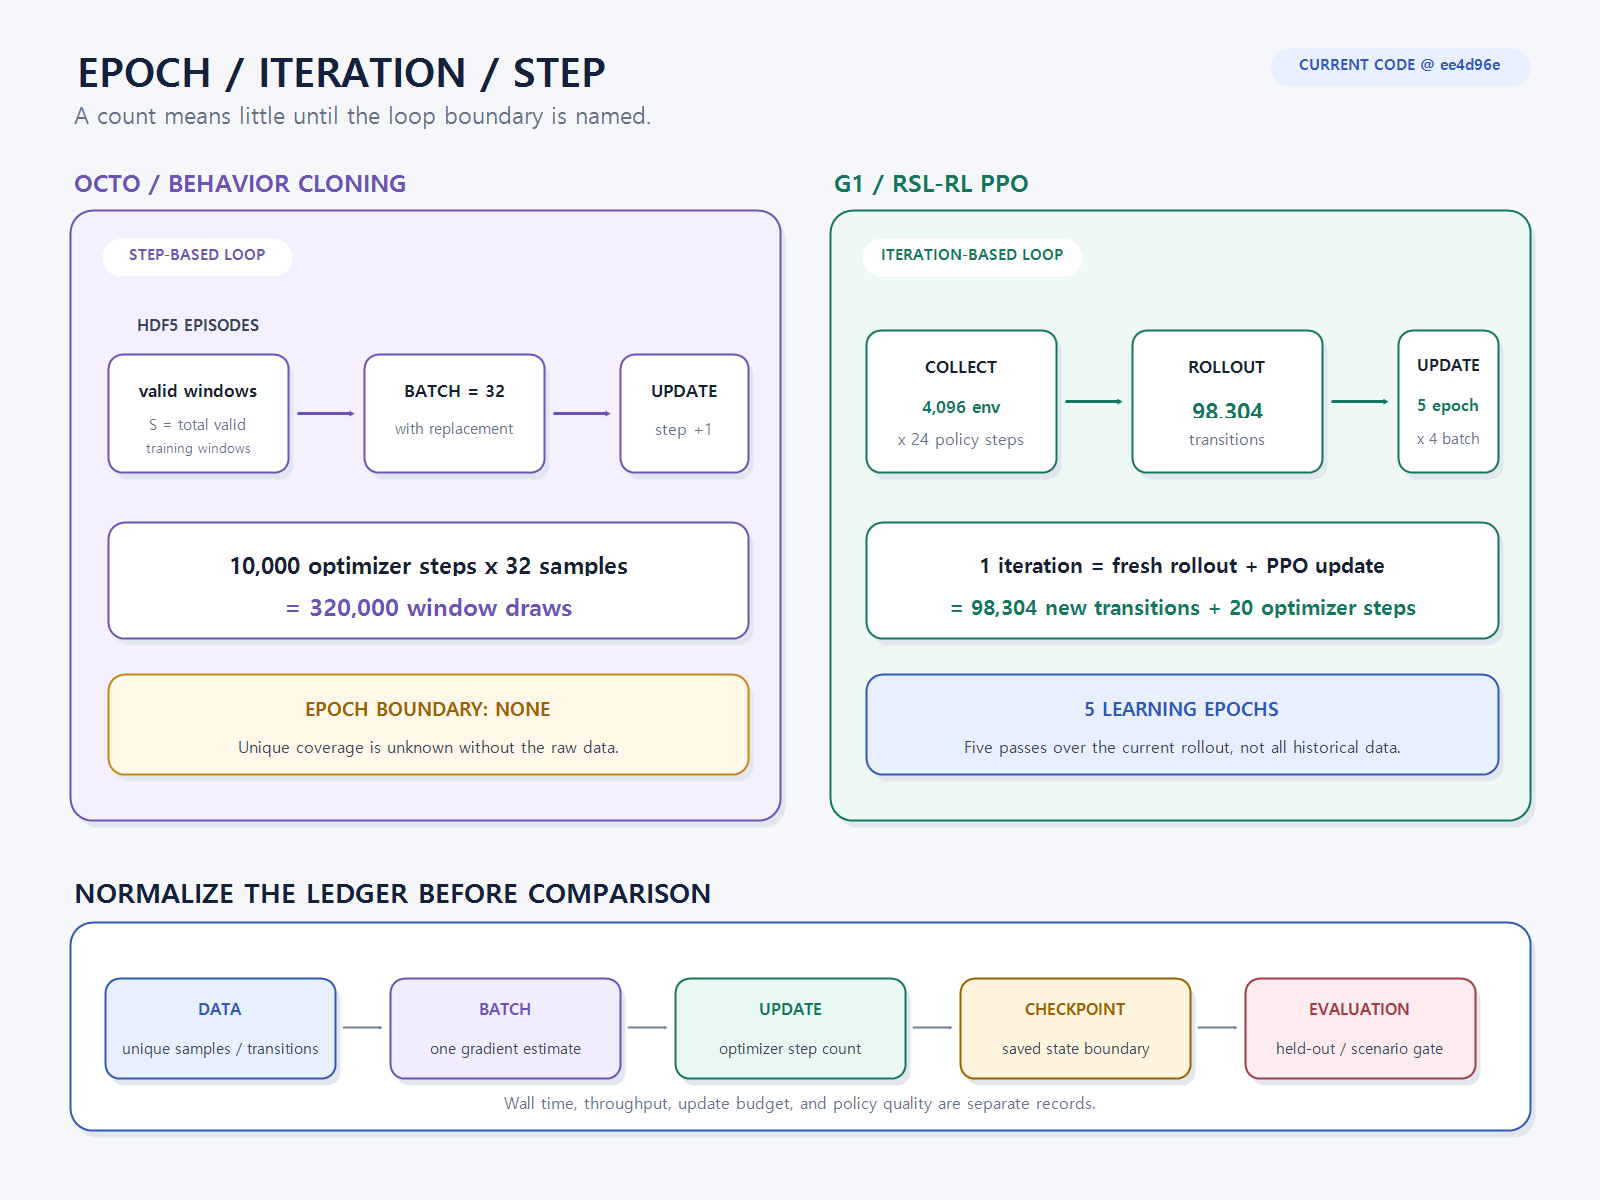
Epoch·iteration·step은 보편적인 시간 단위가 아니다
일반적인 지도학습에서 epoch는 “훈련 데이터 전체를 한 번 순회했다”는 뜻으로 쓰인다. TensorFlow의 Keras fit() 문서도 기본적으로 epoch를 입력 데이터 전체의 한 차례 iteration으로 정의한다. 다만 무한히 반복되는 dataset은 steps_per_epoch를 따로 정해야 한다. 이미 여기서 epoch는 자연법칙이 아니라 데이터 iterator와 학습 루프가 합의한 경계라는 사실이 드러난다.
step은 더 모호하다. 로봇 코드에는 physics step, policy step, environment step, optimizer step, logging step이 함께 등장한다. “10,000 step을 학습했다”라고만 쓰면 물리를 10,000번 적분했다는 뜻인지, batch 10,000개로 parameter를 바꿨다는 뜻인지 알 수 없다. 그래서 이 글에서는 parameter가 실제로 바뀌는 사건을 optimizer step이라고 끝까지 풀어 쓴다. 물리와 policy 주기의 차이는 Isaac Lab의 physics step·decimation·rollout 글로 분리한다.
iteration도 구현이 정한다. RSL-RL에서는 rollout 수집과 PPO update를 묶은 바깥 루프 한 번이다. 다른 프로젝트에서는 validation까지 포함하거나, 단순히 batch 하나를 처리한 횟수를 iteration이라고 부를 수 있다. 로그의 열 이름보다 그 카운터가 증가하는 코드 위치를 먼저 찾아야 한다.
| 용어 | 먼저 확인할 질문 | 현재 Octo 경로 | 현재 G1 PPO 경로 |
|---|---|---|---|
| sample | 한 표본은 무엇인가 | observation window와 미래 action chunk | 환경 한 곳의 한 policy transition |
| batch | gradient 한 번에 무엇을 묶는가 | window 32개 | rollout 98,304개 중 24,576개 |
| optimizer step | parameter가 몇 번 바뀌는가 | 바깥 step마다 1회 | iteration마다 20회 |
| epoch | 어느 표본 집합을 한 바퀴 도는가 | 정의되지 않음 | 현재 rollout storage를 한 바퀴 |
| iteration | 어느 바깥 루프가 끝나는가 | 별도 카운터 없음 | 새 rollout 수집 + PPO update |
Octo의 step은 batch 하나로 parameter를 한 번 바꾸는 사건이다
training/il/finetune_octo.py는 HDF5의 각 episode를 읽고, 길이가 T인 episode에서 observation window와 미래 action horizon이 모두 들어오는 시점만 (episode_index, t)로 저장한다. 현재 기본값은 observation history 2개와 action horizon 4개다. episode가 충분히 길다면 유효 window 수는 대략 T - 4개이고, 전체 유효 window 수 S는 episode별 개수를 합한 값이다.
그다음 동작이 중요하다. WindowBatchIterator.__iter__()는 while True 안에서 rng.choice(..., size=32, replace=True)를 호출한다. 한 batch 안에서도 같은 window가 두 번 뽑힐 수 있고, 다음 batch가 이전 batch의 표본을 다시 뽑을 수도 있다. 모든 window를 정확히 한 번씩 소비한 뒤 epoch를 올리는 구조가 아니다.
while True:
    indices = rng.choice(S, size=32, replace=True)
    yield make_batch(indices)

for step in range(1, 10_000 + 1):
    batch = next(data_iter)
    state = apply_gradients(batch)  # optimizer step 1회
Octo 공식 fine-tuning 코드도 고정 epoch보다 num_steps를 중심에 둔다. 공식 fine-tuning loop는 dataset을 repeat()한 뒤 shuffle·batch하고, range(num_steps)에서 batch를 하나씩 꺼내 train_step을 실행한다. 다만 공식 pipeline의 shuffle buffer와 현재 workspace의 NumPy 복원 추출은 같은 sampler가 아니다. 공통점은 입력 stream이 반복되므로 학습 종료를 optimizer step 수로 정한다는 데 있다.
10,000 step은 320,000개의 고유 window를 봤다는 뜻이 아니다
현재 기본값으로 10,000 optimizer step을 완료하면 batch draw 수는 정확히 계산할 수 있다.
optimizer_steps = 10,000
batch_size      = 32
window_draws    = 10,000 × 32 = 320,000
하지만 320,000 draw와 320,000 unique window는 다르다. 복원 추출에서는 같은 window가 여러 번 등장할 수 있고, 운이 나쁘면 어떤 window는 한 번도 선택되지 않는다. 전체 유효 window 수 S를 알고 있다면 320,000 / S를 명목상의 평균 재사용 강도로 적을 수는 있다. 그것을 “epoch를 몇 번 완료했다”라고 바꾸면 각 표본이 같은 횟수만큼 사용됐다는 인상을 주므로 정확하지 않다.
현재 git에는 실제 raw HDF5가 없고, 데이터 ID별 유효 window 수와 draw histogram을 기록한 실행 산출물도 없다. 따라서 10,000 step을 설정된 optimizer budget이라고 말할 수는 있지만, 데이터 coverage나 일반화 성능을 관찰했다고 말할 수는 없다. 이 경계는 Train·Validation·Test와 episode 누수 글에서 확인한 validation 부재와도 연결된다. 많이 뽑았다는 사실이 보지 않은 데이터에서 잘 동작한다는 증거는 아니다.
G1 PPO의 iteration은 새 경험을 모으고 학습하는 한 묶음이다
G1의 flat 기본 설정은 환경 4,096개와 환경당 rollout 24 policy step을 사용한다. OnPolicyRunner.learn()의 바깥 for it 루프는 먼저 24번 environment를 진행하며 transition을 storage에 넣고, return을 계산한 뒤 alg.update()를 한 번 호출한다. RSL-RL 공식 OnPolicyRunner 구현도 이 수집과 update 묶음을 learning iteration으로 정의한다.
new_transitions_per_iteration
    = num_envs × num_steps_per_env
    = 4,096 × 24
    = 98,304
여기서 24 step은 24초가 아니다. G1은 200Hz physics에서 decimation 4를 사용하므로 policy는 50Hz로 바뀐다. 한 환경의 rollout은 24 × 0.02s = 0.48s의 연속 경험이다. 병렬 환경 수를 곱해 98,304개 transition을 얻더라도 실제 벽시계로 1,966초를 기다리는 것은 아니다. GPU에서 환경들이 함께 진행되기 때문에 simulated time의 합과 wall time을 분리해야 한다.
PPO의 5 learning epochs는 방금 모은 rollout을 다섯 번 읽는다는 뜻이다
현재 PPO 설정은 num_learning_epochs=5, num_mini_batches=4다. RSL-RL의 rollout storage generator는 num_envs × num_transitions_per_env를 batch 크기로 계산하고, 이를 mini-batch 수로 나눈 뒤 epoch와 mini-batch의 이중 루프에서 batch를 내보낸다. PPO update 코드도 update 수를 num_learning_epochs × num_mini_batches로 계산한다.
rollout batch size             = 98,304
mini-batch size                = 98,304 / 4 = 24,576
optimizer steps per iteration  = 5 × 4 = 20
transition reuse per iteration = 5 passes
이 epoch는 수개월 동안 쌓인 모든 G1 경험을 한 바퀴 도는 것이 아니다. 현재 iteration에서 방금 모은 98,304 transition을 다섯 번 재사용하는 범위다. update가 끝나면 다음 iteration은 바뀐 policy로 새 rollout을 모은다. PPO가 on-policy 알고리즘이라는 말은 이 데이터 수명과 관련된다. 과거 rollout을 영구 replay buffer처럼 계속 섞는 구조가 아니라, 현재 policy 근처에서 모은 경험을 제한된 횟수만 재사용한다.
Isaac Lab의 RSL-RL configuration API가 num_learning_epochs를 “update당 learning epoch 수”, num_mini_batches를 “update당 mini-batch 수”라고 적는 이유도 여기에 있다. dataset 전체의 절대 epoch가 아니라 한 PPO update 내부의 두 축이다.
3,000 iteration은 완료 기록이 아니라 최대 설정 예산이다
flat G1 YAML의 max_iterations=3000을 기본값 그대로 끝까지 실행했다고 가정하면 다음 값을 계산할 수 있다.
| 항목 | 계산 | 설정상 최대 예산 |
|---|---|---|
| 새 transition | 4,096 × 24 × 3,000 | 294,912,000 |
| optimizer step | 5 × 4 × 3,000 | 60,000 |
| 환경별 simulated policy time | 24 × 0.02s × 3,000 | 1,440s |
| checkpoint 간격 | save interval 100 | 저장 조건이며 수용 판정 횟수는 아님 |
이 표는 실행 결과가 아니다. 중단, resume, CLI override, 다른 agent config, 초기 실패 gate에 따라 실제 횟수는 달라진다. training/rl/train.py는 --max_iters, learning epoch, mini-batch를 run 단위로 덮어쓸 수 있다. 최근의 짧은 G1 probe처럼 한 iteration만 허용한 실행을 YAML의 3,000과 같은 것으로 적으면 구성된 상한과 실제 수행량을 섞게 된다.
checkpoint 이름도 완료된 update 수와 정확히 같은지 구현을 확인해야 한다. 현재 RSL-RL runner는 0부터 시작하는 iteration index를 파일명에 사용한다. 그래서 model_0.pt가 “아무것도 학습하지 않은 초기 모델”이라고 단정할 수 없다. save 호출 위치와 resume의 current iteration을 함께 봐야 한다. 이 상태 경계는 PPO checkpoint와 optimizer state 글에서 자세히 다뤘다.
학습량을 비교할 때는 네 개의 장부를 따로 둔다
Octo의 10,000과 PPO의 3,000을 하나의 축에 놓는 대신, 나는 다음 네 장부로 나누는 편이 맞다고 판단했다.
- 데이터 장부: 고유 episode·window 수, 새 transition 수, 표본별 draw 또는 reuse 횟수.
- update 장부: batch 크기, optimizer step 수, learning rate schedule, gradient accumulation 여부.
- 시간 장부: physics·policy simulated time, 데이터 로딩·수집·update wall time, 전체 elapsed time.
- 판정 장부: validation 또는 scenario, seed, checkpoint, metric, acceptance gate.
같은 optimizer step 수도 의미가 다르다. Octo의 step은 offline window 32개에서 action loss를 줄이는 갱신이고, PPO의 step은 현재 rollout의 advantage와 old action probability를 사용해 actor와 critic을 갱신한다. batch 크기와 objective, 데이터 생성 비용이 다르므로 10,000 대 60,000이라는 숫자로 계산량이나 학습 성과를 비교할 수 없다. loss·gradient·optimizer의 기본 학습 루프는 공통 구조를 설명하지만, 데이터가 들어오는 방식까지 같게 만들지는 않는다.
현재 구현에서 확인된 것과 아직 확인하지 못한 것을 분리한다
| 대상 | 현재 상태 | 근거 | 아직 말할 수 없는 것 |
|---|---|---|---|
| Octo window iterator | 구현됨 | 유효 slice 목록과 복원 batch 추출 코드 | 실제 dataset coverage와 표본별 재사용 분포 |
| Octo 10,000 step | 기본값으로 구성됨 | num_steps=10_000, batch 32 |
해당 조건의 학습 완료·validation·robot 성공률 |
| G1 PPO iteration | 실행 가능한 경로가 구현됨 | runner의 collect→returns→update loop | 모든 run이 flat 기본값을 사용했다는 주장 |
| G1 3,000 iteration | 기본 최대 예산으로 구성됨 | agent YAML과 CLI default | 특정 run의 실제 완료 횟수와 수용된 성능 |
| 두 방식의 우열 | 미평가 | 공통 held-out task·비용 기준 없음 | sample efficiency·wall-clock efficiency·성공률 우위 |
VLA 글에서 설명한 Octo의 역할과 PPO의 rollout·clipping 글은 서로 다른 policy 학습 문제를 다룬다. 이번 비교의 목적은 둘 중 하나를 승자로 고르는 것이 아니라, “얼마나 학습했는가”라는 문장을 재현 가능한 숫자로 바꾸는 것이다.
다음 실행부터는 카운터 이름이 아니라 완료된 사건을 기록한다
G1의 run_manifest.json에는 이미 task, seed, device, 환경 수, 최대 iteration, 실제 runner config, 부모 checkpoint hash와 command arguments가 들어간다. 이 정보로 설정된 transition·optimizer 예산은 다시 계산할 수 있다. 그러나 중간에 멈춘 run의 실제 완료 update 수, 누적 transition 수, 수집과 update의 wall time을 하나의 요약으로 확정하려면 종료 summary가 더 필요하다.
Octo 쪽에는 dataset hash, episode 수, 유효 window 수 S, sampler 방식, batch size, 완료 optimizer step, 총 draw, unique window coverage, validation split과 checkpoint 평가를 함께 남겨야 한다. 특히 복원 추출을 유지한다면 표본별 draw count의 최솟값·중앙값·최댓값을 기록해야 일부 짧은 episode가 과도하게 반복되는지 확인할 수 있다.
training_clock = {
  "data_identity": "...",
  "unique_samples": S,
  "sampler": "with_replacement",
  "completed_optimizer_steps": ...,
  "sample_draws": ...,
  "new_environment_transitions": ...,
  "checkpoint": "...",
  "evaluation_gate": "...",
}
결국 epoch·iteration·step의 차이는 용어 암기 문제가 아니다. 어느 데이터를 새로 만들었고, 어느 표본을 다시 사용했으며, parameter가 몇 번 바뀌었는지를 분리하는 일이다. Octo의 10,000 step은 320,000회 window 추출과 10,000회 optimizer update를 뜻하지만 고유 coverage를 보장하지 않는다. G1 PPO의 한 iteration은 새 transition 98,304개와 20회의 optimizer update를 묶으며, 그 안의 5 epoch는 현재 rollout을 다섯 번 읽는다는 뜻이다.
다음 검증은 두 trainer의 종료 summary를 같은 schema로 남기는 것이다. 설정값이 아니라 실제 완료 카운터와 데이터 identity를 기록한 뒤, checkpoint 평가 결과까지 같은 ID로 연결한다. 그때부터 “몇 epoch 돌렸다”는 말 대신, 어떤 경험을 얼마만큼 사용해 어느 모델을 만들었고 어떤 조건에서 판정했는지를 답할 수 있다.
함께 읽기: AI 모델의 loss·gradient·checkpoint · Isaac Lab의 physics·policy·rollout 시간축 · PPO 하이퍼파라미터 변경 순서 · Train·Validation·Test와 episode 누수 · PPO 학습 로그 읽는 법
기술 기준 시점: 2026-07-23. workspace 설명은 origin/main@ee4d96e의 training/il/finetune_octo.py, G1 flat agent configuration, environment clock, training/rl/train.py를 기준으로 했다. 공식 문서는 용어와 library loop를 교차 확인하는 데 사용했다. 10,000 Octo step과 3,000 G1 iteration은 기본 설정값이며, 이 글은 해당 예산의 완료나 정책 성능을 주장하지 않는다.