v248의 G1 정책은 slow와 nominal 평가에서 한 번도 넘어지지 않았습니다. nominal 이동 거리는 10.710m였습니다. 이 체크포인트에서 보상 함수, 관측·행동 차원, 종료 조건, action scale을 그대로 두고 PPO를 한 iteration 더 돌렸습니다. 바꾼 것은 --load_model_only 하나였습니다. 결과는 slow 낙상률 87.5%, nominal 낙상률 65.625%였습니다. nominal 이동 거리도 2.924m로 무너졌습니다.
처음에는 이해하기 어려웠습니다. actor와 critic의 가중치는 같은 체크포인트에서 읽었고, 새로운 reward도 넣지 않았습니다. 그런데 여기서 “같은 체크포인트”라는 표현이 문제였습니다. 추론에 필요한 model weight와 학습을 이어 가는 데 필요한 training state는 같은 것이 아닙니다. v250은 가중치는 이어받았지만 Adam optimizer가 축적한 상태는 버리고 시작했습니다. 첫 update부터 이미 다른 학습이었습니다.
이 글은 PPO의 rollout·GAE·clipping을 다시 설명하지 않습니다. 실제 RSL-RL 체크포인트 안에 무엇이 들어 있고, 현재 G1 코드의 resume와 load_model_only가 무엇을 다르게 복원하는지, 그리고 같은 실수를 반복하지 않기 위해 어떤 검사를 추가해야 하는지를 정리합니다.
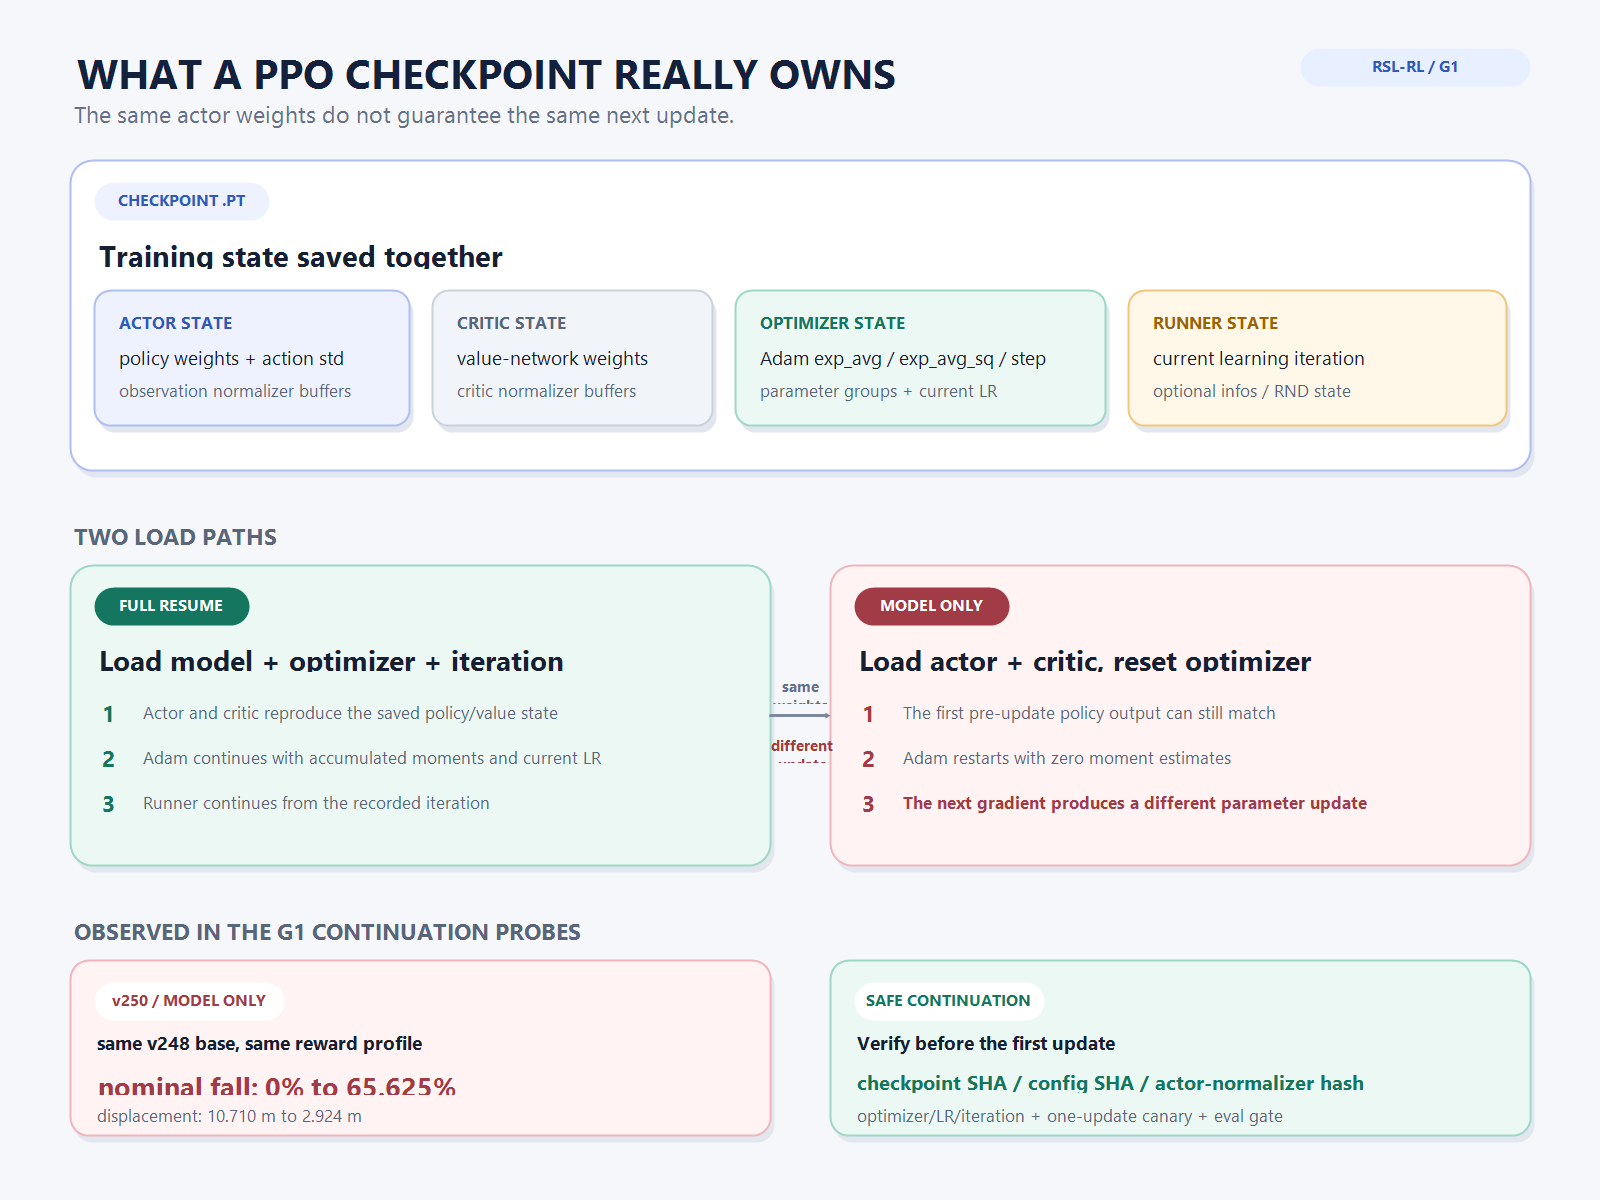
체크포인트는 모델 파일이 아니라 학습 상태의 묶음입니다
현재 사용 중인 RSL-RL의 OnPolicyRunner.save()는 PPO 알고리즘이 만든 dictionary에 현재 iteration과 선택적 infos를 더해 torch.save()로 저장합니다. RSL-RL PPO 구현을 기준으로 핵심 key는 다음과 같습니다.
| checkpoint key | 담고 있는 상태 | 빠졌을 때 달라지는 것 |
|---|---|---|
actor_state_dict |
policy network, action distribution, actor observation normalizer | 같은 관측에서 선택하는 행동 분포 |
critic_state_dict |
value network와 critic normalizer | return의 기준선과 advantage 추정 |
optimizer_state_dict |
parameter별 optimizer 상태와 parameter group | 같은 gradient를 다음 weight 변화로 바꾸는 방식 |
iter |
runner의 현재 learning iteration | 이어지는 iteration 번호와 저장·로그의 시간축 |
infos |
호출자가 선택적으로 넣은 부가 정보 | 프로젝트별 메타데이터; 기본값은 비어 있을 수 있음 |
| RND state | RND를 쓸 때만 predictor와 optimizer 상태 | intrinsic reward 경로 |
여기서 observation normalizer가 별도 top-level key가 아니라 actor와 critic의 state_dict 안에 들어간다는 점이 중요합니다. PyTorch module의 state_dict에는 학습 가능한 parameter뿐 아니라 등록된 persistent buffer도 포함됩니다. 현재 motion-tracking 코드에서도 obs_normalizer._mean, _var, _std, count를 actor state의 일부로 읽고 actor hash와 normalizer hash를 따로 검사합니다.
현재 코드에서 full resume와 model-only는 정확히 무엇이 다른가
training/rl/train.py는 --resume가 켜지면 지정한 run의 model_N.pt를 찾고 runner.load()를 직접 호출합니다. --load_model_only가 없으면 load_cfg=None이 전달되고, RSL-RL은 actor·critic·optimizer·iteration을 모두 불러옵니다.
FULL RESUME
runner.load(resume_path, load_cfg=None)

CURRENT MODEL-ONLY PATH
load_cfg = {
    "actor": True,
    "critic": True,
    "optimizer": False,
    "iteration": True,
    "rnd": False,
}
runner.load(resume_path, load_cfg=load_cfg)
따라서 현재 옵션 이름을 문자 그대로 “policy만 읽는다”고 이해하면 안 됩니다. model-only 경로도 actor뿐 아니라 critic과 iteration을 복원합니다. 실제로 버리는 핵심은 optimizer와 RND 상태입니다. actor·critic 안에 포함된 normalizer는 같이 읽습니다. 이 구분을 하지 않으면 normalizer가 초기화돼서 망가졌다고 잘못 진단하거나, 반대로 iteration 번호가 새로 시작한다고 착각할 수 있습니다.
--load_model_only는 쓸모없는 옵션이 아닙니다. actor 구조를 바꾸거나 parameter shape가 달라져 기존 optimizer state를 안전하게 대응시킬 수 없을 때는 model weight를 초기값으로 이식하는 warm start가 필요합니다. 다만 그것을 “이어 학습”이라고 부르면 실험 의미가 흐려집니다. 제 코드에서는 full resume와 architecture-changing warm start를 서로 다른 실험 유형으로 기록해야 했습니다.
Adam은 현재 weight만 보고 다음 update를 계산하지 않습니다
현재 PPO optimizer는 Adam입니다. Adam은 parameter별로 과거 gradient의 지수 이동 평균 m과 제곱 gradient의 이동 평균 v, update step을 유지합니다. 간단히 쓰면 다음과 같습니다.
m_t = β1 m_(t-1) + (1-β1) g_t
v_t = β2 v_(t-1) + (1-β2) g_t²

θ_t = θ_(t-1) - lr · m̂_t / (sqrt(v̂_t) + ε)
같은 weight θ와 같은 새 gradient g를 주더라도 저장된 m_(t-1), v_(t-1), step이 다르면 다음 weight는 달라집니다. PyTorch optimizer state_dict 문서가 말하는 state가 바로 이 parameter별 상태이고, param_groups에는 learning rate와 weight decay 같은 설정이 들어갑니다.
RSL-RL은 adaptive KL schedule을 사용할 때 관측된 KL에 따라 learning rate를 바꾸고 optimizer의 parameter group에도 그 값을 씁니다. full resume는 optimizer state를 읽은 뒤 그 parameter group의 learning rate를 PPO 객체에 다시 반영합니다. model-only 경로는 새 optimizer를 config의 초기 learning rate로 만듭니다. 즉 reset은 momentum만 0으로 만드는 일이 아니라, 직전 정책이 도달한 update scale의 문맥도 끊을 수 있습니다.
첫 행동이 같아도 첫 update 이후에는 다른 정책입니다
model-only checkpoint를 읽은 직후, 같은 observation을 넣어 actor의 평균 행동이 같은지 검사할 수 있습니다. actor state와 normalizer state가 정확히 복원됐다면 이 검사는 통과해야 합니다. 하지만 그것은 inference parity 검사입니다. training continuity 검사가 아닙니다.
새 rollout을 모으는 동안 normalizer는 다시 observation 통계를 갱신하고, critic은 return의 기준선을 만들며, PPO는 여러 mini-batch와 epoch에서 actor와 critic을 함께 update합니다. 첫 optimizer.step()에서 full-resume Adam은 과거 방향과 scale을 가진 채 움직이고, 새 Adam은 m=0, v=0에서 움직입니다. clipping이 있어도 이 차이는 사라지지 않습니다. clipping은 surrogate objective의 추가 이득을 제한할 뿐 optimizer의 기억을 복원하지 않기 때문입니다.
그래서 비교해야 할 것은 load 직후 action 하나가 아니라 다음 세 지점입니다.
- load 직후 actor·critic·normalizer hash와 고정 observation의 출력
- 첫 update 직전 optimizer learning rate와 저장된 step·moment tensor
- 한 update 뒤 policy relative L2, KL, action std, 평가 gate 변화
v205에서는 다섯 iteration 만에 전진과 균형이 함께 사라졌습니다
첫 번째 명확한 경고는 v205였습니다. 당시 가장 나은 전진 보존 계열인 v199/model_5196에서 reward·environment·reference 값을 그대로 두고 --load_model_only로 5 iteration을 학습했습니다. slow는 낙상률 100%, 이동 거리 -0.699m였고 nominal은 낙상률 87.5%, 이동 거리 -0.066m였습니다. late body-frame velocity도 0.040으로 떨어졌습니다.
대조를 위해 v206은 같은 v199 checkpoint에서 optimizer까지 보존하고 1 iteration만 진행했습니다. slow와 nominal 모두 낙상률 0%였고 각각 5.662m, 8.807m 전진했습니다. v206도 v199보다 나빠서 채택하지는 않았지만, 적어도 model-only branch처럼 즉시 균형과 전진이 함께 붕괴하지는 않았습니다. 여기서 내린 결론은 “optimizer state를 보존하면 성공한다”가 아니라 “optimizer reset 자체가 독립적인 고위험 변경”이라는 것이었습니다.
| 실험 | 시작점·load | slow | nominal | 판정 |
|---|---|---|---|---|
| v205 | v199, model-only, 5 iter | fall 100%, -0.699m | fall 87.5%, -0.066m | optimizer-reset branch rejected |
| v206 | v199, full-state, 1 iter | fall 0%, 5.662m | fall 0%, 8.807m | recovery observed, not accepted |
v245가 괜찮았다고 해서 reset이 안전한 것은 아니었습니다
v245는 이 결론을 단순한 규칙으로 만들지 못하게 한 사례입니다. v241/model_5203에서 model-only로 시작한 v245는 slow를 통과했고, nominal도 속도 오차만 실패했습니다. 이동 거리는 10.583m, 낙상률은 0%였습니다. 이어진 v246과 v247도 즉시 무너지지 않았습니다.
이 결과만 떼어 보면 optimizer reset이 policy를 안정화했다고 말하고 싶어집니다. 하지만 PPO의 다음 gradient는 시작 checkpoint, 새 rollout 표본, advantage 분포, action standard deviation과 학습률에 따라 달라집니다. reset이 어떤 branch에서는 우연히 덜 나쁜 update를 만들 수 있어도, 기존 학습 궤적의 연속성을 보장하지는 않습니다. v245는 reset의 안전성을 증명한 것이 아니라 model-only warm start가 별도의 실험이라는 사실을 보여 줍니다.
그래서 저는 “한 번 성공했으니 기본값으로 쓴다”는 결정을 피해야 했습니다. process 변경도 reward 변경과 똑같이 단일 변경으로 기록하고, 원래 full-state branch와 직접 대조해야 했습니다. 이 원칙을 지키지 않으면 좋아진 결과를 reward 덕분이라고 잘못 귀속하거나, 나빠진 결과를 simulator seed 탓으로 넘기기 쉽습니다.
v250은 같은 base에서 optimizer만 바꾼 직접 대조였습니다
v250의 비교가 더 강한 이유는 출발점과 reward profile이 명확히 고정됐기 때문입니다. v248/model_5208은 slow·nominal 모두 낙상률 0%였고 nominal 이동 거리는 10.710m였습니다. v250은 같은 checkpoint와 compact_v248_nominal_speed_recovery profile을 유지하고 optimizer만 reset했습니다.
| 조건 | slow fall / distance | nominal fall / distance | nominal velocity error |
|---|---|---|---|
| v248 base | 0% / 7.594m | 0% / 10.710m | 0.336 |
| v250 model-only + 1 iter | 87.5% / 0.661m | 65.625% / 2.924m | 0.728 |
| v251 full-state + 1 iter | 0% / 7.056m | 0% / 8.992m | 0.353 |
v251은 같은 v248 base에서 full PPO state를 이어받았습니다. nominal 거리와 속도 gate를 통과하지 못했고 v248보다 나빠서 역시 채택하지 않았습니다. 그러나 v250의 고낙상 붕괴에서는 회복했습니다. 이 대조가 말해 주는 범위는 정확합니다. optimizer 보존은 좋은 정책을 보장하지 않지만, optimizer reset은 v250 붕괴의 실질적인 원인이었습니다.
full resume도 실행 전체를 완전히 재현하지는 않습니다
PyTorch의 general checkpoint 안내도 학습 재개에는 model state보다 더 많은 상태를 저장해야 한다고 설명합니다. 그렇다고 RSL-RL의 full resume가 실험 세계 전체를 정지했다가 되돌리는 기능은 아닙니다. 현재 checkpoint에는 다음 항목이 들어 있지 않거나 별도 파일에서 관리됩니다.
- environment·reward·termination 코드의 Git revision
- agent YAML과 runtime CLI argument
- motion file, asset, dataset의 실제 내용과 hash
- simulator 내부의 현재 각 환경 상태와 rollout storage
- Python·PyTorch·CUDA·Isaac의 RNG 및 실행 환경 전체
따라서 full resume는 “저장된 PPO training state를 복원한다”는 뜻이지, 다음 trajectory가 bitwise identical하다는 뜻은 아닙니다. reset distribution과 randomization이 같아야 새 rollout의 상태 분포가 비교 가능하고, physics step과 vector rollout 시간축도 같아야 sample 수와 update cadence가 맞습니다.
이 누락을 보완하려고 현재 train.py는 run 시작 시 run_manifest.json을 씁니다. 여기에는 task, seed, device, environment 수, 최대 iteration, agent config 경로와 SHA-256, runner config, parent checkpoint 경로와 SHA-256, 전체 CLI argument가 들어갑니다. checkpoint와 manifest를 한 쌍으로 보지 않으면 파일 이름만 같은 재현 실험이 됩니다.
observation normalizer는 작지만 정책 입력 전체를 바꿉니다
normalizer는 관측 o를 running mean과 standard deviation으로 변환합니다.
o_norm = (o - running_mean) / (running_std + ε)network weight가 같아도 mean과 std가 다르면 첫 layer가 받는 숫자는 다릅니다. 특히 joint velocity나 angular velocity처럼 scale이 다른 항목이 섞인 로봇 observation에서는 작은 통계 차이가 여러 관절의 action으로 동시에 전파됩니다. 그래서 현재 motion-tracking 실행 도구는 actor 전체 hash와 normalizer hash를 따로 기록하고, teacher·student normalizer가 변하지 않았는지를 fail-closed guard로 검사합니다.
현재 Direct G1Walk의 load_model_only는 actor와 critic state를 읽으므로 normalizer도 함께 복원합니다. v250을 normalizer 초기화 문제로 설명하면 코드와 맞지 않습니다. 다만 actor 구조를 변경하며 일부 key만 이식하거나, 별도 export policy를 만들거나, evaluation에서 normalizer update mode를 잘못 두는 경우에는 같은 종류의 drift가 다시 생길 수 있습니다. 따라서 “model weight hash가 같다”는 검사만으로는 충분하지 않습니다.
안전한 continuation은 load 전에 계약을 확인해야 합니다
현재 경험을 바탕으로 PPO continuation 절차를 다음과 같이 구분합니다.
| 단계 | 검사 | 실패하면 |
|---|---|---|
| 1. 목적 선언 | full resume인지 architecture-changing warm start인지 명시 | 실험을 시작하지 않음 |
| 2. provenance | parent checkpoint SHA, Git revision, agent config SHA, CLI args | 비교 불가능 상태로 표시 |
| 3. state inventory | actor·critic·optimizer·iter key와 shape 확인 | load mode 재설계 |
| 4. inference parity | 고정 observation에서 actor output, actor·normalizer hash 확인 | 학습 금지 |
| 5. optimizer continuity | state tensor 수, step, param-group LR 확인 | full resume 주장 금지 |
| 6. one-update canary | KL, policy relative L2, action std, value loss 검사 | 장기 run 중단 |
| 7. 외부 평가 | 낙상·거리·속도·비대칭 gate를 parent와 비교 | rollback |
현재 G1 학습 방법에서 학습과 평가, 채택을 분리한 이유가 여기서 다시 드러납니다. training reward가 정상이고 checkpoint 저장이 성공해도, parent policy의 능력을 유지했다는 뜻은 아닙니다. v250도 학습 프로세스 자체는 완료됐습니다. 실패를 발견한 것은 저장 성공 여부가 아니라 parent와 같은 시나리오에서 수행한 외부 평가였습니다.
현재 구현 상태와 다음 검증
| 항목 | 상태 | 근거 |
|---|---|---|
| RSL-RL full-state checkpoint | implemented·executed | actor, critic, optimizer, iter 저장·복원 |
| model-only warm start | implemented·executed | optimizer 제외 load config |
| run provenance manifest | implemented | config·parent SHA와 CLI 기록 |
| optimizer-reset 위험 | observed | v205·v250 붕괴, full-state 대조 회복 |
| actor·normalizer hash guard | implemented | motion-tracking 계열의 분리 hash 검사 |
| Direct G1 one-update continuity gate | designed, not fully automated | 검사 항목은 있으나 모든 run의 공통 선행 gate는 아님 |
| router promotion | not accepted | strict walking gate 미통과 |
다음 구현에서는 resume_audit.json을 run 시작 전에 생성할 생각입니다. parent·child의 checkpoint SHA와 actor·critic·normalizer hash, optimizer state tensor 수, optimizer step 범위, learning rate, runner iteration을 기록하고, 고정 observation inference parity를 통과해야만 첫 PPO update를 허용합니다. 첫 update 뒤에는 policy relative L2와 KL, action std를 parent와 비교해 canary gate를 통과한 branch만 이어서 학습합니다.
이번 시행착오에서 얻은 결론은 단순합니다. policy를 불러오는 것과 학습을 이어 가는 것은 다른 작업입니다. 체크포인트 파일의 경로가 같다는 사실보다, 다음 update를 결정하는 상태가 무엇인지 먼저 확인해야 합니다. 앞으로 model-only는 기본 resume가 아니라 의도적으로 optimizer 기억을 버리는 별도 실험으로 기록합니다.