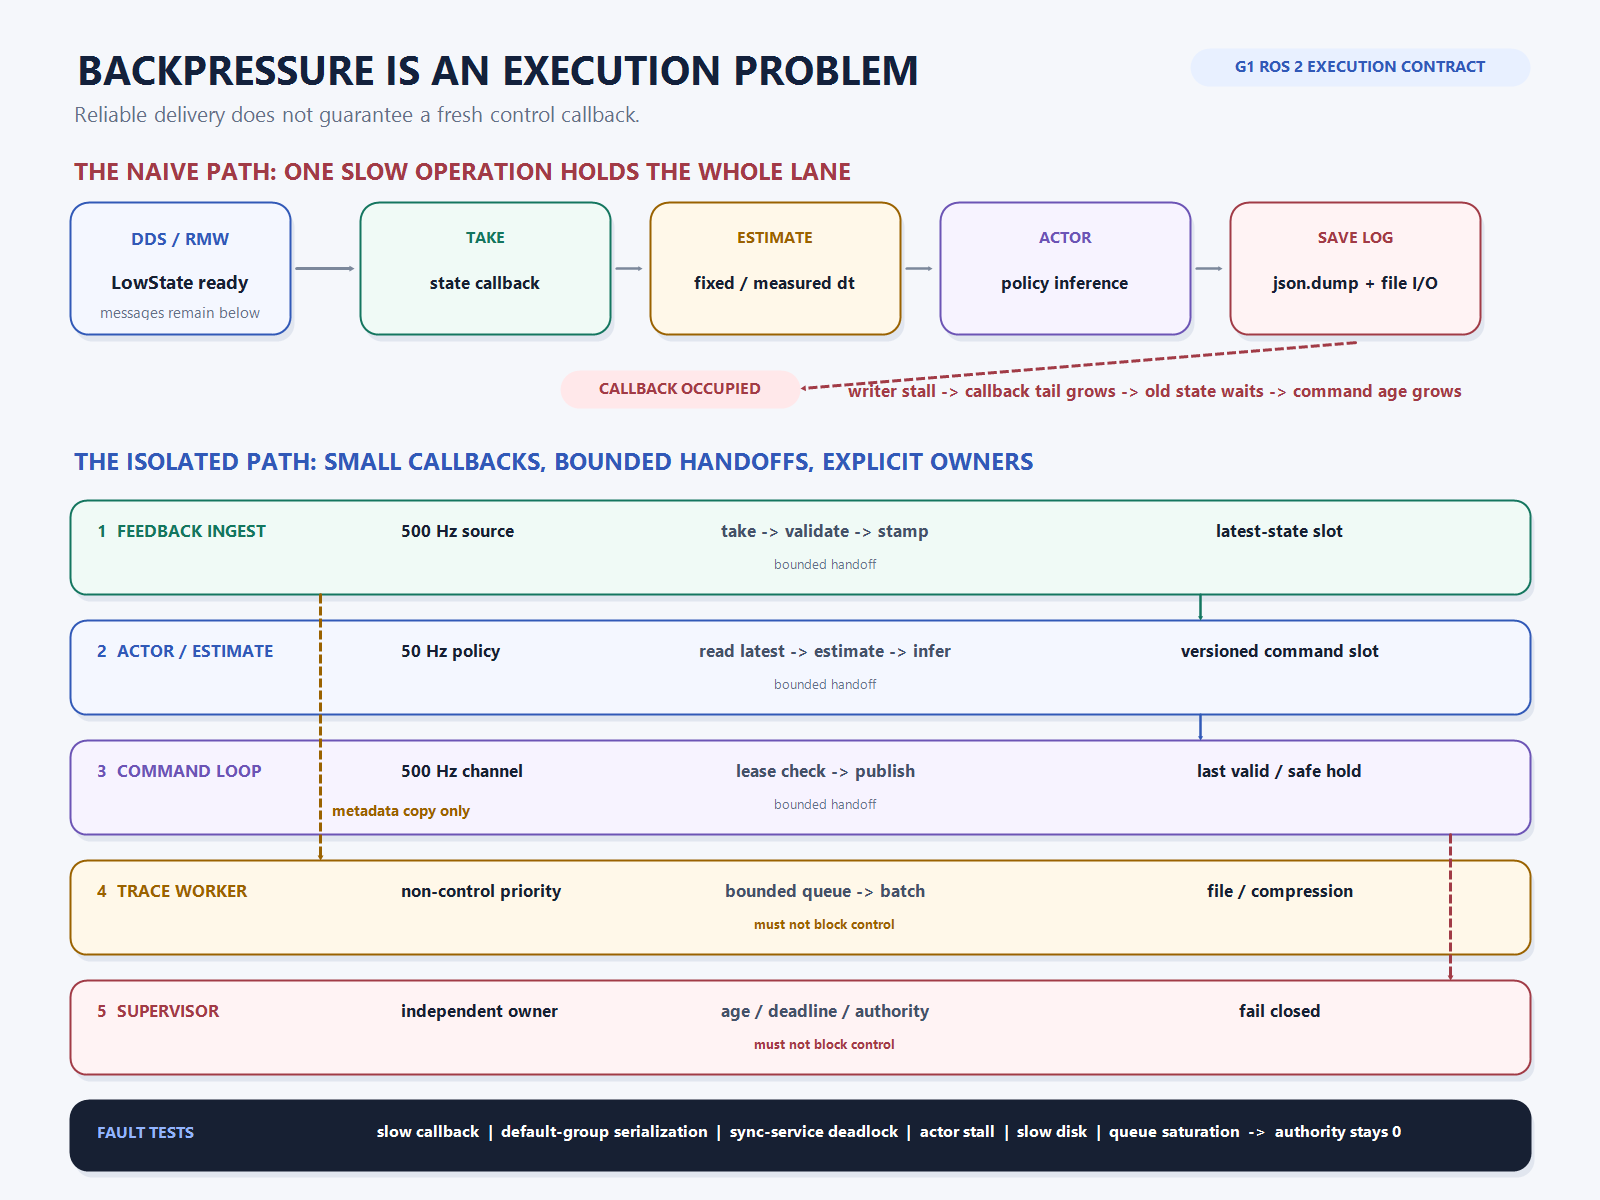
현재 Runner.run()의 마지막 작업은 response 반환이 아닙니다. backend가 action을 만든 뒤 _save_log()가 새 JSON 파일을 열고, json.dump(..., indent=2)로 내용을 저장한 다음에야 호출자에게 response가 돌아갑니다. CLI에서 한 번씩 backend를 시험할 때는 이해하기 쉬운 구조입니다. 그런데 이 함수를 그대로 ROS 2 control callback 안에서 부르면 policy inference 시간뿐 아니라 파일 생성과 JSON 직렬화 시간도 callback 점유 시간이 됩니다.
여기에 G1의 두 주기가 겹칩니다. 현재 Isaac Lab policy는 20ms마다 한 번 action을 만들도록 구성되어 있고, Unitree 공식 G1 low-level 예제는 lowstate 수신과 lowcmd 전송을 2ms 주기의 경로로 보여 줍니다. policy 한 번 사이에 hardware channel은 열 번 움직입니다. state callback, estimator, actor, command publish, incident trace 저장을 한 실행 줄에 세우면 어느 한 작업의 지연이 뒤 작업의 대기가 됩니다.
이때 생기는 것이 backpressure입니다. 생산자가 새 일을 만드는 속도가 소비자가 처리하는 속도보다 빠르거나, 소비자가 잠깐 멈춰 대기 작업이 누적되는 상태입니다. ROS 2에서는 이것이 항상 “queue가 가득 찼다”는 한 가지 신호로 드러나지 않습니다. 메시지는 middleware 아래에 남을 수 있고, executor는 ready 여부만 보고 callback을 고르며, application 내부 queue와 디스크 writer에도 별도의 대기가 생깁니다. 이 글은 현재 transport를 구현했다는 결과 보고가 아니라, 그 transport를 붙이기 전에 실행 경로를 어떻게 나눌지 정한 설계 기록입니다.
현재 router는 동기식 함수이며 ROS 2 callback이 아닙니다
현재 저장소의 robot-control-router에는 rclpy·rclcpp node, publisher, subscription, executor, callback group이 없습니다. Runner.run()은 task profile로 backend를 선택하고, BackendRequest를 만든 뒤 backend.run_step()을 동기적으로 호출합니다. 예외가 발생하면 fallback backend도 같은 호출 안에서 실행합니다. 마지막에는 response log에 선택 규칙을 넣고 JSON 파일을 저장합니다.
response = backend.run_step(request)
response.log["rule"] = selection["rule_name"]
self._save_log(response, task_name)  # open + json.dump
return response
이 구조에서 run()의 호출 시간은 대략 backend 계산, fallback 가능성, JSON 직렬화와 file I/O의 합입니다. 현재 benchmark_latency.py는 synthetic request로 backend 호출 시간을 반복 측정하지만 DDS take, callback scheduling, disk writer stall, command publish와 actuator readback을 포함하지 않습니다. p99도 실제 quantile이 아니라 p95의 1.3배 근사입니다. 따라서 기존 benchmark로 “ROS 2 callback deadline까지 검증됐다”고 말할 수 없습니다.
eval_rl.py는 평가가 끝난 뒤 JSON·CSV를 저장합니다. 이 경로는 control tick마다 파일을 여는 구조가 아니므로 runner와 같은 위험으로 묶을 필요는 없습니다. collect_demos.py의 HDF5 writer는 episode 단위로 RGB 배열을 쌓고 gzip 압축 dataset을 만듭니다. 그러나 실제 SpaceMouse 수집 루프는 아직 placeholder이며 현재 구현된 것은 CPU dry-run schema 경로입니다. 파일을 쓴다는 공통점보다 어느 deadline 경로에서 쓰는가가 더 중요한 구분입니다.
QoS가 전달 정책이라면 executor는 실행 순서를 결정합니다
ROS 2 QoS 계약 글에서는 history·depth·reliability·deadline·liveliness를 channel별 전달 정책으로 나눴습니다. QoS가 맞아야 endpoint가 연결되고, loss와 stale sample을 어떤 방식으로 다룰지 정할 수 있습니다. 그러나 메시지가 middleware에 도착한 뒤 application code가 언제 실행되는지는 executor와 callback group의 책임입니다.
ROS 2 공식 Executor 문서에 따르면 executor는 운영체제 thread를 사용해 subscription, timer, service, action callback을 호출합니다. 일반적인 rclcpp executor에서는 수신 메시지를 client library의 별도 queue에 다시 복사하지 않고 middleware에 둔 채 wait set으로 준비 상태를 감지합니다. 이 wait set이 executor에 알려 주는 것은 각 queue의 정확한 길이가 아니라 해당 entity에 처리할 것이 있는지 나타내는 binary 정보입니다.
callback 처리 시간이 message 도착 주기보다 짧을 때는 결과가 대체로 FIFO처럼 보입니다. 부하가 커지면 공식 문서가 설명하는 동작은 FIFO가 아니라 entity 사이의 round-robin입니다. 아래 계층의 queue에는 과거 sample이 남는데 executor는 어느 topic에 몇 개가 쌓였는지 충분히 알지 못합니다. 그래서 “reliable이므로 모두 도착했다”와 “actor가 최신 state를 사용했다”는 동시에 참일 수 없습니다. 전자는 전달 여부이고 후자는 실행 시점의 freshness입니다.
SingleThreadedExecutor의 한 callback은 다른 callback의 대기 시간이 됩니다
SingleThreadedExecutor는 하나의 thread에서 ready callback을 하나씩 실행합니다. rclpy의 공식 executor API도 spin_once()가 준비된 work item 하나를 실행한다고 설명합니다. state callback이 8ms 동안 actor를 실행하면 그 8ms 동안 같은 executor의 2ms command timer와 supervisor timer는 시작할 수 없습니다. 그 뒤 JSON writer가 filesystem 지연을 만나면 대기는 더 길어집니다.
여기서 평균 callback 시간이 짧다는 사실만으로는 부족합니다. 주기 T와 callback service time C를 비교하면 단일 lane의 단순 부하 비는 ρ=C/T입니다. 지속적으로 ρ≥1이면 그 lane은 입력 속도를 따라갈 수 없습니다. ρ<1이어도 드물게 긴 tail이 발생하면 다음 callback이 밀립니다. 500Hz 입력의 주기는 2ms이므로 state callback이 가끔 2ms를 넘는지, 그 초과가 얼마나 연속되는지가 중요합니다. 현재 workspace에는 이 분포를 측정한 ROS 2 trace가 없습니다.
backlog의 결과도 channel마다 다릅니다. feedback에서는 오래된 state를 뒤늦게 처리하는 것이 문제고, command timer에서는 publish 간격이 벌어지는 것이 문제입니다. supervisor에서는 stale 판정 자체가 늦어질 수 있습니다. trace writer에서는 queue가 커져 memory를 소모하거나 control path를 block할 수 있습니다. 한 executor thread는 이 실패들을 서로 전염시킵니다.
MultiThreadedExecutor를 선택해도 callback group이 같으면 직렬로 실행됩니다
thread 수를 늘리면 자동으로 해결될 것처럼 보이지만 callback group이 병렬 실행 권한을 결정합니다. ROS 2 공식 callback group 가이드는 node의 기본 group이 MutuallyExclusive라고 설명합니다. subscription과 timer를 group 지정 없이 모두 만들면 MultiThreadedExecutor를 사용해도 같은 group의 callback은 서로 겹칠 수 없습니다. 결과적으로 그 node는 SingleThreadedExecutor처럼 동작합니다.
MutuallyExclusive group은 같은 group 안의 callback을 동시에 실행하지 않습니다. command buffer처럼 thread-safe하지 않은 자원을 보호하거나 같은 control timer가 자기 자신과 겹치지 않게 할 때 유용합니다. Reentrant group은 다른 callback뿐 아니라 같은 callback의 여러 instance도 겹쳐 실행할 수 있습니다. state callback이 이전 sample 처리를 끝내기 전에 다음 sample을 처리해도 안전한지 증명하지 않았다면, reentrant를 선택하는 순간 순서와 공유 state race가 새 실패가 됩니다.
| 구성 | 실제로 허용되는 실행 | G1 경로에서 생길 수 있는 오해 | 필요한 검증 |
|---|---|---|---|
| SingleThreadedExecutor | 한 번에 callback 하나 | 구조가 단순하므로 deadline도 안전하다고 생각함 | 모든 callback의 tail duration과 상호 대기 측정 |
| MultiThreaded + 기본 group | 같은 MutuallyExclusive group이라 사실상 직렬 | thread 수만 보고 병렬화됐다고 판단함 | group identity와 실제 overlap trace |
| 서로 다른 MutuallyExclusive group | group 사이 병렬, 각 group 내부 non-overlap | thread pool 공유로 우선순위까지 분리됐다고 생각함 | executor thread·OS priority·resource contention |
| Reentrant group | 같은 callback instance도 동시 실행 가능 | 처리량은 늘지만 shared estimator·buffer가 안전하다고 가정함 | sequence ordering, race, double publish, lock tail |
| 별도 executor·process | callback group과 thread·failure domain 분리 가능 | IPC 비용과 copy가 사라진다고 생각함 | end-to-end age, copy·serialization, crash isolation |
더 위험한 경우는 callback 안의 synchronous service·action 호출입니다. 공식 가이드는 caller callback과 client가 같은 MutuallyExclusive group이면, caller가 결과를 기다리는 동안 Future의 숨은 done-callback이 실행되지 못해 deadlock이 발생한다고 설명합니다. 실제 G1 supervisor가 mode 전환 service의 응답을 기다리는 설계를 한다면 group을 나누거나 asynchronous call을 사용해야 합니다. 현재 코드에는 이 service path가 없으므로 여기서는 검증해야 할 failure injection으로만 남깁니다.
500Hz feedback과 50Hz actor 사이에서는 모든 state를 처리하는 것이 목표가 아닙니다
Unitree의 공식 ROS 2 예제는 G1 low-level 경로에서 2ms timer로 command를 보냅니다. 현재 simulation policy는 20ms마다 action을 바꿉니다. 두 주기를 그대로 연결하면 actor 한 번 사이에 여러 LowState가 들어옵니다. actor가 그 열 개를 모두 오래된 순서대로 처리하면 최신 state에 도달했을 때는 이미 다음 policy tick이 지나 있을 수 있습니다.
feedback의 첫 목적은 archive가 아니라 control입니다. 그래서 ingest callback은 payload를 검증하고 source·receive timestamp와 sequence를 붙인 뒤 latest valid state slot을 갱신하는 작은 작업이어야 합니다. 50Hz actor는 매 tick에서 그 순간의 최신 snapshot 하나를 읽고, 건너뛴 sequence 수와 sample age를 함께 기록합니다. 손실을 숨기는 것이 아니라 control과 기록의 소비 규칙을 분리하는 것입니다.
모든 state를 보존해야 하는 incident trace는 별도 bounded recorder로 복사합니다. recorder queue가 꽉 찼을 때 control callback이 writer를 기다리게 하면 기록 때문에 제어가 늦어집니다. trace drop·overwrite 수를 incident metadata에 남기고 control은 계속 진행하거나, 기록 완전성이 안전 gate라면 supervisor가 authority를 회수해야 합니다. 어떤 경우에도 무한 queue로 시간을 버는 방식은 허용하지 않습니다.
state의 newest-wins와 command의 valid-until은 같은 drop 정책이 아닙니다
queue depth를 1로 두자는 말은 모든 channel에 적용할 수 없습니다. state feedback은 actor가 소비하지 못한 과거 sample을 버리고 최신 유효 sample을 선택하는 newest-wins가 잘 맞을 수 있습니다. 그러나 command는 중간 값을 임의로 건너뛰어도 되는지 actuator semantics와 trajectory generator에 달려 있습니다. 50Hz target을 500Hz channel에서 zero-order hold할지, 보간할지, safe controller가 별도 명령을 소유할지 먼저 정해야 합니다.
command slot에는 적어도 command ID, 생성한 control tick, authority epoch, target robot tick 또는 비교 가능한 valid_until이 필요합니다. 500Hz command loop는 새 policy command가 없다는 이유로 actor를 기다리지 않습니다. 마지막 command가 아직 유효하면 정의된 hold를 수행하고, 만료됐거나 clock mapping이 무효면 candidate command를 보내지 않고 검증된 safe mode로 전환합니다. 이 경계는 clock synchronization 계약과 shadow·canary·rollback 권한 계약이 만나는 지점입니다.
application queue를 쓰더라도 크기, item 단위, full 동작, producer ownership을 manifest로 고정해야 합니다. put()이 block하는 queue는 control callback에서 금지하고, overwrite·drop-new·drop-old 중 무엇을 택했는지 counter로 관측합니다. "비동기 처리"라는 이름만 있고 내부 queue가 무한이면 stall이 사라진 것이 아니라 늦게 memory exhaustion으로 바뀐 것입니다.
disk I/O와 압축은 control callback 밖에서 실패해야 합니다
ROS 2 real-time 설계 문서는 disk I/O와 화면 출력 같은 physical device 접근이 느리고 예측하기 어려우므로 real-time code path 밖으로 옮기라고 설명합니다. fopen 같은 호출은 page fault도 일으킬 수 있습니다. 이 프로젝트가 hard real-time 인증을 받았다는 뜻은 아니지만, 2ms·20ms deadline을 논하는 경로에서 file open과 pretty JSON dump를 직접 수행하지 말아야 할 근거는 충분합니다.
현재 runner log는 response만 저장하므로 파일이 작아 보일 수 있습니다. 그래도 directory metadata, antivirus, filesystem cache, 디스크 포화, 네트워크 드라이브, 동시 writer 수에 따라 tail은 달라질 수 있습니다. incident image나 HDF5 gzip이 붙으면 변동은 더 커집니다. 평균 write 시간이 빠르다는 측정만으로 callback 안전성을 주장할 수 없습니다.
목표 구조에서는 control callback이 immutable한 작은 record나 preallocated buffer handle만 bounded queue에 넘깁니다. non-control priority의 writer가 batch·compression·fsync·hash를 담당합니다. queue가 full이면 control thread가 기다리지 않고 정해진 정책을 실행합니다. incident trigger도 메모리 buffer의 ownership만 동결하고, 실제 파일 commit은 writer가 수행합니다. 이 구분은 3초 incident ring buffer 글이 설계한 flight recorder lifecycle을 실행 계층으로 구체화합니다.
제가 나눈 다섯 실행 lane은 서로 다른 deadline과 failure owner를 가집니다
첫 ROS 2 bridge는 하나의 큰 node보다 다음 다섯 lane을 명시적으로 나누는 편이 낫습니다. 실제로 한 process와 여러 group을 쓸지, process까지 나눌지는 fault test 결과로 정합니다.
| lane | 주요 작업 | 대기 정책 | 실패 owner |
|---|---|---|---|
| feedback ingest | LowState take·CRC/shape·sequence·timestamp, latest slot 갱신 |
backend·disk·service를 기다리지 않음 | transport health·state freshness |
| estimate·actor | 최신 snapshot 선택, estimator·feature·policy, versioned command 생성 | 다음 actor tick과 overlap 금지, stale 입력 즉시 거부 | policy deadline·mapping·model validity |
| command loop | lease·authority·target tick 검사, publish 또는 safe hold | actor 완료를 동기 대기하지 않음 | command freshness·hardware channel |
| supervisor | deadline·liveliness·age·queue saturation·authority 상태 | candidate callback과 독립적으로 권한 회수 | fail-closed transition |
| trace worker | bounded queue 소비, batch·compression·file commit·hash | control을 block하지 않음 | artifact completeness·drop accounting |
feedback과 command timer는 각각 자기 자신과 겹치지 않는 MutuallyExclusive group 후보이고, actor도 같은 tick의 중복 실행을 금지해야 합니다. 그러나 세 group을 한 MultiThreadedExecutor에 넣는 것만으로 priority isolation이 증명되지는 않습니다. 공식 Executor 문서는 callback group을 다른 executor에 배치하고 OS scheduler로 thread priority를 달리할 수 있다고 설명합니다. 첫 mock에서는 단일 executor, multi-threaded+분리 group, control 전용 executor+writer executor를 같은 입력으로 비교해야 합니다.
Python으로 구현할 경우 thread 수가 곧 CPU-bound callback 병렬 처리량이라는 가정도 피합니다. rclpy executor의 scheduling과 Python runtime, native extension, GPU call의 동작은 별도로 trace해야 합니다. 필요하면 actor를 별도 process로 격리하되, IPC serialization과 copy 비용을 end-to-end age에 포함합니다. 구현 언어를 먼저 고정하기보다 deadline과 ownership을 먼저 고정하는 이유입니다.
callback duration만 재면 queue wait와 stale age를 놓칩니다
backpressure를 보려면 최소 네 종류의 시간을 분리해야 합니다. source timestamp는 state가 만들어진 시각, callback start·end는 application이 그 sample을 처리한 구간, actor start·end는 inference 구간, command send·apply는 결과가 실행된 구간입니다. callback_duration=end-start가 짧아도 callback 시작 전에 middleware에서 오래 기다렸다면 sensor age는 이미 큽니다.
source_age_at_callback = callback_start - mapped_source_time
callback_duration      = callback_end - callback_start
actor_queue_wait       = actor_start - ingest_handoff_time
command_hold_age       = command_send - actor_end
age_to_effect          = mapped_apply_time - mapped_source_time
같은 clock으로 mapping되지 않은 timestamp를 빼서는 안 된다는 전제는 #454에 남깁니다. executor 분석에서는 sequence gap, callback start jitter, queue depth 또는 overwrite count, selected sample age, actor deadline miss, command publish interval, writer backlog·drop, supervisor reaction time을 함께 기록합니다. p50·mean만 보지 않고 p95·p99·max와 연속 miss 길이를 봅니다.
ROS 2 공식 ros2_tracing 튜토리얼은 executor callback duration을 trace하고 tracetools_analysis로 분포를 그리는 방법을 제공합니다. 이 도구를 현재 프로젝트에서 실행했다는 뜻은 아닙니다. 첫 bridge에서 callback start/end를 application log로만 재구성하지 않고 executor trace와 transport envelope를 같은 run ID로 묶을 후보로 선택한 것입니다.
첫 시험은 thread 수를 늘리는 것이 아니라 느린 작업을 주입하는 것입니다
정상 상태에서 callback 몇 번이 빨랐다는 결과로는 격리가 증명되지 않습니다. mock LowState producer, mock actor, mock command sink를 두고 actuator authority를 0으로 유지한 채 다음 fault를 넣습니다.
- slow state callback: ingest에 짧은 stall과 긴 tail을 주입해 sequence gap, newest-sample age, 다른 timer의 jitter를 비교합니다.
- default-group serialization: MultiThreadedExecutor를 쓰되 모든 entity를 기본 group에 둔 경우와 명시적 group 분리를 비교합니다.
- reentrant overlap: 같은 state callback을 겹쳐 실행해 shared estimator state, ordering, duplicate command가 깨지지 않는지 확인합니다.
- synchronous service deadlock: timer callback에서 같은 group의 service result를 기다려 watchdog이 정지와 deadlock을 구분하고 authority를 회수하는지 봅니다.
- actor stall: inference를 의도적으로 늦춰도 500Hz command loop가 만료 command를 계속 publish하지 않는지 확인합니다.
- slow disk: writer를 멈추거나 write latency를 늘려 control callback distribution과 command interval이 baseline 밖으로 변하지 않는지 봅니다.
- queue saturation: trace·actor handoff queue를 채워 full 정책, drop counter, memory bound가 manifest와 일치하는지 검증합니다.
- writer crash: 기록 process를 종료해도 supervisor와 safe command path가 살아 있고 partial artifact가 정상 incident로 보이지 않는지 확인합니다.
| 검증 질문 | 필요한 증거 | 현재 상태 |
|---|---|---|
| feedback이 최신 state를 선택하는가 | source sequence·selected sequence·age·skip counter | 설계 |
| actor stall이 command loop를 막지 않는가 | actor stall 구간의 command interval·lease·safe transition | 미구현 |
| logging이 control tail을 바꾸지 않는가 | writer 정상/slow/crash 조건의 paired callback 분포 | 미구현 |
| group 분리가 실제 병렬성을 만드는가 | executor trace의 overlap·thread ID·callback group ID | 미구현 |
| queue가 bounded인가 | 최대 resident item·byte, full policy, drop·overwrite count | incident 글에 설계만 존재 |
| fault에서 권한이 닫히는가 | 같은 run ID의 trigger→authority 0→safe command→readback | live G1 경로 미실행 |
숫자 threshold는 첫 baseline trace 전에 임의로 성공값처럼 적지 않습니다. 먼저 동일한 producer seed와 fault schedule로 세 executor 구성을 반복하고, callback·command·age 분포와 missed sequence를 얻습니다. 그 결과로 channel별 deadline과 허용 jitter를 고정한 뒤 다시 같은 suite를 통과시킵니다. 평균이 좋아졌지만 max age나 연속 miss가 악화되면 candidate 구조를 승인하지 않습니다.
현재 확인한 것은 backpressure가 아니라 backpressure를 만들 수 있는 경계입니다
현재 workspace에서 확인된 구현은 50Hz simulation policy, 동기식 backend runner, response JSON 저장, 평가 종료 뒤의 CSV·JSON writer, episode 단위 HDF5 writer입니다. ROS 2 executor·callback group·live G1 transport·bounded latest-state slot·비동기 trace writer·독립 supervisor는 아직 구현되지 않았습니다. 실제 callback backlog, disk stall 영향, thread priority, ROS 2 trace도 관측되지 않았습니다.
그래도 다음 순서는 분명해졌습니다. 먼저 timestamped TransportEnvelope와 depth-1 latest-state slot을 mock으로 만들고, actor와 command loop를 서로 기다리지 않게 나눕니다. 그 다음 bounded trace queue와 writer를 붙여 slow-disk fault를 통과시킵니다. 마지막으로 ROS 2 node에서 callback group·executor 배치를 세 가지로 바꿔 같은 trace를 비교합니다. 이 단계가 끝나기 전에는 hardware publisher에 candidate authority를 주지 않습니다.
메시지가 도착했다는 사실은 제어가 제때 실행됐다는 증거가 아닙니다. QoS는 전달을, clock mapping은 age 계산을, executor는 callback 실행을, bounded queue는 과부하의 손실 방식을, supervisor는 실패했을 때의 권한을 책임집니다. 이 다섯 책임을 한 callback에 넣지 않는 것이 이번 글에서 정한 첫 구현 계약입니다.