RT-2를 읽으면서 제게 가장 오래 남은 것은 웹 지식이 로봇 행동으로 옮겨간다는 큰 주장보다, 그 사이에 행동을 토큰으로 바꾸는 얇은 경계가 있다는 점이었습니다. 언어 모델은 다음 단어를 고르도록 만들어져 있고, 로봇은 그 결과를 관절이나 엔드이펙터의 움직임으로 실행해야 합니다. 두 세계를 같은 출력 형식으로 연결하려면 무엇을 버리고 무엇을 남길지 먼저 정해야 합니다.
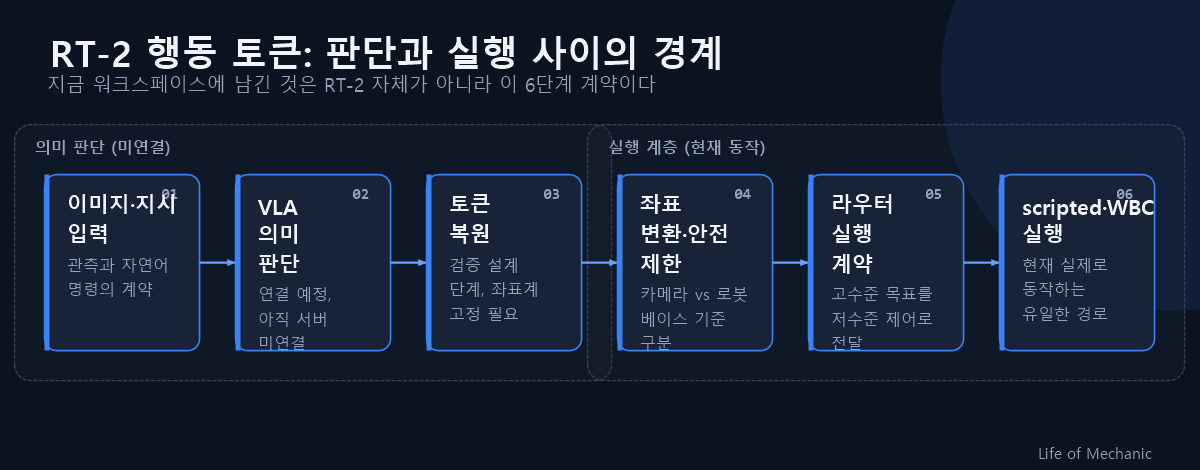
RT-2는 이미지와 자연어 지시를 받은 뒤 여덟 개의 이산 action token을 생성합니다. 이 토큰은 엔드이펙터의 6-DoF 변화와 그리퍼 동작을 양자화한 값입니다. 연속 제어값을 그대로 회귀하는 대신, 언어 모델의 기존 토큰 출력 경로를 그대로 이용한 셈입니다. 논문의 PaLI-X·PaLM-E 결과가 흥미로운 이유는 여기서 비롯된 일반화 가능성이지, 현재 제 환경에서 이미 재현된 성능이 아닙니다.
논문은 로봇 데이터와 기존 vision-language 데이터를 함께 fine-tuning해 언어 능력이 행동 학습 중 사라지는 문제를 줄였습니다. 의미 기반 지시에서 좋아진 결과와 달리, 기존 태스크의 정밀 실행은 RT-1보다 낮은 항목도 있었습니다. 제 프로젝트에서 이 차이는 중요합니다. 물체의 의미를 알아보는 능력과 그리퍼를 정확한 위치로 보내는 능력은 같은 평가가 아니므로, VLA를 붙일 때도 semantic selection과 control execution을 분리해 봐야 합니다.
지금 구현에 남겨 둔 것은 RT-2 자체가 아닙니다
현재 워크스페이스의 이론 지도에는 RT-2와 OpenVLA를 discrete action token 경로의 기준점으로 기록해 두었습니다. 목표 형태는 이미지·지시 → action token → de-tokenize → 제어기입니다. 다만 로봇 제어 라우터에서 실제로 동작하는 것은 scripted와 WBC 백엔드이고, VLA 백엔드는 OpenVLA 서버가 준비되지 않았을 때 dummy fallback으로 남아 있습니다. RT-2의 가중치, 로봇 데이터, 추론 서버를 연결한 적은 없습니다.
이 구분은 사소하지 않습니다. RT-2가 보인 의미 기반 일반화는 Google의 대규모 VLM과 로봇 시연을 함께 학습한 결과입니다. 제 프로젝트의 토큰 경로는 그 결과를 설명하기 위한 설계 메모일 뿐이며, “불을 끄는 물체” 같은 지시를 실제 로봇이 해석했다는 증거가 되지 않습니다.
논문에서 가져온 아이디어와 현재 구현의 경계
입력 계약
연결 예정
검증 설계 단계
라우터의 실행 계약
현재 동작 확인
양자화는 모델 앞의 문제가 아니라 실행 앞의 문제입니다
행동을 256개 구간 같은 이산 값으로 나누면 모델은 토큰을 고르기 쉬워집니다. 대신 복원 단계에서는 각 토큰이 어느 좌표계의 어떤 변화량인지 반드시 고정해야 합니다. 카메라 좌표계 기준의 이동과 로봇 베이스 기준의 이동은 같은 숫자라도 다른 행동이 됩니다. 그리퍼 open/close는 비교적 단순하지만, 위치와 자세 변화에는 안전 범위와 제어 주기가 함께 붙습니다.
그래서 저는 지금 토큰화 자체보다 action의 의미를 먼저 문서화하는 쪽을 택했습니다. VLA가 내놓은 상위 목표를 WBC가 안정적으로 실행한다는 라우터의 구상도 이 경계에서 나옵니다. 고수준 출력과 저수준 제어를 한 모델의 성능으로 뭉뚱그리면, 실패했을 때 의미 해석이 틀린 것인지 제어기가 목표를 못 따라간 것인지 분리할 수 없습니다.
양자화에는 또 하나의 대가가 있습니다. 허용 범위를 256개 bin으로 나누면 bin 하나의 실제 이동량은 범위 설정에 따라 달라집니다. 범위가 너무 넓으면 작은 조작의 해상도가 떨어지고, 너무 좁으면 필요한 움직임이 포화됩니다. 현재 OpenVLA 후처리는 이동과 회전 변화량을 보수적인 범위로 제한하도록 설계돼 있습니다. 이 값은 RT-2 논문의 재현 수치가 아니라 현재 라우터의 안전 경계이며, 실제 Franka 주기와 좌표계에서 별도로 검증해야 합니다.
첫 비교는 휴머노이드 보행이 아니라 Franka 조작에서 시작해야 합니다
RT-2의 원래 설정도 로봇 팔 조작입니다. 현재 데이터 수집 스키마 역시 Franka pick-place episode를 먼저 확인하는 방향으로 만들어져 있습니다. 따라서 첫 실험은 이미지와 언어 지시, 엔드이펙터 action의 기준 프레임을 고정한 단일 조작 태스크가 되어야 합니다. 그 상태에서 토큰을 다시 연속 action으로 복원했을 때 목표가 유지되는지, 그리고 WBC 또는 하위 제어기가 그것을 실행하는지를 따로 평가할 수 있습니다.
RT-2는 바로 가져다 쓸 모델이라기보다 이 경계를 놓치지 않게 해 주는 논문입니다. 다음으로 필요한 것은 더 큰 VLM이 아니라, 한 개의 Franka 시연에서 관측·지시·action이 같은 사건을 가리킨다는 것을 확인하는 일입니다.
첫 검증은 의미 판단과 움직임 복원을 나눠서 합니다
실제 서버를 연결한 뒤 처음부터 긴 pick-place 성공률만 보면 실패 위치를 알기 어렵습니다. 먼저 동일한 이미지와 지시에 대해 출력 token이 반복 가능한지, de-tokenize한 7차원 값이 허용 범위 안에 있는지, camera-to-robot-base 변환 뒤 목표 방향이 보존되는지를 기록해야 합니다. 그 다음 scripted 하위 제어로 알려진 목표를 실행해 제어 경로의 기준선을 만든 뒤 VLA 목표와 비교합니다.
의미 평가도 별도로 둡니다. 새로운 물체 이름이나 기능 지시를 이해했는지 보려면 올바른 대상 선택과 실제 grasp 성공을 분리합니다. 대상은 맞았지만 grasp가 실패했다면 의미 전이가 틀렸다고 결론 내릴 수 없습니다. 반대로 제어기는 목표를 정확히 따라갔지만 잘못된 물체를 집었다면 action 실행보다 grounding 문제입니다. RT-2가 제 파이프라인에 남긴 가장 실용적인 교훈은 VLM의 지식과 로봇 제어의 성공을 하나의 숫자로 합치지 않는 것입니다.
논문 분석: 인터넷에서 배운 지식이 로봇의 손으로 이어질 수 있을까 — RT-2 읽기 · RT-2 원문
원문 보기: RT-2 (arXiv 2307.15818)