G1 학습 코드를 처음 따라가면서 이상했던 부분이 하나 있었습니다. PPO 설정에는 actor와 critic이 있고, critic의 은닉층 크기와 value loss 계수도 적혀 있습니다. 그런데 Q network는 없습니다. 그럼에도 actor를 갱신할 때는 “이 행동이 예상보다 얼마나 좋았는가”를 나타내는 advantage가 필요합니다. 행동을 입력으로 받는 Q network가 없는데, 행동별 평가값은 어디서 생기는 걸까요.
답을 찾으려고 workspace만 검색하면 중간에서 길이 끊깁니다. training/rl/train.py는 YAML 설정을 Isaac Lab용 RSL-RL 설정 객체로 바꾸고 OnPolicyRunner를 시작합니다. G1 커스텀 PPO는 추가 reward와 진단값을 저장하고 update를 확장하지만, 기본적인 return과 GAE 계산은 외부 의존성인 RSL-RL이 맡습니다. 즉 이 문제는 수식만 이해해서도, 우리 코드만 읽어서도 끝나지 않습니다. 로봇이 실제로 만든 한 개의 transition이 rollout storage에서 어떤 숫자로 바뀌는지까지 연결해서 봐야 합니다.
이 글은 PPO 전체 학습 루프와 clipping을 다시 설명하는 글이 아닙니다. return, V, Q, advantage가 같은 미래를 서로 어떻게 다르게 묻는지, PPO가 별도 Q network 없이 advantage를 만드는 방법, 그리고 terminal과 timeout이 critic의 정답을 어떻게 바꾸는지를 현재 G1 구현에 맞춰 정리합니다.
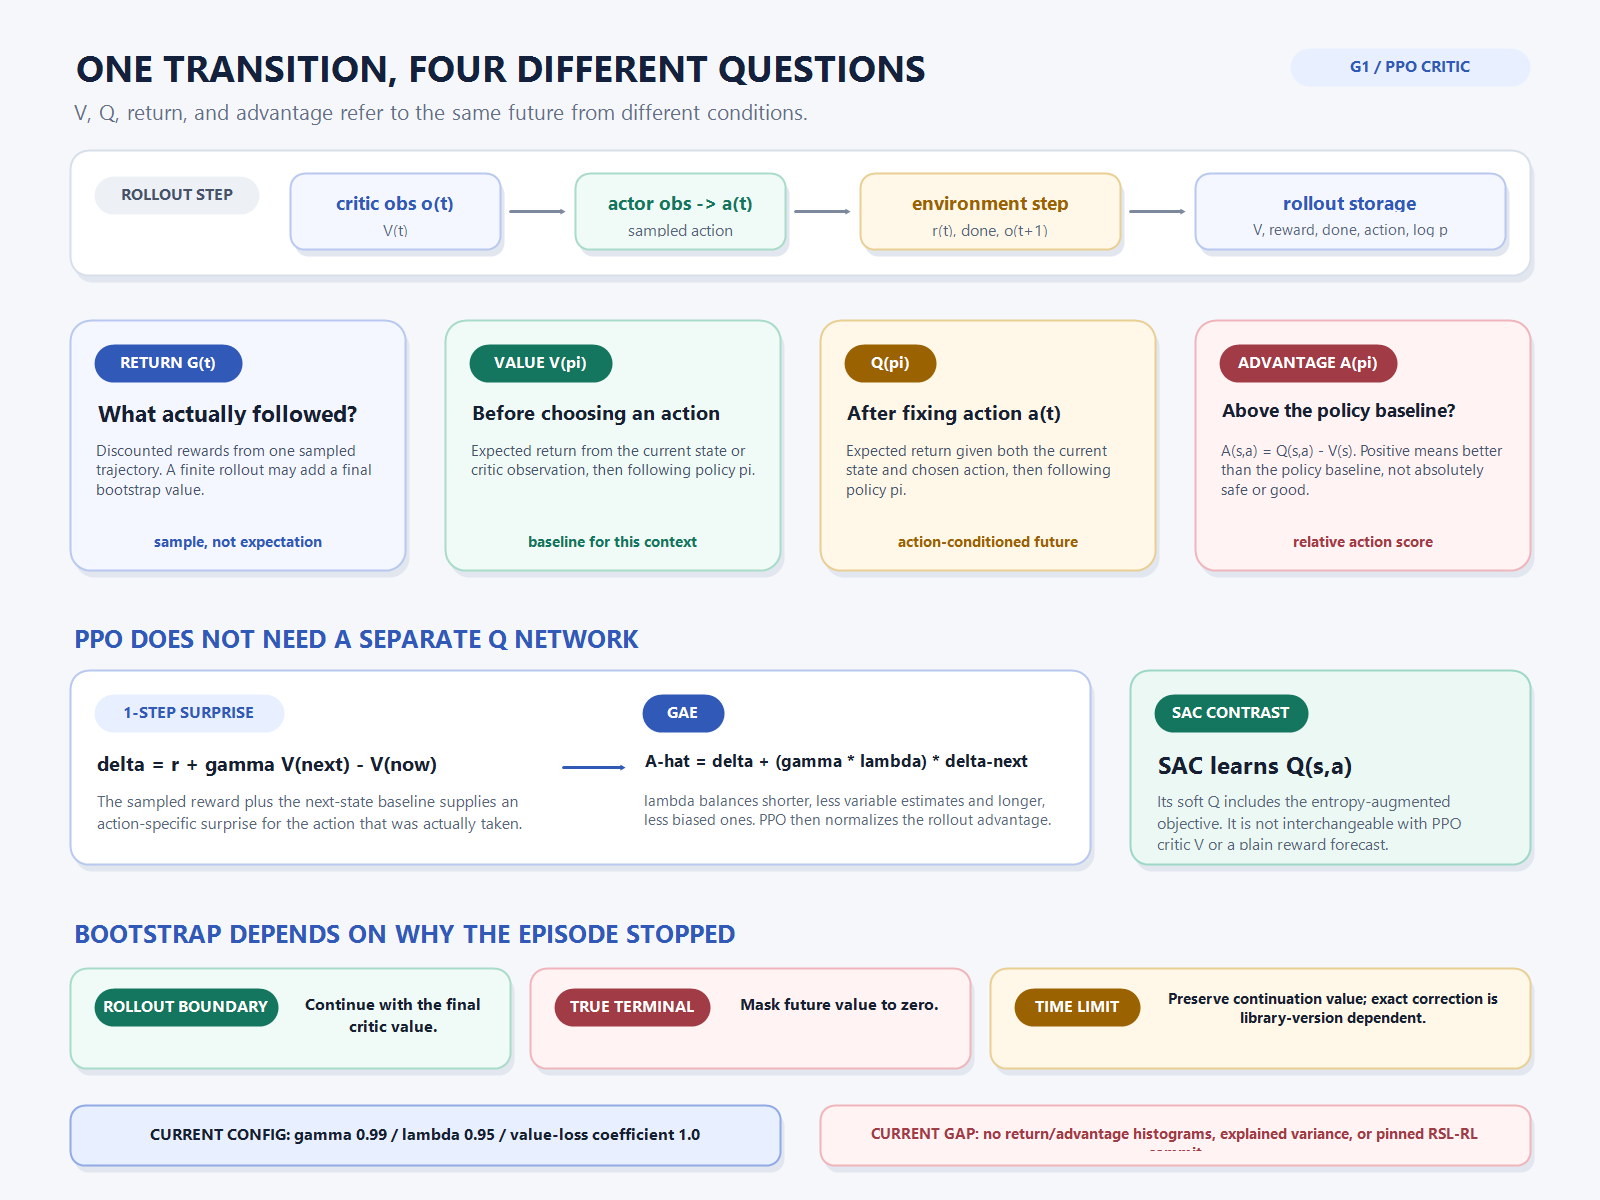
Return은 한 번 관측한 미래이고, value는 그 미래들의 평균입니다
먼저 return과 value를 분리해야 합니다. 시각 t에서 이후에 받은 reward를 할인해 더한 값이 return G_t입니다.
G_t = r_t + γ r_(t+1) + γ² r_(t+2) + ...return은 한 trajectory에서 실제로 벌어진 결과입니다. 같은 자세와 명령에서 시작해도 actor가 다른 action을 샘플링하거나 물리 접촉이 달라지면 다른 return을 얻을 수 있습니다. 따라서 return 하나는 “그때 실제로 어떻게 되었는가”에 대한 표본이지, 그 상태의 객관적인 점수가 아닙니다.
반면 state value V^π(s)는 현재 상태에서 정책 π를 계속 따를 때 얻을 return의 기댓값입니다.
V^π(s) = E_π[G_t | s_t = s]로봇 구현에서는 완전한 상태 s 대신 critic이 실제로 받는 observation을 넣으므로 V(o_t)라고 쓰는 편이 더 정직합니다. 특히 현재 G1의 일부 경로처럼 actor와 critic의 입력이 다르면, critic은 actor가 보는 화면의 가치가 아니라 critic observation으로 조건화된 미래 return을 예측합니다. privileged observation을 쓰는 이유와 배포 시 actor 입력이 어떻게 유지되는지는 비대칭 actor-critic 글에서 별도로 다뤘습니다.
Q는 action을 하나 고정한 뒤의 미래를 묻습니다
action value Q^π(s,a)는 상태뿐 아니라 지금 선택할 action까지 조건으로 겁니다. 이 action을 한 번 실행한 뒤에는 다시 정책 π를 따른다고 가정합니다.
Q^π(s,a) = E_π[G_t | s_t = s, a_t = a]차이는 질문을 던지는 시점에 있습니다. V는 action을 뽑기 전에 “이 상황에서 평소 정책대로 하면 얼마나 얻을까”를 묻습니다. Q는 후보 action 하나를 지정한 뒤 “바로 이 행동을 하고 나면 얼마나 얻을까”를 묻습니다. 그래서 같은 상태에서도 action마다 Q는 달라질 수 있지만 V는 하나입니다.
| 값 | 조건으로 아는 것 | 답하는 질문 | 현재 PPO에서의 역할 |
|---|---|---|---|
Return G_t |
한 번 진행된 trajectory | 실제로 어떤 보상을 받았는가 | critic target을 만드는 표본 |
V^π(s) |
현재 상태, 이후 정책 | 행동을 고르기 전 평균적인 미래는 어떤가 | critic이 직접 예측 |
Q^π(s,a) |
현재 상태와 지금의 행동 | 이 행동을 한 뒤의 평균적인 미래는 어떤가 | 별도 network로 직접 학습하지 않음 |
A^π(s,a) |
Q와 같은 조건 | 이 행동이 현재 정책의 기준보다 나았는가 | actor update의 방향과 강도 |
여기서 V와 Q는 모두 정책에 상대적인 값입니다. 같은 G1 자세라도 정책이 달라지면 이후에 선택할 행동이 달라지고 값도 달라집니다. reward 구성이나 termination 규칙을 바꾸어도 값의 의미가 달라집니다. 따라서 서로 다른 reward version에서 나온 value를 절대적인 “보행 점수”처럼 비교하면 안 됩니다.
Advantage는 행동의 절대 점수가 아니라 기준선과의 차이입니다
advantage는 Q에서 V를 뺀 값입니다.
A^π(s,a) = Q^π(s,a) - V^π(s)예를 들어 critic이 현재 상황의 평균적인 미래 return을 100으로 예상하고, 특정 action을 했을 때의 기대 return이 106이라면 advantage는 +6입니다. 이 숫자는 설명을 위한 예시일 뿐 G1 실험 측정값은 아닙니다. 의미는 단순합니다. 그 action은 같은 상황에서 현재 정책이 평균적으로 할 행동보다 나았습니다. 반대로 -6이라면 기준보다 나빴습니다.
양수 advantage를 “좋은 행동”이라고 바로 부르면 문제가 생깁니다. reward가 잘못 설계되어 팔을 고정한 채 버티는 행동에 높은 점수를 주었다면, 그 행동은 critic의 기준보다 유리하면서도 우리가 원하는 걷기에는 해로울 수 있습니다. advantage는 reward와 정책이 만든 내부 비교값이지, 안전성이나 자연스러움을 판정하는 외부 기준이 아닙니다.
PPO는 별도의 Q network 없이 어떻게 advantage를 만드는가
PPO rollout에서는 actor가 실제 action a_t를 하나 샘플링하고 환경이 reward r_t와 다음 observation을 돌려줍니다. 이 transition 자체가 선택된 action의 결과입니다. critic은 현재와 다음 observation의 V를 예측하고, 두 값 사이에 실제 reward를 끼워 넣어 TD residual을 계산합니다.
δ_t = r_t + γ V(o_(t+1)) - V(o_t)critic이 정확하다고 가정하면 δ_t는 실제로 선택된 action의 one-step advantage 표본으로 해석할 수 있습니다. 평소 기대한 만큼만 진행됐다면 0에 가깝고, 예상보다 좋은 reward와 다음 상태를 만들었다면 양수가 됩니다. action을 Q network에 다시 넣지 않아도 되는 이유입니다. 환경에서 그 action을 이미 실행했고, 그 결과가 transition에 들어 있기 때문입니다.
하지만 한 step의 residual은 접촉 노이즈와 지연 reward에 민감합니다. 그래서 PPO는 여러 시점의 residual을 할인해 더하는 GAE(Generalized Advantage Estimation)를 사용합니다.
Â_t = δ_t + (γλ)δ_(t+1) + (γλ)²δ_(t+2) + ...현재 기본 G1 PPO 설정은 γ=0.99, λ=0.95입니다. λ를 0에 가깝게 두면 가까운 TD 정보에 더 의존해 분산은 줄지만 부정확한 critic에서 오는 bias가 커질 수 있습니다. 1에 가까워지면 더 긴 구간의 결과를 반영해 bias는 줄이는 대신 trajectory 차이에 따른 분산이 커집니다. 이것이 GAE 논문이 다루는 핵심 trade-off입니다.
현재 RSL-RL storage 안에서는 V, return, advantage가 따로 저장됩니다
현재 G1 학습 경로를 코드 순서대로 읽으면 다음과 같습니다. actor가 action을 만들 때 critic도 같은 시점의 value를 계산합니다. 환경 step 뒤에는 reward와 done을 저장합니다. rollout이 다 차면 마지막 observation의 value를 한 번 더 계산하고 뒤에서 앞으로 TD residual과 GAE를 누적합니다. 마지막으로 return = advantage + value를 만들고 advantage를 정규화한 뒤 mini-batch update에 사용합니다.
act:
  action_t = actor(observation_t)
  value_t  = critic(critic_observation_t)

step:
  store(action_t, value_t, reward_t, done_t, log_prob_t)

after rollout:
  last_value = critic(last_critic_observation)
  delta_t    = reward_t + not_terminal * γ * next_value - value_t
  advantage  = delta_t + not_terminal * γ * λ * next_advantage
  return_t   = advantage_t + value_t
여기서 중요한 구현 경계가 있습니다. 이 기본 계산은 workspace의 train.py가 직접 구현하지 않고 외부 RSL-RL 패키지에 맡깁니다. training/rl/environment.yml도 저장소 URL만 가리키고 commit을 고정하지 않습니다. 현재 데스크탑에는 과거 학습에 사용한 Isaac Lab runtime이 남아 있지 않아 정확한 설치 버전을 다시 확인할 수 없습니다. 그러므로 위 흐름은 현재 RSL-RL main과 workspace 확장 코드를 함께 대조한 결과이며, 과거 모든 checkpoint가 동일한 timeout 보정 세부 구현을 사용했다고 단정할 수는 없습니다.
Rollout이 끝난 것과 episode가 끝난 것은 같은 사건이 아닙니다
rollout은 학습을 위해 transition을 일정 개수씩 잘라 모으는 저장 단위입니다. 현재 기본 설정의 num_steps_per_env=24가 끝났다고 해서 G1의 미래가 사라지는 것은 아닙니다. 이 경우 마지막 observation의 critic value를 붙여 rollout 바깥의 미래를 근사합니다. 이것이 bootstrap입니다.
반면 로봇이 넘어져 task의 terminal 상태에 도달했다면 그 episode 이후의 reward는 없습니다. 다음 value를 0으로 막아야 합니다. 두 사건을 같은 done 하나로 처리하면 24번째 step마다 아직 걸을 수 있는 상태의 미래를 인위적으로 잘라 버리거나, 넘어진 다음에 존재하지 않는 가치를 붙일 수 있습니다.
| 경계 원인 | 실제 의미 | critic target 처리 | 잘못 처리했을 때 |
|---|---|---|---|
| rollout buffer 끝 | 데이터 묶음만 끝남 | 마지막 V로 bootstrap | 긴 미래를 24 step에서 잘라 봄 |
| true terminal | 넘어짐 등 task가 실제 종료 | 미래 V를 0으로 mask | 종료 뒤에 존재하지 않는 가치를 더함 |
| time limit | 외부 시간 제한으로 잘림 | continuation value를 보존 | 멀쩡한 상태를 terminal처럼 벌점화 |
현재 RSL-RL main은 time_outs가 전달되면 저장된 value를 이용해 reward를 보정한 뒤 done mask와 함께 return을 계산합니다. 수학적으로는 truncation 뒤에도 미래가 이어진다는 정보를 보존하려는 처리입니다. 다만 라이브러리 버전에 따라 terminal observation과 pre-reset observation을 다루는 방식이 달라질 수 있으므로, 일반식 r + γV(next)만 보고 실제 tensor가 어느 시점의 observation인지 단정해서는 안 됩니다. G1 환경에서 terminated와 truncated가 만들어지는 구체적인 경로는 termination·timeout·reset 글에 분리해 두었습니다.
Critic loss가 낮다고 좋은 정책인 것은 아닙니다
critic은 계산된 return target과 자신의 value 예측 차이를 줄입니다. 현재 PPO update는 value 변화도 clipping한 뒤 제곱 오차를 사용합니다. 이 loss가 내려가면 “현재 reward와 bootstrap 규칙으로 만든 target을 더 잘 맞추고 있다”는 뜻은 됩니다. 하지만 다음 네 가지는 말해 주지 않습니다.
- reward가 우리가 원하는 자연스러운 보행을 정확히 표현하는가
- actor가 simulator 밖의 외부 acceptance gate를 통과하는가
- termination과 timeout target이 올바르게 구분되었는가
- critic이 새로운 명령·속도·초기 자세에서도 보정되어 있는가
실제 G1 기록에서도 유한한 value loss를 남긴 학습 버전들이 외부 행동 gate를 통과하지 못했습니다. 수치 사례와 TensorBoard에서 다른 scalar를 함께 읽는 방법은 PPO 학습 로그 해석 글의 범위입니다. 여기서 가져올 결론은 하나입니다. value loss는 critic이 내부 target을 얼마나 맞추는지 보는 학습 지표이지, 로봇 정책의 품질 보증서가 아닙니다.
Advantage 정규화 뒤에는 원래 분포가 보이지 않습니다
현재 RSL-RL 경로는 rollout에서 계산한 advantage를 평균 0, 표준편차 1에 가깝게 정규화해 actor update에 넣습니다. batch의 스케일 차이가 gradient 크기를 지나치게 흔드는 것을 줄이는 데 유용하지만, 정규화된 값만 보면 원래 advantage가 전부 작은지, 일부 terminal 직전 표본만 큰 음수인지 알 수 없습니다.
adv_normalized = (adv_raw - mean(adv_raw)) / (std(adv_raw) + 1e-8)정규화 전 advantage가 모두 비슷하게 나쁘더라도 batch 안에서는 상대적인 양수와 음수가 생깁니다. 반대로 reward scale을 바꾸면 raw return과 value loss는 크게 바뀌지만 정규화된 actor 입력의 분포는 다시 비슷해질 수 있습니다. 따라서 서로 다른 reward version을 비교할 때 policy loss나 value loss 하나만 놓고 해석하면 reward scale, target 분산, 정규화 효과를 뒤섞게 됩니다.
SAC의 Q는 PPO critic의 V와 목적부터 다릅니다
PPO와 SAC 비교 글에서 설명했듯 SAC는 replay buffer의 transition을 재사용하며 Q network를 직접 학습합니다. actor는 상태에서 action을 만들고, critic은 그 (s,a) 조합의 soft Q를 평가합니다. 그래서 PPO처럼 rollout마다 별도 Q 없이 advantage를 재구성하는 경로와 구조가 다릅니다.
또한 SAC의 soft Q는 단순한 discounted reward만이 아니라 entropy를 포함한 maximum-entropy 목적에 상대적인 값입니다. PPO의 V, 일반적인 Q, SAC의 soft Q를 모두 “미래 보상 예측”이라고 뭉뚱그리면 network 입력뿐 아니라 최적화 대상의 차이까지 놓칩니다.
현재 G1 critic에서 실제로 부족한 증거
현재 공통 로그에서는 mean value loss는 확인할 수 있지만, critic이 어느 구간에서 틀리는지 판단할 자료가 충분하지 않습니다. return과 raw advantage의 분포, TD residual, explained variance가 학습 버전 전체에서 공통 schema로 기록되지 않습니다. timeout과 true terminal에서 마지막 target이 어떻게 구성됐는지 재현할 fingerprint도 부족합니다.
| 추가할 기록 | 확인하려는 질문 | 판단할 수 없는 것 |
|---|---|---|
| raw advantage 평균·표준편차·분위수 | 신호가 소수의 큰 실패에 지배되는가 | 행동 자체가 자연스러운가 |
| return과 value의 평균·분산 | critic scale과 target scale이 맞는가 | reward 설계가 올바른가 |
| explained variance | critic이 target 변동을 설명하는가 | 정책이 acceptance gate를 통과하는가 |
| terminal·timeout별 TD residual | 종료 원인에서 target이 비정상적으로 튀는가 | reset 뒤 물리 상태가 안전한가 |
| RSL-RL commit·Isaac Lab 버전 | return 계산 경로를 재현할 수 있는가 | 동일 seed에서 완전한 결정론 |
다음 학습 전에 할 일은 새로운 critic 구조를 추가하는 것이 아닙니다. 먼저 rollout 저장 직후, 정규화하기 전의 advantage와 return 통계를 남기고, terminal과 timeout 표본을 분리해 TD target을 확인해야 합니다. 동시에 checkpoint sidecar에 RSL-RL 패키지 버전 또는 commit을 기록해야 합니다. 이 관측이 있어야 value loss가 큰 이유를 “critic 용량 부족”, “reward scale 변화”, “termination target 오류”, “실제로 예측하기 어려운 rollout”로 나눌 수 있습니다.
정리: critic은 성공을 판정하지 않고 비교 기준을 만듭니다
Return은 한 번 경험한 미래이고, V는 행동을 고르기 전 그 미래들의 평균이며, Q는 특정 행동을 고정한 뒤의 평균입니다. Advantage는 Q에서 V를 뺀 상대값입니다. PPO는 Q network를 따로 만들지 않고, 실제로 선택한 action의 reward와 앞뒤 V에서 TD residual을 계산하고 GAE로 누적해 advantage를 얻습니다.
이 구조에서 critic의 역할은 로봇이 잘 걷는지 최종 판정하는 것이 아닙니다. 같은 조건에서 actor가 평균적으로 하던 행동보다 이번 행동이 나았는지를 비교할 기준선을 제공하는 것입니다. 그 기준선은 reward, 정책, observation, 종료 규칙에 따라 함께 변합니다. 그래서 현재 G1 파이프라인에서 critic을 신뢰하려면 value loss 하나가 아니라 raw return·advantage 분포, 종료 원인별 bootstrap, 외부 행동 gate를 같은 학습 버전에 묶어 보아야 합니다.
다음 검증: RSL-RL runtime fingerprint를 checkpoint에 저장하고, 정규화 전 advantage·return·TD residual을 terminal과 timeout별로 기록하는 최소 instrumentation을 먼저 추가합니다. 그 뒤에야 critic architecture나 value loss 계수를 바꾸는 실험이 무엇을 개선했는지 설명할 수 있습니다.
참고 자료