G1의 비정상적인 상체 동작이 큰 탐색 noise 때문인지 확인하려고 v401에서 actor의 standard deviation을 직접 줄였습니다. 전체 std 평균은 1.138에서 0.526으로, 최댓값은 2.813에서 1.022로 내려갔습니다. 변경은 의도대로 적용됐습니다. 그런데 simulator에 전달된 action은 여전히 clip 상한 4.0에 닿았고 평가도 실패했습니다.
v418에서는 범위를 더 좁혔습니다. 상체와 hip roll·yaw에 해당하는 21개 관절의 std 평균을 0.5209에서 0.3305로, 최댓값을 0.6001에서 0.3500으로 제한했습니다. route는 보존됐지만 deterministic actor mean과 눈에 보이는 morphology는 거의 움직이지 않았습니다. slow displacement는 1.474m에서 1.325m로 나빠졌고 nominal은 8.248m에서 8.431m로 조금 늘었지만 acceptance gate는 통과하지 못했습니다.
두 실험은 같은 사실을 가리켰습니다. 정책이 어디를 중심으로 행동하는지와 그 주변을 얼마나 넓게 탐색하는지는 서로 다른 parameter입니다. std를 줄이면 sample의 흔들림은 줄일 수 있지만 이미 잘못된 곳에 자리 잡은 actor mean을 자동으로 옮기지는 않습니다. 이 글에서는 이 구분을 현재 G1의 29차원 Gaussian action, entropy bonus, 학습 rollout과 deterministic evaluation 경로로 이어서 설명합니다.
PPO 로그 글이 entropy와 mean std 숫자를 읽는 법을, 하이퍼파라미터 글이 변경 순서를 맡고 있습니다. 여기서는 숫자를 튜닝하지 않습니다. 같은 checkpoint가 학습 중에는 action을 표본화하고 평가에서는 mean을 내는 이유, 그리고 그 차이가 G1 관절 목표에서 어떤 물리적 결과를 만드는지에 집중합니다.
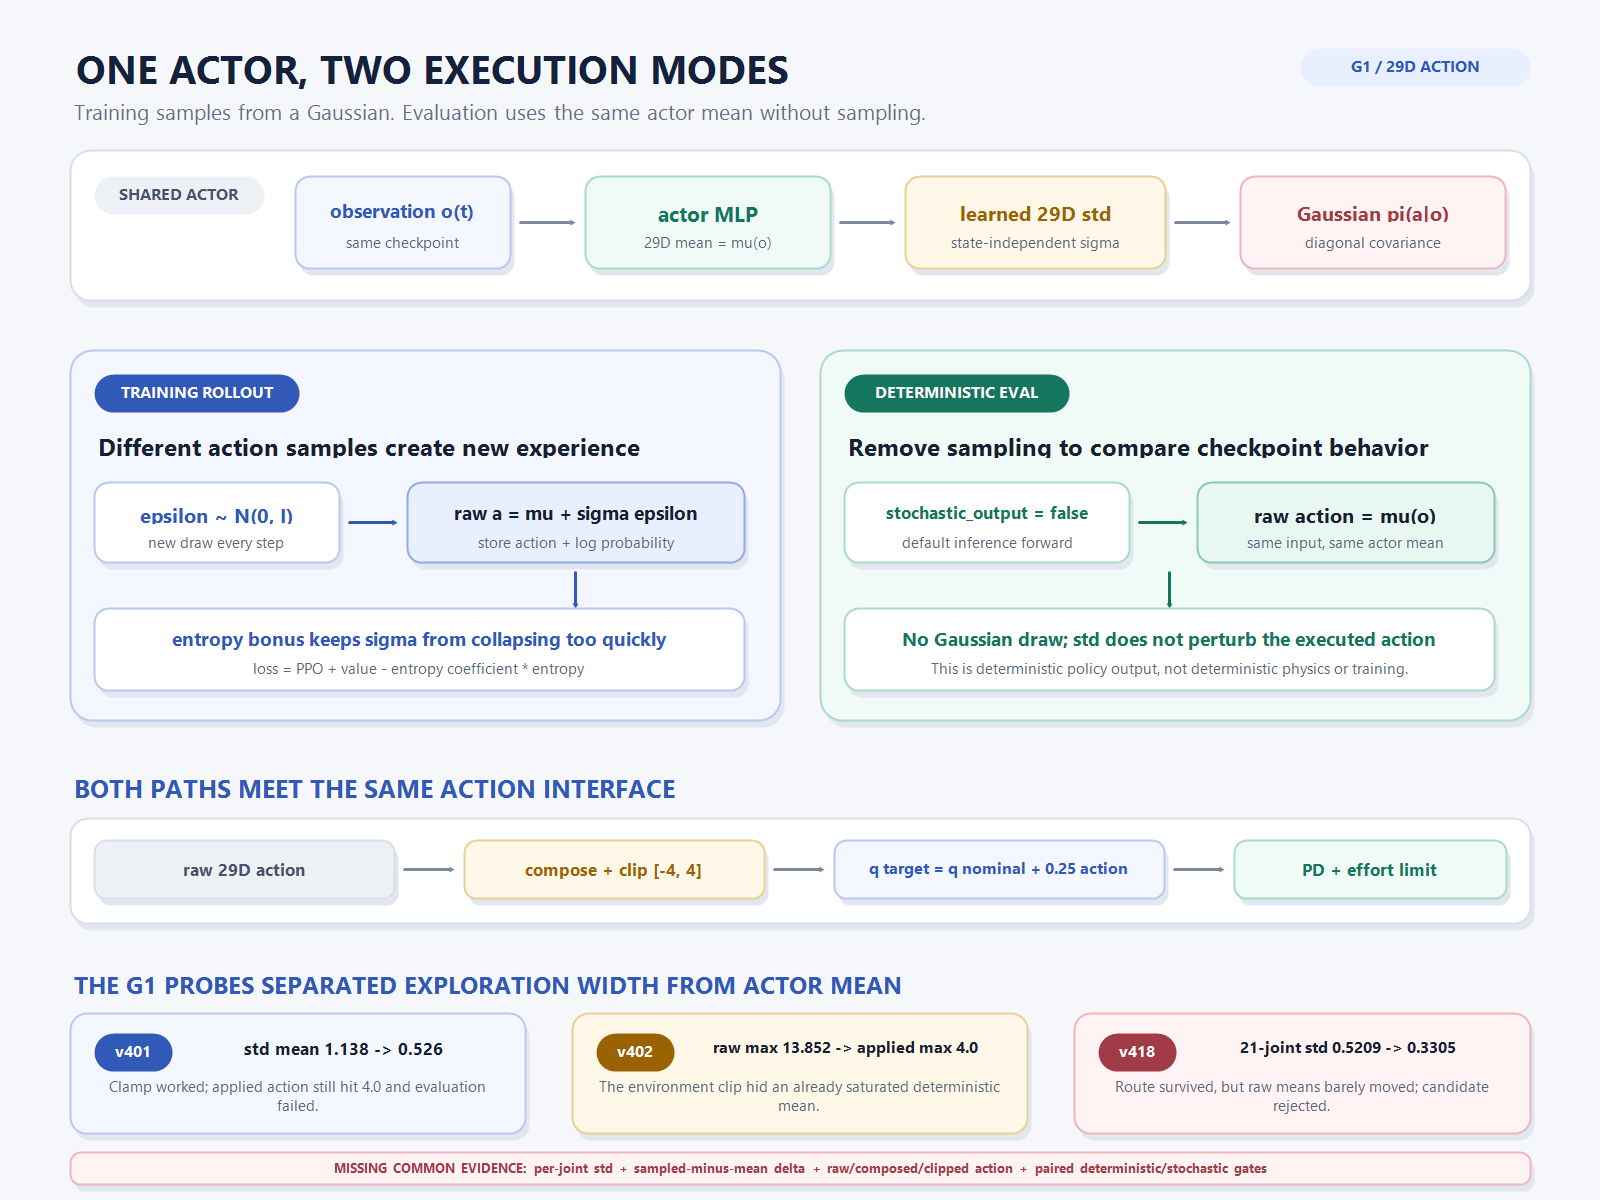
μ+σε를 실행해 새로운 transition을 만들고, deterministic 평가는 같은 actor의 μ만 실행합니다. v401·v402·v418은 std를 줄이는 일과 이미 포화된 mean을 바꾸는 일이 별개의 문제임을 보여 줬습니다.Actor가 출력하는 것은 29개의 확정값이 아니라 행동분포입니다
현재 기본 G1 policy는 29개 관절에 대응하는 연속 action을 만듭니다. 학습 중 actor MLP가 관측 o_t를 받아 29차원 평균 μ(o_t)를 출력하고, action distribution은 관절별 표준편차 σ를 함께 사용합니다. RSL-RL의 기본 Gaussian은 공분산의 비대각 성분을 직접 학습하지 않는 diagonal Gaussian입니다.
π(a|o) = Normal( μ(o), diag(σ²) )

a_t = μ(o_t) + σ ⊙ ε_t
ε_t ~ Normal(0, I)μ는 현재 관측에서 정책이 가장 중심에 두는 raw action입니다. σ는 그 중심 주변에서 각 관절 action을 얼마나 넓게 뽑을지 정합니다. 현재 기본 contract의 std는 state-independent parameter이므로 같은 checkpoint에서는 관측이 달라져도 관절별 σ 자체는 같습니다. 관측에 따라 바뀌는 것은 actor MLP가 만든 mean입니다.
RSL-RL 최신 구현에는 관측마다 std도 출력하는 heteroscedastic Gaussian이 별도로 존재하지만, 현재 G1 YAML은 이전 형식의 init_noise_std를 사용하고 handle_deprecated_rsl_rl_cfg가 설치된 버전의 설정 구조로 변환합니다. 현재 프로젝트의 기본 경로를 state-dependent uncertainty 모델처럼 설명하지 않은 이유입니다.
같은 관측에서도 학습 action이 달라지는 이유는 ε를 다시 뽑기 때문입니다
학습 rollout에서 RSL-RL PPO는 actor를 stochastic_output=True로 호출합니다. distribution을 현재 mean과 std로 갱신하고 sample 하나를 뽑습니다. 그 action과 log probability, value, reward, done이 rollout storage에 들어갑니다. 다음 step에서 새로운 ε를 뽑으므로 observation이 우연히 같더라도 raw action은 달라질 수 있습니다.
# RSL-RL PPO rollout의 의미
sampled_action = actor(observation, stochastic_output=True)
log_prob       = log π(sampled_action | observation)
next_obs, reward, done = env.step(sampled_action)
이 확률성이 필요한 이유는 아직 실행하지 않은 action 주변을 실제 환경에서 시험하기 위해서입니다. mean만 계속 실행하면 현재 policy가 이미 선택한 좁은 궤적의 경험만 모입니다. sample이 다른 joint target을 만들면 접촉, body velocity, 다음 observation과 reward가 달라지고, 그 결과가 advantage를 통해 mean과 std의 다음 update에 반영됩니다. PPO가 그 action을 어떻게 평가하는지는 V·Q·Advantage 글에서 분리해 설명했습니다.
Initial std, 현재 std, entropy coefficient는 같은 숫자가 아닙니다
탐색 설정을 볼 때 가장 먼저 구분해야 할 세 값이 있습니다.
| 항목 | 무엇을 뜻하는가 | 언제 작동하는가 | 직접 바꾸지 않는 것 |
|---|---|---|---|
init_noise_std |
학습 시작 시 관절별 σ의 초기값 | actor distribution 생성 시 | checkpoint에서 복원된 현재 std |
현재 std_param |
지금 checkpoint가 가진 관절별 탐색 폭 | Gaussian sample·log probability·entropy | actor MLP가 출력하는 mean |
entropy_coef |
분포 entropy를 loss에 얼마나 반영할지 | mini-batch optimizer update | std를 지정된 값으로 강제 고정 |
origin/main@ee4d96e 기준 flat과 rough G1 설정은 모두 init_noise_std=1.0에서 시작합니다. entropy coefficient는 flat 0.002, rough 0.005로 다릅니다. 이것은 rough policy가 더 좋은 탐색을 이미 검증했다는 결과가 아니라 서로 다른 configuration의 설계값입니다. checkpoint를 resume하면 현재 std parameter도 actor state와 함께 복원되므로 YAML의 초기값만 보고 실제 탐색 폭을 판단할 수 없습니다.
Entropy는 mean을 흔드는 noise가 아니라 분포 폭에 대한 최적화 압력입니다
서로 독립인 Gaussian action의 entropy는 각 관절 std가 넓을수록 커집니다. 평균 μ가 어디에 있는지는 Gaussian entropy 식에 들어가지 않습니다.
H[π] = Σ_j 0.5 × log(2πe σ_j²)

PPO total loss
= surrogate loss
 + value coefficient × value loss
 - entropy coefficient × H[π]
RSL-RL은 gradient descent를 사용하므로 entropy 항 앞에 음수가 붙습니다. entropy coefficient가 양수라면 entropy를 크게 유지하는 방향, 즉 std가 너무 빨리 0에 가까워지지 않는 방향으로 압력을 줍니다. state-independent Gaussian에서 이 항은 mean에 직접 gradient를 주지 않습니다. 다만 surrogate loss와 같은 optimizer에서 actor parameter가 함께 갱신되므로 이후 rollout 분포와 학습 데이터가 달라져 mean에 간접적인 영향은 생길 수 있습니다.
그래서 entropy coefficient를 0.002에서 다른 값으로 바꾸는 일과 std를 0.35로 clamp하는 일은 동일한 조작이 아닙니다. 전자는 optimizer objective의 상대 가중치를 바꾸고, 후자는 선택한 관절의 현재 distribution parameter를 즉시 제한합니다. 둘을 모두 “noise를 줄였다”고 기록하면 변경 시점과 인과관계를 잃습니다.
Deterministic 평가는 같은 actor에서 Gaussian sample만 제거합니다
현재 play.py와 공통 evaluator는 checkpoint를 읽은 뒤 RSL-RL의 get_inference_policy()를 가져와 policy(obs)를 호출합니다. 최신 RSL-RL MLPModel.forward의 stochastic_output 기본값은 False입니다. Gaussian distribution이 있어도 sample을 뽑지 않고 MLP output, 즉 mean을 반환합니다.
# 학습 rollout
action_train = actor(obs, stochastic_output=True)   # μ + σε

# 현재 평가·play 경로
action_eval  = policy(obs)                          # μ
deterministic evaluation의 목적은 탐색 noise를 제거해 두 checkpoint의 중심 행동을 같은 scenario에서 비교하는 것입니다. std가 큰 candidate와 작은 baseline을 stochastic action으로 한 번씩만 실행하면, policy mean의 차이보다 ε 표본 차이가 결과를 더 흔들 수 있습니다. mean action을 쓰면 적어도 “이 checkpoint가 중심으로 선택하는 행동”을 비교할 수 있습니다.
그렇다고 전체 simulation이 결정론적이라는 뜻은 아닙니다. reset state, command sampler, PhysX 접촉, GPU 연산과 runtime version이 달라지면 mean policy를 사용해도 trajectory가 달라질 수 있습니다. deterministic policy output, 같은 seed의 repeatability, bitwise deterministic training은 서로 다른 계약입니다. seed와 runtime 범위는 PPO 재현성 글이 소유합니다.
Gaussian raw action은 그대로 관절 각도가 되지 않습니다
학습과 평가의 두 경로는 sample 여부만 다르고 이후 action interface는 같습니다. 현재 Direct G1Walk 환경은 actor raw action을 받아 필요한 group transform을 적용한 뒤 [-4,4]로 clip합니다. 그 값에 action_scale=0.25를 곱하고 nominal joint position에 더해 위치 목표를 만듭니다.
raw action
→ optional group composition
→ applied action = clip(composed action, -4, 4)
→ q_target = q_nominal + 0.25 × applied action
→ implicit PD
→ effort limit
→ joint torque
초기 std 1.0은 raw action 단위의 표준편차입니다. clip에 걸리지 않는 구간이라면 action noise 1은 위치 목표 약 0.25rad의 차이로 이어집니다. 하지만 Gaussian은 이론상 범위가 제한되지 않으므로 raw sample이나 mean이 4를 넘을 수 있습니다. 그때 여러 raw 값이 모두 같은 applied action 4로 접힙니다.
PPO storage는 actor가 표본화한 raw action과 그 log probability를 보존하지만, simulator는 clip 이후 action을 실행합니다. raw tail의 서로 다른 값이 같은 물리 target을 만들 수 있다는 뜻입니다. 이 경계는 “std가 크다”와 “로봇 관절이 실제로 크게 흔들렸다”를 같은 문장으로 쓸 수 없게 만듭니다. raw·composed·clipped action과 최종 position target을 함께 기록해야 합니다. 전체 PD 경로는 위치·속도·토크 제어 글에서 다뤘습니다.
v401은 탐색 폭을 줄여도 applied action 포화가 남는다고 보여 줬습니다
v400의 checkpoint audit에서는 std가 큰 채널이 문제가 두드러진 상체에 몰려 있었습니다. 오른쪽 wrist pitch·yaw는 2.81·2.80, 왼쪽 wrist pitch·yaw는 2.66·2.53, waist pitch는 2.35였습니다. 그래서 v401은 reward나 action scale을 건드리지 않고 checkpoint load 뒤 상체·hip roll·yaw std만 최대 0.6으로 제한했습니다.
std 평균은 1.138에서 0.526으로 내려갔습니다. intervention 자체는 성공했습니다. 그러나 nominal trace에서 applied action max는 4.0이었고 waist 0.3504, hip 0.4043, arm action 3.5087이 남았습니다. slow displacement 0.256m, nominal 5.500m였으며 평가 gate는 실패했습니다.
여기에는 두 설명이 가능했습니다. 첫째, std를 낮춰도 actor mean 자체가 이미 clip 바깥에 있을 수 있습니다. 둘째, 2-iteration probe가 mean을 옮기기에는 너무 짧았을 수 있습니다. v401만으로 둘 중 하나를 확정하지 않고, 다음 v402에서 std clamp를 유지한 채 upper-body mean-bound loss를 추가했습니다.
v402의 raw trace가 sample noise 뒤에 숨은 mean saturation을 드러냈습니다
v402는 상체 mean action이 절댓값 2를 넘으면 비용을 주는 loss를 추가했습니다. 학습 로그에는 해당 loss 8.6226이 기록되어 배선은 확인됐습니다. 하지만 nominal 평가의 waist·hip·arm action은 0.352·0.396·3.515로 거의 움직이지 않았고 candidate는 다시 실패했습니다.
이후 trace에 raw-commanded action을 추가하자 경계가 선명해졌습니다. applied action의 평균·최댓값은 2.861·4.000이었지만 raw action은 4.912·13.852였습니다. raw arm 평균은 7.274였습니다. 환경 clip이 표면의 action max를 4로 고정해 주고 있었을 뿐, actor가 중심으로 내는 명령은 이미 그 바깥에 자리 잡고 있었습니다.
| Probe | 단일 변경 | 직접 확인한 것 | 승인되지 않은 이유 |
|---|---|---|---|
| v401 | 선택 관절 std max 0.6 | std 평균 1.138→0.526 | applied action 4.0, morphology·이동 gate 실패 |
| v402 | std clamp 유지 + mean-bound loss | loss 활성, raw max 13.852 확인 | mean saturation과 상체 형태가 거의 유지 |
| v418 | 21관절 std max 0.35 | std 평균 0.5209→0.3305 | route는 유지했지만 raw mean·morphology 미개선 |
v402의 결론은 std가 무관하다는 것이 아닙니다. stochastic rollout의 안전과 탐색 범위에는 분명히 영향을 줍니다. 다만 이 실패의 1차 병목은 std가 아니라 deterministic actor mean과 action authority surface에 있었습니다. 그래서 다음 실험은 noise를 더 줄이는 대신 actor output head와 mean을 직접 진단하는 방향으로 바뀌었습니다.
v418은 std 개선과 정책 mean 개선을 다시 분리했습니다
v418은 이후 route reference와 groupwise raw-bound loss가 들어간 조건에서 다시 std를 제한했습니다. 선택된 21개 관절의 std 평균은 0.5209에서 0.3305로 내려갔고 최댓값은 정확히 0.35에 묶였습니다. nominal 15초에서 fall과 crossing은 0이었고 route도 앞선 squash 진단보다 보존됐습니다.
그러나 nominal raw action max는 10.752, raw arm은 5.526이었고 arm applied action은 3.407이었습니다. slow·nominal scenario 모두 최종 pass는 false였습니다. 탐색 폭을 줄였다는 positive evidence와 mean·morphology가 개선되지 않았다는 negative evidence를 동시에 남겼고, v418을 walking success나 router promotion으로 승인하지 않았습니다.
이 결과 뒤에 v419는 PPO를 돌리지 않고 actor output-head row를 직접 줄이는 진단을 수행했습니다. raw max는 약 10.676에서 9.898로 낮아졌지만 heading-bad row가 98에서 179로 늘어 gate 160을 넘었습니다. mean을 움직이는 방법은 실제 action을 바꿨지만 route를 손상시켰습니다. 따라서 “std만 줄이면 된다”와 “mean만 작게 만들면 된다”는 두 단순한 해법이 모두 기각됐습니다.
Mean std 하나는 29개 관절의 탐색 상태를 숨깁니다
RSL-RL logger의 Policy/mean_std는 관절별 std를 평균한 값입니다. 다리의 σ가 줄고 wrist의 σ가 커져도 평균이 비슷할 수 있습니다. 더구나 raw action이 clip 바깥에 있다면 std 변화가 applied action 분포에 미치는 영향도 관절마다 다릅니다.
예를 들어 mean이 0인 관절에서 σ를 1.0에서 0.5로 줄이면 대부분의 sample이 더 좁은 raw 범위에 모입니다. 반면 mean이 8인 관절은 σ가 1.0이든 0.5든 대다수 sample이 clip 4에 걸릴 수 있습니다. 후자의 applied action은 거의 변하지 않으면서 entropy와 raw log probability만 바뀝니다.
| 관측할 조합 | 가능한 해석 | 추가로 필요한 증거 |
|---|---|---|
| std↓, raw mean 유지, clip↓ | 탐색 tail이 포화의 주원인이었을 가능성 | sampled-minus-mean과 clip fraction |
| std↓, raw mean 유지, clip 유지 | deterministic mean이 이미 clip 밖 | deterministic raw action과 applied action |
| std 유지, raw mean↓, route 악화 | mean authority가 route 제어에도 필요 | joint group별 route sensitivity |
| mean std 유지, 행동 변화 | 관절별 σ 재분배 또는 mean·observation 변화 | 29D std vector, observation·actor hash |
따라서 mean std 곡선은 탐색이 완전히 붕괴했는지 보는 첫 신호로는 쓸 수 있지만, 어느 관절이 어떤 물리량을 탐색하는지는 말하지 못합니다. entropy 역시 29차원 합이므로 같은 한계가 있습니다. 현재 G1에서 필요한 것은 scalar를 더 자주 찍는 일이 아니라 관절 이름을 보존한 vector 진단입니다.
Stochastic 평가와 deterministic 평가는 서로 다른 실패를 찾습니다
deterministic 평가는 checkpoint mean의 구조적 결함을 드러내는 데 적합합니다. 같은 scenario에서 raw mean saturation, 발 교차, route drift, morphology를 비교할 때 sample noise를 제거할 수 있습니다. v418의 std clamp가 mean 문제를 해결하지 못했다는 판단도 deterministic trace가 있었기 때문에 가능했습니다.
반대로 stochastic rollout은 학습 중 실제로 방문하는 action tail의 안전성을 봅니다. mean은 안전해도 std가 큰 wrist sample이 self-contact나 termination을 만들 수 있고, 반대로 deterministic mean이 조금 불안해도 sample 일부가 회복 행동을 찾을 수 있습니다. 그래서 한 모드의 통과로 다른 모드를 대체할 수 없습니다.
- deterministic gate: mean action의 route·morphology·saturation·장기 안정성을 비교합니다.
- stochastic safety gate: 현재 σ에서 tail action이 termination·접촉·관절 한계를 얼마나 만드는지 봅니다.
- paired attribution: 같은 초기 observation tape에서 mean action과 sampled action의 차이가 어느 joint·시점에서 물리 결과를 갈라놓는지 추적합니다.
stochastic 평가의 결과를 reproducibility 평가와도 구분해야 합니다. seed를 고정하면 같은 난수 stream을 요청할 수 있지만, runtime과 call order가 달라지면 동일 sample을 보장하지 않습니다. 이 글의 deterministic은 Gaussian draw를 제거한 policy mode를 뜻합니다.
현재 G1에 필요한 다음 기록은 sample과 mean의 차이를 보존하는 것입니다
현재 학습 보고서에는 특정 진단에서 관절별 std와 raw·applied action이 남아 있지만 모든 PPO run이 공유하는 schema는 아닙니다. 기본 TensorBoard의 mean std와 entropy만으로는 v401 같은 실패를 조기에 분리하기 어렵습니다.
다음 instrumentation에서는 같은 observation에 대해 distribution mean과 실제 sampled action을 함께 저장해야 합니다. simulator에 넘기기 직전의 composed·clipped action, 최종 target offset도 같은 row에 붙입니다.
per step / per joint:
  mean_action
  std
  sampled_action
  sampled_minus_mean
  composed_action
  clipped_action
  target_offset_rad
  clip_mask

per scenario:
  deterministic gate
  stochastic tail gate
  terminal cause and first-divergence step
이 기록이 있으면 탐색을 줄인 뒤 행동이 좋아지지 않았을 때 원인을 세 갈래로 나눌 수 있습니다. std intervention이 parameter에 적용되지 않았는지, 적용됐지만 mean이 clip 밖에 남았는지, applied action은 달라졌지만 route control에 필요한 authority까지 잃었는지 구분할 수 있습니다.
정리: 탐색은 정책의 중심이 아니라 중심 주변의 경험을 바꿉니다
현재 G1 PPO에서 actor MLP는 관측에 따른 29차원 mean을 만들고, 학습 가능한 관절별 std가 그 주변의 Gaussian sample 폭을 정합니다. 학습 rollout은 sample을 실행해 새로운 transition을 만들지만 deterministic 평가는 같은 actor의 mean만 실행합니다. entropy coefficient는 이 분포가 너무 빨리 좁아지지 않도록 loss에 압력을 줄 뿐, mean을 올바른 자세로 직접 옮기는 벌점이 아닙니다.
v401·v402·v418은 이 구분을 실제 실패로 확인했습니다. std clamp는 작동했고 일부 route는 보존됐지만 포화된 deterministic mean과 morphology는 해결되지 않았습니다. 이후 mean을 직접 줄인 v419는 raw command를 낮추면서 heading gate를 손상시켰습니다. 탐색 폭과 중심 action, action interface, route authority를 한 숫자로 고칠 수 없다는 결론이 남았습니다.
다음 검증: 고정된 초기 observation tape에서 deterministic mean과 seeded Gaussian sample을 paired 실행하고, 29개 관절별 std·sample-mean·raw/composed/clipped action·target offset을 첫 divergence 시점까지 기록합니다. 이 검사를 공통 schema로 만든 뒤에야 entropy나 std 변경을 “탐색 개선”으로 평가할 수 있습니다.
참고 자료