v99의 G1 정책은 아직 걷지 못했지만, nominal 명령에서 처음으로 아주 작은 single-support 신호를 만들었습니다. 두 발 중 하나가 떠 있던 비율은 0.0016이었습니다. 다음 v100에서는 학습 명령을 실제 평가 속도에 맞추려 했습니다. 0.45~0.55m/s의 slow 구간과 0.90~1.00m/s의 nominal 구간을 섞었습니다. 합리적인 변경처럼 보였습니다.
결과는 반대였습니다. nominal 평가의 첫 checkpoint는 1.688초 만에 모두 넘어졌고 single-support는 다시 0이 됐습니다. 마지막 checkpoint에서는 slow와 nominal 모두 낙상률 100%였습니다. 그래서 v101은 nominal을 빼고 slow 구간만 학습했습니다. 중간 checkpoint의 slow 낙상률은 31%까지 내려갔지만 -0.222m 후진했고, 발은 거의 떨어지지 않았습니다. 학습 문제가 쉬워진 것이 아니라 두 발을 붙인 채 버티는 다른 해법이 쉬워진 것이었습니다.
이 실험은 reset 때 어떤 명령을 뽑느냐가 단순한 데이터 옵션이 아니라는 사실을 보여 줬습니다. 새 에피소드가 어느 자세와 속도에서 시작하고, 어떤 태스크를 받으며, 어떤 물리 조건을 겪는지가 곧 정책이 배우는 상태 분포입니다. 이 글에서는 G1의 두 학습 경로를 비교해 reset distribution, domain randomization, curriculum이 무엇을 다르게 바꾸는지 정리합니다.
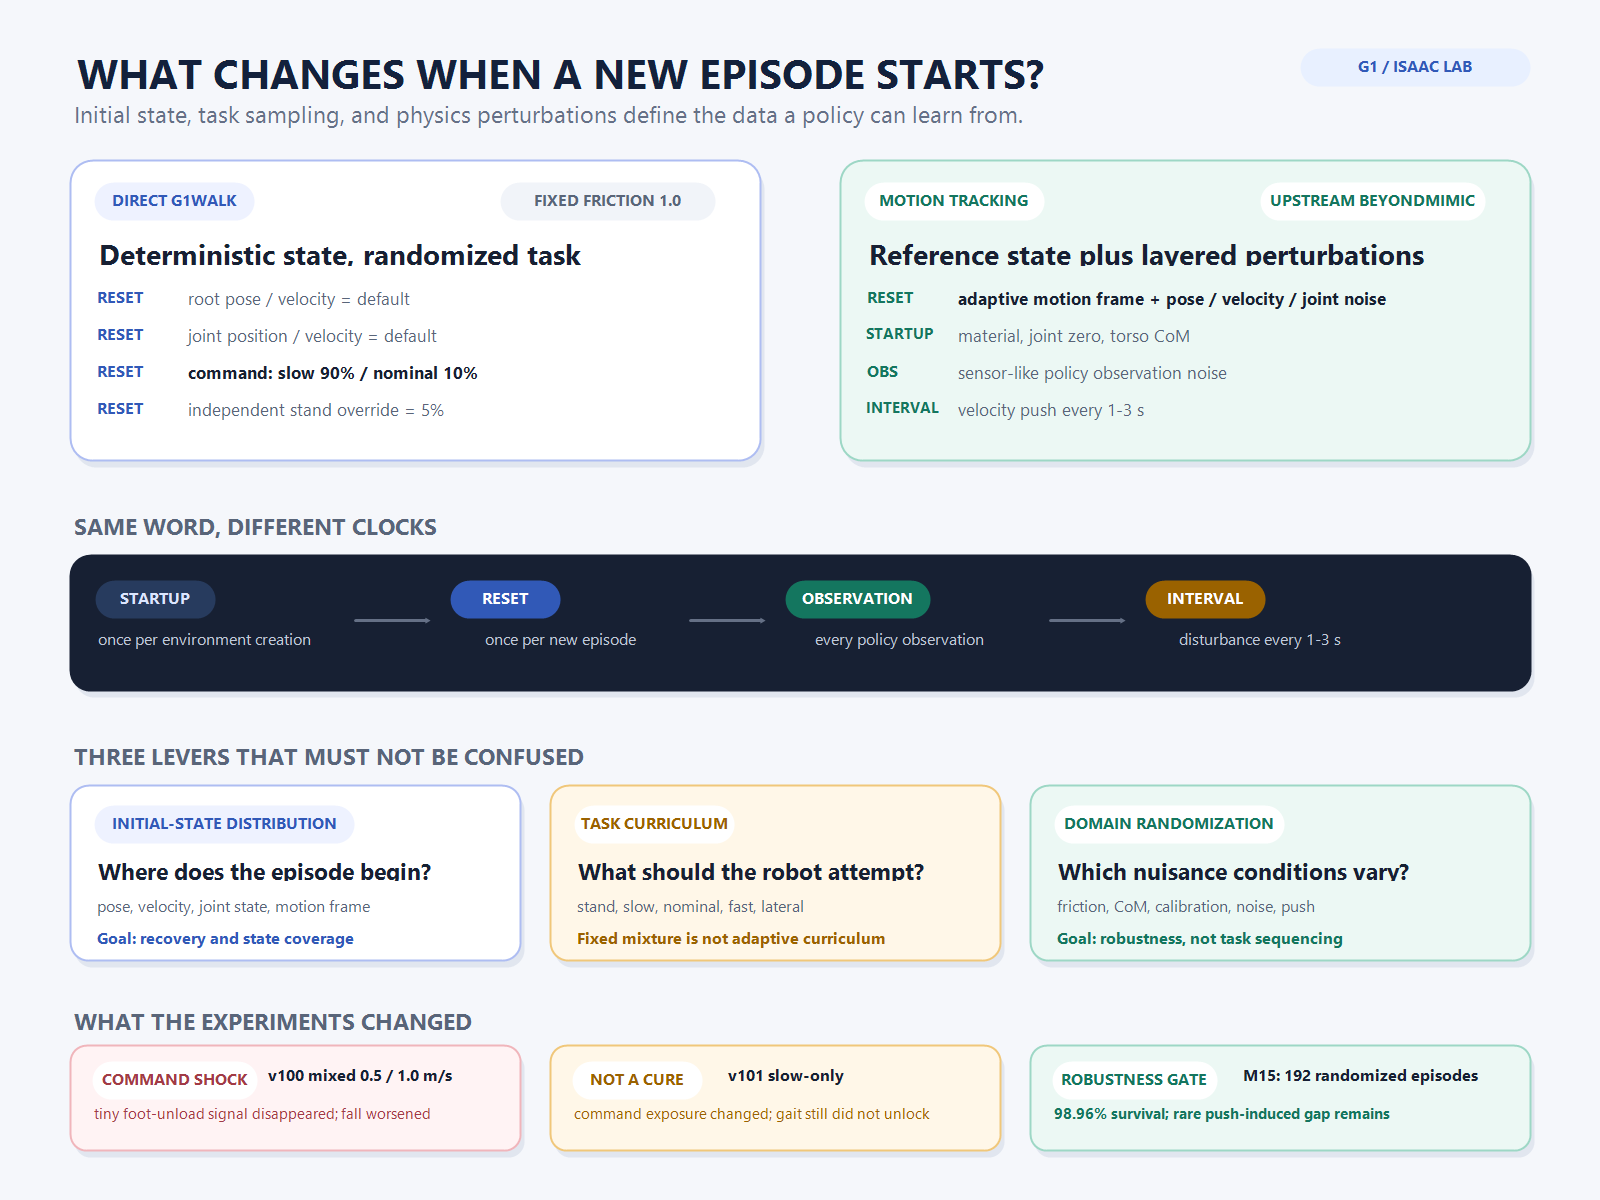
reset distribution은 새 에피소드의 첫 데이터 행을 정합니다
termination·timeout·reset 글에서는 에피소드가 언제 끝나고 어떤 환경만 다시 시작하는지 설명했습니다. 이번 질문은 그 다음입니다. reset된 환경의 첫 observation은 어디에서 오는가.
초기 상태 분포는 로봇의 root pose와 velocity, 관절 위치와 속도, 접촉 상태, 태스크 명령을 함께 정의합니다. 매번 완전히 같은 정지 자세에서 시작하면 초기 학습은 쉬워집니다. 대신 정책은 약간 기울었거나 이미 움직이는 상태에서 회복하는 방법을 볼 기회가 없습니다. 반대로 처음부터 자세·속도·관절을 크게 흔들면 대부분의 rollout이 회복 불가능한 실패 구간으로 시작해 유용한 보상 차이를 만들지 못할 수 있습니다.
그래서 초기 상태 범위는 “다양할수록 좋다”가 아닙니다. 정책이 현재 해결할 수 있는 상태와 다음에 해결해야 할 상태 사이의 경계를 정하는 값입니다. Bengio 등의 curriculum learning이 쉬운 사례에서 더 어려운 사례로 학습 분포를 조직한 이유도 이 최적화 경로와 관련됩니다. 다만 현재 G1 구현에서 curriculum이라는 이름이 붙은 모든 기능이 실제로 난이도를 자동 조절하는 것은 아닙니다.
Direct G1Walk는 상태를 고정하고 명령만 다시 뽑습니다
G1WalkEnv._reset_idx()는 종료된 환경의 root pose·velocity와 joint position·velocity를 asset의 기본값으로 되돌립니다. 위치에는 각 병렬 환경의 origin만 더합니다. 초기 roll·pitch, root velocity, joint offset을 확률적으로 흔드는 코드는 이 경로에 없습니다. 평면 material도 static·dynamic friction 1.0으로 고정되어 있고 별도의 EventCfg가 없습니다.
joint_pos = default_joint_pos[env_ids]
joint_vel = default_joint_vel[env_ids]
root_state = default_root_state[env_ids] + env_origin

write_root_pose(root_state)
write_root_velocity(root_state)
write_joint_state(joint_pos, joint_vel)
랜덤하게 바뀌는 것은 주로 command입니다. 현재 velocity_curriculum="eval_gate_slow_nominal"은 reset된 환경마다 slow와 nominal 중 하나를 뽑습니다. slow 확률은 90%이고 속도는 0.45~0.55m/s, nominal 확률은 10%이고 속도는 0.90~1.00m/s입니다. 그 뒤 5% 확률의 stand mask가 독립적으로 적용돼 선택된 명령을 (0,0,0)으로 덮어씁니다.
따라서 기대 비율은 단순한 90:10:5가 아닙니다. stand가 마지막에 5%를 덮어쓰므로 대략 slow 85.5%, nominal 9.5%, stand 5%가 됩니다. 실제 4,096개 환경에서의 개수는 난수에 따라 조금씩 달라집니다. 이 histogram을 저장하지 않으면 config에 적힌 확률과 정책이 실제로 본 batch 구성을 같은 것으로 착각할 수 있습니다.
이름은 curriculum이지만 현재 Direct sampler는 고정 혼합입니다
curriculum은 보통 학습 진행이나 성능에 따라 문제 난이도를 바꾸는 절차를 뜻합니다. 하지만 현재 Direct G1Walk의 velocity_curriculum 분기는 iteration, 성공률, 낙상률을 읽지 않습니다. reset 때 미리 정한 확률과 범위에서 command를 뽑습니다. 더 정확한 이름은 command distribution profile 또는 task mixture에 가깝습니다.
고정 혼합 자체가 잘못된 것은 아닙니다. 하나의 PPO batch 안에서 slow와 nominal을 함께 보여 주고, 평가 구간과 학습 구간의 불일치를 줄일 수 있습니다. 문제는 “curriculum을 켰으니 쉬운 속도를 통과한 뒤 어려운 속도로 확장될 것”이라고 기대할 때 생깁니다. 현재 구현에는 승격 gate도, 확률 schedule도, 실패 시 rollback도 없습니다. 사람이 config를 바꾸고 새 run을 시작해야 분포가 변합니다.
stand 명령 25%는 reward의 숨은 크기 문제를 드러냈습니다
초기 G1 학습은 전진 명령 0.3~0.6m/s만 보았고, 평가에는 stand-still이 포함돼 있었습니다. 이 out-of-distribution 문제를 줄이기 위해 reset 시 stand 명령을 25% 넣었습니다. 그러나 training reward는 약 -3,000~-16,000까지 떨어졌고 value loss는 수백만 단위에 머물렀으며 action standard deviation은 1.5 부근까지 커졌습니다. slow displacement도 기존 +0.133m에서 +0.114m로 나빠졌습니다.
stand 비율을 5%로 낮춰도 바로 해결되지 않았습니다. zero command에서 rew_stand_still=-0.5×sum(qvel²)가 지나치게 커졌기 때문입니다. 그래서 stand-still cost를 5.0으로 clip하고 entropy를 낮췄습니다. 그제야 후기 reward가 약 +15~+30으로 돌아왔고 value loss도 약 40 수준으로 안정됐습니다.
그렇다고 stand 학습이 성공한 것은 아니었습니다. stand와 slow 평가의 낙상률은 여전히 100%였습니다. 이 시도에서 얻은 것은 “stand 5%가 정답”이 아니라, 학습 분포를 바꾸면 기존 reward가 전혀 다른 수치 범위에서 작동할 수 있다는 사실이었습니다. 태스크 비율과 reward scale을 독립적으로 조정할 수 없다는 뜻입니다.
v99→v101은 command 분포만으로 gait를 만들 수 없음을 보여 줬습니다
| 조건 | 평가 | 낙상 | episode | single support | 판단 |
|---|---|---|---|---|---|
| v99 기존 분포 | nominal | 100% | 3.606s | 0.0016 | 아주 작은 foot-unload 신호 |
| v100 slow+nominal | nominal | 100% | 1.688s | 0.0000 | 명령 난이도 급증 뒤 신호 소실 |
| v101 slow-only | slow | 31% | 13.054s | 0.0001 | 생존은 늘었지만 -0.222m 후진 |
| v101 slow-only | nominal | 100% | 3.111s | 0.0069 | 희소하고 불안정한 접촉 전환 |
v100은 reward와 action scale을 유지한 채 command distribution만 바꾼 비교였습니다. nominal 약 1.0m/s를 곧바로 섞자 v99의 약한 발 들기 신호가 사라졌습니다. 그래서 v101은 slow 0.45~0.55m/s만 뽑도록 되돌렸습니다. 중간 checkpoint에서 slow survival은 좋아졌지만 전진하지 않았고 두 발 접촉 비율은 0.9999였습니다. 마지막 checkpoint는 slow 낙상률이 다시 81%로 악화됐습니다.
이 결과 뒤 command-curriculum-only 반복을 중단했습니다. 실패 원인은 command exposure 부족만으로 설명되지 않았습니다. policy output은 크게 포화됐지만 지지발을 유지한 전방 착지로 이어지지 않았고, 높이 붕괴 또는 double-support 생존으로 갈라졌습니다. 다음 v102에서는 command가 아니라 swing-action prior를 stance contact와 forward placement 조건에 묶었습니다. reward hacking 글에서 보았던 것처럼, 쉬운 분포를 제공하는 일과 원하는 행동을 정의하는 일은 서로 대체할 수 없습니다.
motion tracking은 reset 상태 자체를 흔듭니다
현재 별도의 G1 motion-tracking 학습은 BeyondMimic의 Tracking-Flat-G1-v0 태스크를 사용합니다. Direct G1Walk와 달리 하나의 고정 정지 자세가 아니라 motion clip의 특정 frame을 초기 상태로 선택합니다. 선택된 reference의 root·joint state에 작은 perturbation을 더해 시뮬레이터에 씁니다.
| reset 요소 | upstream 기본 범위 | 정책이 배우는 차이 |
|---|---|---|
| root position | x·y ±0.05m, z ±0.01m | 참조 위치에서 조금 벗어난 상태 |
| root orientation | roll·pitch ±0.1rad, yaw ±0.2rad | 기울기와 heading 오차 회복 |
| root linear velocity | x·y ±0.5m/s, z ±0.2m/s | 이미 움직이는 상태에서 추적 |
| root angular velocity | roll·pitch ±0.52rad/s, yaw ±0.78rad/s | 회전 과도 상태에서 안정화 |
| joint position | reference에 ±0.1rad | 관절 추적 오차 복원 |
이 값들은 현재 workspace가 새로 만든 범위가 아니라 upstream tracking task의 기본 계약입니다. 로컬 train_g1_motion_tracking.py는 motion file과 환경 수, seed를 설정하고 이 태스크를 실행합니다. 특정 paired diagnostic을 제외하면 observation corruption과 startup event, interval push를 유지합니다. 구현이 존재한다는 주장과 어느 checkpoint가 이 분포에서 통과했다는 주장은 뒤에서 따로 구분합니다.
startup·reset·observation·interval은 같은 randomization이 아닙니다
Isaac Lab의 domain randomization 문서는 event를 startup, reset, interval 모드로 나눕니다. 적용 시점이 다르면 데이터에서 갖는 의미도 다릅니다.
| 시점 | motion-tracking 기본 설정 | 의미 |
|---|---|---|
| startup | 마찰·반발계수, joint default position, torso CoM | 병렬 환경마다 하나의 물리 개체 편차를 부여 |
| reset | motion frame, root pose·velocity, joint position | 에피소드마다 다른 초기 추적 오차를 부여 |
| observation | anchor·base velocity·joint state noise | 매 policy observation에 센서형 오차를 부여 |
| interval | 1~3초마다 velocity push | episode 중 회복해야 할 외란을 부여 |
startup material은 static friction 0.3~1.6, dynamic friction 0.3~1.2, restitution 0~0.5에서 뽑습니다. joint default position은 ±0.01rad, torso CoM은 x ±0.025m와 y·z ±0.05m 범위에서 이동합니다. 중요한 점은 이 값들이 episode reset마다 새로 바뀌지 않는다는 것입니다. startup은 환경 생성 시 적용되므로 한 병렬 환경은 여러 episode 동안 같은 물리 개체 편차를 가질 수 있습니다.
이 시간 구분을 무시하면 재현성도 흐려집니다. 같은 seed와 checkpoint를 썼더라도 환경을 다시 생성했는지, 같은 환경에서 episode만 reset했는지에 따라 물리 샘플이 달라질 수 있습니다. physics step·decimation·vector rollout 글의 시간축에 event cadence를 함께 기록해야 하는 이유입니다.
motion-frame adaptive sampling은 실제 성능 기반 curriculum에 가깝습니다
BeyondMimic의 MotionCommand는 motion clip을 여러 bin으로 나누고, 어느 bin에서 termination이 발생했는지 누적합니다. 실패 횟수의 이동 평균에 uniform floor를 더해 sampling probability를 만들고, reset 때 multinomial로 다음 시작 bin을 선택합니다. 잘 실패하는 동작 구간을 더 자주 보여 주되 모든 구간의 확률을 0으로 만들지 않는 구조입니다.
failure_count[bin] <- moving_average(current_failures)
sampling_prob <- failure_count + uniform_floor
start_bin <- multinomial(sampling_prob)
start_frame <- uniform_position_inside(start_bin)
이 방식은 Direct G1Walk의 고정 90:10 command mixture와 책임이 다릅니다. 하나는 "어떤 속도 태스크를 줄 것인가"를 정하고, 다른 하나는 "한 motion 안에서 어느 구간부터 추적시킬 것인가"를 최근 실패에 따라 바꿉니다. 둘 다 training distribution을 조절하지만 adaptive signal과 샘플 단위가 다릅니다.
평가는 clean·component·combined randomization으로 나눴습니다
motion-tracking evaluator는 기본적으로 pose·velocity·joint perturbation을 0으로 만들고 observation corruption과 startup event, push를 끕니다. 이는 deterministic baseline을 재현하기 위한 선택입니다. --randomized_eval을 켜면 observation, startup, push를 개별 또는 함께 유지할 수 있습니다. 이 분리가 없으면 실패가 센서 noise 때문인지, 물리 편차 때문인지, 외란 회복 때문인지 알 수 없습니다.
M15 model 1789는 64환경 10초 deterministic gate에서 survival 100%, route progress 95.80%, crossing 0%를 기록했습니다. 연속 30초에서도 survival 100%, route 96.13%, crossing 0%였습니다. observation-only와 startup-only randomization도 10초 동안 crossing 0%를 통과했습니다.
남은 차이는 push였습니다. push-only에서는 낙상은 없었지만 crossing 0.0219%가 발생했습니다. seed 42의 combined randomization에서는 survival 98.44%, crossing 0.0594%, termination 2건으로 악화됐습니다. 세 seed, 총 192 episode를 모으자 평균 survival 98.96%, route 100.59%, crossing 0.0698%였습니다. 선언한 robust-simulation threshold는 통과했지만, rare push failure와 disturbance에서 raw action max 9.73이 남았습니다.
따라서 M15는 robust simulation candidate로 accepted됐지만 실제 로봇에 deployed된 정책은 아닙니다. router 연결도 계속 막아 두었습니다. Sim-to-real 검증 글이 소유하는 물리 측정과 hardware gate를 통과하지 않았기 때문입니다. Domain randomization 결과는 실물 전이의 증거가 아니라, 시뮬레이션 내부의 강건성 범위를 분해한 증거입니다.
초기 상태를 넓힐수록 좋아진다는 규칙은 없습니다
초기 상태와 명령 범위를 너무 좁히면 정책은 평가 조건을 보지 못합니다. 너무 빨리 넓히면 현재 정책이 만들던 희소한 성공 신호까지 사라집니다. v100은 후자의 사례였고, stand 25% 실험은 분포 변화가 reward 수치 범위를 무너뜨린 사례였습니다. 반대로 M15의 component evaluation은 startup randomization 자체보다 interval push가 남은 병목임을 좁혔습니다.
이 때문에 세 축을 별도로 기록해야 합니다.
| 축 | 현재 질문 | 넓히는 조건 |
|---|---|---|
| initial-state distribution | 현재 상태에서 회복 가능한가 | clean gate를 보존하면서 perturbation별 실패율이 허용 범위인가 |
| task curriculum | 어떤 command를 수행할 수 있는가 | 이전 command 구간에서 생존뿐 아니라 gait gate까지 통과했는가 |
| domain randomization | 어떤 nuisance 변화에 강건한가 | nominal model이 먼저 검증됐고 component failure가 해석 가능한가 |
강화학습 환경의 observation·action·reward·termination 글이 MDP의 구성 요소를 설명했다면, 이번 글의 핵심은 그 MDP에서 어떤 첫 상태와 조건을 얼마나 자주 보여 주느냐입니다. 같은 환경 코드라도 이 분포가 달라지면 PPO가 최적화하는 실제 문제도 달라집니다.
현재 구현 상태와 다음 검증
| 항목 | 상태 | 현재 근거 |
|---|---|---|
| Direct G1Walk 기본 state reset | implemented | root·joint default를 선택된 env에 기록 |
| Direct command mixture | implemented·executed | slow·nominal·stand reset-time sampling과 v99~v101 비교 |
| Direct physics randomization | not implemented | flat material friction 1.0, EventCfg 없음 |
| Motion tracking state perturbation | implemented·executed | upstream task를 유지한 local training path |
| Motion tracking component randomization eval | executed·observed | observation·startup·push·combined 분리 평가 |
| M15 robust simulation gate | accepted | 3 seeds·192 episodes, survival 98.96% |
| 실물 G1 전이 | not deployed | hardware 동일 지표와 제한 명령 검증 미실행 |
다음에는 run마다 distribution manifest를 남길 생각입니다. reset pose·velocity·joint 범위, command의 설정 확률과 실제 sample histogram, event mode와 범위, observation noise, seed를 checkpoint와 함께 저장합니다. Direct G1Walk에서는 4,096개 환경의 realized slow·nominal·stand 비율을 먼저 기록하고 각 bucket의 termination과 gait metric을 따로 집계해야 합니다.
curriculum을 성능 기반으로 바꾸려면 승격 조건도 명시해야 합니다. slow 구간에서 낙상률만 낮아진 것이 아니라 전진 속도·single support·좌우 교대가 함께 통과했을 때만 nominal 확률을 늘리고, 회귀하면 이전 분포로 돌아가야 합니다. motion tracking은 clean, observation-only, startup-only, push-only, combined 순서를 유지하고 최소 세 seed를 반복합니다.
지금까지 가장 방어 가능한 결론은 단순합니다. reset은 로봇을 처음 자세로 되돌리는 함수가 아닙니다. 정책이 어떤 세계를 얼마나 자주 보게 될지 결정하는 sampler입니다. 그 sampler를 바꾼 뒤 행동이 달라졌다면, 먼저 학습이 좋아졌는지가 아니라 학습 문제가 어떻게 달라졌는지를 확인해야 합니다.