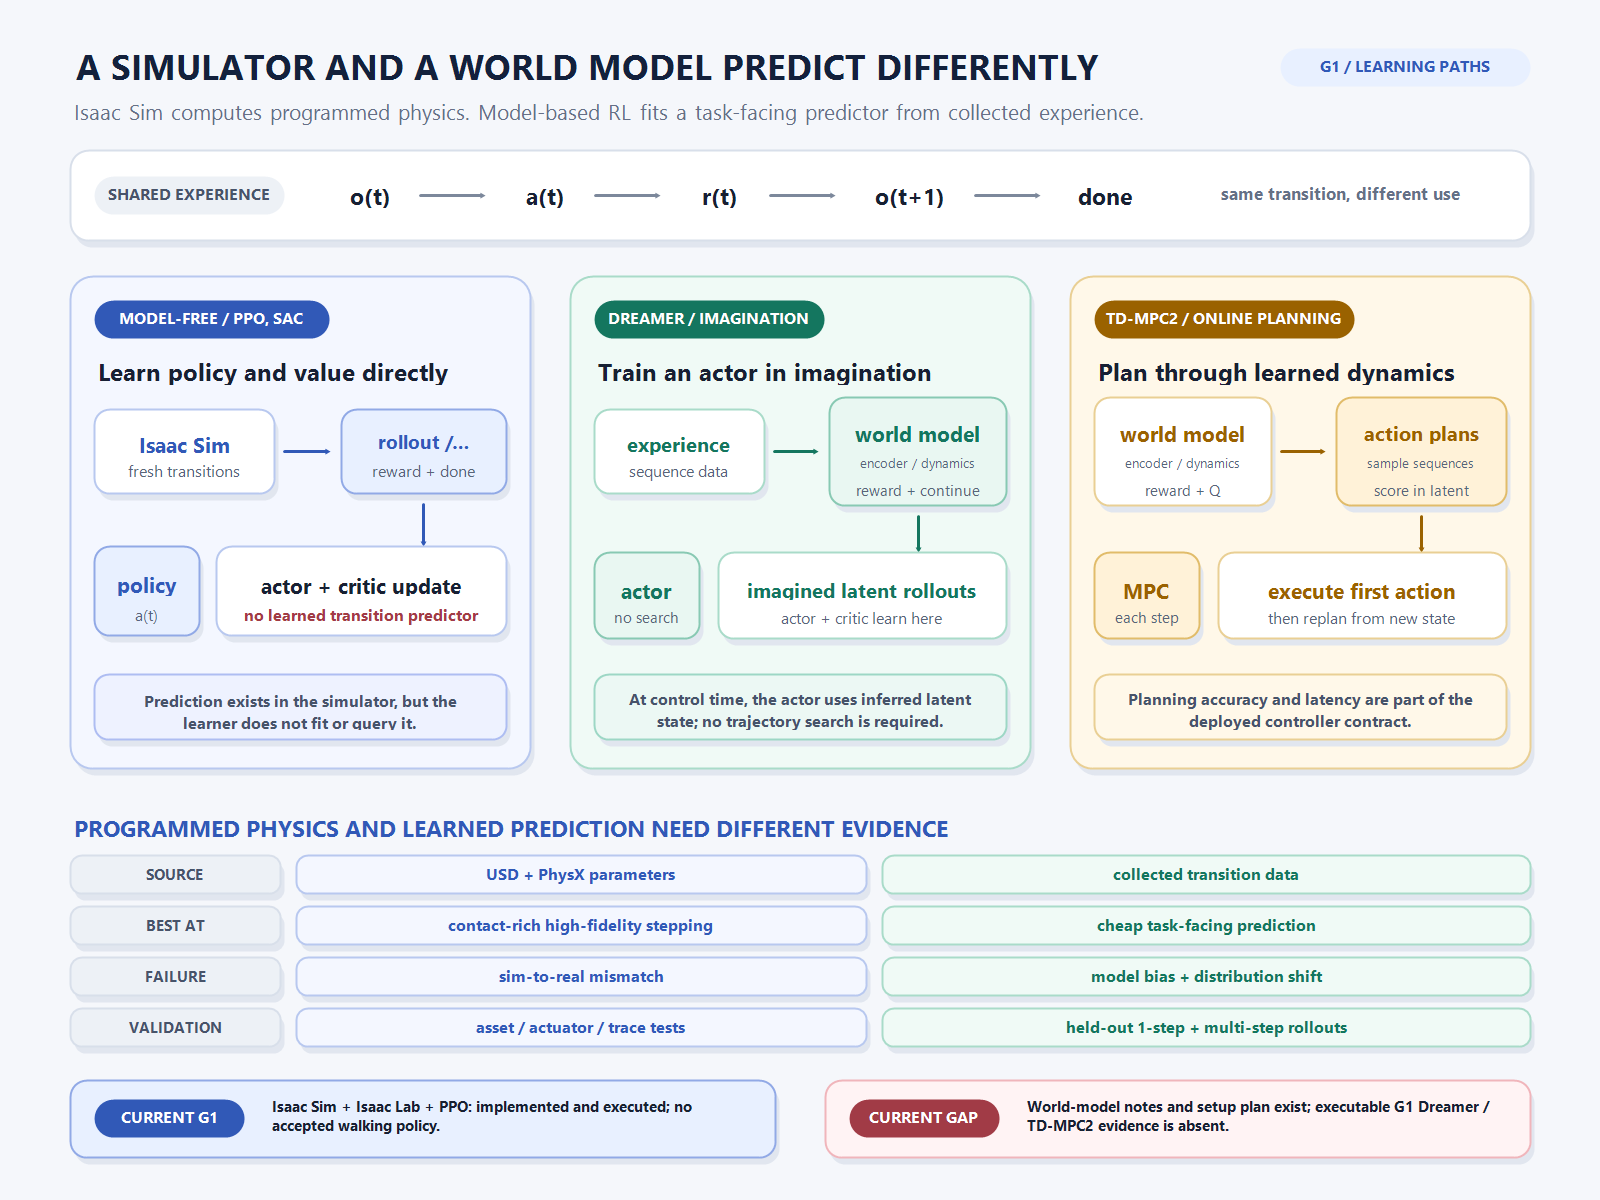
현재 G1 PPO는 Isaac Sim에서 한 iteration마다 4,096개 환경 × 24 step, 총 98,304개의 transition을 만듭니다. 시뮬레이터는 action을 받은 로봇의 관절·접촉·몸체 상태가 다음 20ms 뒤 어떻게 변하는지 계산합니다. 그런데 PPO learner는 그 변화 법칙을 신경망으로 따로 학습하지 않습니다. observation과 action, reward, done을 받아 actor와 critic만 갱신합니다.
같은 workspace에는 World Models 폴더와 DreamerV3·TD-MPC2 노트가 있고, TD-MPC2를 이용한 FLAM 재현 setup도 남아 있습니다. 얼핏 보면 중복입니다. 이미 Isaac Sim이라는 예측 가능한 세계가 있는데, 다음 상태를 예측하는 world model을 또 만드는 이유는 무엇일까요. 반대로 시뮬레이터를 사용하면서 PPO를 model-free라고 부르는 것도 이상하게 들립니다.
여기서 model이라는 말의 소유자를 나누면 혼란이 줄어듭니다. Isaac Sim은 사람이 구성한 USD·PhysX parameter로 물리를 계산하는 외부 환경입니다. model-based RL의 world model은 수집한 transition에서 dynamics와 reward·termination을 근사하도록 학습한 내부 예측기입니다. model-free RL은 세계에 물리가 없다는 뜻이 아니라, learner가 그 예측기를 명시적으로 학습해 policy update나 action planning에 사용하지 않는다는 뜻입니다.
이 글은 Isaac Sim·Isaac Lab·RSL-RL의 도구 경계를 다시 설명하지 않습니다. 동일한 경험이 model-free PPO, Dreamer식 imagination, TD-MPC2식 online planning에서 어떻게 다르게 소비되는지에 집중합니다. 마지막에는 현재 G1에서 실제로 검증된 범위와 world-model baseline을 만들기 전에 필요한 첫 실험을 분리합니다.
model-free는 물리 모델이 없다는 뜻이 아닙니다
현재 G1의 한 제어 step은 actor가 29차원 action을 출력하고, Isaac Lab 환경이 이를 관절 위치 목표로 바꾼 뒤, Isaac Sim이 네 번의 5ms physics step을 계산하는 순서로 진행됩니다. 다음 observation과 reward가 돌아오면 PPO는 rollout storage에 기록합니다. 이 경로에는 분명하게 물리 계산이 있습니다.
observation o_t → actor π(a|o_t) → action a_t
action a_t → Isaac Sim / Isaac Lab → o_(t+1), r_t, done_t
rollout → advantage / value target → actor + critic update
하지만 actor나 critic에게 “이 action을 넣으면 다음 observation이 무엇인가”를 출력하도록 학습시키지는 않습니다. PPO의 critic은 앞으로 받을 return을 압축한 value를 예측할 뿐, 다음 관절 상태와 접촉 상태를 복원하지 않습니다. SAC의 Q 함수도 상태–행동의 기대 return을 예측하지만 transition dynamics 자체를 생성하는 모델은 아닙니다. 이 때문에 PPO와 SAC를 model-free로 분류합니다.
정책 parameter 안에 동역학의 흔적이 전혀 없다는 뜻도 아닙니다. 반복된 interaction을 통해 actor는 어떤 관절 행동이 낙상이나 전진과 연결되는지를 암묵적으로 학습합니다. 다만 그 지식을 독립적인 next-state predictor로 꺼내 여러 action sequence를 비교하거나 synthetic rollout을 생성할 수 없습니다. model-free라는 이름은 지식의 부재가 아니라 학습과 의사결정에서 명시적 transition model을 쓰지 않는 구조를 가리킵니다.
Isaac Sim과 learned world model은 같은 질문을 다른 근거로 풉니다
Isaac Sim은 로봇의 mass·inertia, joint drive, collision shape, friction과 solver 설정을 바탕으로 다음 물리 상태를 계산합니다. 이 값은 USD와 configuration에 사람이 넣습니다. G1이 새로운 trajectory를 경험했다고 해서 PhysX parameter가 자동으로 학습되는 것은 아닙니다.
learned world model은 반대로 데이터에서 출발합니다. 현재 observation o_t와 action a_t가 주어졌을 때 다음 observation 또는 latent state, reward, episode continuation을 예측하도록 parameter를 맞춥니다. 실물 telemetry를 함께 학습하면 simulator가 놓친 actuator delay나 contact signature를 흡수할 가능성도 있지만, training distribution 밖에서는 그 근사가 틀릴 수 있습니다.
| 구분 | Isaac Sim | learned world model |
|---|---|---|
| 근거 | USD, PhysX, actuator·sensor configuration | 수집된 observation–action transition |
| 다음 상태 계산 | programmed physics integration | neural dynamics prediction |
| 오류의 중심 | asset·parameter·solver와 현실의 mismatch | 학습 오차·distribution shift·model exploitation |
| 업데이트 | 사람이 parameter와 자산을 보정 | 새 데이터로 gradient update |
| 검증 | contact·actuator·sensor trace와 실물 대조 | held-out one-step·multi-step prediction과 실제 환경 대조 |
따라서 world model은 Isaac Sim을 반드시 대체하는 물건이 아닙니다. simulator에서 대량의 transition을 모아 먼저 학습하고, 나중에 제한된 실물 데이터로 보정할 수도 있습니다. 또는 learned model은 policy 학습을 위한 빠른 imagination generator로만 쓰고, 최종 평가는 계속 Isaac Sim이나 실제 로봇에서 수행할 수 있습니다. 둘의 관계는 대체보다 역할 분담에 가깝습니다.
world model은 다음 화면 하나보다 제어에 필요한 결과를 예측합니다
가장 직접적인 dynamics model은 s_t와 a_t를 받아 s_(t+1)을 예측합니다. 하지만 카메라 image나 긴 sensor history를 그대로 미래로 생성하면 계산량이 커집니다. 그래서 DreamerV3와 TD-MPC2 같은 방법은 observation을 작은 latent state z_t로 encoding하고, 그 공간에서 dynamics를 학습합니다.
z_t = encoder(o_t)
z_hat_(t+1) = dynamics(z_t, a_t)
r_hat_t = reward_head(z_t, a_t)
c_hat_t = continue_head(z_t, a_t)   # episode가 계속될 확률

검증 질문:
같은 action sequence를 넣었을 때 z, reward, contact/termination 결과가
Isaac Sim rollout과 얼마나 오래 같은 방향을 유지하는가?
여기서 좋은 reconstruction image가 곧 좋은 control model이라는 보장은 없습니다. 발이 바닥에 닿는 순간, 몸체 기울기가 termination threshold를 넘는 순간, action saturation이 발생하는 순간처럼 return을 바꾸는 사건을 맞혀야 합니다. TD-MPC2가 pixel decoder 없이 task-oriented latent dynamics와 reward·Q prediction을 함께 학습하는 이유도 모든 시각 정보를 재현하는 대신 의사결정에 필요한 표현을 만들기 위해서입니다.
반대로 latent prediction error가 작아도 사람이 해석하기 어려울 수 있습니다. 따라서 G1에서는 latent loss 하나만 보지 않고 base velocity·orientation, joint state, foot contact, reward term과 done의 실제 오차를 함께 봐야 합니다. world model의 목적은 그럴듯한 미래 영상을 만드는 것이 아니라, action을 비교할 때 틀린 결정을 만들지 않을 정도로 task consequence를 보존하는 것입니다.
Dreamer는 imagined trajectory에서 actor와 critic을 학습합니다
DreamerV3는 실제 interaction sequence로 recurrent world model을 학습합니다. encoder가 observation을 latent representation으로 바꾸고, dynamics가 action을 조건으로 미래 latent를 예측합니다. reward와 episode continuation도 같은 latent trajectory에서 예측합니다.
world model이 일정한 예측 구조를 만들면 actor와 critic은 실제 환경을 매번 step하지 않고 latent imagination 안에서 여러 미래를 경험합니다. DreamerV3 구현 설명도 경험에서 world model을 배우고, imagined trajectory로 actor–critic policy를 훈련한다고 정리합니다. 실제 환경 transition 하나가 model update뿐 아니라 다수의 imagined behavior update를 만드는 것이 sample efficiency의 원천입니다.
여기서 “Dreamer는 inference 때 world model을 전혀 사용하지 않는다”고 쓰면 지나치게 단순합니다. 매 control step마다 action sequence를 탐색하는 online planner는 없지만, 현재 observation history를 latent state로 추론하는 world-model representation은 actor 입력 경로에 남습니다. 배포 계약은 latent state update + actor forward이고, imagination rollout은 training 단계의 정책 개선에 사용됩니다.
TD-MPC2는 제어할 때마다 latent future를 탐색합니다
TD-MPC2는 learned implicit world model의 latent space에서 local trajectory optimization을 수행하는 model-based RL 방법입니다. 현재 observation을 encoding하고 여러 action sequence의 미래 latent·reward·value를 예측한 뒤, 가장 유리한 sequence의 첫 action만 실행합니다. 다음 observation이 도착하면 다시 planning합니다.
Dreamer와 TD-MPC2는 모두 learned dynamics를 사용하지만 배포 시점의 계산 계약이 다릅니다. Dreamer식 actor는 학습 중 imagination에서 개선된 뒤 control 때 actor가 action을 바로 냅니다. TD-MPC2식 agent는 매 decision마다 world model을 여러 번 호출해 action 후보를 비교합니다. 후자는 현재 상태에 맞춰 계획을 수정할 수 있지만 planning horizon·candidate 수·model 크기가 control latency로 직접 들어옵니다.
| 경로 | world model을 쓰는 시점 | control 시점의 핵심 연산 | 주요 검증 대상 |
|---|---|---|---|
| model-free PPO | 사용하지 않음 | actor forward | policy·critic update와 실제 rollout 행동 |
| DreamerV3 | representation·training imagination | latent state update + actor forward | latent prediction, imagined return, 실제 환경 행동 |
| TD-MPC2 | training + decision-time planning | latent rollout search + 첫 action | model error, planning quality, control latency |
| MBPO | 짧은 synthetic rollout 생성 | 학습된 model-free policy forward | real/model data 비율과 rollout horizon |
현재 G1 policy step은 20ms, 즉 50Hz입니다. TD-MPC2식 planning을 연결한다면 encoder, candidate rollout, scoring, action 전달 전체가 이 deadline 안에서 안정적으로 끝나는지 측정해야 합니다. 지금 workspace에는 그 latency를 측정한 결과가 없습니다. 논문의 continuous-control 결과를 현재 G1 controller의 실시간 성능으로 옮겨 쓰지 않는 이유입니다.
model-based RL의 비용은 model bias입니다
learned model은 실제 interaction 없이 많은 trajectory를 만들 수 있습니다. 그러나 예측한 상태가 실제 environment distribution에서 조금 벗어나면 다음 예측은 그 잘못된 상태를 다시 입력으로 받습니다. 한 step의 작은 오차가 긴 rollout에서 누적되고, policy나 planner가 model의 허점을 높은 return으로 오해할 수 있습니다.
MBPO 논문은 이 문제 때문에 replay buffer의 실제 상태에서 시작하는 짧은 model rollout을 사용합니다. 긴 trajectory 몇 개를 처음부터 상상하기보다, 실제 데이터 근처에서 많은 짧은 branch를 만듭니다. 논문의 ablation에서는 model이 200-step 예측을 할 수 있어도 policy optimization에는 더 짧은 rollout이 유리했습니다. 예측 가능 길이와 학습에 안전한 길이는 같은 숫자가 아닙니다.
model-free RL에는 이 종류의 transition bias가 없습니다. 실제 환경이 반환한 observation과 reward로만 update하기 때문입니다. 대신 새로운 state–action coverage를 얻으려면 environment를 계속 실행해야 합니다. PPO와 SAC의 데이터 수명 주기 글에서 구분한 sample cost 위에, model-based RL은 synthetic data의 수와 model error라는 축을 하나 더 추가합니다.
G1의 접촉과 termination은 one-step RMSE보다 까다로운 시험입니다
휴머노이드 보행에서는 발이 닿기 직전과 직후의 dynamics가 매끄럽게 이어지지 않습니다. contact force가 생기고 지지 조건이 바뀌며, 작은 발 위치 차이가 몸체 회전과 다음 action distribution을 바꿉니다. 현재 G1 환경도 base height·tilt·lateral velocity 조건으로 episode를 종료하고, 발 접촉과 support phase를 별도 trace로 평가합니다.
평균 next-observation RMSE만 최소화하면 대부분을 차지하는 안정적인 double-support 구간은 잘 맞히면서, 드문 touchdown·slip·fall 직전 상태를 놓칠 수 있습니다. 그런데 policy return을 크게 바꾸는 것은 바로 그 드문 사건입니다. 따라서 model validation은 stance, swing, touchdown, near-termination을 나누고 각 구간의 multi-step error와 event classification을 봐야 합니다.
partial observability도 남습니다. actor observation에 contact solver의 모든 내부 상태와 정확한 friction parameter가 들어 있는 것은 아닙니다. 같은 observation과 action에서도 숨은 상태에 따라 다음 결과가 달라질 수 있습니다. history 또는 stochastic latent를 추가할지 결정하려면 먼저 동일한 visible state 주변의 outcome variance를 측정해야 합니다. network capacity를 늘리는 것만으로 관측되지 않은 원인을 복원할 수는 없습니다.
현재 workspace에서 model-free는 실행됐고 world model은 검증되지 않았습니다
origin/main@ee4d96e에는 G1 flat·rough 환경, RSL-RL PPO config, OnPolicyRunner 학습 entrypoint, checkpoint·evaluation·trace 경로가 있습니다. PPO는 여러 조건에서 실제로 실행됐습니다. 다만 현재 acceptance gate를 통과한 G1 보행 policy는 없습니다. model-free 경로가 실행됐다는 사실과 walking policy가 accepted됐다는 상태를 분리해야 합니다.
World Models 폴더에는 Model-Based RL, latent representation, DreamerV3, TD-MPC2 노트가 있습니다. 이것은 지식층이 설계됐다는 증거입니다. sim/experiments/2026-06-16_FLAM-reproduction-setup.md에는 MuJoCo Humanoid-Bench와 TD-MPC2를 조립하는 계획이 있지만, baseline training과 네 모듈 구현 체크박스는 미완료로 남아 있습니다. 이 경로는 Isaac Lab G1이 아니라 Humanoid-Bench H1을 대상으로 한 별도 track이기도 합니다.
한편 Theory.md의 6월 22일 changelog에는 외부 C:\repos\flam 환경과 네 모듈의 구현·self-test가 기록돼 있습니다. 그러나 현재 데스크탑에는 해당 외부 경로와 WBC/flam이 없고, 추적되는 workspace에도 구현 파일·config·checkpoint·평가 결과가 없습니다. 과거 기록을 삭제할 근거도 없지만 현재 실행 가능한 artifact로 확인할 근거도 없습니다. 그래서 이 글의 상태 판정은 historical implementation note exists, current executable evidence unavailable입니다.
결론적으로 현재 G1에서 DreamerV3나 TD-MPC2를 실행하고 PPO와 비교했다는 서사는 만들 수 없습니다. world-model 연구 노트와 setup 계획은 존재하지만, G1용 learned dynamics dataset·trainer·checkpoint·held-out prediction report·policy evaluation은 확인되지 않았습니다. 현재 baseline은 model-free PPO이며, world model은 연구 후보 단계입니다.
첫 world-model 실험은 policy 학습보다 예측 계약부터 닫아야 합니다
world model을 G1에 추가한다면 첫 단계는 PPO를 대체하는 일이 아닙니다. 현재 환경과 action interface를 고정하고, 동일한 시간축의 transition dataset을 만드는 일입니다. 최소한 observation, applied action, reward, next observation, terminated, truncated, policy step index와 생성한 environment·policy revision이 함께 있어야 합니다.
- 데이터 계약을 고정합니다. observation layout, action scale, reward profile, termination, policy dt, seed와 source checkpoint를 manifest에 남깁니다.
- episode 단위로 split합니다. 연속된 인접 frame이 train과 validation에 나뉘어 one-step score가 부풀지 않게 합니다. policy version과 seed도 held-out 축으로 둡니다.
- one-step과 open-loop multi-step을 분리합니다. ground-truth action sequence를 고정하고 1·5·10·25 step 예측이 어디서 갈라지는지 봅니다.
- event별로 측정합니다. stance·swing·touchdown·slip·near-termination에서 velocity, orientation, joint state, reward와 done 오차를 따로 기록합니다.
- Isaac rollout에서 최종 판정합니다. model 안에서 높은 return을 얻은 action을 실제 simulator에 넣었을 때 같은 결과가 나오는지 확인하기 전에는 policy improvement로 부르지 않습니다.
이 단계에서 필요한 시각 자료도 imagined video보다 error curve입니다. horizon에 따른 state error, reward error, contact/termination precision과 uncertainty가 먼저입니다. model이 25 step을 버티지 못하면 rollout horizon을 줄이거나 observation history와 stochastic state가 필요한지 검토합니다. 이 진단이 통과한 뒤에야 Dreamer식 behavior learning, MBPO식 short branch, TD-MPC2식 online planning 중 어느 경로가 현재 계산 예산과 맞는지 비교할 수 있습니다.
공정한 비교는 environment step·계산량·최종 환경을 함께 기록합니다
model-based와 model-free를 비교할 때 environment step만 같게 맞추면 sample efficiency는 볼 수 있지만 전체 비용은 놓칩니다. world model update, imagination rollout, planning search가 사용하는 GPU 시간과 memory를 함께 기록해야 합니다. 반대로 wall-clock만 맞추면 model-based agent가 적은 environment step으로 배운 장점을 숨길 수 있습니다.
| 비교 축 | model-free PPO | model-based baseline |
|---|---|---|
| 실제 환경 데이터 | Isaac transition 수 | Isaac transition 수 + model-generated transition 수 분리 |
| 학습 계산 | actor·critic optimizer step | world model + actor·critic/Q optimizer step |
| 제어 계산 | actor inference latency | latent inference와 planning 또는 actor latency |
| 중간 검증 | KL·value·entropy와 rollout 행동 | one/multi-step error·uncertainty·model exploitation |
| 최종 판정 | 동일한 Isaac slow·nominal scenario와 morphology·contact·raw-action·multi-seed gate | |
최종 score는 learned model 안에서 측정하지 않습니다. model이 틀린 방향으로 낙관적인 trajectory를 만들 수 있기 때문입니다. 같은 Isaac Sim 환경과 고정 scenario에서 baseline과 candidate를 비교해야 합니다. 실제 로봇 단계가 열리면 같은 telemetry schema와 낮은 위험 조건에서 다시 대조합니다.
Isaac Sim이 있는데도 world model을 배우는 이유
world model의 가치는 physics simulator가 존재하지 않아서가 아닙니다. 실제 또는 고충실도 environment interaction이 비쌀 때, 수집한 경험에서 task-relevant predictor를 만들고 그 안에서 더 많은 policy update나 planning candidate를 평가할 수 있기 때문입니다. simulator와 실물 데이터를 함께 학습해 반복되는 dynamics 구조를 압축하는 경로도 있습니다.
대신 learned prediction은 새로운 failure surface를 만듭니다. model bias, long-horizon drift, hidden contact state, planning latency와 artifact provenance를 관리해야 합니다. 현재 G1은 4,096개 Isaac environment가 fresh experience를 빠르게 공급하고, reward·observation·action 계약도 계속 수정되고 있습니다. 이 조건에서는 world model을 붙였다는 사실보다 어떤 고정된 계약을 정확히 예측하는지가 먼저입니다.
다음 검증 가능한 단계는 작은 G1 latent world model로 걷기 policy를 학습하는 것이 아닙니다. PPO update를 전혀 하지 않은 상태에서 고정 dataset의 one-step·multi-step·contact/termination prediction report를 만드는 것입니다. 그 결과가 Isaac ground truth를 충분히 보존해야 imagination이나 online planning을 열 근거가 생깁니다. 지금의 방어 가능한 결론은 model-based RL이 유망하다는 일반론보다, 현재 workspace에는 그 첫 prediction gate의 증거가 아직 없다는 것입니다.
함께 읽기: Isaac Sim과 Isaac Lab의 역할 · PPO의 model-free update · PPO와 SAC의 경험 수명 주기 · G1의 20ms policy clock과 vector rollout · episode 데이터의 시간축 계약 · G1 checkpoint 평가 계약
원문과 공식 구현: World Models · DreamerV3 · DreamerV3 implementation · TD-MPC2 · TD-MPC2 implementation · Model-Based Policy Optimization
기술 기준 시점: 2026-07-22. G1 구현 상태는 origin/main@ee4d96e, 현재 C:\workspace\WBC와 외부 C:\repos\flam의 존재 여부를 대조해 작성했습니다. Theory changelog의 과거 FLAM 구현 기록은 보존하되, 현재 실행 artifact가 없어 재검증된 구현으로 취급하지 않았습니다. 논문 결과는 workspace의 G1 실험 결과가 아닙니다.