data/raw/를 열어 보면 11.8MB짜리 dryrun_test.hdf5가 하나 있습니다. 확장자와 크기만 보면 이미 로봇 시연 데이터를 수집한 것처럼 보입니다. 저장 코드는 카메라 영상 두 개, 14차원 로봇 상태, 7차원 action, reward와 done을 한 episode 아래에 묶을 수 있습니다. 기본 dry-run은 이런 구조로 50 step짜리 episode 다섯 개를 만듭니다.
그런데 이 파일을 ‘로봇 학습 데이터’라고 부르기에는 결정적인 문제가 있습니다. 현재 dry-run의 영상은 임의의 픽셀이고, 상태와 action도 난수입니다. Isaac Sim도, SpaceMouse도, 실제 로봇도 이 파일을 만드는 과정에 참여하지 않았습니다. 즉 이 파일이 증명한 것은 HDF5 저장 경로가 동작한다는 것이지, 정책이 배울 만한 시연을 확보했다는 것이 아닙니다.
이 구분을 놓치면 데이터셋을 만든 뒤에 더 곤란한 문제가 생깁니다. 배열의 길이는 모두 50으로 맞는데 영상과 action의 시점이 어긋날 수 있고, 7개의 숫자가 어느 좌표계의 어떤 단위인지 알 수 없으며, train과 validation에 사실상 같은 장면이 섞일 수도 있습니다. 그래서 이번 글에서는 파일 포맷보다 먼저 한 가지 질문을 정리하려 합니다. 한 장면과 한 action이 ‘같은 step’이라는 사실을 무엇으로 보장할 것인가?
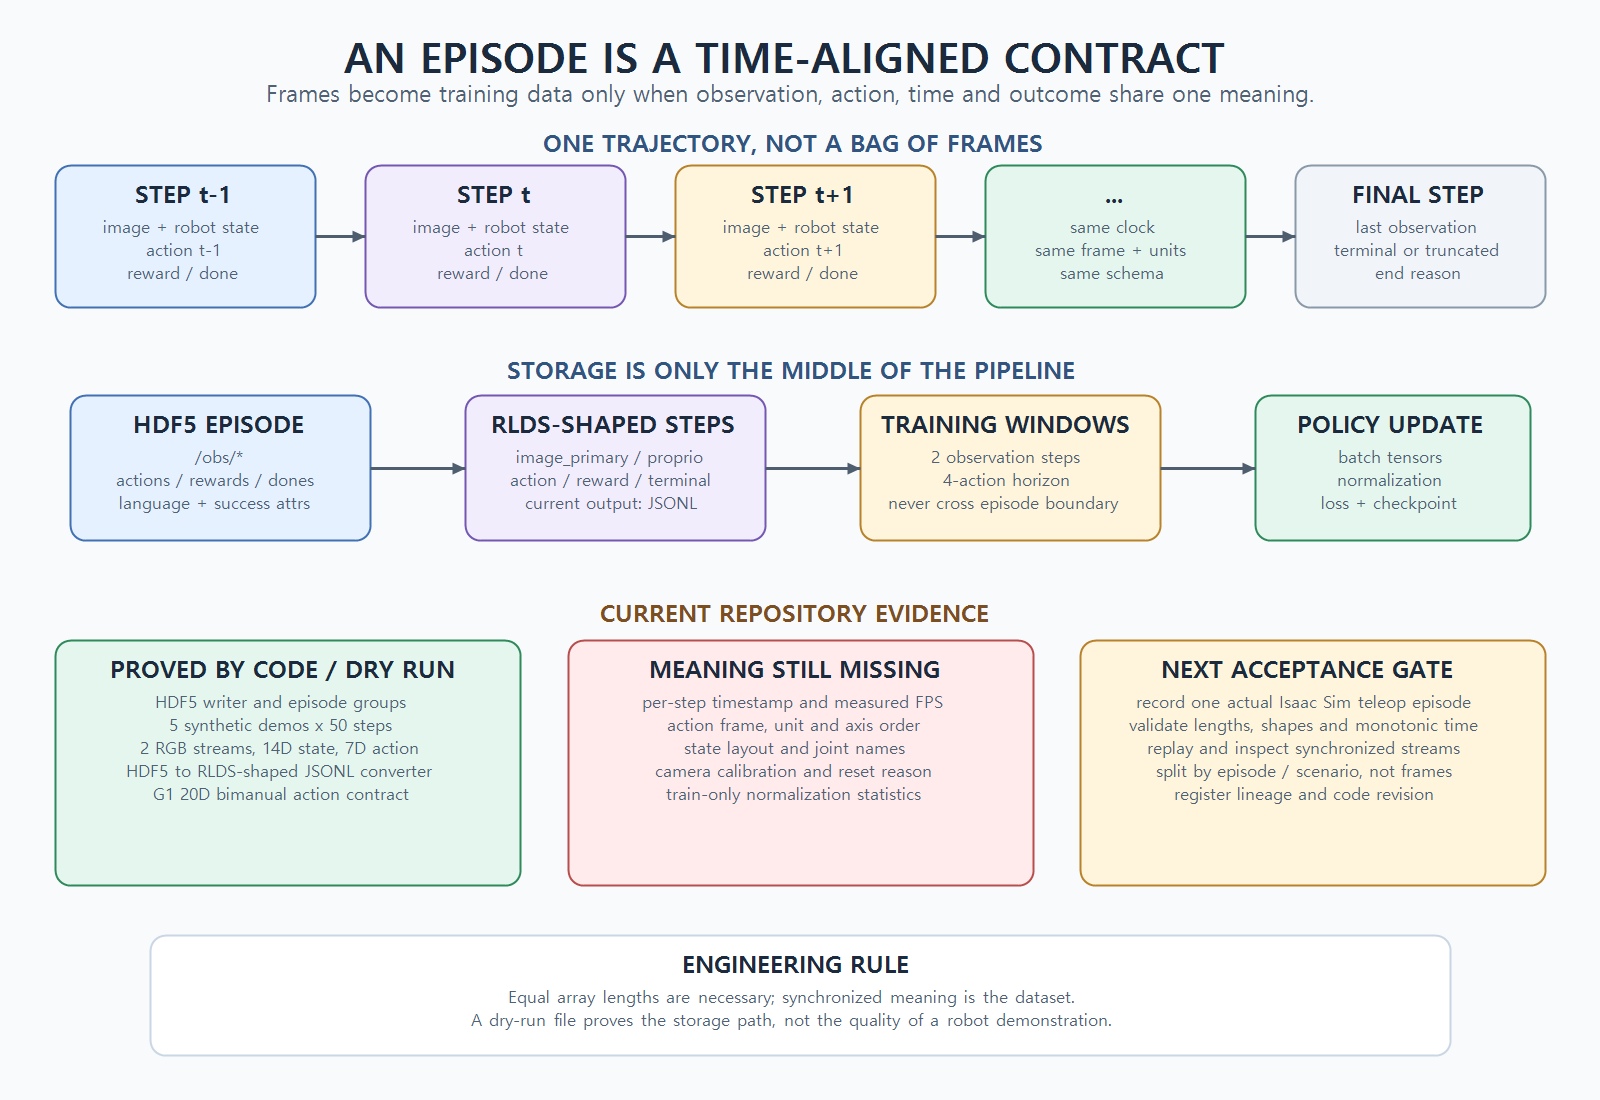
Episode는 프레임의 폴더가 아니라 하나의 닫힌 궤적입니다
로봇 학습에서 episode는 reset부터 종료까지 이어지는 한 번의 상호작용입니다. step t에서 로봇은 관측 o_t를 받고, 정책이나 조작자가 action a_t를 선택합니다. 환경은 그 action을 적용한 뒤 다음 관측 o_{t+1}과 결과를 만듭니다.
episode = {step_0, step_1, ..., step_T}

step_t = {
  observation_t,
  action_t,
  reward_t,
  terminal_t,
  timestamp_t
}
이 정의에서 중요한 것은 각 배열의 길이가 아니라 인과관계입니다. observation_t가 action을 내리기 전 센서 값인지, action을 적용한 뒤 센서 값인지 먼저 정해야 합니다. reward가 a_t를 적용한 결과인지, 이전 action의 결과인지도 마찬가지입니다. 이 계약이 문서와 코드에 없으면 데이터가 정상적으로 로드되더라도 모델은 한 step씩 밀린 대응관계를 배울 수 있습니다.
Google Research의 RLDS도 dataset을 episode의 모음으로 보고, episode 안에 순서가 있는 step들을 둡니다. step에는 현재 관측, action, reward 외에 첫 step인지, 마지막 step인지, 환경의 terminal 상태인지 구분하는 필드가 들어갑니다. is_last와 is_terminal을 나누는 이유도 분명합니다. 성공이나 실패로 환경이 끝난 것과 시간 제한이나 수집 중단으로 궤적이 잘린 것은 학습 관점에서 같은 종료가 아니기 때문입니다.
현재 HDF5 writer가 실제로 저장하는 것
현재 저장소의 collect_demos.py에는 EpisodeData와 HDF5EpisodeWriter가 구현되어 있습니다. 한 episode가 끝나면 다음과 같은 구조가 생깁니다.
/data/demo_0/
  obs/
    agentview_rgb    (T, 84, 84, 3) uint8
    wrist_rgb        (T, 84, 84, 3) uint8
    robot_state      (T, 14) float32
  actions            (T, 7) float32
  rewards            (T,) float32
  dones              (T,) bool
  attrs:
    language_instruction
    success
    n_steps

/metadata/
  task, robot, data_id, created
  total_demos, total_steps
이 구조는 첫 번째 뼈대로는 꽤 유용합니다. 대용량 영상 배열을 episode별로 압축 저장하고, action과 상태를 같은 그룹에서 찾을 수 있습니다. 자연어 명령은 episode attribute로 한 번만 저장하므로 매 step마다 같은 문자열을 중복 저장하지 않아도 됩니다. 파일 수준에는 task, robot, data ID와 생성 시각도 남습니다.
하지만 여기서 한 번 멈춰야 합니다. EpisodeData에는 metadata 필드가 있지만 writer는 그 내용을 파일에 기록하지 않습니다. 각 step에는 timestamp가 없고, 파일에도 실제 control frequency가 없습니다. action이 end-effector delta인지 joint target인지, meter와 radian 중 어떤 단위를 쓰는지, base frame인지 world frame인지도 저장되지 않습니다. robot_state의 14개 값이 어느 joint 순서인지 알려 주는 layout도 없습니다.
더 근본적으로 writer는 observation, action, reward, done의 길이가 모두 같은지 검사하지 않습니다. 마지막 step에서 done이 어떻게 설정되어야 하는지, image dtype과 shape가 episode 사이에서 바뀌지 않았는지도 검증하지 않습니다. 지금 코드는 데이터를 쓸 수는 있지만, 잘못 정렬된 데이터를 거부하는 수집 계약까지는 아닙니다.
이미지와 action 사이에는 반드시 시계가 있어야 합니다
카메라는 30Hz, 로봇 상태는 100Hz, 정책은 20Hz로 동작할 수 있습니다. 이 세 신호를 단순히 같은 인덱스로 잘라 넣으면 image[37]과 action[37]이 같은 순간을 뜻한다는 보장이 없습니다. 더욱이 영상 인코딩, 네트워크, 센서 필터, GPU 추론에는 서로 다른 지연이 생깁니다.
그래서 원시 데이터에는 적어도 원본 timestamp와 수집 clock의 기준이 있어야 합니다. 변환 단계에서 nearest-neighbor를 쓸지, 상태를 보간할지, 이전에 확정된 프레임을 쓸지 결정한 뒤 그 정책도 metadata에 남겨야 합니다. G1 LeRobot 변환기의 fps=50 기본값처럼 숫자를 나중에 넣는 것과 실제 두 sample 사이의 시간을 수집 시점에 측정하는 것은 전혀 다른 일입니다.
이 문제는 action에서도 반복됩니다. 현재 Franka dry-run의 7차원 action은 주석상 6D end-effector delta와 gripper입니다. 하지만 다음 질문에 답하지 못하면 같은 7개의 숫자를 재생할 수 없습니다.
- 이동량은 meter인가, 정규화된 [-1, 1] 값인가?
- 회전은 Euler angle, axis-angle, quaternion 중 무엇인가?
- delta는 world, robot base, end-effector 중 어느 좌표계에서 정의하는가?
- 각 축의 순서는 무엇이며 gripper의 열림·닫힘 부호는 어느 쪽인가?
- 한 action을 몇 초 동안 유지하는가?
VLA가 출력하는 action과 저수준 controller의 경계를 다룬 앞선 글에서도 이 계약이 중요했습니다. 데이터 단계에서 action 의미를 잃어버리면 어떤 모델을 고르더라도 실행 단계에서 원래 행동을 복원할 수 없습니다.
HDF5에서 RLDS로 바꾸면 무엇이 달라지는가
현재 hdf5_to_rlds.py는 HDF5의 각 demo를 읽어 step 목록으로 바꿉니다. agentview_rgb는 image_primary로, robot_state는 proprio로 이름이 바뀌고, action·reward·terminal flag와 자연어 명령이 각 step에 붙습니다. 마지막 인덱스에는 is_last도 설정합니다.
다만 정확한 표현이 필요합니다. 현재 출력은 TensorFlow Datasets로 직렬화된 완전한 RLDS dataset이 아니라, RLDS와 비슷한 step 구조를 가진 JSON Lines입니다. 파일명은 train.jsonl과 val.jsonl이고, metadata도 별도 JSON으로 저장됩니다. 즉 의미 구조를 RLDS 방향으로 맞춘 변환기이지, 공식 RLDS loader에 바로 넣는 배포용 TFDS builder까지 구현된 것은 아닙니다.
종료 step의 의미도 다시 맞춰야 합니다. 공식 RLDS에서 is_last=true인 step은 마지막 관측을 담으며 그 뒤의 action과 reward는 유효하지 않은 것으로 봅니다. 현재 converter는 HDF5의 마지막 인덱스에 is_last를 세우면서 같은 인덱스의 action과 reward도 그대로 채웁니다. 수집기가 ‘action 적용 전 관측’을 저장했는지 ‘적용 후 관측’을 저장했는지 정의하지 않은 상태에서는 이 mapping의 의미를 확정할 수 없습니다. 이것이 단순히 key 이름을 바꾸는 작업만으로 정식 RLDS 계약이 완성되지 않는 또 하나의 이유입니다.
이 차이는 사소한 명칭 문제가 아닙니다. Open X-Embodiment처럼 여러 기관과 로봇의 데이터를 섞으려면 episode ID, 환경 설정, 유효성 여부, 일관된 step 필드와 split 정의가 필요합니다. 포맷을 RLDS라고 부르는 것만으로 이 호환성이 자동으로 생기지는 않습니다.
모델은 episode 전체를 한 번에 읽지 않습니다
Episode 경계를 보존하는 이유는 모델이 항상 전체 궤적을 통째로 입력받기 때문이 아닙니다. 실제 학습기는 episode 안에서 짧은 window를 반복해서 뽑습니다. 현재 finetune_octo.py의 prototype은 기본적으로 연속된 observation 두 step을 보고 action 네 step을 묶어 학습 batch를 만듭니다.
observation window: [o_(t-1), o_t]
action chunk:       [a_t, a_(t+1), a_(t+2), a_(t+3)]
이때 episode 경계가 없으면 한 시연의 마지막 관측과 다음 시연의 첫 action이 같은 window에 들어갈 수 있습니다. reset 직전과 reset 직후를 이어 붙인 가짜 운동을 모델에 가르치는 셈입니다. 현재 iterator는 episode별로 유효한 slice를 만들기 때문에 이 경계를 넘지 않습니다. Octo 같은 generalist policy가 여러 로봇의 trajectory를 함께 학습하더라도 각 trajectory의 시간적 경계와 observation/action space를 명시해야 하는 이유입니다.
G1 양손 데이터 계약은 더 명시적이지만 아직 수집 증거는 아닙니다
G1용 g1_bimanual_hdf5_to_rlds.py는 일반 converter보다 한 단계 더 구체적입니다. 파일의 schema가 g1_bimanual_vla_v0인지, action type이 bimanual_ee_delta_pose_gripper인지 확인합니다. 왼손 7차원, 오른손 7차원, torso 3차원, base 3차원을 합쳐 20차원 action layout도 metadata에 남깁니다. 관측은 robot state, base state, 양손 pose를 합친 85차원 상태와 머리·양손목 카메라로 구성합니다.
이것은 좋은 진전입니다. ’20차원’이라는 길이뿐 아니라 어느 구간이 어느 신체 부위인지 알 수 있기 때문입니다. 그러나 validator는 현재 필요한 key의 존재를 주로 확인합니다. episode마다 길이가 같은지, shape와 dtype이 계약대로인지, timestamp가 단조 증가하는지, terminal flag가 마지막에만 있는지는 아직 검사하지 않습니다. 변환기는 CPU에서 동작하며 Isaac Sim을 실행하거나 모델을 호출하지도 않습니다.
따라서 G1 양손 schema는 구현된 데이터 인터페이스이지 수집·검증된 G1 시연 dataset은 아닙니다. 이 둘을 같은 문장으로 쓰지 않는 것이 현재 프로젝트 기록에서 가장 중요한 원칙입니다.
Train/validation split도 데이터 계약의 일부입니다
현재 일반 converter는 episode 목록의 앞 90%를 train, 뒤 10%를 validation으로 자릅니다. shuffle도 없고, object·scene·operator·seed별 stratification도 없습니다. 수집 순서가 조건과 연관되어 있다면 이 방식은 validation을 지나치게 어렵거나 쉽게 만들 수 있습니다.
반대로 한 episode의 프레임을 무작위로 나누면 더 심각한 leakage가 생깁니다. 30Hz 영상에서 인접 프레임은 거의 같은 장면이므로 train에서 본 순간의 바로 다음 프레임이 validation에 들어갑니다. 지표는 좋아지지만 새 배치와 새 episode에 일반화하는 능력은 측정하지 못합니다.
현재 pipeline에는 test split도 없고, train set만으로 계산한 action·state 정규화 통계도 저장되지 않습니다. LeRobotDataset이 schema, FPS, episode boundary, feature statistics를 metadata로 관리하는 이유가 여기에 있습니다. 모델 checkpoint만 보관하고 어떤 통계로 입력과 action을 정규화했는지 잃어버리면, 같은 모델을 다시 실행해도 다른 출력이 나옵니다.
현재 데이터 pipeline의 상태를 증거 수준으로 나누면
| 상태 | 현재 근거 | 아직 말할 수 없는 것 |
|---|---|---|
| Designed | 원격조작·합성 데이터 → HDF5 → 정제·분할 → RLDS/LeRobot → 학습이라는 흐름과 데이터 ID 규칙이 문서화되어 있습니다. | 각 단계가 실제 dataset에서 모두 연결되었다고 말할 수 없습니다. |
| Implemented | 일반 HDF5 writer, HDF5 → RLDS 형태 JSONL converter, G1 양손 schema validator와 LeRobot 변환 경로가 있습니다. | 실제 teleoperation collector와 자동 synthetic collector는 구현 완료 상태가 아닙니다. |
| Executed | 저장소에는 dryrun_test.hdf5가 있고, 코드의 dry-run은 난수 기반 episode로 schema를 검사합니다. |
Isaac Sim 또는 실제 로봇에서 시연을 수집했다는 증거가 아닙니다. |
| Observed | 기본 dry-run은 84×84 RGB 두 stream, 14D state, 7D action을 가진 5×50 step 구조를 출력하도록 작성되어 있습니다. | 센서 동기화 오차, action latency, 실제 성공률은 관측하지 않았습니다. |
| Accepted | 등록된 실제 raw/processed dataset과 품질 gate 통과 기록이 없습니다. | 학습 가능한 데이터셋이 승인되었다고 말할 수 없습니다. |
| Deployed | 이 데이터에서 만들어진 production policy나 배포 기록이 없습니다. | 데이터가 로봇 성능을 개선했다고 결론낼 수 없습니다. |
Raw Data Registry와 Processed Data Registry에도 현재 실제 항목은 없고 예시 행만 있습니다. 데이터 파일을 git에서 제외하고 metadata만 지식층에 남기는 설계는 되어 있지만, 어느 원시 episode가 어느 필터와 converter를 거쳐 어느 학습 run에 들어갔는지 추적하는 lineage는 아직 채워지지 않았습니다.
첫 실제 episode를 받기 전에 추가할 검증 항목
다음 목표를 ‘1000 episode 수집’으로 잡으면 문제가 늦게 발견됩니다. 먼저 하나의 짧은 Isaac Sim teleoperation episode를 끝까지 추적하는 편이 낫습니다. 그 한 episode가 다음 조건을 통과해야 수집량을 늘릴 수 있습니다.
- 시간을 기록합니다. 각 sensor와 action의 timestamp, clock 기준, 목표 control rate와 실제 간격을 저장하고 단조 증가를 검사합니다.
- action의 의미를 고정합니다. action type, 좌표계, 단위, 축 순서, scale, hold time을 schema version과 함께 남깁니다.
- 상태 layout을 이름으로 남깁니다. joint name과 순서, position·velocity 단위, base pose 표현을 숫자 범위가 아닌 명시적 목록으로 저장합니다.
- 카메라 계약을 남깁니다. 해상도·FPS뿐 아니라 intrinsics, extrinsics, 이미지 timestamp와 frame ID를 보존합니다.
- 길이와 종료 의미를 검사합니다. 모든 필드가 같은 시간축에 정렬되는지, 마지막 flag와 terminal/truncation 이유가 일관되는지 확인합니다.
- 원본을 재생합니다. 영상, 상태, action을 나란히 playback하여 사람 눈으로 방향·지연·gripper 부호를 확인합니다.
- episode 단위로 split합니다. object, scene, seed, operator 같은 조건을 기준으로 train/validation/test를 나누고 중복을 검사합니다.
- train 통계만 계산합니다. mean·std·min·max와 계산 코드 revision을 processed metadata에 기록합니다.
- lineage를 등록합니다. dataset ID, 원시 파일 hash, 수집 config, commit SHA, 변환 명령, 출력 경로를 registry에 연결합니다.
여기까지 통과하면 비로소 “한 episode를 수집했다”는 문장이 파일 생성 이상의 의미를 가집니다. 그다음 10개, 100개로 늘리면서 실패 episode를 버릴지 유지할지, 성공 label을 누가 어떤 규칙으로 판정할지 정할 수 있습니다.
데이터 품질은 모델보다 먼저 시간축에서 무너집니다
로봇 학습 데이터는 이미지, 숫자, 자연어를 한 폴더에 넣는 작업이 아닙니다. 같은 순간의 관측과 action, 그 action이 만든 결과를 복원 가능하게 묶는 작업입니다. HDF5와 RLDS, LeRobot은 이 계약을 저장하고 교환하기 위한 그릇입니다. 그릇을 바꾸어도 timestamp와 좌표계, 단위가 없으면 잃어버린 의미는 돌아오지 않습니다.
현재 프로젝트에서 방어 가능한 결론은 명확합니다. 일반 HDF5 writer와 RLDS 형태 JSONL 변환 경로, G1 양손 action layout은 구현되어 있습니다. 난수 episode로 저장 구조를 확인하는 dry-run 파일도 있습니다. 하지만 실제 Isaac Sim teleoperation 수집, 시간 동기화 검증, split과 normalization lineage, dataset acceptance는 아직 남아 있습니다.
그래서 다음 실험은 큰 dataset을 만드는 일이 아닙니다. 실제 조작이 들어간 단 하나의 episode를 기록하고, 영상과 action을 같은 시간축으로 재생한 뒤, 변환 전후의 의미가 유지되는지 확인하는 일입니다. 그 작은 통과 기록이 있어야 11.8MB의 파일은 비로소 로봇이 배울 수 있는 경험의 첫 조각이 됩니다.
함께 읽기: Physical AI 프로젝트의 전체 파이프라인 · 데이터와 모델 파일을 코드와 다르게 관리하는 이유 · VLA action과 저수준 제어의 경계 · Open X-Embodiment 데이터를 섞기 전에 확인한 것