G1 PPO 실험에서 정책은 한동안 두 발을 바닥에 붙인 채 움직였습니다. reward를 여러 차례 바꿔도 single_support는 0이었습니다. 정책이 발을 들기 싫어한 것인지, 현재 action 범위로는 발을 들 수 없었던 것인지 먼저 분리해야 했습니다.
그래서 PPO를 멈추고 왼쪽 hip·knee·ankle에 수동 action을 넣었습니다. action_scale=0.25, action_clip=2에서 크기 2의 명령을 줬을 때 왼발 sole 최고 높이는 0.078m였고 접촉은 한 번도 끊기지 않았습니다. scale을 0.50으로 높이거나, scale 0.25를 유지하면서 clip과 수동 명령을 4로 넓히자 최고 높이는 0.352m, single-support 비율은 0.159가 됐습니다.
이 결과는 action 범위가 실제 발 들기 권한을 제한했다는 증거였습니다. 하지만 clip을 4로 바꾼 뒤 학습한 v98 정책은 다시 double_support=1.0에 머물렀습니다. 물리적으로 가능한 행동을 열어 주는 일과 PPO가 그 행동을 발견하는 일은 서로 다른 문제였습니다.
이 구분을 이해하려면 actor가 출력한 숫자가 모터에 어떻게 도달하는지 알아야 합니다. 현재 G1의 29차원 action은 토크가 아닙니다. nominal pose에서 얼마나 벗어난 관절 위치를 원하는지 나타내고, 그 위치 오차를 Isaac Sim의 implicit PD actuator가 토크로 바꿉니다.
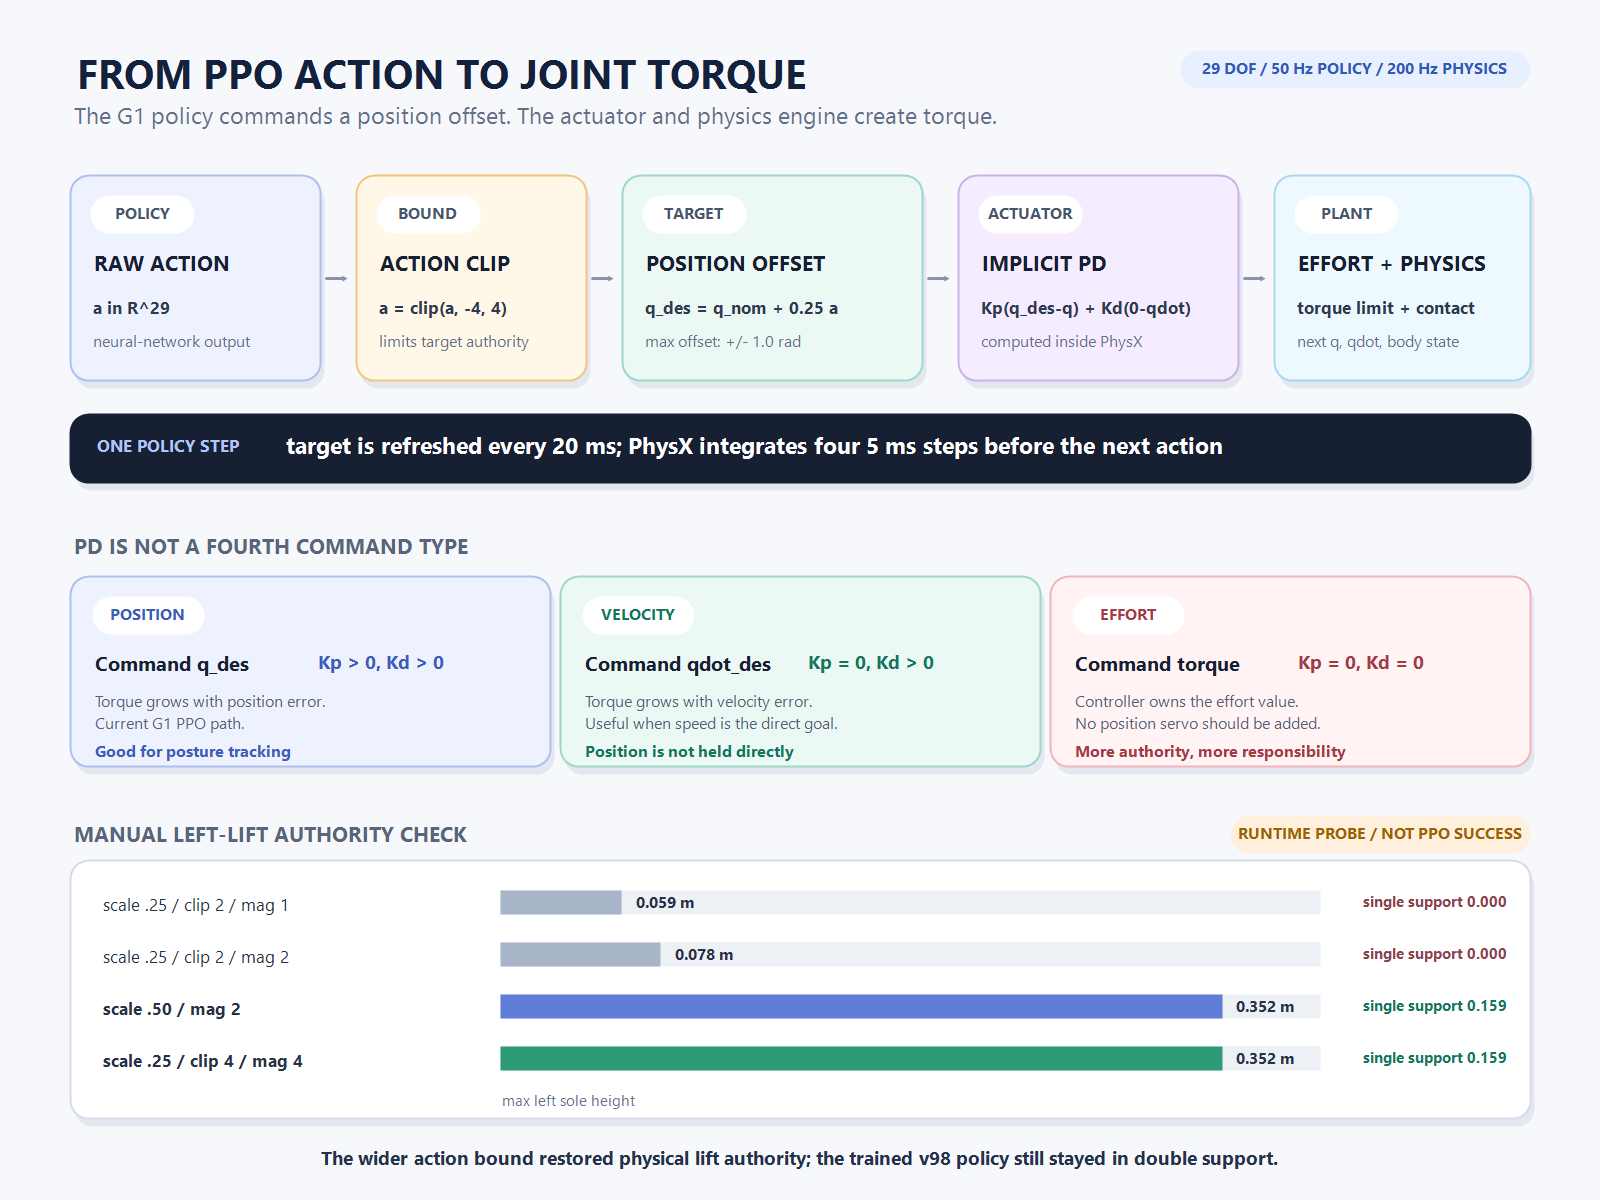
현재 G1의 action은 토크가 아니라 위치 목표의 편차입니다
sim/envs/g1_walk/g1_walk_env.py에서 actor의 출력은 다음 순서로 처리됩니다.
actor_raw_action
  → optional group-specific composition
  → clip(action, -4, 4)
  → q_target = q_nominal + 0.25 × action
  → set_joint_position_target(q_target)
→ write_data_to_sim()q_nominal은 현재 로봇 asset의 기본 관절 자세이고, action 하나는 그 자세에 더할 offset입니다. 기본 설정에서 최종 action 범위는 -4에서 4이므로 관절 위치 목표는 nominal에서 최대 ±1.0rad까지 이동할 수 있습니다. 이 범위가 곧 관절의 실제 위치 limit이라는 뜻은 아닙니다. 그 뒤에도 USD의 joint limit과 actuator effort limit, 접촉 동역학이 남아 있습니다.
현재 코드에는 허리·고관절·팔처럼 형태가 쉽게 무너지는 그룹에 tanh 기반의 별도 bound를 적용하는 실험용 action interface도 있습니다. 이 profile이 활성화되면 actor raw action, group별로 조합된 action, 전역 clip을 통과한 action이 서로 다를 수 있습니다. 그래서 평가할 때는 network 출력만 저장해서는 어느 목표가 simulator에 전달됐는지 알 수 없습니다.
Isaac Lab Articulation API에서 set_joint_position_target()은 즉시 PhysX를 움직이지 않습니다. 내부 target buffer를 채우고, 이후 write_data_to_sim()이 actuator 처리 결과를 simulation buffer에 씁니다. 현재 G1의 _pre_physics_step()과 _apply_action()이 이 두 단계를 나눠 수행합니다.
위치·속도·토크 제어의 차이는 무엇을 목표값으로 주는가에 있습니다
세 제어 방식은 모두 결국 관절에 힘을 만듭니다. 차이는 상위 제어기가 물리 엔진 또는 motor servo에 무엇을 요청하는가입니다.
| 제어 방식 | 상위 제어기의 명령 | 저수준에서 필요한 계산 | 주의할 점 |
|---|---|---|---|
| 위치 제어 | 목표 관절각 q_des |
현재 각도·속도 오차를 PD로 토크로 변환 | 큰 위치 오차나 높은 gain은 토크 포화를 만들 수 있음 |
| 속도 제어 | 목표 관절속도 qdot_des |
속도 오차를 줄이는 damping 계열 effort 계산 | 특정 위치를 직접 유지하는 제어는 아님 |
| 토크 제어 | 목표 effort tau_des |
상위 제어기가 토크를 직접 계산 | position drive가 함께 켜지면 의도하지 않은 effort가 더해질 수 있음 |
위치 제어는 “왼쪽 무릎을 0.3rad로 보내라”처럼 목표 각도를 줍니다. 모터 또는 simulator의 servo는 현재 위치와 목표 위치의 차이를 보고 필요한 effort를 계산합니다. 충격이나 외력으로 관절이 밀려도 목표 자세로 돌아가려는 성질이 있어 posture tracking에 쓰기 쉽습니다.
속도 제어는 “이 관절을 초당 1rad로 움직여라”처럼 속도를 직접 목표로 둡니다. 바퀴처럼 회전 위치보다 회전 속도가 중요한 장치에 자연스럽습니다. 관절이 어느 위치에서 멈춰야 하는지는 별도의 상위 논리나 target 변경으로 정해야 합니다.
토크 제어에서는 상위 제어기가 계산한 effort를 그대로 전달합니다. Isaac Lab의 articulation 실행 예제도 effort target을 사용할 때 stiffness와 damping을 0으로 둡니다. 그렇지 않으면 직접 보낸 torque 위에 position·velocity drive가 계산한 effort가 함께 작용할 수 있기 때문입니다.
PD는 별도의 네 번째 명령이 아니라 오차를 토크로 바꾸는 규칙입니다
PD는 proportional–derivative control의 약자입니다. P항은 위치 오차에 비례해 목표 쪽으로 밀고, D항은 속도 오차에 비례해 움직임을 감쇠합니다. 일반적인 joint-space 형태는 다음과 같습니다.
tau_computed
  = Kp × (q_des - q)
  + Kd × (qdot_des - qdot)
  + tau_feedforward

tau_applied
= clip(tau_computed, -tau_max, tau_max)Kp가 stiffness, Kd가 damping입니다. 위치 제어는 두 gain을 사용해 목표 자세를 추종합니다. 순수한 속도 제어라면 보통 stiffness를 0으로 두고 damping과 속도 target을 사용합니다. 직접 torque를 제어하려면 두 gain을 0으로 두고 effort target만 전달합니다. 따라서 “위치 제어냐 PD 제어냐”는 같은 층의 양자택일이 아닙니다. 위치 명령을 토크로 실현하는 방법으로 PD를 사용할 수 있습니다.
Isaac Lab actuator 문서는 position·velocity control에서 physics engine이 내부적으로 spring–damper 형태의 PD effort를 계산한다고 설명합니다. explicit actuator는 사용자 코드가 PD와 clipping을 계산하고, implicit actuator는 stiffness와 damping을 PhysX에 전달해 simulation이 연속시간 drive로 처리합니다.
현재 G1은 ImplicitActuatorCfg를 사용합니다. 따라서 환경 코드가 위 수식을 Python으로 직접 계산하지 않습니다. 환경은 position target을 쓰고, PhysX가 joint drive와 timestep 안에서 effort를 만듭니다. 이 차이는 같은 gain을 사용해도 explicit Python PD와 implicit PhysX drive가 완전히 같은 수치 결과를 보장하지 않는다는 뜻이기도 합니다.
G1의 관절마다 같은 PD gain과 torque limit을 쓰지 않습니다
현재 official G1 설정은 모터 역할에 따라 actuator group을 나눕니다. hip pitch·yaw는 effort limit 88Nm, stiffness 100, damping 2를 사용하고 waist yaw의 stiffness와 damping은 200과 5입니다. hip roll과 knee는 effort limit 139Nm이며 knee stiffness는 150, damping은 4입니다.
ankle은 어깨·팔꿈치·wrist roll·waist roll/pitch와 함께 light-distal group에 들어갑니다. 이 group의 effort limit은 25Nm, stiffness는 40이고 ankle damping은 2입니다. wrist pitch·yaw는 effort limit 5Nm로 더 낮습니다. 모든 group에는 armature 0.01이 설정돼 있습니다.
숫자가 다른 이유를 “다리는 강하고 팔은 약해서”라고만 줄이면 충분하지 않습니다. 같은 위치 오차라도 Kp와 effort limit이 다르면 계산되는 토크와 포화 시점이 달라집니다. link inertia, gear와 motor 특성, 관절이 맡는 역할도 함께 반영해야 합니다. 현재 값은 official Unitree G1 asset에 맞춘 출발점이며, 실물 motor trace와 일치함을 이 프로젝트에서 system identification으로 확인한 상태는 아닙니다.
zero action도 zero torque가 아닌 이유
actor가 0을 출력하면 식은 q_target=q_nominal이 됩니다. 하지만 이것은 목표 위치의 offset이 0이라는 뜻이지, applied torque가 0이라는 뜻은 아닙니다. 실제 관절 위치가 nominal과 다르거나 관절이 움직이는 중이면 P항과 D항이 torque를 만듭니다. 중력과 접촉으로 자세가 흔들려도 servo는 nominal pose를 회복하려고 effort를 냅니다.
G1 v87 zero-policy 검사에서 이 차이가 드러났습니다. 시작 시 발목 torque-limit 비율은 좌우 0.635와 0.682였고, t=0.02초에는 0.994와 1.000에 도달했습니다. 정책 action은 0이었지만 position error와 당시 asset–actuator 조합은 큰 effort를 만들었습니다. ZMP margin이 음수가 된 것은 약 0.78초 뒤였으므로, 균형을 잃은 뒤 토크가 커졌다고만 설명할 수 없었습니다.
이 사건은 reward보다 actuator와 초기 자세를 먼저 보게 만들었습니다. 자세한 USD–actuator 교차 진단은 URDF와 USD의 실행 계약에 정리했습니다. 여기서 필요한 결론은 하나입니다. action 값과 torque 값은 같은 신호가 아니며, 둘 사이의 PD와 limit을 계측해야 원인을 찾을 수 있습니다.
action clip과 effort limit은 서로 다른 곳을 자릅니다
action_clip은 actor 출력이 만들 수 있는 위치 목표 범위를 제한합니다. 현재 scale 0.25에서 clip 2라면 nominal 대비 최대 offset은 ±0.5rad이고, clip 4라면 ±1.0rad입니다. raw action이 4를 넘더라도 target은 더 멀어지지 않습니다.
effort_limit은 그 target을 따라가려고 PD가 계산한 torque를 제한합니다. 위치 오차가 크거나 stiffness가 높으면 action이 clip 안에 있어도 torque가 포화될 수 있습니다. 반대로 action을 크게 넓혀도 link geometry나 접촉 때문에 목표 자세가 발을 들지 못한다면 physical authority는 생기지 않습니다.
| 제한 | 적용 위치 | 제한하는 것 | 대표 진단값 |
|---|---|---|---|
| group bound | raw action 조합 단계 | 허리·고관절·팔 등 특정 group의 commanded 범위 | actor raw와 composed action 차이 |
| action clip | 관절 target 계산 전 | nominal pose에서 가능한 최대 목표 offset | clamped action, q_target-q_nominal |
| joint position limit | articulation | 관절이 허용하는 물리적 각도 범위 | soft/hard joint limit 접근 |
| effort limit | actuator/physics | 목표를 따라가기 위해 적용 가능한 최대 torque | computed 대비 applied torque, saturation ratio |
이 네 경계를 하나의 “action 범위”로 부르면 진단이 꼬입니다. actor가 극단적인 raw action을 냈는지, 환경이 target을 너무 좁게 잘랐는지, PD가 과도한 torque를 요구했는지, actuator가 한계에 걸렸는지는 다른 문제입니다.
수동 발 들기 검사가 찾아낸 것은 학습이 아니라 action 권한이었습니다
v95–v97은 reward 구조를 바꿨지만 발을 떼지 못했습니다. 다음 reward를 추가하기 전에 수동 action으로 왼발을 들 수 있는지 확인했습니다.
| runtime 조건 | 왼발 contact-off | single support | 왼발 sole 최고 높이 |
|---|---|---|---|
| scale 0.25, clip 2, manual 1 | 0.000 | 0.000 | 0.059m |
| scale 0.25, clip 2, manual 2 | 0.000 | 0.000 | 0.078m |
| scale 0.50, manual 2 | 0.159 | 0.159 | 0.352m |
| scale 0.25, clip 4, manual 4 | 0.159 | 0.159 | 0.352m |
scale을 두 배로 키우는 방법과 clip을 두 배로 키우는 방법이 이 특정 수동 probe에서는 같은 최대 target offset을 만들었습니다. official scale 0.25를 보존하면서 권한을 넓히기 위해 v98에서는 action_clip: 2→4만 변경했습니다. hip·knee·ankle의 조합 (2, 2, -2)는 별도 scan에서 contact-off 비율 0.693, 최고 sole 높이 0.339m를 만들었고 첫 contact-off는 0.02초에 발생했습니다.
이 결과로 “관절 mapping이 틀려서 왼발을 물리적으로 들 수 없다”는 설명은 약해졌습니다. target 권한과 sign pattern이 확인됐기 때문입니다. 그러나 WBC 또는 PPO가 그 target을 안정적인 교대 보행으로 사용할 수 있는지는 전혀 검증하지 못했습니다.
clip을 넓힌 v98이 걷지 못한 이유는 별도의 문제였습니다
v98 PPO에서는 raw action 최대값이 9.004까지 나와 global clip에 실제로 걸렸고, 평균 절대값도 1.240이었습니다. 즉 정책 출력이 작은 채로 죽어 있던 실험은 아니었습니다. 그런데도 15초 평가에서 왼발과 오른발 sole 최고 높이는 0.050m와 0.052m였고, single_support=0, double_support=1.0이었습니다.
수동 probe가 성공한 것은 특정 관절 조합을 사람이 넣었기 때문입니다. clip 4는 그 조합을 표현할 공간만 열었습니다. PPO가 그 방향을 찾으려면 관측에서 어느 발을 들어야 하는지 구분할 수 있어야 하고, reward 또는 teacher가 작은 초기 lift를 유리한 행동으로 평가해야 하며, stance 발이 무너지지 않도록 나머지 관절도 함께 제어해야 합니다.
따라서 v98의 결론은 “action clip을 넓히면 걷는다”가 아니었습니다. physical/action-authority blocker는 제거됐지만 policy discovery blocker는 남았습니다. 다음 v99에서 swing-action prior를 강화하자 처음으로 아주 작은 single-support 신호가 나타났지만, 빈도는 0.0025에 불과했고 8개 환경의 평균 첫 종료는 3.843초였습니다. 이 후보도 보행으로 승인하지 않았습니다.
torque trace는 무엇을 기록해야 하는가
Isaac Lab의 ArticulationData는 user가 준 position·velocity·effort target과 actuator가 계산한 computed_torque, 제한 뒤의 applied_torque를 구분합니다. 다만 implicit actuator에서는 PhysX가 실제 drive를 내부 처리하고 torque를 직접 노출하지 않기 때문에 Isaac Lab이 계산한 값은 근사치라는 문서상 경계가 있습니다.
현재 G1 reward는 robot.data.applied_torque를 이용해 torque 제곱 penalty와 |torque×joint_velocity| 형태의 energy 항을 계산합니다. 이 값은 학습과 simulator 진단에는 유용하지만, 실물 motor current에서 환산한 torque와 동일하다고 가정하면 안 됩니다.
한 control failure를 추적할 때는 적어도 다음 신호를 같은 timestamp에 둬야 합니다.
- actor raw action과 group별 composed action
- global clip 이후 action과 최종
q_target - 실제 joint position·velocity와 position error
- computed/applied torque와 joint별 effort-limit 비율
- 발 접촉, sole 높이, 몸체 tilt와 termination cause
이렇게 기록하면 raw action은 작지만 초기 자세 오차 때문에 torque가 포화되는 경우, raw action이 커도 clip 때문에 target이 더 이상 변하지 않는 경우, target은 충분하지만 stance contact가 무너지는 경우를 분리할 수 있습니다.
현재는 학습된 목표 생성기와 implicit PD의 조합을 사용합니다
현재 G1 구조를 “RL 제어”라고만 부르면 저수준 servo가 사라진 것처럼 들립니다. 실제로는 PPO actor가 50Hz에서 관절 위치 목표를 만들고, implicit PD가 200Hz physics 안에서 torque를 만들어 접촉과 관성을 처리합니다. WBC가 absolute joint target을 내는 경로도 같은 actuator에 연결할 수 있습니다. 두 상위 제어기의 차이는 WBC와 강화학습의 역할 경계에서 따로 설명했습니다.
이 선택이 torque control보다 본질적으로 우월하다는 뜻은 아닙니다. 위치 target 인터페이스는 actor가 motor-level torque의 모든 빠른 변화를 직접 배우지 않아도 되고, nominal pose 주변의 자세 추종을 low-level drive에 맡길 수 있습니다. 반면 gain과 limit이 잘못되면 policy가 내는 의도와 실제 torque 사이가 멀어지고, 실물 전이를 위해 actuator dynamics를 별도로 맞춰야 합니다.
직접 torque policy나 explicit actuator model을 사용하려면 motor response, delay, saturation과 안전 한계를 상위 제어기가 더 정확히 책임져야 합니다. 현재 프로젝트에는 실물 G1 torque trace와 비교한 system identification이 없으므로, 어느 control mode가 실제 로봇에서 더 낫다는 결론은 내릴 수 없습니다. 필요한 검증 순서는 G1 sim-to-real 검증 계약과 연결됩니다.
현재 확인한 것과 아직 승인하지 않은 것
| 상태 | 현재 근거 | 말할 수 없는 것 |
|---|---|---|
| Implemented | 29D action, scale 0.25, clip 4, position target, official implicit actuator group | torque를 직접 출력하는 PPO policy가 구현됐다는 뜻은 아님 |
| Executed | action authority 수동 scan과 v98·v99 PPO 평가 | 수동 발 들기 패턴을 정책이 안정적으로 학습했다는 뜻은 아님 |
| Observed | clip 4에서 수동 single-support 가능, v98 policy는 double-support 고착 | clip 확대가 보행 문제를 해결했다는 뜻은 아님 |
| Accepted | 현재 승인된 G1 보행 checkpoint 없음 | 현재 position-PD 조합이 최종 controller라는 뜻은 아님 |
| Deployed | 실물 G1 배포와 torque 비교 기록 없음 | 실물 안정성·추종 성능·sim-to-real 성능을 주장할 수 없음 |
origin/main@ee4d96e 기준으로 action-to-torque 경로는 구현됐고 여러 PPO·수동 진단에서 실행됐습니다. 그러나 현재 승인된 보행 checkpoint와 실물 배포 기록은 없습니다. 다음 runtime 진단에서 먼저 고정해야 할 것도 reward가 아니라 actor raw action, composed/clamped action, q_target, joint state와 applied torque를 한 control step의 같은 시간축으로 묶는 일입니다.
위치·속도·토크 제어의 차이는 명령 이름보다 책임의 위치에 있습니다. 위치 목표를 주면 저수준 PD가 torque 계산을 맡고, torque 목표를 주면 상위 제어기가 그 책임을 가져갑니다. 현재 G1에서는 PPO가 위치 목표 생성기이고 implicit PD가 torque 생성기입니다. 이 두 층을 분리해 봐야 “정책이 잘못된 action을 냈는가”와 “actuator가 그 action을 다른 torque로 만들었는가”를 같은 문제로 오해하지 않습니다.
함께 읽기: G1 강화학습 환경의 관측·행동·보상 · URDF와 USD의 G1 asset 계약 · WBC와 강화학습의 역할 경계 · PPO의 rollout과 policy update · G1 sim-to-real 검증
공식 문서: Isaac Lab Actuators · Isaac Lab Articulation API · Interacting with an Articulation