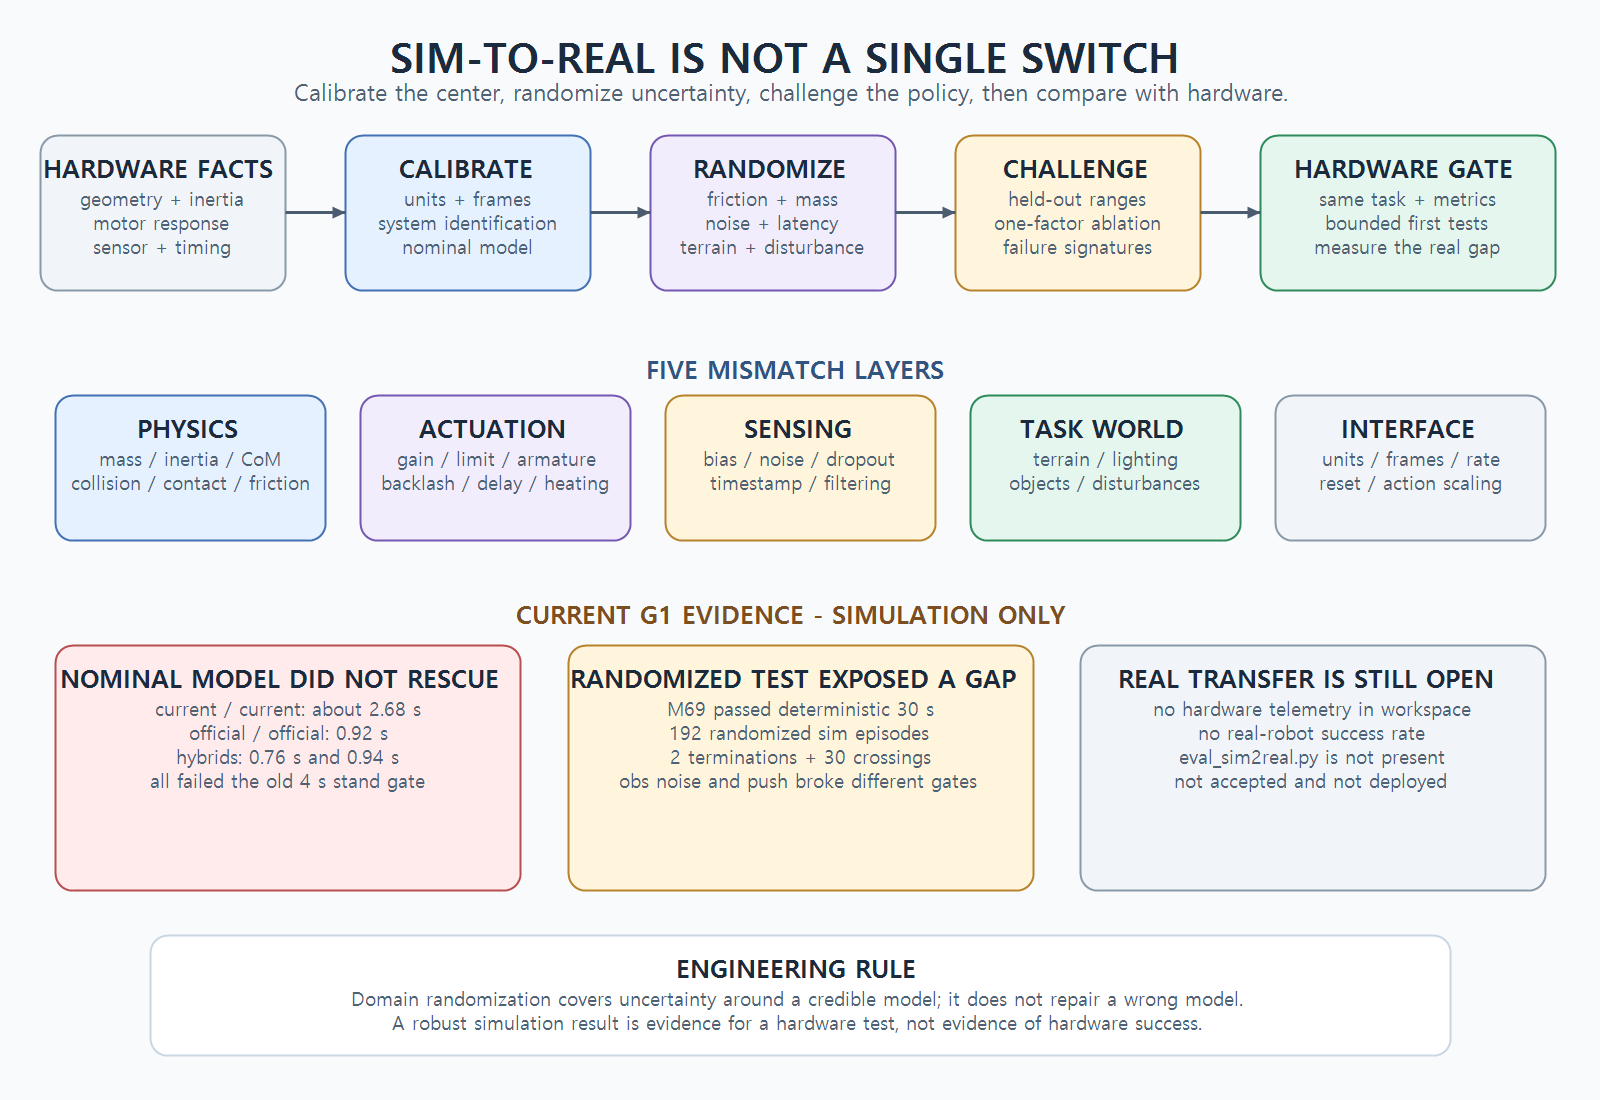
G1의 자체 변환 USD와 자체 actuator 설정을 사용했을 때 zero policy는 평균 약 2.68초 뒤 무너졌습니다. 정책 action을 모두 0으로 둔 검사였으므로, 이 결과는 학습보다 로봇 모델과 저수준 구동 설정을 먼저 의심하게 만들었습니다. 그래서 공식 Unitree USD와 공식 Isaac Lab 계열 actuator 설정을 함께 적용했습니다.
결과는 예상과 반대였습니다. 공식 USD와 공식 actuator 조합은 0.92초에 종료됐습니다. 자체 USD에 공식 actuator를 붙인 조합은 0.76초, 공식 USD에 기존 actuator를 붙인 조합은 0.94초였습니다. 네 조합 모두 당시 사용하던 4초 정지 gate를 통과하지 못했습니다. 더 오래 버틴 기존 조합조차 현실에 가까워서가 아니라, 서로 다른 오차가 우연히 보상된 것일 가능성이 생겼습니다.
이 경험 때문에 sim-to-real을 “시뮬레이터에서 학습한 모델을 실물에 복사하는 마지막 단계”로 보지 않게 됐습니다. 전이 전에 먼저 물어야 할 것은 파일을 어떻게 옮기느냐가 아니라, 시뮬레이션과 실제 로봇 사이에서 어떤 입력–응답 관계를 어느 오차 범위까지 맞춰야 하는가입니다.
Reality gap은 마찰계수 하나가 아닙니다
Reality gap은 시뮬레이터와 실제 로봇의 차이를 통칭합니다. 흔히 바닥 마찰이나 링크 질량을 먼저 떠올리지만, 보행 정책이 보는 세계는 그보다 넓습니다. 정책의 한 action이 다음 observation으로 돌아올 때까지의 전체 폐루프가 다를 수 있습니다.
| 격차의 층 | 시뮬레이션에서 정해야 하는 것 | 틀렸을 때 나타날 수 있는 현상 |
|---|---|---|
| 형상·물리 | 링크 질량과 관성, CoM, collision 형상, 접촉과 마찰 | 같은 자세에서도 ZMP와 넘어지는 방향이 달라짐 |
| 구동기 | PD gain, 토크·속도 제한, armature, 지연과 비선형 | 목표 관절각은 같아도 overshoot·포화·tracking lag가 달라짐 |
| 센서 | bias, noise, filtering, dropout, timestamp | 정책이 늦거나 흔들리는 상태를 정상 상태로 해석함 |
| 태스크 환경 | 지형, 경사, 마찰 변화, 외란, 조명과 물체 배치 | 한 바닥이나 한 카메라 조건에만 맞는 행동을 학습함 |
| 소프트웨어 인터페이스 | 단위, 좌표계, 관절 순서, control rate, action scale, reset | 정상적인 정책 출력이 엉뚱한 관절이나 크기로 적용됨 |
G1에서 공식 USD를 교체한 사건은 첫 번째와 두 번째 층이 서로 얽힌 사례였습니다. USD에는 collision, 질량과 관성, joint drive 같은 값이 들어 있고, 환경 설정에는 actuator group별 gain과 effort limit, armature가 들어 있습니다. 한쪽만 바꾸면 동일한 action이 전혀 다른 동역학을 만듭니다. 관절 기본 자세와 spawn 높이가 맞지 않으면 시작 순간의 침투나 지지 형상까지 달라집니다.
다섯 번째 층도 물리만큼 중요합니다. 현재 G1 환경은 200Hz 물리 step에 decimation 4를 사용해 정책을 50Hz로 실행합니다. action은 29개 관절의 nominal pose에 더할 offset이며 scale은 0.25입니다. 실제 runtime이 50Hz를 유지하지 못하거나, joint order·단위·action scale 중 하나가 다르면 시뮬레이터에서 검증한 정책과 같은 제어기가 아닙니다.
먼저 기준 모델을 보정하고 그다음 불확실성을 넓힙니다
Sim-to-real에서 서로 자주 섞이는 두 작업이 system identification과 domain randomization입니다.
System identification은 실제 로봇의 입력과 응답을 측정해 시뮬레이터의 기준점을 좁히는 작업입니다. 예를 들어 일정한 관절 목표나 토크 명령을 주고 실제 관절 위치·속도의 rise time, overshoot, steady-state error를 기록합니다. 그 응답과 시뮬레이터의 응답이 비슷해지도록 gain, damping, armature, delay 또는 더 복잡한 actuator model을 조정합니다.
Domain randomization은 그 기준점 주변의 불확실성을 하나의 값이 아니라 분포로 다루는 작업입니다. 매 episode에서 마찰, 질량, 센서 오차, 지연 또는 지형을 다시 뽑고, 정책이 그 분포 전체에서 높은 보상을 얻도록 학습합니다.
ξ ~ p(ξ)
θ* = arg maxθ Eξ,τ [ Σt γ^t r(st, at ; ξ) ]ξ는 한 episode의 물리·센서·환경 조건이고, p(ξ)는 학습에 사용한 randomization 분포입니다. 실제 로봇의 조건이 이 분포 안에 있고 정책이 보지 않은 조합에도 일반화한다면 전이 가능성이 높아집니다. Tobin 등의 초기 domain randomization 연구는 렌더링 조건을 넓혀 실제 영상이 시뮬레이션의 또 다른 변형처럼 보이게 만드는 발상을 보여 줬습니다. 보행에서는 Hwangbo 등의 actuator model과 동역학 randomization처럼 입력–토크 관계까지 다룹니다.
순서가 중요합니다. 기준 시뮬레이터가 잘못된데 randomization 범위부터 넓히면 정책은 잘못된 중심을 둘러싼 여러 세계에 적응합니다. 우연히 현실이 범위 안에 들어올 수도 있지만, 어떤 차이를 흡수했는지 알기 어렵고 정책이 지나치게 보수적으로 변할 수도 있습니다. G1의 기존 actuator 조합이 공식 조합보다 오래 버틴 사실을 곧바로 “기존 모델이 더 현실적이다”라고 해석하지 않은 이유입니다. 오래 버틴 시간은 한 지표일 뿐이고, 실물 입력–응답 데이터가 없으므로 어느 조합이 현실에 더 가까운지는 아직 판정할 수 없습니다.
Domain randomization은 네 종류의 불확실성을 다르게 다뤄야 합니다
모든 값을 한꺼번에 넓게 흔드는 방식은 실패 원인을 찾기 어렵습니다. 현재 프로젝트에서는 randomization을 다음과 같이 나누어 보는 편이 유용합니다.
- 동역학 randomization: 링크 질량·관성·CoM, 마찰, restitution, actuator gain과 limit를 바꿉니다. 같은 action이 만드는 가속도와 접촉 결과가 달라집니다.
- 관측 randomization: 관절 상태, 몸체 속도, projected gravity 같은 observation에 noise·bias·dropout·filtering을 넣습니다. 정책이 정확한 simulator state에만 의존하지 않게 합니다.
- 시간 randomization: observation delay, action delay, jitter를 넣습니다. 한두 control step의 지연도 접촉 전환과 균형에 영향을 줄 수 있기 때문에 물리 값과 별도로 검사해야 합니다.
- 환경·외란 randomization: 지형, 경사, 마찰 패치와 외부 push를 바꿉니다. nominal 보행뿐 아니라 상태가 흔들린 뒤 회복할 수 있는지 봅니다.
Isaac Lab에서는 reset 또는 interval 시점의 EventTerm으로 이러한 변화를 구성할 수 있습니다. 다만 API가 있다는 것과 현재 G1 환경에 randomization이 들어 있다는 것은 다른 주장입니다. 현재 G1WalkEnvCfg의 flat 환경은 마찰 1.0의 고정 평면, 공식 G1 asset과 고정 actuator 설정을 사용합니다. rough 환경에는 다양한 지형 생성기가 있지만 물리 material의 static·dynamic friction은 역시 1.0으로 고정돼 있습니다. Theory에 적힌 마찰 범위, 질량 ±15%, 지연 범위는 설계 예시이지 이 DirectRLEnv에서 실행된 값으로 쓰면 안 됩니다.
현재 구현된 것은 실물 전이가 아니라 시뮬레이션 강건성 분해입니다
별도의 G1 motion-tracking 평가 경로에는 --randomized_eval과 --randomization_components가 구현돼 있습니다. 여기서는 randomization을 observation, startup, push 세 그룹으로 나누고, 그룹을 끄거나 유지하면서 같은 정책이 어느 조건에서 무너지는지 볼 수 있습니다. 평가 과정은 깨끗한 observation과 noise가 섞인 observation의 차이, 실제로 적용된 push velocity delta도 기록합니다.
이 분리가 실제로 필요했던 사례가 M69였습니다. M69는 deterministic 조건에서 30초를 통과했지만, 세 개의 paired randomized seed에서 총 192 episode를 평가하자 생존율은 99.48%, 종료 2회, 발 crossing 30개 환경이 기록됐습니다. 절대 생존율만 보면 높지만 whole-policy promotion gate는 실패했습니다.
구성요소를 나누어 보니 observation noise만 켠 조건은 route와 action-rate를 무너뜨렸고, push만 켠 조건은 route와 crossing을 무너뜨렸습니다. startup randomization만 적용한 조건은 통과했습니다. 이것은 현실 전이 성공의 증거가 아닙니다. 다만 “강건성이 부족하다”는 한 문장을 센서 관측 민감도와 외란 회복 부족이라는 서로 다른 문제로 좁혀 준 sim-to-sim 증거입니다.
또한 이 결과만으로 noise와 push가 실제 원인이라고 일반화할 수는 없습니다. 사용한 randomization 범위가 실제 센서와 외란 분포를 대표하는지 확인되지 않았기 때문입니다. 현재 단계에서 말할 수 있는 것은 정해진 시뮬레이션 randomization 조건에서 서로 다른 실패 signature가 재현됐다는 것까지입니다.
현재 Sim-to-real 상태를 단계별로 적으면 아직 ‘설계와 sim 검증’입니다
| 상태 | 현재 근거 | 말할 수 없는 것 |
|---|---|---|
| Designed | Theory에 DR, actuator model, teacher–student, sensor noise·delay 전략이 정리됨 | 각 전략이 G1에 모두 적용됐다는 뜻은 아님 |
| Implemented | 공식 G1 asset·actuator config, 200Hz physics/50Hz policy loop, randomized motion-tracking 평가와 ablation 경로 | 실제 G1 모터·센서 모델과 일치한다는 뜻은 아님 |
| Executed | USD/actuator 네 조합의 zero-policy trace, M69 deterministic·randomized 평가가 실행됨 | 실물 로봇에서 같은 정책이 실행됐다는 뜻은 아님 |
| Observed | 네 조합 모두 old 4s stand gate 실패, randomized 평가에서 noise와 push별 실패가 관측됨 | 실물 reality gap의 크기는 아직 모름 |
| Accepted | 실물 전이 승인 정책 없음 | sim-to-real 완료를 주장할 수 없음 |
| Deployed | 실물 G1 배포 기록 없음 | 실물 성공률·안전성·지속 운용 성능 없음 |
한 가지 문서–구현 불일치도 남아 있습니다. training/eval/README.md에는 eval_sim2real.py가 실제 로봇 성능을 측정하는 스크립트로 적혀 있지만, 현재 revision의 training/eval/에는 그 파일이 없습니다. 따라서 sim success와 real success의 차이를 자동 계산하는 평가기는 설계 목록에는 있으나 구현됐다고 볼 수 없습니다.
실물에 올리기 전 필요한 첫 검증 계약
현재 프로젝트에서 다음 단계는 randomization 항목을 더 많이 넣는 일이 아닙니다. 실제 로봇과 시뮬레이터를 같은 질문으로 비교할 수 있는 계약부터 정해야 합니다.
- 구성의 계보를 고정합니다. USD source, mass·inertia·collision, joint order, nominal pose, actuator gain과 limit, control rate, action scale을 하나의 manifest로 묶습니다.
- 저에너지 입력–응답 검사를 정의합니다. 보행 정책 전에 정지 자세와 제한된 관절 명령으로 target–actual tracking, saturation, delay를 같은 시간축에 기록합니다.
- 기준 모델을 보정합니다. rise time과 overshoot, steady-state error, 접촉 위치처럼 직접 비교 가능한 신호를 이용해 nominal simulation을 좁힙니다.
- 측정 불확실성에서 DR 범위를 만듭니다. 임의의 넓은 범위가 아니라 실제 측정 오차와 운용 조건을 포함하도록 friction·mass·noise·delay 분포를 정합니다.
- 학습 범위와 평가 범위를 분리합니다. policy가 본 분포뿐 아니라 경계와 held-out 조합에서도 fall, tracking, crossing, action saturation을 검사합니다.
- 실물에서는 같은 gate를 낮은 위험부터 엽니다. stand/hold, 작은 명령, 제한된 보행 순서로 범위를 넓히고, 시뮬레이션과 동일한 단위와 timestamp로 로그를 남깁니다.
이 과정을 거치면 sim-to-real gap을 숫자로 정의할 수 있습니다. 같은 명령과 평가 시간에서 simulator와 hardware의 tracking error, termination, contact, action saturation 차이를 비교하고, 어느 층의 mismatch가 큰지 다시 좁힙니다. 지금은 실물 trace가 없으므로 그 gap을 계산할 분모 자체가 없습니다.
시뮬레이션에서 강건한 정책은 실물 시험의 후보일 뿐입니다
Domain randomization의 목적은 시뮬레이터를 현실처럼 보이게 꾸미는 것이 아닙니다. 정책이 실제 운용에서 만날 수 있는 차이에 지나치게 민감하지 않도록 학습 분포를 설계하는 것입니다. 그러나 그 분포의 중심과 범위를 정하려면 결국 실제 로봇의 측정이 필요합니다.
G1에서 공식 asset과 gain을 넣고도 더 빨리 무너진 일은 이 순서를 분명하게 만들었습니다. 출처가 공식이라는 사실은 인터페이스와 동역학이 현재 환경에 올바르게 결합됐다는 증거가 아닙니다. 반대로 기존 조합이 2.68초를 버텼다는 사실도 현실에 더 가깝다는 증거가 아닙니다. 둘 다 시뮬레이션 안에서 관측한 입력–응답일 뿐입니다.
현재의 방어 가능한 결론은 세 가지입니다. 공식 G1 asset·actuator 경로와 sim robustness 평가 도구는 구현됐습니다. observation·startup·push를 나눈 randomized sim 평가에서 deterministic 결과가 가린 실패도 관측됐습니다. 하지만 hardware telemetry, 실물 성공률, 실행 가능한 sim-to-real gap evaluator는 아직 없습니다.
다음 검증은 그래서 실제 G1에 보행 policy를 바로 올리는 일이 아닙니다. 먼저 제한된 관절 명령에서 simulator와 hardware의 target–actual–torque 시간축을 같은 형식으로 수집하는 것입니다. 그 데이터가 생겨야 actuator와 delay의 nominal model을 좁히고, domain randomization 범위를 추측이 아니라 측정으로 정할 수 있습니다.
함께 읽기: Physical AI 프로젝트의 전체 파이프라인 · 로봇 강화학습 환경 읽기 · WBC와 강화학습은 무엇이 다른가 · 보행 정책의 생존율만으로는 평가할 수 없는 것들 · G1 보행 정책을 어떻게 학습하고 있는가
참고 자료: Domain Randomization for Transferring Deep Neural Networks from Simulation to the Real World · Learning Agile and Dynamic Motor Skills for Legged Robots · Learning to Walk in Minutes Using Massively Parallel Deep Reinforcement Learning · Isaac Lab Direct RL environment and event configuration
기술 기준 시점: 2026-07-21. 현재 상태와 수치는 origin/main@ee4d96e의 G1 asset·actuator config, zero-policy trace 기록, motion-tracking randomized evaluation과 디렉터리 manifest를 기준으로 작성했습니다. M69 결과는 시뮬레이션 강건성 평가이며 실물 G1 전이 결과가 아닙니다.