G1의 넘어짐 판정 높이를 0.60m에서 0.45m로 낮춰 본 적이 있습니다. 첫 종료 시점은 1.263초에서 1.380초로 늦어졌습니다. 그러나 목표였던 4초 정지는 회복되지 않았습니다. 루트 높이 자체를 0.75m부터 0.92m까지 바꿔도 결과는 1초대에 머물렀습니다. 종료 기준을 느슨하게 만들면 로봇이 더 오래 서는 것처럼 보일 수는 있지만, 무너지는 동역학이 고쳐지는 것은 아니었습니다.
이 실험 뒤 학습용 높이 기준을 0.25m로 더 낮추자 변화가 하나 생겼습니다. 이전에는 16개 환경 모두 높이 조건으로 끝났지만, 새 기준에서는 16개 모두 기울기 조건으로 끝났습니다. 첫 종료 시점도 0.92초에서 1.28초로 늘었습니다. 겉으로 보면 생존 시간이 개선된 듯하지만, 실제로는 쓰러지는 궤적을 조금 더 길게 수집한 것이었습니다. 바뀐 것은 로봇의 안정성이 아니라 마지막 전이에 붙은 라벨이었습니다.
그래서 이 글에서는 termination, timeout, reset을 환경 설정 항목으로만 다루지 않습니다. 이 세 값이 PPO에 들어가는 데이터의 경계와 가치 추정, 벡터 환경의 평가 결과를 어떻게 바꾸는지 현재 G1 구현을 따라가며 설명합니다.
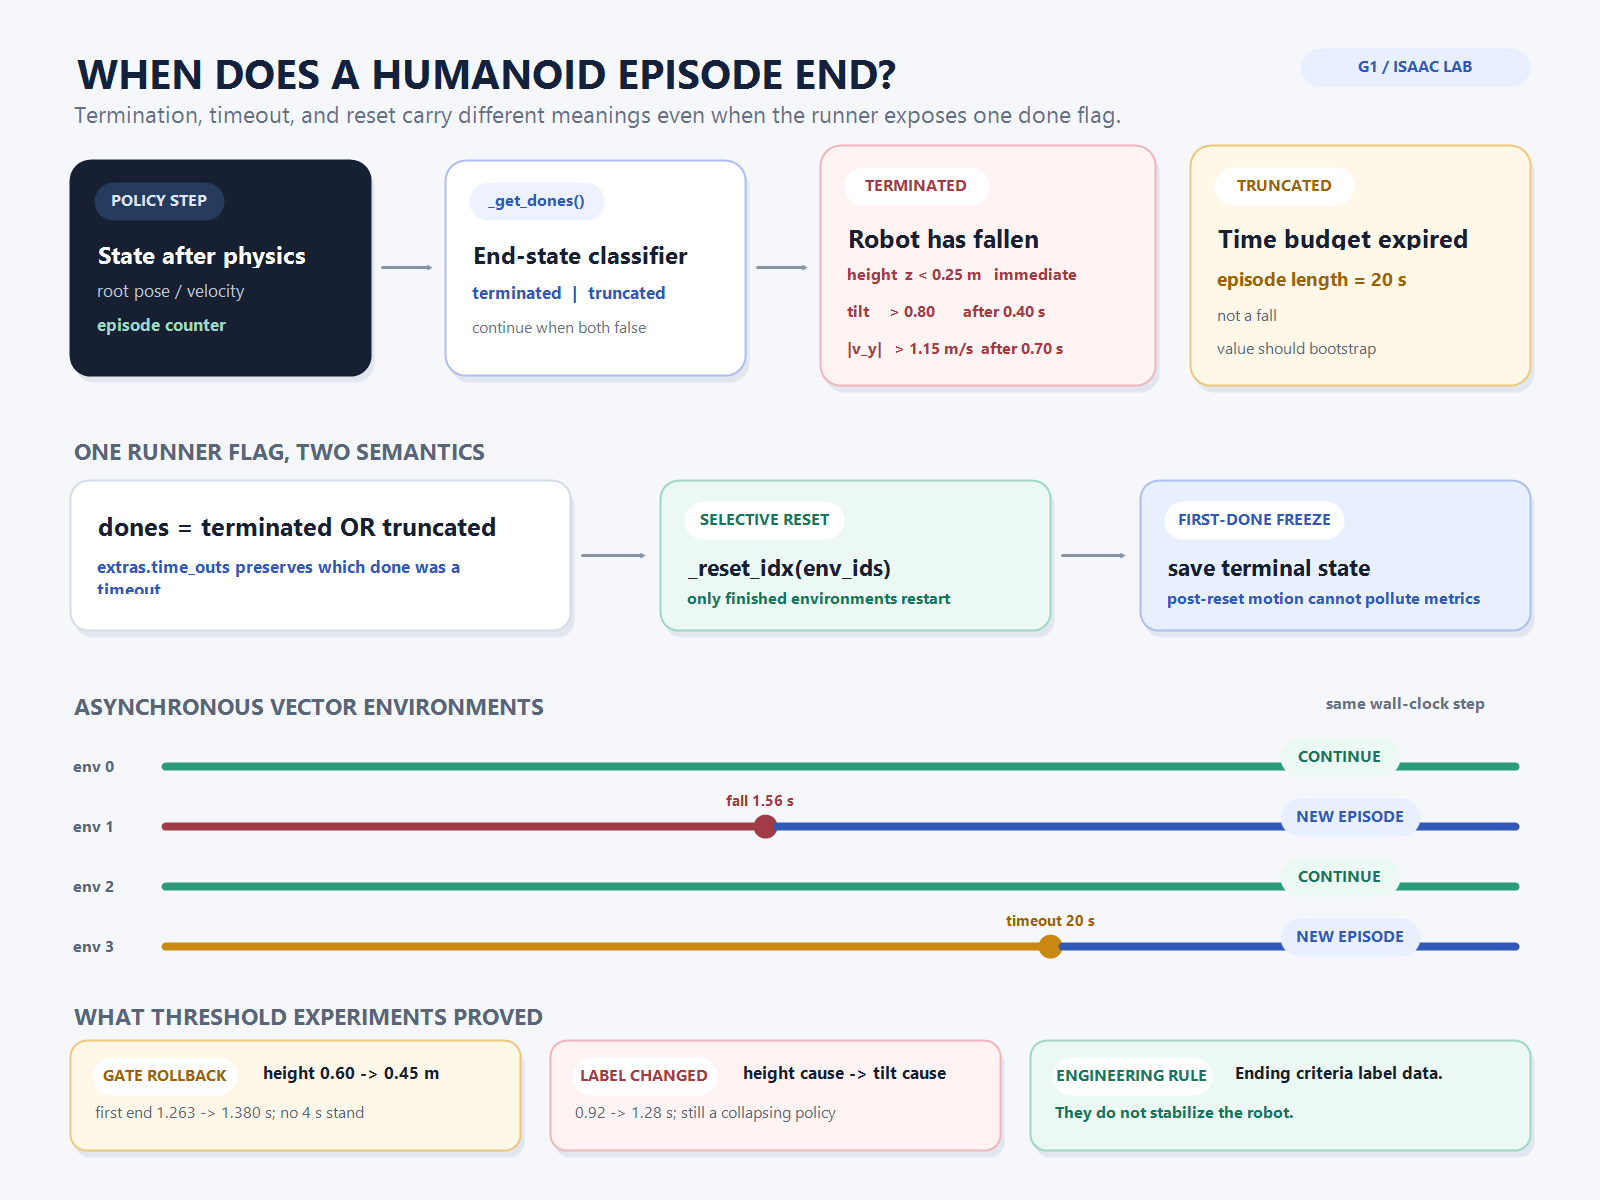
done 신호 뒤에는 서로 다른 두 의미가 있습니다. 넘어짐은 MDP의 종단 상태이고, 20초 timeout은 수집 예산이 끝난 것입니다. 둘을 합쳐 전달하더라도 학습과 평가에서는 다시 구분할 수 있어야 합니다.에피소드 종료는 물리 제어가 아니라 데이터 경계를 정하는 일입니다
로봇이 실제로 넘어지는 과정은 접촉력, 관성, 관절 토크, 지지 다각형, 제어 주기가 만듭니다. 종료 조건은 그 과정을 안정화하지 않습니다. 특정 상태를 관측한 뒤 “이 전이를 에피소드의 마지막으로 기록할 것인가”를 결정합니다. 즉 제어기보다 데이터 수집기의 책임에 가깝습니다.
이 구분을 놓치면 두 가지 잘못된 판단이 생깁니다. 기준을 느슨하게 한 뒤 평균 에피소드 길이가 늘어난 것을 보행 성능 개선으로 해석할 수 있고, 반대로 기준을 엄격하게 한 뒤 조기 종료가 늘어난 것을 정책 퇴화로 해석할 수 있습니다. 같은 정책도 종료 라벨에 따라 생존 시간과 낙상률이 달라집니다. 그래서 G1 학습 방법을 정리한 글에서 말한 정책 성능과 환경 판정 기준은 분리해 추적해야 합니다.
terminated와 truncated는 왜 다른가
Gymnasium의 time-limit 설명은 에피소드 끝을 두 종류로 나눕니다. terminated는 환경이 정의한 종단 상태에 도달한 경우입니다. G1에서는 넘어짐이 여기에 해당합니다. truncated는 로봇 상태와 무관한 외부 한계 때문에 수집을 끊은 경우입니다. 20초 제한이 대표적입니다.
| 구분 | 현재 G1에서의 의미 | 다음 상태 가치 | 평가 표기 |
|---|---|---|---|
terminated |
높이·기울기·횡속도 조건으로 낙상 판정 | 종단 상태이므로 부트스트랩하지 않음 | fall |
truncated |
20초 episode budget 소진 | 환경 상태는 계속될 수 있으므로 부트스트랩 | timeout |
reset |
종료된 환경을 초기 상태로 되돌림 | 새 에피소드의 첫 상태 | 이전 에피소드와 분리 |
PPO의 return을 단순화하면 마지막 전이의 목표는 r + gamma × V(next_state)입니다. 실제 낙상이라면 다음 상태 가치 항을 제거합니다. 반면 시간 제한은 MDP의 진짜 종단 상태가 아니므로 가치 항을 유지해야 합니다. 두 경우를 모두 하나의 done=True로 처리해 가치 함수를 0으로 만들면, timeout 직전의 정상 상태를 실제 실패처럼 학습할 수 있습니다. PPO 소개글에서 다룬 GAE와 value target이 종료 의미에 민감한 이유입니다.
현재 G1은 세 가지 신호로 낙상을 판정합니다
G1WalkEnv._get_dones()는 루트 높이, 몸체 기울기, body-frame 횡속도를 각각 검사합니다. 세 조건 가운데 하나라도 참이면 fell이 됩니다. 현재 설정값은 다음과 같습니다.
| 판정 신호 | 기준 | 적용 시점 | 잡으려는 실패 |
|---|---|---|---|
| root height | z < 0.25m |
즉시 | 몸체가 지면 가까이 내려앉은 상태 |
| tilt | tilt_xy > 0.8 |
0.4초 이후 | roll·pitch 방향의 큰 기울기 |
| lateral velocity | |v_y_body| > 1.15m/s |
0.7초 이후 | 옆으로 빠르게 미끄러지며 무너지는 상태 |
기울기는 base quaternion으로 중력 벡터를 몸체 좌표계로 돌린 뒤, 수평 성분 제곱합으로 계산합니다. 횡속도 역시 world velocity를 body frame으로 변환한 뒤 y 성분을 사용합니다. 로봇이 yaw 방향으로 회전해도 몸체 기준의 옆 미끄러짐을 같은 의미로 읽기 위한 선택입니다. 좌표계 변환 자체는 G1 좌표계 정리글에 따로 정리했습니다.
여기서 grace를 디바운싱 시간으로 오해하면 안 됩니다. 현재 코드는 기울기가 0.4초 동안 연속으로 기준을 넘었는지 검사하지 않습니다. 에피소드 시작 후 0.4초가 지나기 전에는 기울기 종료를 비활성화하고, 이후에는 한 스텝만 초과해도 종료합니다. 횡속도의 0.7초도 같은 방식입니다. spawn 직후의 과도 상태를 허용하는 시작 유예 시간이지, 지속 시간을 재는 누적 타이머가 아닙니다.
왜 높이는 즉시 보고 기울기와 횡속도에는 유예 시간을 두었는가
높이 0.25m는 자연 정지 높이 약 0.835m와 멀리 떨어져 있습니다. 이 정도로 내려앉았다면 초기 자세 오차라기보다 이미 명확한 붕괴 상태에 가깝습니다. 반면 spawn 직후에는 관절이 settling되면서 짧은 기울기나 속도 스파이크가 생길 수 있습니다. 이를 첫 수십 스텝의 낙상으로 기록하면 정책이 행동을 내기도 전에 에피소드가 잘립니다.
현재 물리 스텝은 5ms이고 정책 스텝은 20ms입니다. 따라서 0.4초는 정책 스텝 20개, 0.7초는 35개에 해당합니다. 다만 구현은 sim.dt × render_interval로 이 값을 환산합니다. Isaac Lab의 physics step·decimation·rollout 길이 글에서 지적했듯 렌더 간격과 제어 간격이 갈라지면 이 계산도 어긋날 수 있습니다. 다음 수정에서는 환경의 정식 policy step 값과 max_episode_length를 기준으로 바꾸고, 경계 스텝을 단위 테스트할 필요가 있습니다.
20초 timeout은 낙상이 아닙니다
현재 episode length는 20초입니다. 50Hz 정책 주기에서는 1,000번의 action step입니다. 이 한계에 도달하면 time_out=True를 반환합니다. 로봇이 서 있든 걷고 있든 수집 예산이 끝났기 때문에 새 에피소드로 넘어갑니다.
평가 시나리오가 15초라면 끝까지 살아남은 정책은 낙상률 0%와 15초 episode length를 기록할 수 있습니다. 그러나 그것만으로 보행 성공은 아닙니다. 실제 v92 정책은 15초 동안 낙상하지 않고 4.748m 이동했지만 두 발 접촉 비율이 1.0이었고, air time과 step frequency는 모두 0이었습니다. 두 발을 붙인 채 미끄러진 것입니다. 생존·timeout 통과와 보행 acceptance를 분리해야 하는 이유입니다.
벡터 환경에서는 끝난 로봇만 reset합니다
Isaac Lab은 수천 개 환경을 같은 GPU에서 병렬로 진행합니다. env 1이 1.56초에 넘어졌다고 env 0, 2, 3까지 함께 처음으로 돌리면 아직 유효한 rollout을 버리게 됩니다. 그래서 _reset_idx(env_ids)는 종료된 환경 인덱스만 받습니다. Isaac Lab 환경 설계 문서도 termination과 time-out tensor를 따로 만들고, 선택된 환경 인덱스만 reset하는 구조를 설명합니다.
현재 G1 reset은 단순히 로봇 위치만 되돌리지 않습니다. 선택된 환경에 대해 root pose와 velocity, joint position과 velocity를 기본값으로 쓰고, 새 command를 다시 샘플링합니다. 그 뒤 이전 action, joint velocity history, 발 접촉 횟수, air time, double-support와 single-support 누적값까지 초기화합니다. 이 가운데 하나라도 남으면 새 에피소드의 첫 보상과 관측에 이전 실패의 기억이 섞입니다.
done env_ids
  -> reset robot root / joint state
  -> sample next command
  -> clear action and velocity history
  -> clear contact / air-time / support counters
  -> start a new episode only for those env_ids
이 비동기 구조 때문에 에피소드 데이터 스키마에는 environment id, episode id, step index가 모두 필요합니다. 단순히 wall-clock 순서로 저장하면 서로 다른 로봇 인스턴스와 reset 이후 구간이 한 trajectory처럼 섞일 수 있습니다.
runner가 done을 합쳐도 evaluator는 다시 의미를 복원해야 합니다
현재 RSL-RL wrapper는 terminated | truncated를 계산해 하나의 dones tensor로 정책 runner에 전달합니다. recurrent policy state는 두 경우 모두 reset해야 하므로 이 합친 신호가 필요합니다. 동시에 extras["time_outs"]를 남겨 어떤 done이 시간 제한이었는지 보존합니다.
dones = terminated | truncated
terminated_for_metric = dones & ~extras["time_outs"]

policy.reset(dones)       # 둘 다 새 episode
fall_rate += terminated # timeout은 fall이 아님eval_policy.py처럼 둘을 합친 값만 세면 episode 종료 횟수는 알 수 있어도 낙상률은 알 수 없습니다. 현재 G1 전용 eval_rl.py는 time_outs를 제외한 종료만 fell로 집계합니다. 이 차이는 출력 열 하나의 문제가 아니라 "정책이 실패했는가, 평가 시간이 끝났는가"를 구분하는 실험 정의의 문제입니다.
reset 이후 상태를 terminal state로 읽었던 평가 오류
벡터 환경은 done을 반환하는 같은 step 안에서 해당 환경을 reset할 수 있습니다. evaluator가 그 다음에 robot root pose를 읽으면 낙상 직전 자세가 아니라 새 spawn 자세를 보게 됩니다. 종료 시점의 높이, 기울기, 횡속도를 기록하려 했지만 정상적인 초기 상태가 남는 식의 오류가 생깁니다.
이를 막기 위해 현재 환경은 _get_dones()에서 종료 직전 root pose·quaternion·linear velocity·angular velocity·CoM·joint state·torque·foot contact를 _last_termination_* 버퍼에 복사합니다. debug_g1_motion_trace.py는 terminated mask에 대해 이 스냅샷을 우선 사용합니다. reset된 상태로 실패 원인을 재계산하지 않기 위해서입니다.
평가 누적 방식도 고쳤습니다. 예전에는 한 환경이 일찍 넘어져 reset된 뒤 남은 평가 시간 동안 새 에피소드의 이동량까지 같은 결과에 더해질 수 있었습니다. 지금은 각 환경의 첫 done에서 finished_envs를 고정하고, 이후 step은 그 환경의 metric에서 제외합니다. 이 "first-done freeze"가 없으면 5초 평가 안에 1초짜리 실패 에피소드가 여러 개 이어져 displacement와 episode length가 실제보다 이상하게 커질 수 있습니다.
v33: 횡속도 종료 조건은 실패를 더 정확히 잘랐지만 보행을 고치지 못했습니다
v24, v29, v32를 같은 walk_forward_slow 조건에서 비교했을 때 첫 종료 직전 body-frame 횡속도는 모두 1.29m/s를 넘었습니다. 높이와 기울기만으로는 옆으로 빠르게 붕괴하는 구간을 늦게 자르고 있었습니다. 그래서 v33에서 0.7초 이후 |v_y_body| > 1.15m/s 조건을 추가했습니다.
| 버전 | 첫 done | 종료 직전 body vy | 관찰 |
|---|---|---|---|
| v24 | 1.555s | -1.298m/s | 7개 환경 double contact |
| v29 | 1.483s | -1.528m/s | roll 0.679rad까지 증가 |
| v32 | 1.603s | -1.480m/s | 평균 displacement 0.680m |
| v33 | 약 1.56s | -1.041m/s | 횡속도로 더 이르게 분류했지만 fall 100% |
v33은 실패 라벨을 개선했습니다. 전진량과 velocity tracking은 어느 정도 유지하면서 옆으로 이탈하는 rollout을 더 일관되게 끊었습니다. 하지만 gait score는 0.715, torque RMS는 222Nm였고 낙상률은 100%였습니다. 종료 조건이 drift와 비대칭을 진단하기 쉬워졌을 뿐, 원인을 제거하지는 못했습니다.
v80과 v90: threshold를 바꾸는 실험이 알려 준 것
v80에서는 evaluation 높이 기준만 runtime에서 바꿔 같은 zero-policy 상태를 검사했습니다.
| base_height_min | 첫 낙상 | 해석 |
|---|---|---|
| 0.60m | 1.263s | 엄격한 성공 기준에서 조기 검출 |
| 0.50m | 1.346s | 종료만 0.083초 지연 |
| 0.45m | 1.380s | 4초 stand gate는 여전히 실패 |
반면 ankle nominal을 -0.30rad에서 -0.15rad로 바꾸자 첫 낙상이 1.26초에서 2.30초로 늘었습니다. 최적 조합도 2.70초에 그쳤지만, termination threshold보다 초기 관절 자세가 훨씬 강한 레버라는 사실은 드러났습니다. 그래서 당시 결론은 PPO 재개가 아니라 공식 asset의 발 geometry, spawn height, nominal pose 호환성을 먼저 확인하는 것이었습니다.
v90에서는 학습 termination과 평가 success를 아예 분리했습니다. 학습은 base_height_min=0.25m로 충분한 붕괴 구간을 수집하고, 평가는 0.60m의 자세 기준을 유지했습니다. 공식 nominal pose를 맞춘 P0에서 첫 종료는 0.92초에서 1.14초로 늘었고, permissive training termination을 적용한 P1에서는 1.28초까지 갔습니다. 종료 원인은 height 16/16에서 tilt 16/16으로 바뀌었습니다. 이 결과는 학습을 시작할 최소 sanity gate는 통과했다는 뜻이지, 걷기 성공을 뜻하지 않았습니다.
학습 termination과 평가 acceptance는 일부러 달라야 합니다
학습에서는 너무 이른 종료가 회복 행동과 붕괴 직전 상태를 보지 못하게 할 수 있습니다. 따라서 명확히 위험한 상태까지 rollout을 허용하는 느슨한 기준이 유리할 수 있습니다. 반대로 평가는 사용자가 기대하는 자세와 안전 수준을 엄격히 확인해야 합니다. 현재 0.25m와 0.60m의 차이는 설정 불일치가 아니라 두 책임을 분리하려는 선택입니다.
다만 코드 주석에는 과거의 0.60m 설명과 현재 0.25m 값이 가까이 남아 있어 오해하기 쉽습니다. 이런 값은 "낙상 기준" 하나로 이름 붙이기보다 training_collapse_height와 eval_success_height처럼 역할이 드러나게 분리하는 편이 낫습니다. 로봇 강화학습 환경의 observation·action·reward·termination 글에서 termination을 네 번째 구성 요소로 설명했지만, 실제 프로젝트에서는 train/eval의 판정 책임까지 나눠야 합니다.
현재 구현에서 확인된 것과 아직 남은 일
| 항목 | 상태 | 근거 또는 남은 문제 |
|---|---|---|
| 높이·기울기·횡속도 낙상 분류 | 구현됨 | _get_dones()에서 원인별 buffer 저장 |
| termination과 timeout 분리 | 구현됨 | extras.time_outs로 evaluator가 복원 |
| 선택적 vector reset | 구현됨 | 종료된 env_ids의 상태와 history만 초기화 |
| terminal snapshot 보존 | 구현됨 | reset 전 _last_termination_* 저장 |
| first-done metric freeze | 구현·검증됨 | post-reset 구간의 평가 오염 방지 |
| grace와 timeout의 시간 기준 | 개선 필요 | render_interval 대신 policy step 정본 필요 |
| 모든 evaluator의 의미 통일 | 미완 | 일반 eval_policy.py는 done을 하나로 합침 |
| 안정 보행 | 미완 | 종료 체계가 정리돼도 제어·접촉 문제는 별도 |
다음 실험은 threshold를 더 찾는 일이 아닙니다
다음에는 같은 checkpoint를 여러 threshold로 평가해 "정책 변화"와 "판정 변화"를 완전히 분리할 생각입니다. 각 환경에 대해 높이·기울기·횡속도의 최초 crossing 시간을 모두 기록하고, 최종 cause는 상호 배타적으로 저장합니다. 50Hz 기준 20·35번째 스텝의 grace 경계를 단위 테스트하고, decimation이나 render 설정이 바뀌어도 같은 초 단위가 유지되는지 확인해야 합니다.
timeout 처리도 runner까지 추적할 필요가 있습니다. 20초에서 끝난 정상 상태가 value bootstrap에 실제로 반영되는지, recurrent state는 done에서 초기화되면서도 return target은 timeout 정보를 사용하는지 확인합니다. 데이터셋에는 terminated, truncated, termination_cause, terminal_observation을 별도 필드로 남길 것입니다.
이 작업이 끝나야 "에피소드가 길어졌다"는 문장을 성능 개선이라고 쓸 수 있습니다. 지금까지 확인한 결론은 더 단순합니다. 종료 기준은 로봇을 세우지 않습니다. 다만 실패를 어디서 자르고, 무엇으로 이름 붙이며, PPO와 evaluator에 어떤 마지막 상태를 넘길지는 정확하게 만듭니다.