M144의 actor isolation audit에서는 M15 network weight와 observation normalizer를 모두 고정했습니다. lower body·waist·wrist에 해당하는 21개 action row도 학습 대상에서 제외했습니다. 그런데 여덟 개 arm command만 바꾸자 “고정했다”고 생각한 21개 output이 전부 달라졌습니다. raw action의 최대 차이는 0.2913이었습니다.
원인은 weight update가 아니었습니다. arm의 관절 위치와 속도가 달라지면서 M15가 받는 160차원 observation 가운데 앞쪽 58개 값이 달라졌고, 고정된 normalizer와 고정된 MLP가 그 새로운 입력에 반응했습니다. 이 사건은 정책 drift를 볼 때 model weight만 비교해서는 안 된다는 사실을 보여 줬습니다. raw observation, running statistics, network weight는 서로 다른 상태입니다.
PPO checkpoint와 resume 글에서는 normalizer가 actor·critic state 안에 저장된다는 점을 설명했습니다. 이번에는 그 안쪽을 봅니다. running mean과 variance는 무엇을 계산하는지, 학습과 평가에서 언제 갱신되며, 현재 G1 motion-tracking 경로가 왜 actor normalizer를 고정하거나 입력을 둘로 나눴는지 정리합니다.
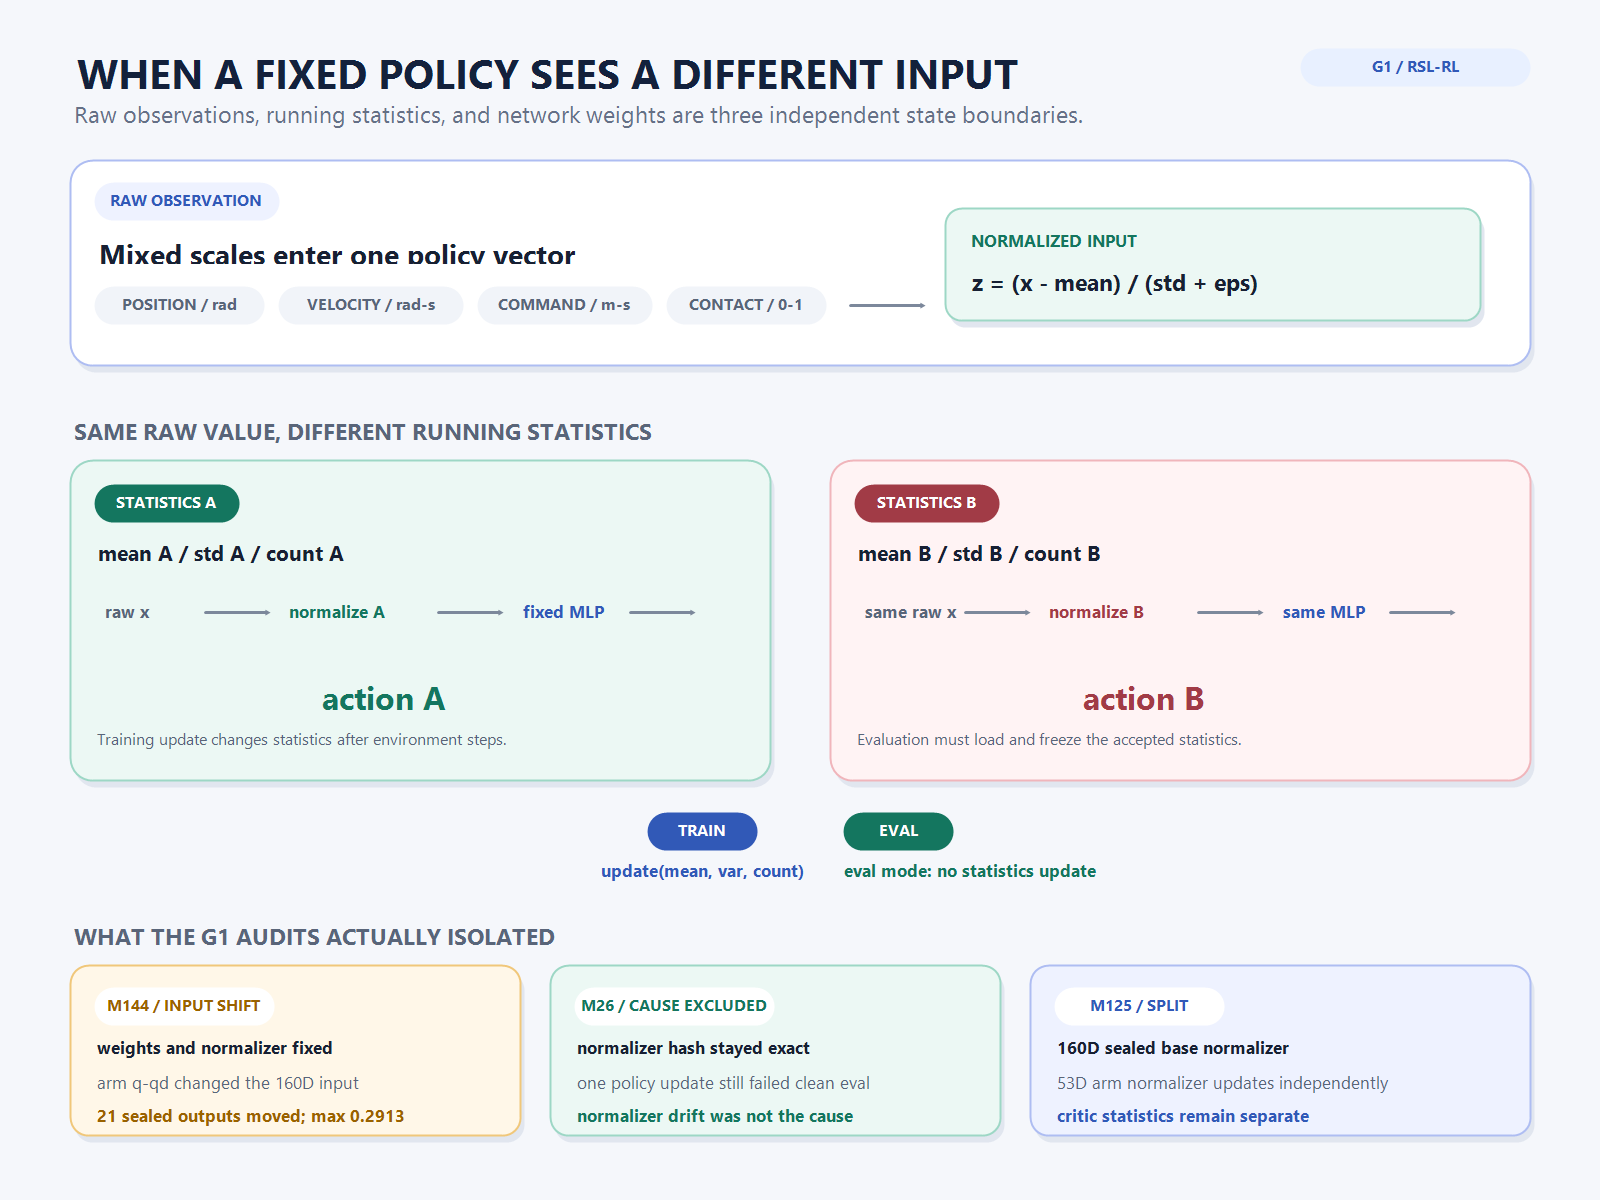
observation normalization은 단위를 없애는 전처리입니다
로봇 policy의 observation 한 줄에는 서로 다른 물리량이 섞입니다. 관절 위치는 rad, 관절 속도는 rad/s, 몸통 선속도와 command는 m/s, projected gravity와 접촉 flag는 무차원 값입니다. 강화학습 환경의 observation 계약이 어떤 정보를 보여 줄지를 정한다면, normalization은 그 정보가 network에 들어갈 수치 범위를 맞춥니다.
z_i = (x_i - mean_i) / (std_i + epsilon)x_i는 i번째 raw observation, mean_i와 std_i는 지금까지 관찰한 값의 running statistics입니다. 평균 부근의 값은 0 근처로 이동하고, 한 standard deviation 차이는 대략 ±1 규모가 됩니다. 이것은 각 물리량의 의미를 바꾸는 좌표 변환이 아닙니다. rad가 m/s로 바뀌는 것이 아니라, network가 서로 다른 scale을 가진 feature를 비슷한 수치 범위에서 다룰 수 있게 하는 계산입니다.
정규화하지 않아도 MLP가 이론적으로 scale 차이를 학습할 수는 있습니다. 그러나 큰 magnitude의 velocity와 작은 contact·phase signal이 같은 first layer에 들어가면 gradient와 activation scale이 feature마다 다르게 형성됩니다. observation normalization은 이 부담을 줄이지만, 잘못된 observation 정의나 좌표계를 고쳐 주지는 않습니다. body-frame 전진과 world-frame 후진을 혼동한 입력은 평균 0으로 만들더라도 여전히 의미가 틀립니다.
RSL-RL은 batch별 통계를 기존 running state에 합칩니다
RSL-RL의 EmpiricalNormalization은 feature마다 _mean, _var, _std, count를 buffer로 가집니다. 새 batch가 들어오면 batch mean과 variance를 계산한 뒤 기존 통계와 결합합니다. 현재 구현의 핵심은 다음과 같습니다.
count += batch_size
rate = batch_size / count

mean += rate * (batch_mean - mean)
var  += rate * (batch_var - var
                + delta_mean * (batch_mean - updated_mean))
std = sqrt(var)count는 episode 수나 PPO iteration 수가 아닙니다. normalizer가 본 environment row의 수입니다. 4,096개 환경을 한 step 진행해 observation을 갱신하면 한 번에 4,096씩 증가합니다. 24-step rollout이라면 최대 98,304개의 row가 running statistics에 반영됩니다. vector rollout의 시간축과 normalizer의 시간축을 함께 기록해야 하는 이유입니다.
초기에는 mean=0, variance=1, count=0에서 시작합니다. 첫 batch가 통계에 큰 영향을 주고, count가 커질수록 같은 크기의 새 batch가 주는 변화는 작아집니다. 오래 학습한 policy의 normalizer를 초기화하면 network weight는 그대로여도 입력 좌표계가 학습 초기 상태로 되돌아갑니다. 반대로 오래된 통계를 무조건 고정하면 새로운 task distribution이 실제로 바뀌었을 때 새 feature 범위를 제대로 표현하지 못할 수 있습니다.
통계는 forward가 아니라 environment step 뒤에 갱신됩니다
RSL-RL PPO 구현의 기본 흐름은 actor가 현재 observation으로 action을 만든 다음 environment를 진행하고, 새 observation을 받은 뒤 process_env_step()에서 actor와 critic의 update_normalization()을 호출합니다. 즉 현재 action을 만든 통계와 그 action 결과로 수집된 새 observation을 반영한 통계 사이에는 한 step의 순서가 있습니다.
action_t = actor(normalize(obs_t))
obs_(t+1), reward, done = env.step(action_t)

actor.update_normalization(obs_(t+1))
critic.update_normalization(obs_(t+1))
이 순서는 PPO rollout을 해석할 때 중요합니다. 저장된 obs_t와 old log-probability는 그 시점의 policy·normalizer 상태에서 생성됐습니다. update 과정에서 같은 rollout을 다시 계산할 때 normalizer가 중간에 바뀌면 old와 new policy ratio에 observation transform 차이까지 섞일 수 있습니다. 현재 RSL-RL은 rollout 수집 중 step 단위로 통계를 갱신한 뒤, 저장된 batch를 update에 사용합니다. 그래서 한 update의 수치 재현을 보려면 actor weight뿐 아니라 그 rollout 종료 시점의 normalizer state도 함께 봐야 합니다.
actor와 critic은 같은 통계를 공유한다고 가정하면 안 됩니다
actor는 실제 실행 때 사용할 policy observation을 받고, critic은 학습 중에만 허용되는 privileged observation을 받을 수 있습니다. 두 입력의 차원과 feature 분포가 다르면 mean과 variance도 달라야 합니다. RSL-RL 5 계열은 actor와 critic을 별도 model로 만들고 각각 obs_normalizer를 가집니다. PPO는 environment step 뒤 두 normalizer를 따로 갱신합니다.
| 경로 | 입력 목적 | normalizer 책임 | 배포 시 필요 여부 |
|---|---|---|---|
| actor | 관측에서 action 생성 | policy observation의 mean·variance | 필수 |
| critic | value·advantage 기준선 계산 | critic observation의 mean·variance | actor-only 추론에는 불필요 |
| teacher actor | distillation·보존 기준 | teacher가 학습될 때 사용한 통계 | teacher를 실행할 때 필수 |
| residual actor | 추가 feature로 제한된 action 수정 | 새 feature 집합 전용 통계 또는 명시적 고정 | residual을 실행할 때 필수 |
critic normalizer가 계속 갱신돼도 actor의 deterministic action이 직접 바뀌지는 않습니다. 대신 value와 advantage가 달라져 다음 actor update에 간접적으로 영향을 줄 수 있습니다. 그래서 “actor normalizer만 같으면 training이 같다”는 주장도 부족합니다. 추론 재현과 학습 재현은 확인해야 할 상태 범위가 다릅니다.
train mode와 eval mode가 running statistics의 문을 여닫습니다
EmpiricalNormalization.update()은 module의 training flag가 false이면 즉시 반환합니다. PyTorch에서 module.eval()은 train(False)와 같고, submodule에도 evaluation mode가 전파됩니다. PyTorch Module 문서에서 설명하는 이 상태는 gradient 계산 여부와 별개입니다.
현재 motion-tracking evaluator는 checkpoint를 불러온 뒤 runner.get_inference_policy()를 호출합니다. RSL-RL runner는 그 안에서 algorithm을 eval mode로 전환하고 actor를 반환합니다. 따라서 정상적인 평가 경로에서는 policy를 여러 step 실행해도 actor normalizer의 mean·variance·count가 바뀌지 않아야 합니다.
torch.inference_mode()만 감싸는 것으로는 이 계약을 대신할 수 없습니다. inference mode는 autograd 기록을 막지만 custom normalizer의 training flag를 false로 만들지 않습니다. training 상태의 actor에서 update_normalization()을 직접 호출하면 gradient가 없어도 running buffer는 바뀝니다. 평가 전후 normalizer hash를 확인하는 이유가 여기에 있습니다.
M26에서는 normalizer drift를 실패 원인에서 제외했습니다
M26은 M15 전체 policy를 복제해 recovery 초기 상태를 섞은 한 번의 PPO update를 시험한 branch였습니다. 설계 단계에서 teacher actor와 teacher normalizer를 고정했고, student normalizer도 M15와 정확히 같은 hash에서 시작하도록 강제했습니다. process_env_step()에서는 student actor normalizer를 갱신하지 않고 critic normalizer만 갱신했습니다.
no-PPO gate에서는 4,096개 환경의 첫 rollout이 action bitwise parity, PPO ratio 1, KL 0을 통과했습니다. teacher actor·normalizer hash와 gradient 격리도 확인했습니다. 그러나 98,304 transition의 한 update 뒤 clean 평가 survival은 M15의 100%에서 75%로 떨어졌고, crossing은 0%에서 0.806%, body error는 3.56cm에서 5.11cm, raw action max는 6.979에서 14.722로 악화됐습니다.
이 결과를 “normalization이 틀어졌다”고 설명할 수는 없습니다. normalizer는 hash로 고정됐고 실제로 변하지 않았습니다. actor update authority가 clean behavior를 훼손한 것입니다. normalizer guard의 가치는 모든 실패를 막는 데 있지 않았습니다. 가능한 원인 하나를 정확히 제외해 다음 실험이 learning rate·KL·정책 보존 gate에 집중하게 한 데 있었습니다.
M54는 9.83M transition 동안 입력 변환을 고정했습니다
M54에서는 M50 actor의 trunk, normalizer, lower-body·waist·wrist output, exploration standard deviation을 고정하고 여덟 개 shoulder·elbow output row만 PPO가 바꿀 수 있게 했습니다. 첫 canary는 frozen actor state가 bitwise equal한지 확인했고, 실제 run은 4,096개 환경에서 100 update, 총 9.83M transition을 처리했습니다.
모든 sentinel은 10초 survival 100%와 crossing 0을 유지했습니다. shoulder balance는 0.4760에서 최종 0.6540으로 개선됐습니다. 그래도 목표 0.80에 못 미쳤고, pitch cancellation 0.0545는 기준 0.06689보다 낮았으며 pitch correlation 0.8364는 허용 상한 0.74455보다 높았습니다. M54는 accepted policy가 아니었습니다.
이 실험은 normalizer를 고정하면 behavior가 자동으로 보존된다는 증거가 아닙니다. 다만 9.83M transition 동안 input transform이라는 변수를 고정해, 관찰된 변화가 upper-arm output row와 reward credit에 의해 생겼다고 해석할 수 있는 경계를 만들었습니다. normalizer freeze는 성능 향상 장치가 아니라 인과관계를 좁히는 실험 통제였습니다.
M144는 statistics drift와 observation shift가 다르다는 것을 보여 줬습니다
M125·M126 경로는 M15 lower body·waist·wrist output과 base normalizer를 고정하고 독립적인 여덟 개 arm action을 결합했습니다. 처음에는 output row를 덮어쓰지 않으면 기존 제어가 보존된다고 생각했습니다. M144 audit에서 이 가정이 깨졌습니다.
arm action이 물리 시뮬레이션을 바꾸면 다음 step의 arm joint position·velocity도 바뀝니다. 그 값들은 M15 160차원 input의 일부입니다. M15는 고정된 mean·std로 그 새로운 값을 정규화하고, 고정된 MLP 전체를 통과시킵니다. 따라서 lower-body output row의 weight를 학습하지 않았더라도 lower-body action은 달라질 수 있습니다. 실제 audit에서는 여덟 arm q·qd command channel 변화가 21개 sealed output 전부를 움직였고 최대 raw delta가 0.2913이었습니다.
| 변화 유형 | 달라지는 상태 | 같은 weight에서 action 변화 가능? | 현재 검사 |
|---|---|---|---|
| model drift | MLP parameter·distribution | 가능 | actor hash, row별 delta |
| statistics drift | mean·variance·std·count | 가능 | normalizer hash, buffer 비교 |
| observation shift | raw pose·velocity·command·contact | 가능 | raw feature trace·quantile |
| semantic drift | feature 순서·단위·좌표계 | 가능하며 더 위험 | layout SHA, frame·unit contract |
reset distribution과 randomization은 observation shift를 의도적으로 만듭니다. statistics drift는 그 분포를 running estimator가 따라가며 생깁니다. 두 현상을 분리하지 않으면 “normalizer가 변했다”와 “로봇이 다른 상태를 방문했다”를 같은 원인으로 취급하게 됩니다.
M125는 160차원 base와 53차원 arm 통계를 분리했습니다
M125의 독립 8D arm actor는 입력을 두 부분으로 나눕니다. 앞 160차원은 sealed M15 base policy가 사용하고, 뒤 53차원은 base pose·velocity, 8개 arm joint error·velocity, previous action, phase, support, CAM, contact와 foot-gap 정보를 담은 arm-local observation입니다.
base branch에는 M15 checkpoint의 obs_normalizer state를 base_obs_normalizer로 복사합니다. 이 base normalizer와 base MLP는 frozen contract에 포함됩니다. 새 arm branch는 별도 53차원 obs_normalizer와 MLP를 가지며, update_normalization()은 local arm observation만 잘라 이 통계를 갱신합니다. critic도 자신의 observation 통계를 따로 갱신합니다.
base_obs  = policy_obs[..., :160]
arm_obs   = policy_obs[..., 160:213]

base_mean = frozen_m15_mlp(frozen_base_norm(base_obs))
arm_delta = arm_mlp(updating_arm_norm(arm_obs))

merged_action = base_mean.clone()
merged_action[arm_rows] += arm_delta
이 구조는 새 feature가 M15의 160차원 통계를 오염시키지 않게 했습니다. 하지만 M144가 보여 준 것처럼 물리적으로 달라진 arm state가 다음 step의 base observation 안으로 다시 들어오는 문제까지 막지는 못했습니다. normalizer ownership과 closed-loop state ownership은 별도의 계약입니다.
평가에서는 raw와 normalized observation을 함께 기록해야 합니다
action이 달라졌을 때 actor hash 하나만으로는 원인을 가를 수 없습니다. 현재 코드의 hash guard를 확장한다면 다음 순서가 필요합니다.
| 단계 | 기록할 값 | 가려내는 문제 |
|---|---|---|
| 1. schema | feature 이름·순서·차원·단위·frame SHA | semantic drift |
| 2. raw input | feature group별 mean·std·p01·p50·p99·min·max | observation distribution shift |
| 3. normalizer | buffer hash, count, mean·std 차이 | statistics drift·잘못된 checkpoint |
| 4. normalized input | 절댓값 p99·max, NaN·Inf, saturation 범위 | outlier·scale collapse |
| 5. fixed-tape parity | 동일 raw observation에서 normalized input·action delta | weight와 statistics 원인 분리 |
| 6. eval immutability | 평가 전후 actor·normalizer hash | train/eval mode 누수 |
특히 count를 빼면 mean과 std가 같아 보이는 두 normalizer가 실제로 얼마나 새 batch에 민감한지 알 수 없습니다. count가 작은 branch는 다음 4,096-row batch에서 크게 움직이고, 오래 학습한 branch는 거의 움직이지 않을 수 있습니다. checkpoint 비교에는 현재 통계뿐 아니라 그 통계의 관성도 포함돼야 합니다.
현재 구현 상태와 다음 진단
| 항목 | 상태 | 근거 |
|---|---|---|
| RSL-RL running mean·variance | implemented·executed | actor·critic EmpiricalNormalization 경로 |
| checkpoint normalizer 보존 | implemented·executed | actor·critic state_dict와 hash 검사 |
| evaluation freeze | implemented | get_inference_policy의 eval mode 전환 |
| M26 normalizer 원인 제외 | observed | hash exact 상태에서 clean gate 실패 |
| M54 actor normalizer 고정 학습 | executed, not accepted | 9.83M transition·100 update, morphology gate 실패 |
| M125 base·arm normalizer 분리 | implemented·executed | 160D frozen base와 53D updating arm path |
| 공통 raw·normalized drift report | designed, not fully implemented | 일부 hash·trace는 있으나 모든 run의 공통 gate가 아님 |
다음 진단은 parent와 candidate를 같은 saved observation tape에 통과시키고 네 가지 조합을 비교하는 것입니다. parent weight+parent stats, candidate weight+parent stats, parent weight+candidate stats, candidate weight+candidate stats를 각각 실행하면 weight와 statistics의 action delta를 분해할 수 있습니다. 동시에 live rollout에서는 raw feature group의 quantile을 기록해 observation shift를 별도로 측정해야 합니다.
normalization은 보이지 않는 전처리라서 실패 원인으로 쉽게 지목됩니다. 그러나 M26처럼 통계가 정확히 고정돼도 policy update가 실패할 수 있고, M144처럼 통계와 weight가 모두 고정돼도 closed-loop observation이 달라지면 action이 변합니다. 앞으로는 “같은 모델”이라는 표현 대신 weight·running statistics·raw observation·schema 가운데 무엇이 실제로 같은지 나눠 기록합니다.