
Physical AI를 처음 이해할 때, 로봇에게 무엇을 물어봐야 할까
로봇에게 “앞으로 걸어”라고 말하면, 실제로는 무엇이 그 말을 움직임으로 바꾸는 걸까요? 처음에는 언어를 이해하는 AI 모델 하나를 잘 고르면 될 […]
로봇에게 “앞으로 걸어”라고 말하면, 실제로는 무엇이 그 말을 움직임으로 바꾸는 걸까요? 처음에는 언어를 이해하는 AI 모델 하나를 잘 고르면 될 […]
로봇이 몇 걸음 움직이는 장면을 보면, 사람은 먼저 “됐다”는 말을 하고 싶어집니다. 저 역시 보행 정책을 다룰 때 처음에는 넘어지지
시뮬레이터에서 로봇이 넘어지지 않고 움직이면, 이제 실제 로봇에도 같은 명령을 보내도 될까요? 처음에는 가상 환경에서 동작을 만들면 현실로 옮기는 일은
화면 속 인공지능이 잘 답하는 것과 로봇이 실제로 움직이는 일은 무엇이 다를까요. 로봇은 말을 이해하는 것만으로는 물건을 집거나 균형을 잡을
로봇 연구에서 자주 나오는 ‘정책(policy)’은 무엇일까요. 처음에는 로봇에게 시킬 행동을 순서대로 적어 둔 목록이라고 생각하기 쉽습니다. 하지만 실제로 정책은 현재
실제 로봇을 가상 공간에 그대로 옮겨 놓으면 문제가 줄어들까요. 처음에는 디지털 트윈을 ‘현실과 똑같은 로봇 복사본’처럼 생각했습니다. 그러나 로봇의 몸과
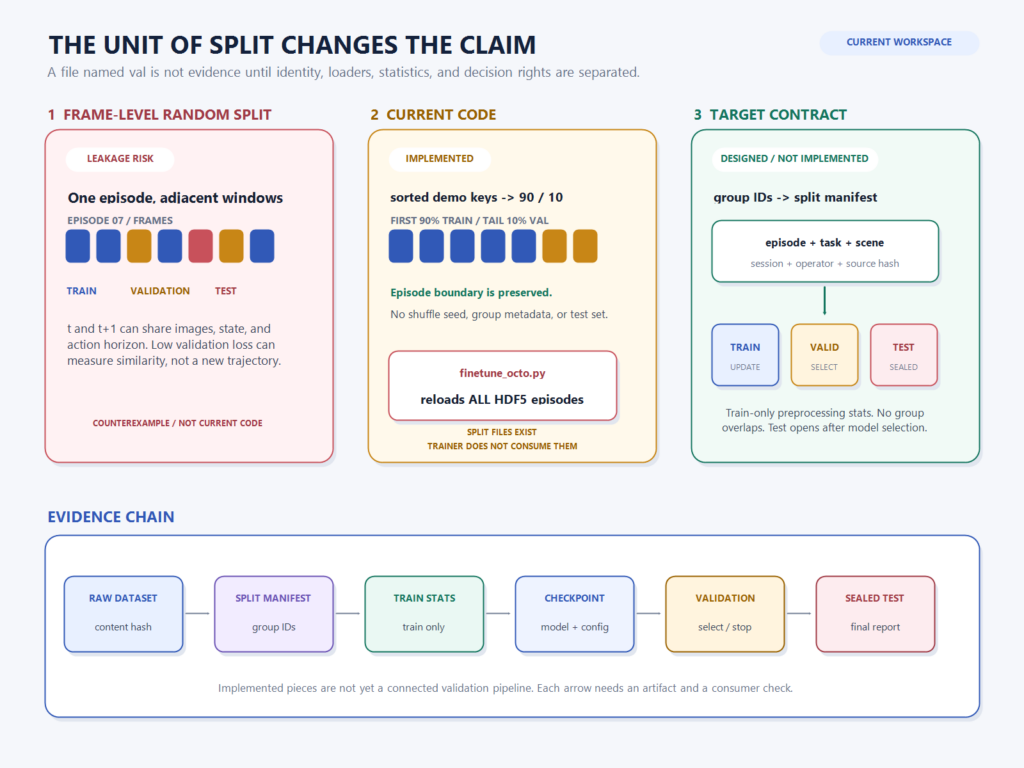
현재 로봇 데이터 변환기와 Octo fine-tuning 경로를 따라 train·validation·test의 역할, episode leakage, train-only 통계와 split manifest의 필요성을 설명합니다.

Epoch·iteration·step을 같은 학습 횟수로 비교하면 왜 틀리는지, 현재 Octo 모방학습과 G1 RSL-RL PPO 코드의 sample·batch·optimizer update 경계를 실제 설정값으로 계산해 정리합니다.
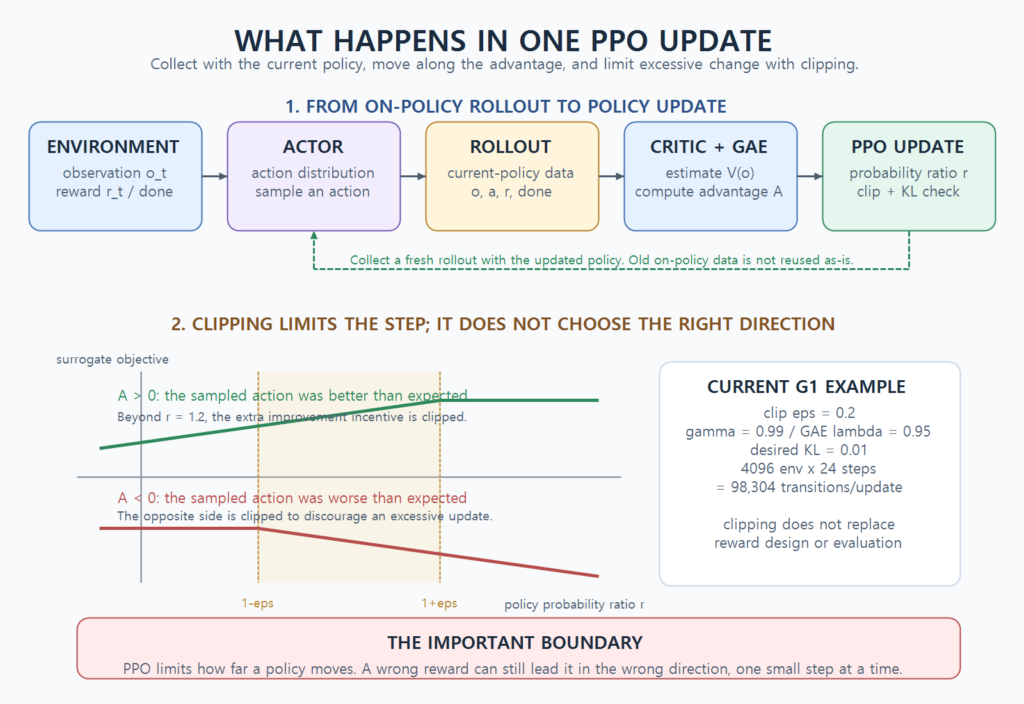
최근 G1 실험에서는 PPO 업데이트를 거친 로봇이 넘어지지 않고 계속 걸었는데도 새 정책을 채택하지 않았습니다. 느린 보행 경로가 기준보다 짧아졌기
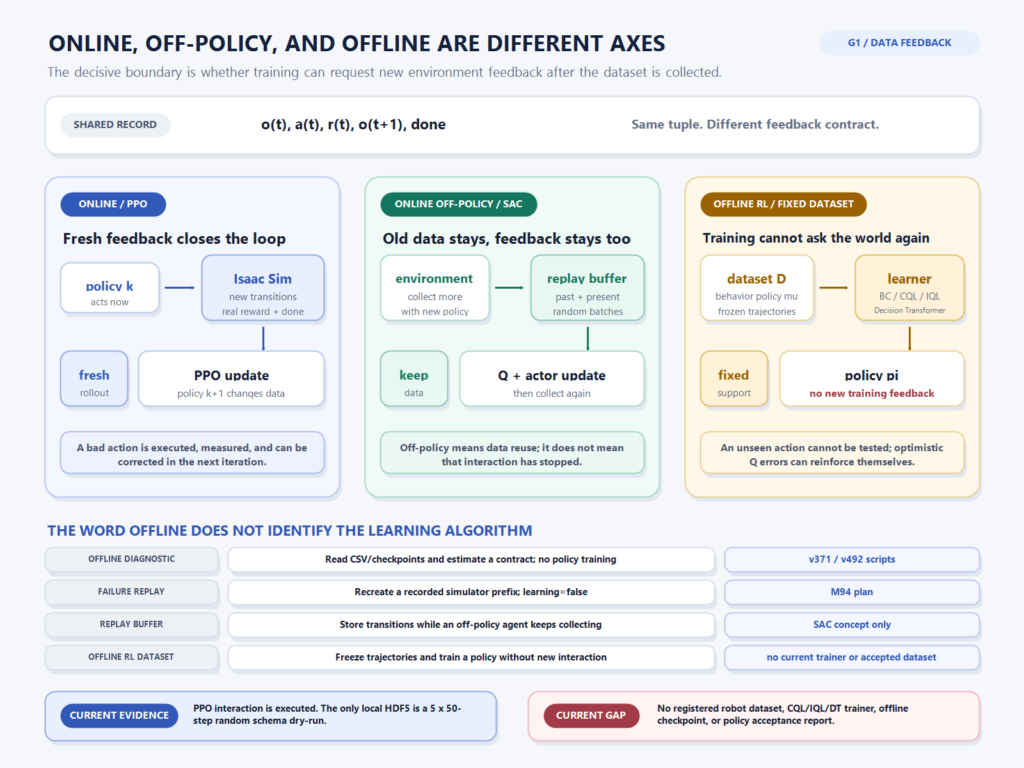
현재 G1 저장소에서 offline과 replay를 검색하면 이미 오프라인 강화학습을 구현한 것처럼 보이는 파일이 나옵니다. offline_control_authority_diagnostic는 checkpoint와 trace를 읽고 action 방향을