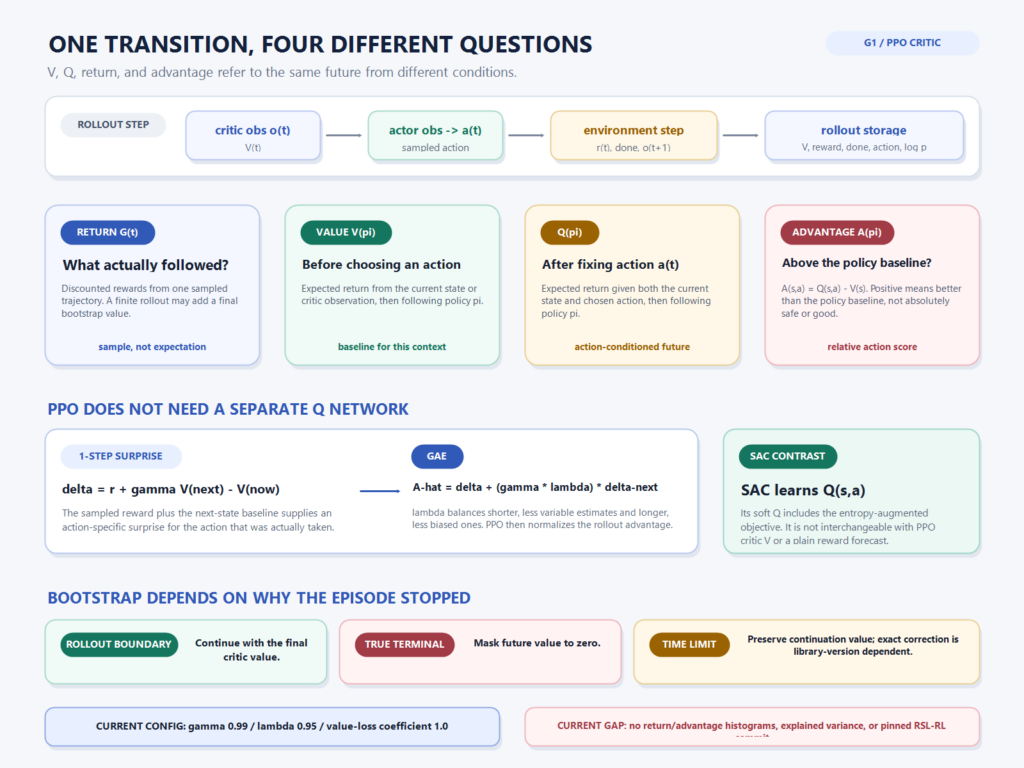
V·Q·Advantage는 무엇이 다른가: G1의 critic은 어떤 미래를 예측하는가
G1 학습 코드를 처음 따라가면서 이상했던 부분이 하나 있었습니다. PPO 설정에는 actor와 critic이 있고, critic의 은닉층 크기와 value loss 계수도 […]
G1 학습 코드를 처음 따라가면서 이상했던 부분이 하나 있었습니다. PPO 설정에는 actor와 critic이 있고, critic의 은닉층 크기와 value loss 계수도 […]
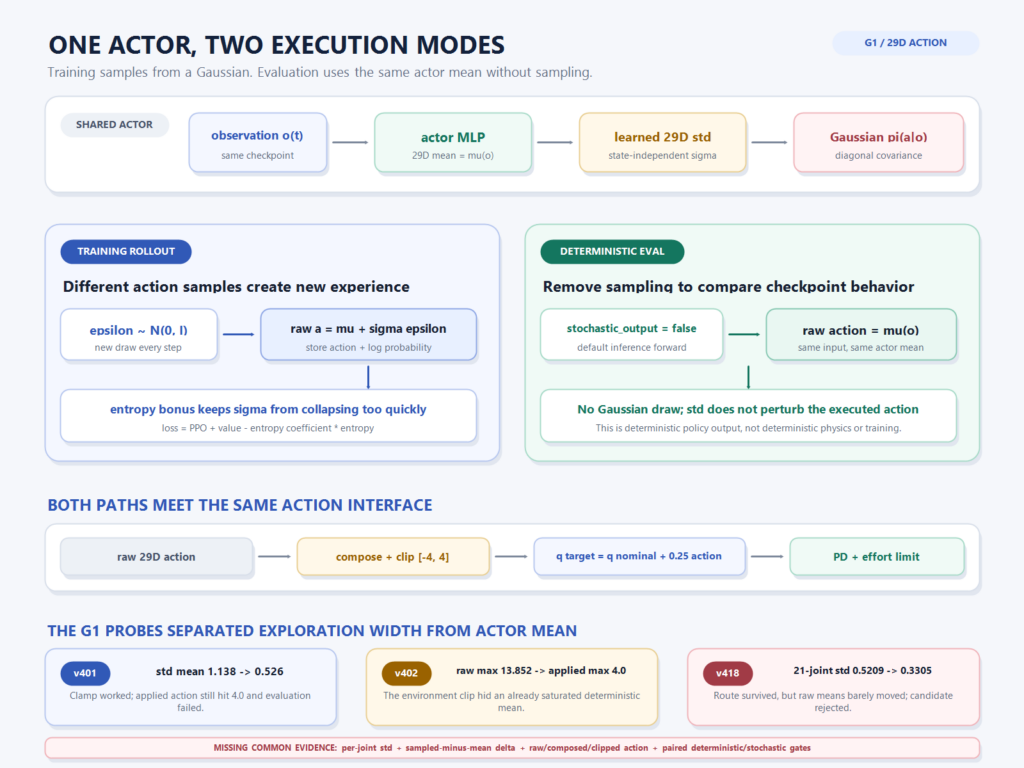
G1의 비정상적인 상체 동작이 큰 탐색 noise 때문인지 확인하려고 v401에서 actor의 standard deviation을 직접 줄였습니다. 전체 std 평균은 1.138에서 0.526으로,
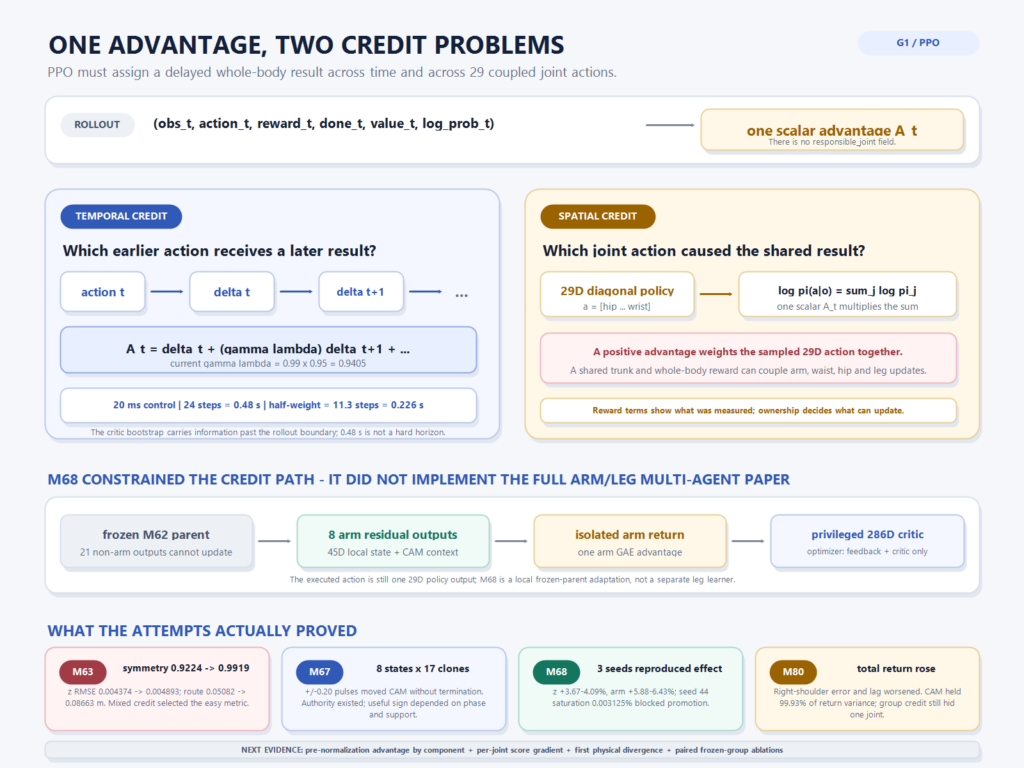
M79에서 오른쪽 어깨만 수정하는 phase head를 125회 PPO update로 학습했습니다. 4,096개 환경에서 1,228만8천 transition을 처리했고, 새 head의 출력은 최대 0.1122까지

G1 actor의 observation 73개를 실물 센서 목록으로 바꿔 적다가 첫 줄에서 막혔습니다. 정책은 20ms마다 body frame의 base linear velocity 3개를

G1 환경 설정에는 policy가 50Hz로 동작한다고 적혀 있습니다. 그런데 router smoke test에서 다섯 step을 실행해 보면 프로그램은 100ms를 기다리지 않습니다.
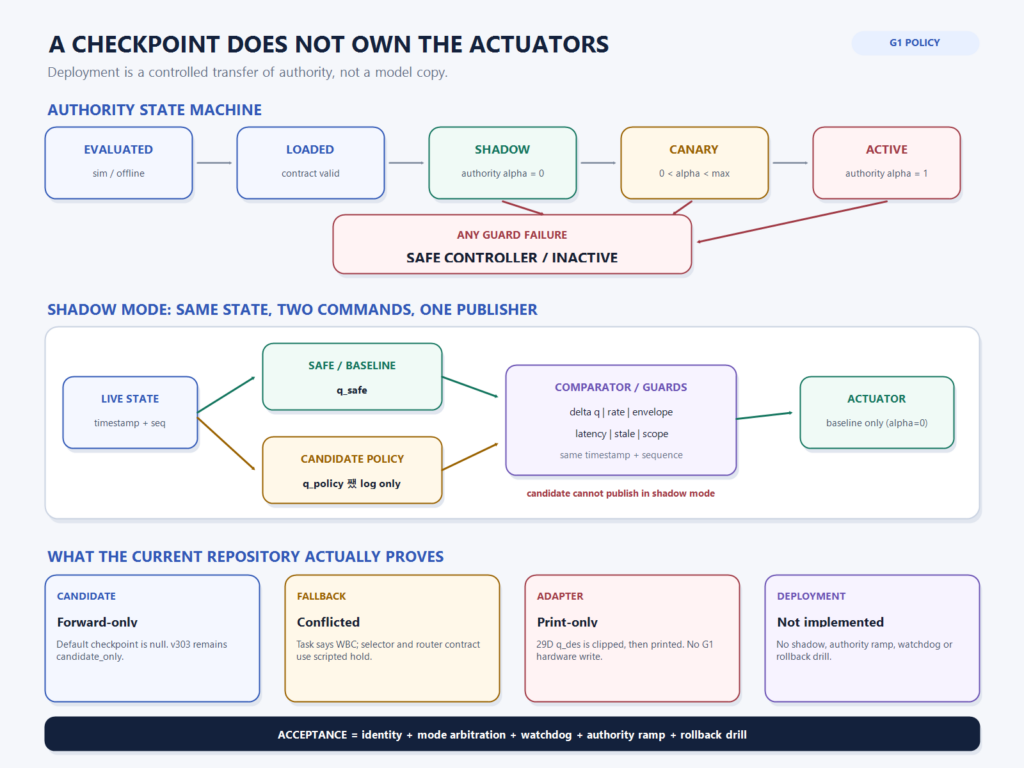
G1 보행 policy의 배포 경로를 확인하다가 같은 저장소 안에서 서로 다른 fallback 세 개를 발견했습니다. walk_forward.yaml에는 RL이 실패하면 WBC로 전환한다고
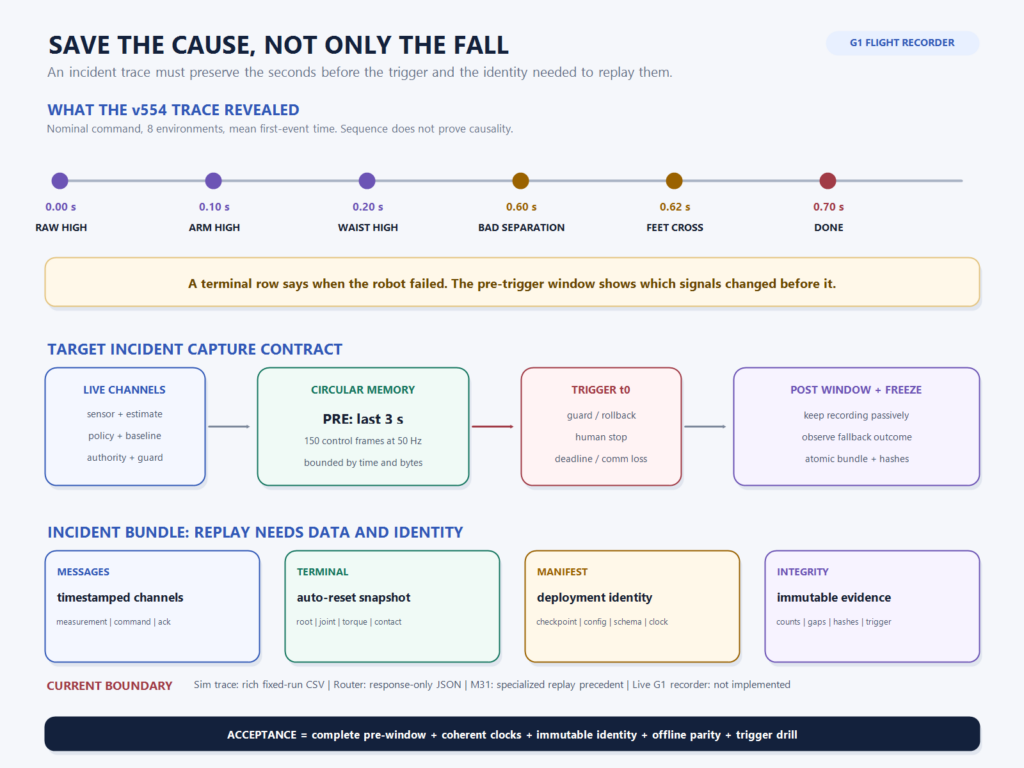
G1 v554의 nominal 5초 trace에서 실패는 0.70초에 갑자기 시작되지 않았습니다. 8개 환경의 첫 사건 시각을 평균하면 raw action 이상은 0.00초,
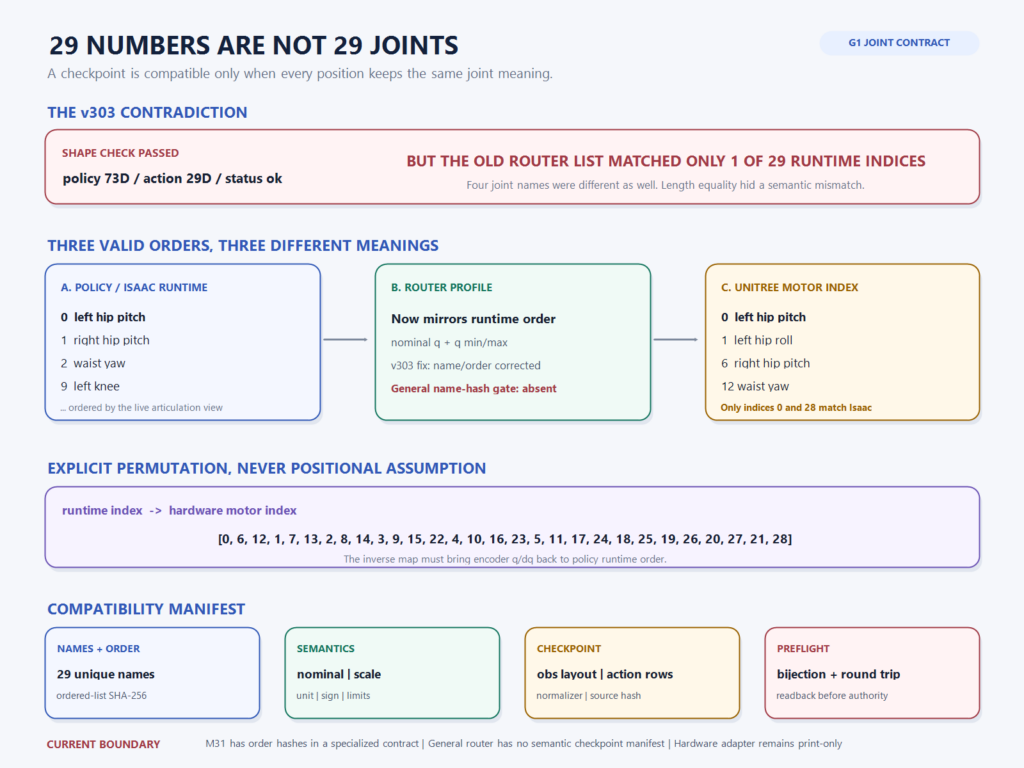
2026년 7월 6일, G1의 v303 checkpoint를 router에 연결하는 과정에서 이상한 조합을 발견했습니다. policy는 RSL-RL MLP로 로드됐고 observation과 action 차원도 각각
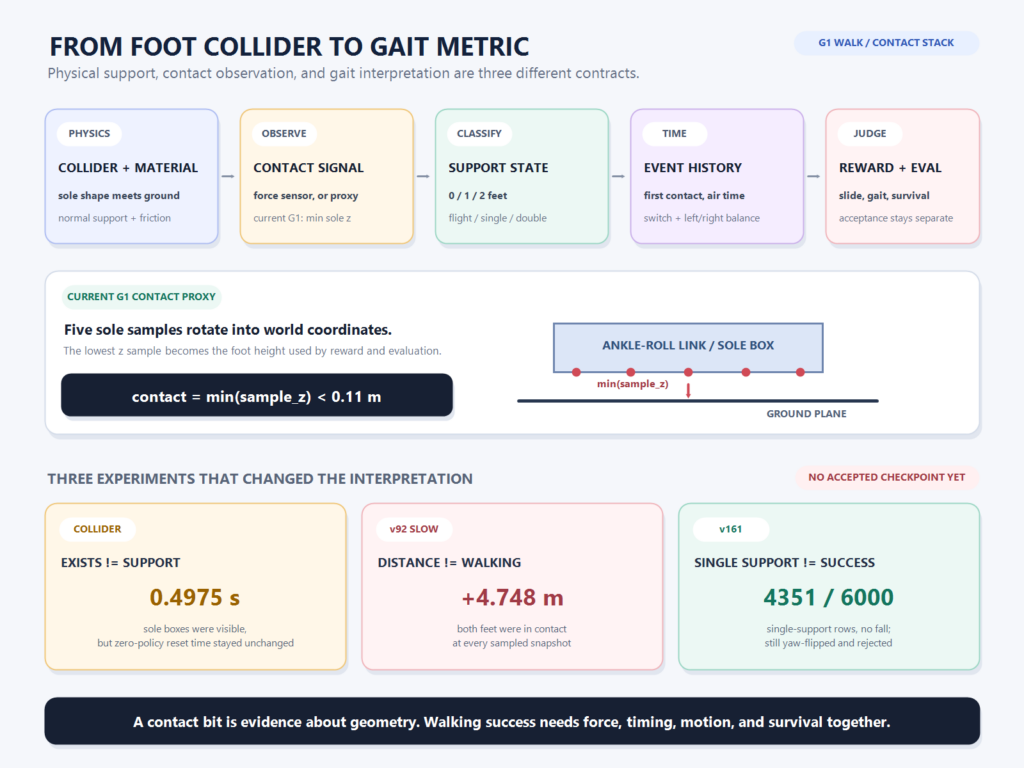
G1 v92 정책은 slow command 평가에서 15초 동안 넘어지지 않고 +4.748m를 이동했습니다. 이 숫자만 보면 보행이 시작된 것처럼 보입니다. 그러나
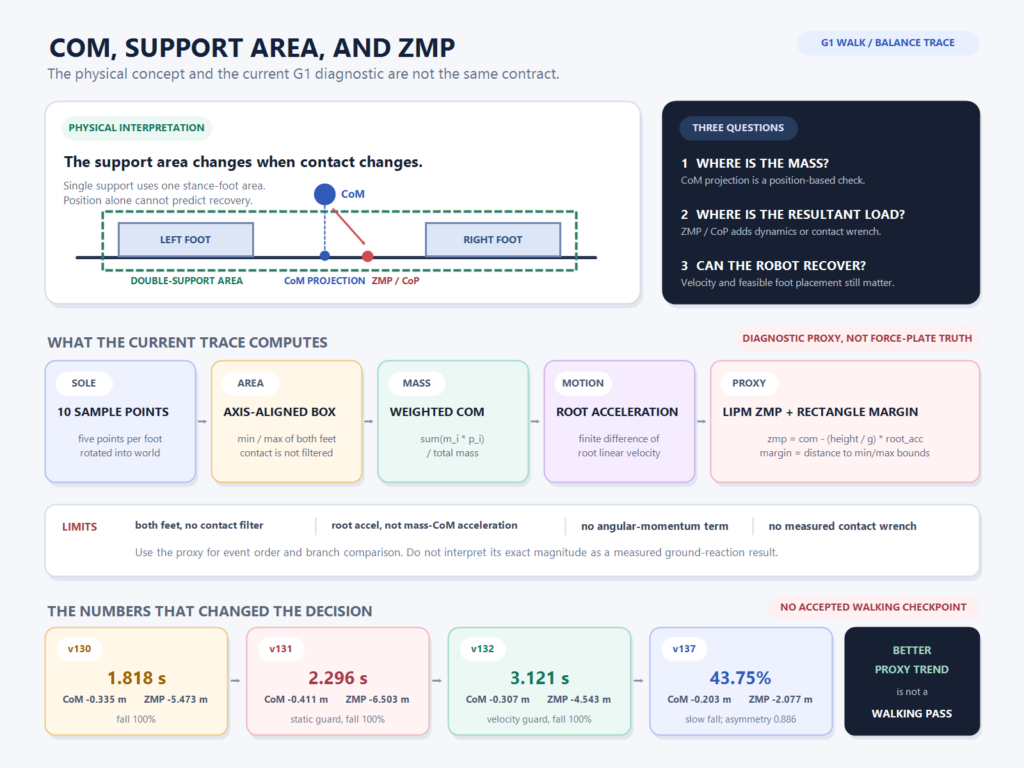
G1 보행 실험 v131에서 저는 무게중심을 지지발 쪽에 붙잡는 보상을 추가했습니다. 결과만 보면 어느 정도 효과가 있었습니다. 느린 명령에서 평균