LLM에게 로봇 팔을 직접 맡기면 어디까지 될까 — 블록은 95%, 퍼즐은 10%
언어 모델에게 로봇 팔을 그냥 맡기면 어떻게 될까요. 한 제3자 평가에서 블록을 그릇에 넣는 과제는 95%가 나왔지만, 퍼즐 조각을 홈에 끼우는 과제는 10%에 그쳤습니다. 두 과제의 격차가 무엇을 뜻하는지 정리했습니다.
언어 모델에게 로봇 팔을 그냥 맡기면 어떻게 될까요. 한 제3자 평가에서 블록을 그릇에 넣는 과제는 95%가 나왔지만, 퍼즐 조각을 홈에 끼우는 과제는 10%에 그쳤습니다. 두 과제의 격차가 무엇을 뜻하는지 정리했습니다.
컴퓨터 안에서 잘 걷던 로봇이 실제 바닥에 내려오면 그대로 걸을 수 있을까요? 답은 “그럴 수도 있지만, 자동으로 그렇지는 않다”에 가깝습니다.
로봇에게 걷는 모습을 수천 장 보여 주는 방법만으로는, 미끄러질 때 어떻게 회복할지까지 가르치기 어렵습니다. 강화학습은 로봇이 직접 시도하고 그 결과에
사람은 걷는 법을 의식하지 않아도, 미끄러운 바닥이나 계단 앞에서는 걸음걸이를 바꿉니다. 휴머노이드 로봇도 두 발로 서 있는 것만으로는 부족하고, 몸이
사람에게 “컵을 집어”라고 말하면 손을 어느 쪽으로 뻗을지 따로 설명하지 않아도 됩니다. 하지만 로봇에게는 컵이 화면의 어디에 있는지, 어느 손을
AI에게 “컵을 집어”라고 말하면 무엇이 일어나야 할까요. 챗봇이라면 문장으로 답할 수 있지만, 로봇이라면 컵이 어디에 있는지 보고, 팔을 어느 방향으로

현재 G1의 73차원 관측과 29차원 행동을 따라 forward, rollout, loss, backward, optimizer step, checkpoint의 차이를 설명합니다.
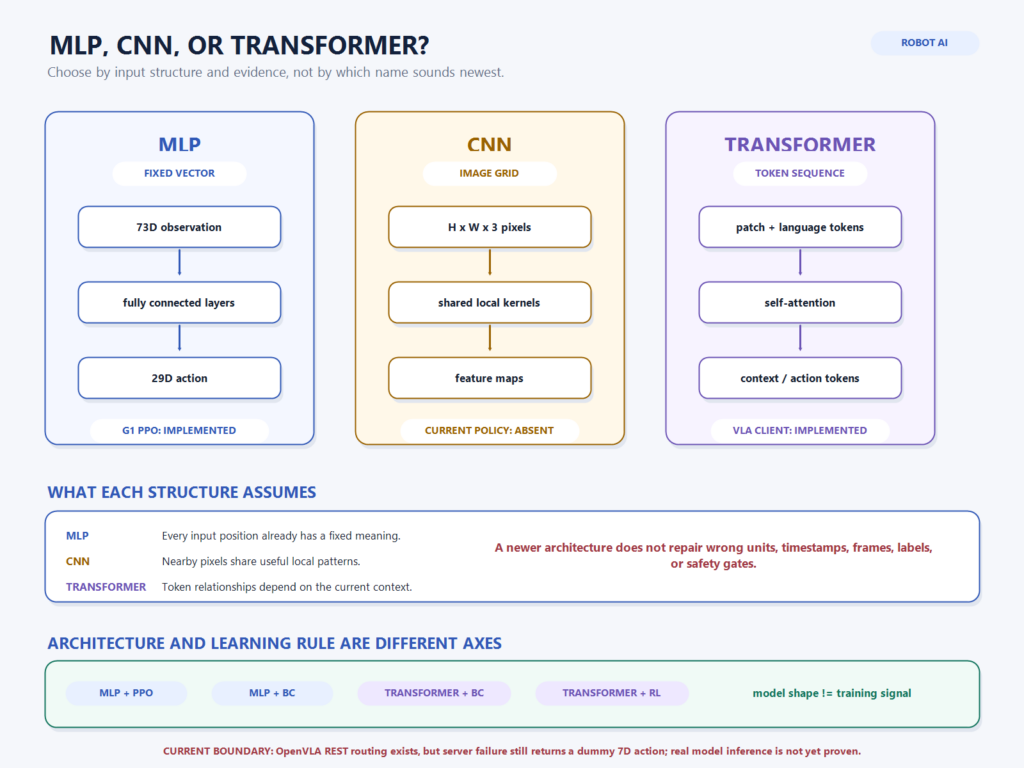
현재 G1의 73차원 MLP와 OpenVLA 경로를 기준으로 MLP·CNN·Transformer가 입력 구조를 어떻게 다르게 처리하는지 설명합니다.
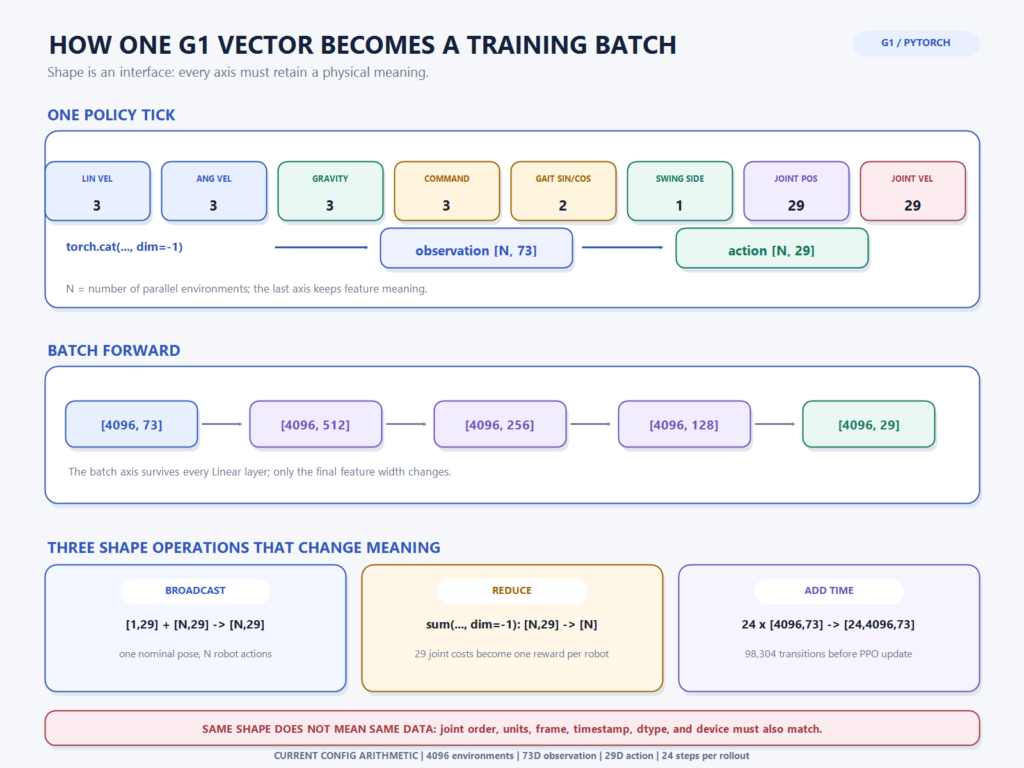
현재 G1의 73차원 관측과 4,096개 병렬 환경을 기준으로 tensor shape, batch, broadcasting, reduction, rollout의 의미와 흔한 축 오류를 설명합니다.
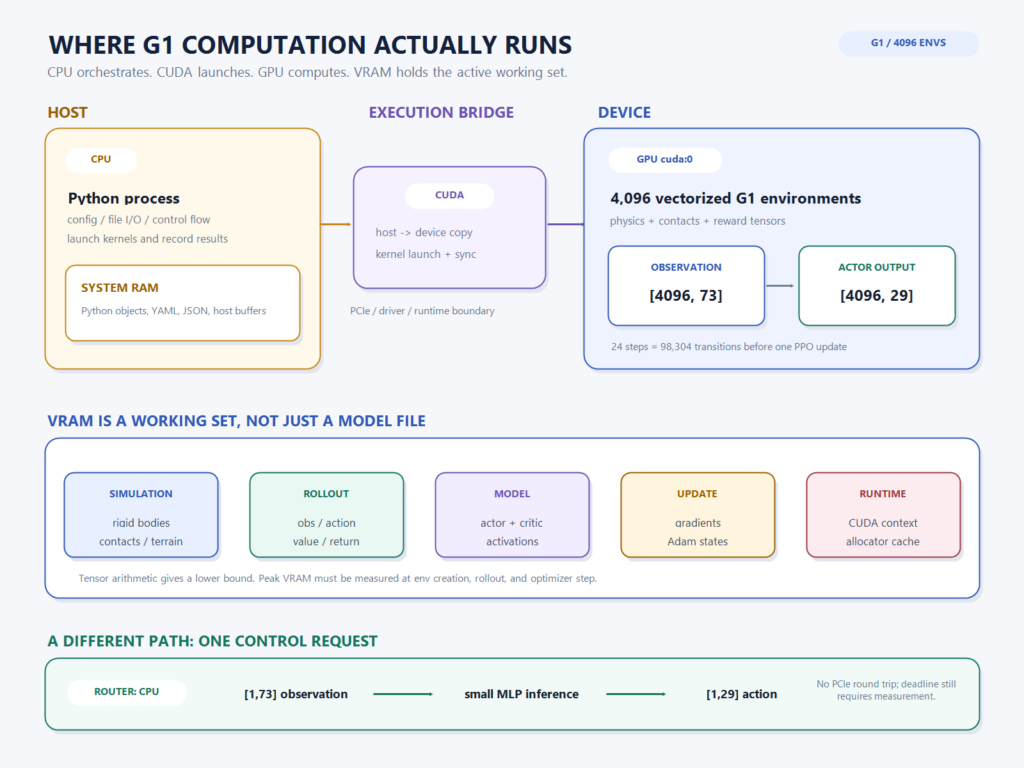
현재 G1의 GPU 학습 경로와 CPU 단일 추론 경로를 따라 CPU·GPU·CUDA·VRAM의 역할, 데이터 이동, 메모리 peak와 검증 경계를 설명합니다.