현재 G1 코드에는 얼핏 모순처럼 보이는 두 설정이 함께 있습니다. 학습용 rsl_rl_ppo_cfg.yaml은 device: cuda:0을 사용합니다. 반면 로봇 제어 라우터의 rl_g1_walk.yaml은 device: cpu입니다. 하나는 잘못된 설정일까요? 그렇지 않습니다. 전자는 Isaac Lab에서 4,096개 환경의 물리 계산과 PPO 학습을 묶어 처리하는 경로이고, 후자는 체크포인트 하나로 관측 한 건을 받아 action을 만드는 실행 경로입니다. 같은 정책이어도 계산량과 지연 조건이 다르면 적절한 장치도 달라집니다.
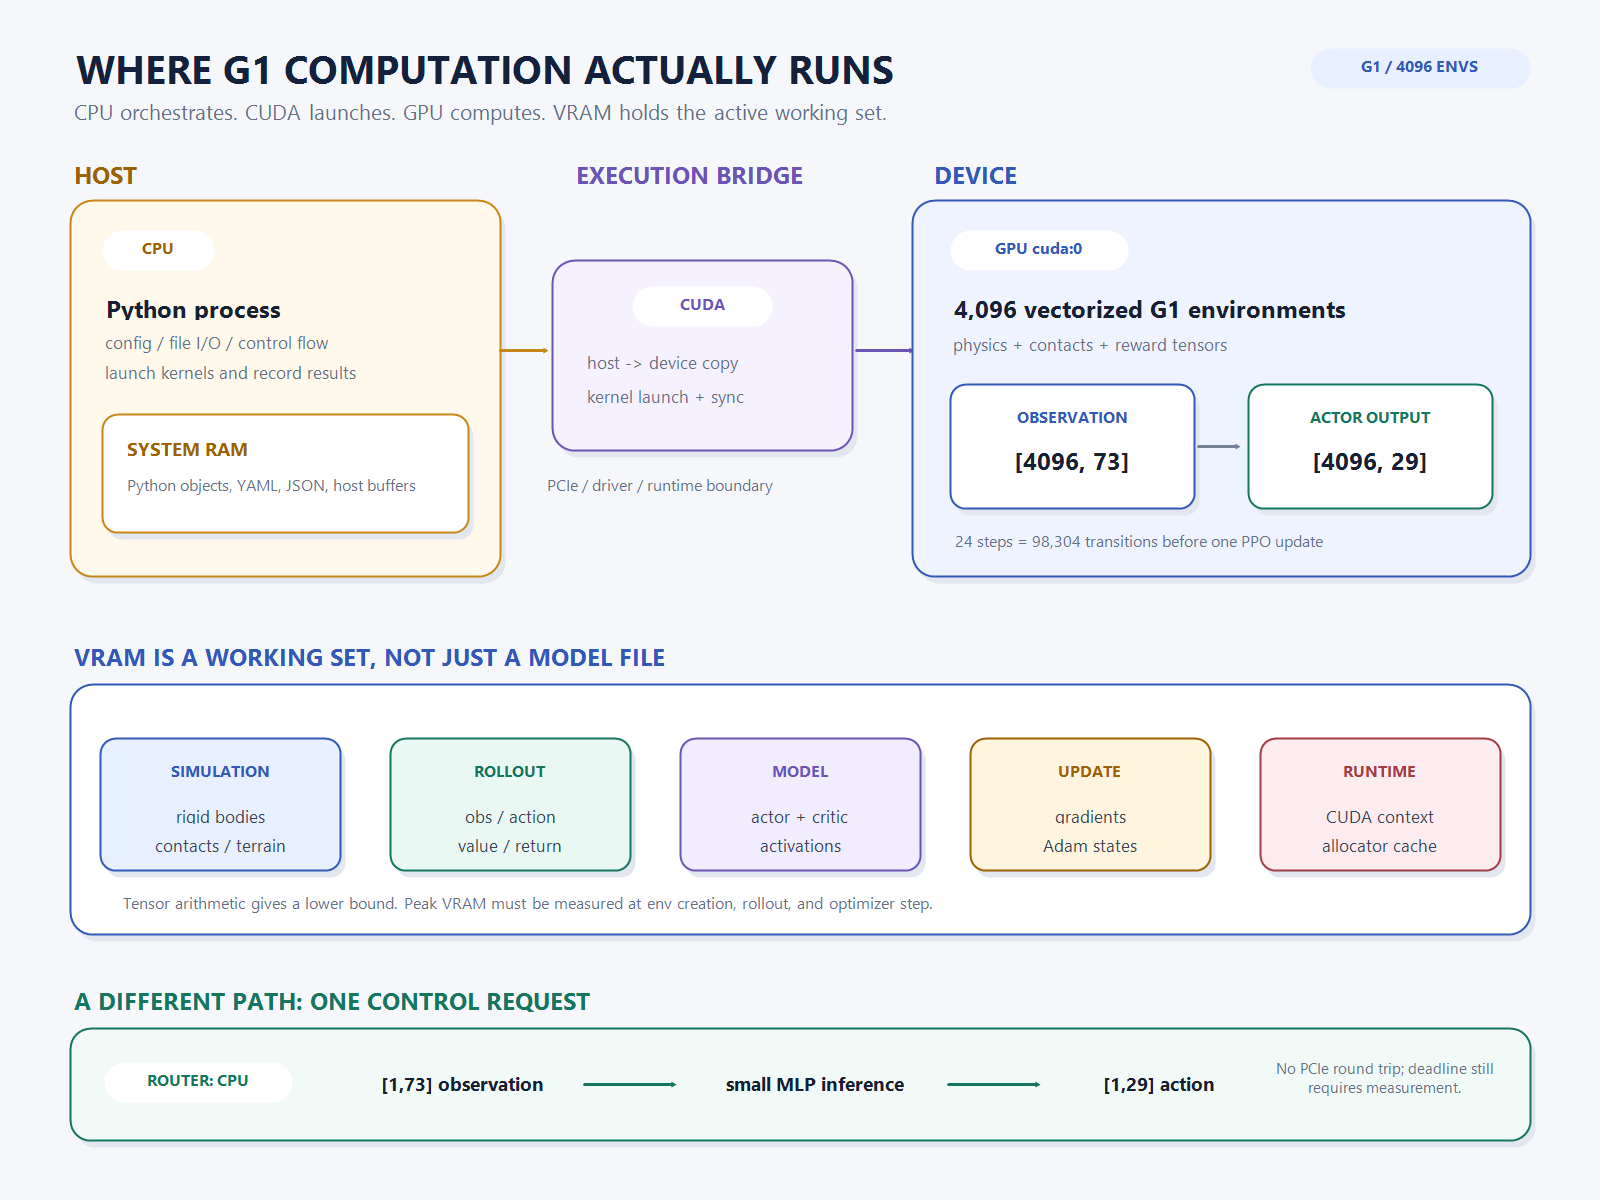
여기서 GPU, CUDA, VRAM을 같은 말처럼 쓰면 문제를 진단하기 어려워집니다. GPU는 계산 장치이고, CUDA는 CPU가 NVIDIA GPU에 계산을 맡기도록 연결하는 플랫폼과 실행 모델이며, VRAM은 GPU가 바로 접근하는 장치 메모리입니다. CPU와 RAM도 사라지지 않습니다. Python process를 시작하고 config와 파일을 읽고 GPU kernel을 예약하며 결과를 저장하는 일은 여전히 CPU 쪽에서 진행됩니다. 이 글에서는 현재 G1의 4096 × 73 observation batch가 어디에서 만들어지고, 어떤 값이 VRAM을 차지하며, 왜 단일 inference는 CPU에 남겨 둘 수 있는지를 하나의 계산 경로로 정리합니다.
CPU와 GPU의 차이는 ‘똑똑함’이 아니라 잘하는 계산의 모양입니다
CPU는 운영체제, Python interpreter, 파일 입출력, 조건 분기처럼 순서와 제어 흐름이 복잡한 작업을 다루기 좋습니다. GPU는 같은 연산을 많은 데이터 조각에 적용하는 처리량 중심 장치입니다. NVIDIA의 CUDA programming model은 CPU와 CPU에 연결된 메모리를 host와 host memory, GPU와 GPU에 연결된 메모리를 device와 device memory로 구분합니다. CUDA application도 CPU에서 시작하며, host code가 data 이동과 GPU kernel 실행을 요청합니다.
이 차이를 “CPU는 느리고 GPU는 빠르다”로 줄이면 절반만 맞습니다. 파일 하나를 열어 YAML key를 검사하거나, 실패 원인에 따라 다른 branch를 고르거나, action 한 건을 계산하는 작은 MLP를 실행하는 일은 GPU에 보낸다고 항상 빨라지지 않습니다. data를 device로 옮기고 kernel을 예약하고 결과를 다시 host로 가져오는 고정 비용이 있기 때문입니다. 반대로 4,096개 로봇의 같은 물리 식과 같은 actor layer를 row별로 계산한다면 GPU가 좋아하는 규칙적인 병렬성이 생깁니다.
| 구성요소 | 정확한 역할 | 현재 G1에서의 예 | 흔한 오해 |
|---|---|---|---|
| CPU | process 실행, 제어 흐름, I/O, GPU 작업 예약 | Python entry point, config·checkpoint 경로 처리, log 저장 | GPU를 쓰면 CPU가 필요 없다 |
| system RAM | CPU가 직접 쓰는 주 메모리 | Python object, 읽어 들인 config·JSON·일부 host buffer | RAM이 충분하면 VRAM 부족도 해결된다 |
| GPU | 많은 data에 같은 계산을 병렬 적용 | vectorized physics, batched actor forward, PPO update | 모든 프로그램을 자동으로 가속한다 |
| VRAM | GPU가 kernel에서 접근하는 device memory | simulation state, observation·action tensor, weight, activation, gradient | 모델 파일 크기와 VRAM 사용량은 같다 |
| CUDA | host가 NVIDIA GPU memory와 kernel을 다루는 실행 플랫폼 | PyTorch·Isaac Lab의 cuda:0 경로 |
CUDA는 GPU나 VRAM의 다른 이름이다 |
CUDA는 하드웨어가 아니라 CPU와 GPU 사이의 실행 계약입니다
cuda:0은 “첫 번째 CUDA GPU에 tensor와 계산을 둔다”는 장치 식별자입니다. PyTorch의 CUDA semantics 문서에 따르면 tensor가 한 번 특정 device에 할당되면 그 tensor에 대한 연산 결과도 같은 device에 남습니다. 서로 다른 device의 tensor를 일반 연산에 섞으면 오류가 나며, to(), cuda(), copy_()처럼 이동을 명시하는 연산이 필요합니다.
# 같은 shape라도 device가 다르면 같은 실행 경로가 아니다.
obs_cpu = torch.zeros(4096, 73, device="cpu")
obs_gpu = obs_cpu.to("cuda:0")

action_gpu = actor.to("cuda:0")(obs_gpu)
action_cpu = action_gpu.cpu().numpy()
이 네 줄에는 두 번의 경계 통과가 있습니다. observation이 host memory에서 device memory로 이동하고, 결과 action이 다시 CPU가 사용할 수 있는 배열로 돌아옵니다. tensor shape만 확인하면 두 이동은 보이지 않습니다. 그래서 tensor·shape·batch 글에서 shape와 함께 dtype·device·semantics를 보존해야 한다고 썼습니다. [4096, 73]이라는 모양이 같아도 CPU tensor와 CUDA tensor는 서로 다른 메모리 공간에 있습니다.
CUDA 작업은 기본적으로 비동기라는 점도 중요합니다. Python에서 GPU 연산 함수를 호출했을 때 host thread는 kernel의 실제 완료를 기다리지 않고 다음 일을 진행할 수 있습니다. 따라서 단순히 함수 호출 전후의 wall clock만 재면 GPU 실행 시간이 실제보다 짧게 보일 수 있습니다. 정확한 구간 측정에는 CUDA event를 사용하거나 측정 경계에서 synchronization이 필요합니다. 동기화를 매 step 남발하면 CPU와 GPU가 겹쳐 일할 기회를 잃으므로, 계측과 정상 실행의 설정도 분리해야 합니다.
G1 4,096개 환경은 GPU 한 대 안에서 하나의 큰 batch가 됩니다
현재 G1WalkEnvCfg는 num_envs=4096, observation_space=73, action_space=29를 선언합니다. G1WalkEnv는 command, raw action, 이전 action, contact time과 여러 reward용 buffer를 device=self.device로 만듭니다. Isaac Lab의 DirectRLEnv 문서도 환경을 여러 sub-environment가 병렬로 동작하는 vectorized environment로 정의하며, 환경의 device는 simulation device를 반환합니다.
한 policy tick에서 observation은 [4096, 73], actor output은 [4096, 29]가 됩니다. 4,096개의 별도 Python loop가 각자 MLP를 호출하는 구조가 아닙니다. 73개 feature를 가진 4,096개 row가 같은 weight matrix를 통과합니다. policy가 24 step을 수집하면 PPO update 전 transition은 24 × 4096 = 98,304개입니다. 시간축까지 쌓은 observation의 논리 shape는 [24, 4096, 73]입니다.
그렇다고 “환경 수를 4,096으로 늘리면 4,096배 빨라진다”는 뜻은 아닙니다. 환경이 늘수록 contact pair, rigid-body state, reward buffer, rollout storage가 커지고 GPU memory bandwidth와 VRAM이 한계에 가까워집니다. kernel이 작거나 CPU-side 작업이 자주 끼어들면 GPU가 기다릴 수도 있습니다. 반대로 camera rendering이 포함되면 pixel tensor와 rendering pipeline이 병목을 바꿉니다. Isaac Lab 공식 benchmark가 task와 환경 수에 따라 서로 다른 FPS를 제시하는 이유도 계산 내용이 다르기 때문입니다. 그 표의 RTX 4090 수치를 이 프로젝트의 RTX 5070 Ti 결과로 가져오지는 않았습니다.
VRAM 16GB에서 observation 하나는 작지만 전체 학습은 작지 않습니다
float32 원소 하나를 4 byte로 계산하면 현재 G1 tensor의 순수 data 크기는 직접 구할 수 있습니다. [4096, 73] observation은 299,008개 원소, 약 1.14MiB입니다. [4096, 29] action은 약 0.45MiB입니다. 24 step observation rollout만 계산하면 약 27.38MiB이고, 같은 길이의 action rollout은 약 10.88MiB입니다. actor MLP의 weight와 bias 205,853개만 float32로 저장하면 약 0.79MiB입니다.
| 대상 | shape 또는 개수 | 순수 float32 크기 | 이 숫자에 포함되지 않는 것 |
|---|---|---|---|
| 한 tick observation | [4096, 73] |
약 1.14MiB | physics state, contact, reward buffer |
| 한 tick action | [4096, 29] |
약 0.45MiB | target, previous action, actuator state |
| 24-step observation | [24, 4096, 73] |
약 27.38MiB | value, log probability, return, advantage |
| 24-step action | [24, 4096, 29] |
약 10.88MiB | distribution parameter와 PPO 부가 storage |
| actor MLP parameter | 205,853개 | 약 0.79MiB | critic, gradient, optimizer state, activation |
이 표를 합쳐 “G1 학습에는 수십 MiB면 충분하다”고 결론 내리면 틀립니다. VRAM에는 robot link와 rigid-body state, PhysX contact buffer, terrain과 scene data, actor·critic weight, forward activation, backward gradient, Adam optimizer state, rollout의 value·return·advantage·log probability, CUDA context와 framework workspace가 함께 존재합니다. GUI를 켜면 renderer와 texture도 같은 GPU 예산을 씁니다. 표는 tensor 하나의 산술 크기일 뿐 runtime peak VRAM 측정값이 아닙니다.
PyTorch도 눈에 보이는 tensor 크기와 GPU가 잡아 둔 메모리를 구분합니다. 공식 torch.cuda 문서의 memory_allocated()는 tensor가 차지한 현재 메모리, memory_reserved()는 caching allocator가 관리하는 전체 메모리를 보고합니다. tensor를 삭제해도 재사용을 위해 reserve된 영역이 nvidia-smi에는 사용 중으로 보일 수 있습니다. empty_cache()가 살아 있는 tensor 메모리를 없애 주거나 현재 process가 더 큰 model을 담게 해 주는 것은 아닙니다.
OOM은 VRAM 숫자 하나가 아니라 peak가 만들어지는 순서로 진단해야 합니다
CUDA out-of-memory가 발생하면 가장 먼저 batch size만 줄이기 쉽습니다. G1에서는 환경 수가 batch 축이므로 4096 → 2048로 줄이면 많은 environment-sized buffer가 작아집니다. 하지만 OOM 위치가 renderer 초기화인지, contact buffer 확장인지, PPO backward인지에 따라 원인이 다릅니다. actor forward 직전 여유가 충분해도 backward에서 activation과 gradient, optimizer temporary buffer가 겹치며 peak가 생길 수 있습니다.
그래서 최소한 네 값을 같은 run에 남겨야 합니다. 시작 전 global free/total VRAM, environment 생성 직후의 allocated/reserved, 첫 rollout 직후의 peak allocated/reserved, 첫 optimizer step 직후의 peak입니다. 여기에 num_envs, headless 여부, camera 사용, dtype, task, software와 driver version이 붙어야 비교가 가능합니다. GUI 실행과 headless PPO를 같은 VRAM 기준으로 섞으면 renderer 비용이 학습 tensor 문제처럼 보일 수 있습니다.
현재 데스크톱 환경 기록은 Windows 11, RTX 5070 Ti 16GB, Isaac Sim 5.1, Isaac Lab 2.x, PyTorch 2.7.0+cu128과 드라이버 591.74를 기준으로 합니다. 595.97 조합에서 GUI의 rtx.scenedb.plugin.dll crash를 겪어 기준 driver를 낮춘 과정은 Isaac Sim·Isaac Lab 로컬 환경 기록이 소유합니다. 이 글에서는 그 시행착오를 반복하지 않습니다. driver 호환성은 “GPU가 느리다”는 성능 문제와 다르고, OOM은 다시 별개의 memory capacity 문제입니다.
학습은 GPU, 단일 정책 실행은 CPU라는 선택이 동시에 성립합니다
학습 설정의 cuda:0은 simulation, actor·critic forward, rollout, PPO update를 같은 device에 두려는 선택입니다. 대량의 environment state를 매 tick CPU로 복사하지 않고 GPU 안에서 계산을 이어 갈 수 있습니다. 4,096개 환경의 fresh transition을 수집하는 이유와 PPO data lifecycle은 physics step·decimation·vector environment 글과 AI 모델 학습 글에서 각각 더 깊게 다뤘습니다.
반면 현재 router config는 device: cpu입니다. PolicyLoader는 checkpoint를 map_location=self.device로 읽고 actor를 같은 device에 올립니다. 요청 한 건에서는 observation을 torch.tensor(...).unsqueeze(0)으로 만들고, torch.no_grad()에서 action 하나를 계산한 뒤 .cpu().numpy()로 반환합니다. CPU 설정이라면 이 마지막 cpu()는 사실상 같은 장치 안의 변환이고, 작은 MLP 한 건을 위해 PCIe 왕복을 만들지 않습니다.
여기서 CPU inference가 충분히 빠르다는 결론은 아직 내릴 수 없습니다. 현재 config에 CPU라고 적혀 있다는 사실과 control deadline을 측정해 통과했다는 사실은 다릅니다. 실제 robot runtime에서는 sensor age, preprocessing, actor forward, safety check, transport, actuator response를 합친 end-to-end latency를 측정해야 합니다. 여러 robot 요청을 batch로 묶거나 image encoder까지 붙이면 GPU가 다시 유리해질 수 있습니다. 반대로 50Hz의 작은 vector MLP 한 건이라면 data 이동 없이 CPU에 두는 편이 더 단순할 수 있습니다.
CPU fallback은 디버깅 수단이지만 GPU 결과의 대체 증거는 아닙니다
Isaac Lab의 환경 실행 tutorial은 --device cpu로 simulation device를 바꾸는 방법을 제공하며 CPU 실행이 debugging에 유용하지만 GPU보다 훨씬 느리다고 설명합니다. 작은 환경 수로 observation shape, reset, reward의 finite 여부를 확인할 때 CPU 경로는 원인을 좁히는 데 유용합니다. GPU가 없는 노트북에서 router의 interface와 checkpoint loader를 확인하는 역할도 분리할 수 있습니다.
그러나 CPU smoke가 통과했다고 4,096개 CUDA 환경도 통과한다고 말할 수는 없습니다. GPU에서만 드러나는 contact capacity, kernel error, device mismatch, asynchronous failure, peak VRAM이 남아 있습니다. 반대로 GPU PPO가 실행됐다고 router의 CPU latency와 실제 actuator deadline이 검증된 것도 아닙니다. PPO 재현성 글에서 hardware·driver·CUDA version을 run fingerprint에 포함한 이유도 같은 코드가 서로 다른 runtime에서 같은 증거 수준을 갖지 않기 때문입니다.
현재 코드에서 확인된 것과 아직 측정하지 않은 것을 나눕니다
| 주장 | 현재 근거 | 판정 |
|---|---|---|
| G1 환경은 device-local tensor를 사용한다 | device=self.device로 command·action·contact·reward buffer 생성 |
구현 확인 |
| 기본 학습 경로는 CUDA GPU를 선택한다 | PPO config와 실행 기록의 device: cuda:0 |
구현·실행 기록 확인 |
| 4,096개 환경과 73D→29D policy 경로가 정의돼 있다 | G1 env cfg와 actor config | 구현 확인 |
| router의 checked-in G1 inference device는 CPU다 | rl_g1_walk.yaml의 device: cpu |
설정 확인 |
| 현재 16GB VRAM peak와 여유량을 알고 있다 | 동일 조건의 peak memory report가 없음 | 미측정 |
| router CPU inference가 50Hz deadline을 만족한다 | end-to-end latency acceptance 기록이 없음 | 미검증 |
특히 마지막 두 줄을 채워 넣지 않았습니다. RTX 5070 Ti가 16GB라는 사양은 capacity의 상한이고, G1 run이 실제로 몇 GiB를 peak로 썼는지 알려 주지 않습니다. 공식 benchmark가 GPU 병렬 학습의 가능성을 보여 줘도 제 scene, reward profile, renderer와 software version의 결과를 대신하지 않습니다. router에 cpu가 적혀 있어도 deadline 통과를 보장하지 않습니다. 설정, 실행, 관측, 승인이라는 네 단계를 나누면 hardware 설명도 과장 없이 쓸 수 있습니다.
다음 측정은 FPS 하나보다 계산 경계를 함께 남겨야 합니다
다음 G1 canary에서는 먼저 torch.cuda.is_available(), GPU model, driver, PyTorch와 CUDA build, task와 commit, num_envs, headless·camera 여부를 manifest에 고정합니다. 그 뒤 environment 생성, 첫 rollout, 첫 optimizer step의 peak allocated·reserved를 각각 기록합니다. 처리량은 environment step, actor inference, PPO update를 구간별로 나누고, GPU 시간은 CUDA event 또는 명시적 synchronization을 사용해 측정합니다.
router 쪽은 별도의 실험이 필요합니다. CPU와 cuda:0에서 동일한 73D observation tape를 넣고 warm-up 이후 p50·p95·p99 latency를 비교합니다. GPU 경로에는 host→device와 device→host 복사 시간이 포함돼야 합니다. action 값의 허용 오차, checkpoint hash, dtype, thread 수와 background load도 함께 남깁니다. 이 비교가 끝나야 “작은 MLP는 CPU가 낫다” 또는 “batch inference에는 GPU가 낫다”를 이 프로젝트의 결론으로 승격할 수 있습니다.
GPU를 쓴다는 말보다 무엇이 어디에 있는지를 먼저 확인합니다
현재 G1 학습은 CPU가 process와 실행 흐름을 관리하고, CUDA가 cuda:0의 GPU에 vectorized simulation과 tensor 연산을 맡기는 구조입니다. VRAM에는 observation 하나만 올라가는 것이 아니라 simulation state, contact, rollout, actor·critic, activation, gradient, optimizer와 allocator cache가 함께 존재합니다. 4,096개 환경이 유리한 이유는 같은 계산을 큰 batch에 적용할 수 있기 때문이지 GPU라는 이름이 자동으로 코드를 빠르게 만들기 때문이 아닙니다.
동시에 router의 단일 G1 actor는 CPU 설정으로 남아 있습니다. 작은 inference에서 data 이동을 피하는 선택은 충분히 합리적이지만, 실제 control deadline 통과는 아직 측정해야 합니다. 앞으로 장치 문제를 볼 때는 “GPU를 사용했는가” 한 줄로 끝내지 않고, tensor의 device, host↔device copy, synchronization, peak allocated·reserved, 환경 수와 실행 구간을 함께 확인할 것입니다. 그 기록이 있어야 느린 이유와 메모리가 부족한 이유, driver가 깨진 이유를 서로 다른 문제로 분리할 수 있습니다.