G1 PPO의 seed 재현성을 확인하던 M68 실험에서는 seed 42·43·44가 모두 목표로 삼은 두 지표를 개선했습니다. vertical CAM z RMSE는 3.67~4.09%, 팔의 상쇄 기여는 5.88~6.43% 좋아졌습니다. 그런데 seed 44에서 오른쪽 어깨 pitch residual이 32,000개 표본 중 한 번 포화됐습니다. 비율은 0.003125%였습니다. 평균 성능만 보면 지나칠 수 있는 값이었지만, 미리 고정한 zero-saturation gate 때문에 M68은 다음 부모 정책으로 승격되지 않았습니다.
후속 M69는 극단적인 CAM error가 arm residual을 키우는 경로만 tanh로 제한했습니다. 같은 M62 부모에서 seed 42·43·44를 각각 다시 학습했고, 세 seed 모두 두 목표 지표를 개선하면서 termination·foot crossing·saturation tail을 0으로 만들었습니다. 여기서 승인한 것도 전체 보행 정책이 아니라 bounded arm subsystem까지였습니다.
이 대조를 겪으며 seed를 “같은 결과를 만드는 숫자”로 부르면 부족하다는 것을 알게 됐습니다. seed는 학습이 소비하는 난수열의 출발점을 정합니다. 그 난수열이 어느 코드 경로로 전달되는지, 실행 순서와 하드웨어·라이브러리가 같은지, 같은 seed 반복과 서로 다른 seed 평가 중 어떤 질문을 하고 있는지까지 고정해야 재현성 계약이 됩니다.
이 글은 checkpoint 평가 계약에서 다룬 multi-seed acceptance gate를 반복하지 않습니다. 현재 G1 코드에서 --seed가 어디로 흘러가고 무엇을 바꾸는지, 같은 seed의 반복과 다른 seed의 재현이 왜 별개의 검사인지에 집중합니다. reset 때 어떤 상태와 명령을 뽑는지는 reset distribution·randomization 글에 따로 남겼습니다.
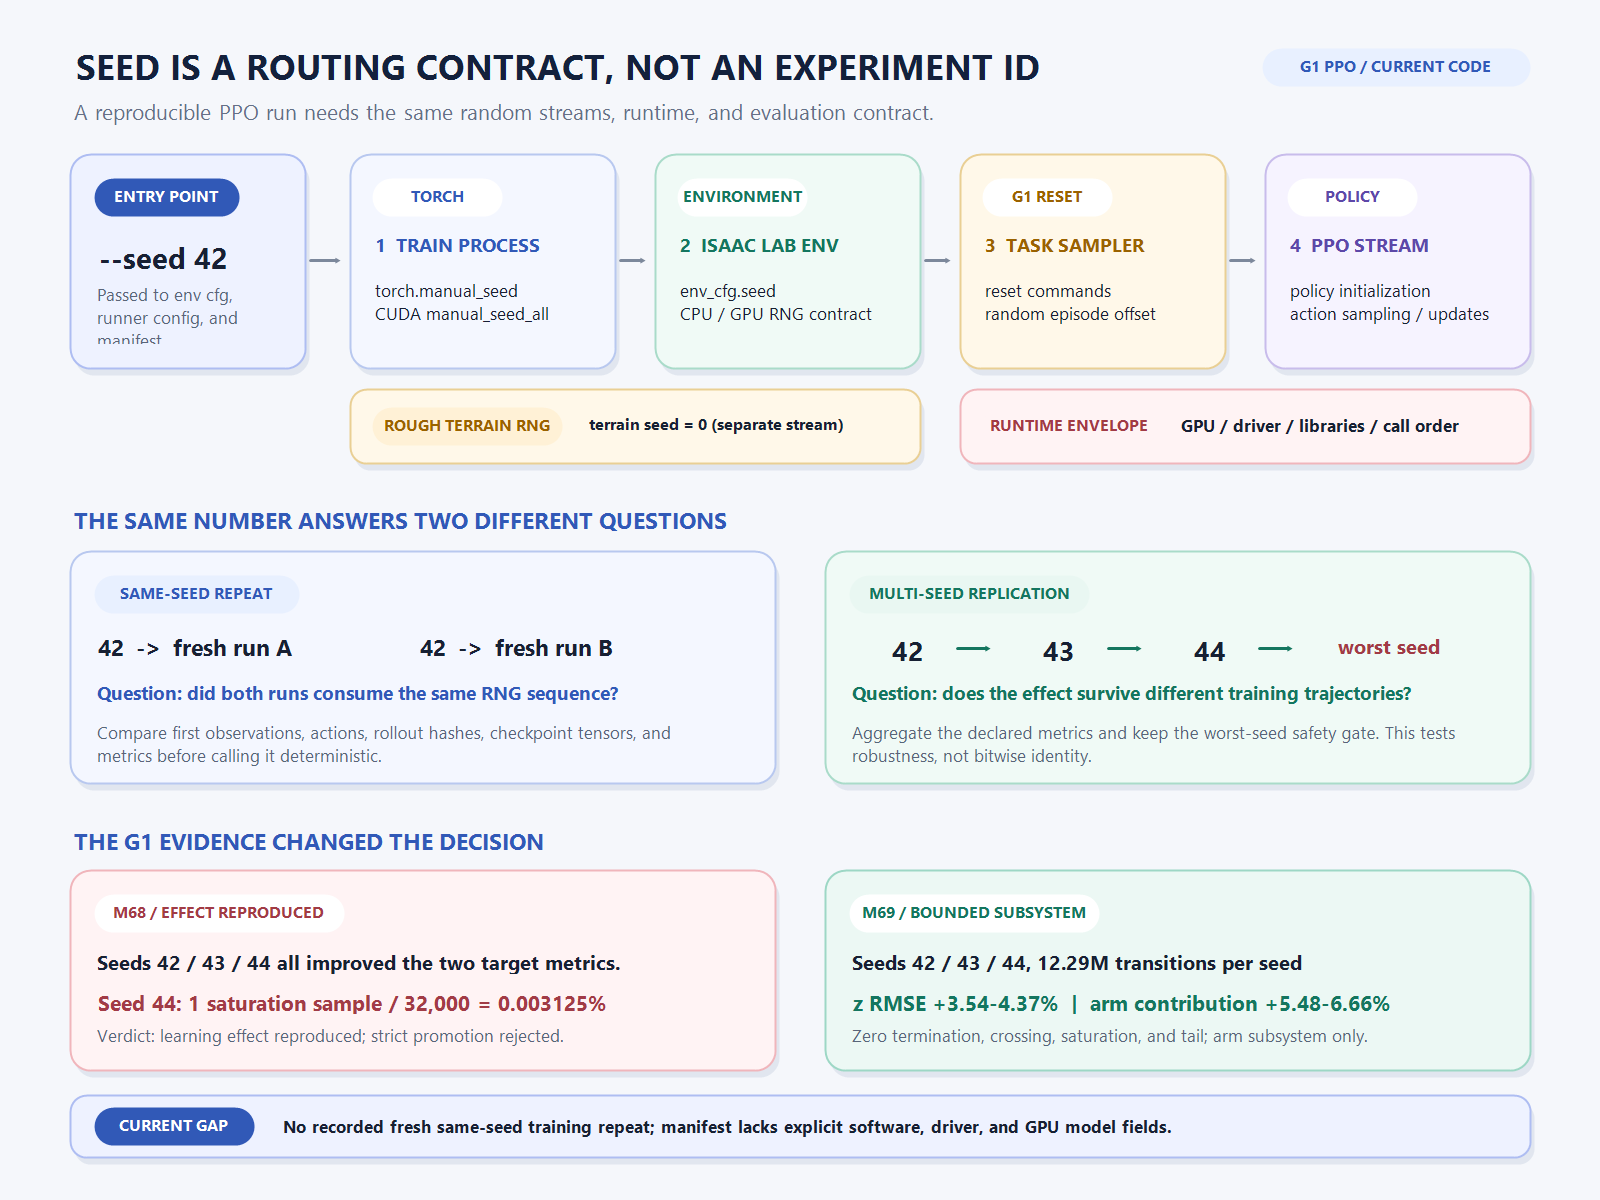
현재 G1에서 seed의 정본은 YAML이 아니라 실행 인자입니다
flat G1의 rsl_rl_ppo_cfg.yaml에는 seed: 42가 적혀 있습니다. 그러나 현재 training/rl/train.py는 이 top-level 값을 읽어 학습 seed로 쓰지 않습니다. 명령행의 --seed를 기본 42로 정의하고, 그 값을 environment와 runner configuration에 직접 전달합니다.
parser.add_argument("--seed", type=int, default=42)

torch.manual_seed(args.seed)
torch.cuda.manual_seed_all(args.seed)

env_cfg.seed = args.seed
runner_cfg = build_runner_cfg(yaml_data, seed=args.seed, ...)
따라서 YAML의 숫자만 43으로 바꾸고 CLI를 생략하면 실제 실행은 여전히 기본값 42입니다. 반대로 YAML이 42인 상태에서도 --seed 43을 주면 environment·runner·manifest는 43을 받습니다. 설정 파일과 실행값이 충돌할 때 어느 쪽이 실제 동작을 소유하는지 확인하지 않으면, 이름만 seed 43인 실험을 만들 수 있습니다.
현재 run_manifest.json이 args.seed를 저장하는 이유가 여기에 있습니다. 실행 후에는 YAML의 의도보다 manifest의 seed, command arguments, runner configuration을 우선해서 읽어야 합니다. 다만 manifest에 숫자가 남았다는 사실만으로 해당 난수열이 모든 라이브러리에 정확히 적용됐다고 증명되는 것은 아닙니다. 배선은 코드와 첫 실행 trace로 따로 확인해야 합니다.
하나의 seed가 네 종류의 난수 소비 지점을 지납니다
첫 번째는 학습 프로세스입니다. 현재 entrypoint는 환경을 만들기 전에 Torch CPU와 CUDA generator를 초기화합니다. actor·critic weight의 초기값, Gaussian action sampling, random episode offset처럼 실제 코드에서 Torch RNG를 사용하는 연산은 이 난수열의 영향을 받습니다. 같은 숫자를 쓰더라도 그 전에 난수를 한 번 더 소비하는 코드가 추가되면 이후 sequence는 모두 한 칸씩 밀릴 수 있습니다.
두 번째는 Isaac Lab 환경입니다. workspace는 env_cfg.seed=args.seed를 설정한 뒤 gym.make를 호출합니다. Isaac Lab의 현재 공식 Reproducibility and Determinism 문서는 환경 생성 시 seed를 설정하며, 공식 configure_seed 구현은 Python random, NumPy, Torch, CUDA, Warp와 PYTHONHASHSEED를 함께 맞추는 계약을 보여 줍니다. 현재 custom entrypoint가 직접 호출하는 것은 Torch seed이지만, env_cfg.seed를 환경 생성 계약에도 전달하고 있습니다.
세 번째는 G1 task sampler입니다. _reset_idx()는 torch.rand와 uniform_으로 slow·nominal command, 전후·좌우·회전 명령과 stand mask를 뽑습니다. 기본 학습은 init_at_random_ep_len=True로 시작해 RSL-RL runner가 torch.randint_like로 각 병렬 환경의 초기 episode offset도 흩어 놓습니다. seed가 달라지면 같은 4,096개 로봇이 처음 접하는 command와 gait phase의 조합부터 달라집니다.
네 번째는 policy trajectory입니다. PPO의 rollout과 clipping을 설명한 글에서 다뤘듯이 학습 중 actor는 고정된 평균 action만 내지 않고 현재 Gaussian policy에서 행동을 표본화합니다. 표본 하나가 달라지면 다음 물리 상태와 reward가 달라지고, 다음 rollout의 advantage와 gradient도 바뀝니다. 처음의 작은 차이는 수천 환경과 여러 update를 지나며 서로 다른 checkpoint trajectory로 커질 수 있습니다. 이것은 오류가 아니라 확률적 학습이 가진 정상적인 분기입니다.
| seed가 닿는 위치 | 현재 코드의 경로 | 달라질 수 있는 것 |
|---|---|---|
| process RNG | torch.manual_seed, CUDA all |
network 초기값, stochastic action과 Torch 기반 sampling |
| environment RNG | env_cfg.seed |
환경 생성과 Isaac Lab이 소유한 randomization stream |
| G1 reset sampler | torch.rand, uniform_ |
command mixture, stand mask, 새 episode 조건 |
| runner start | init_at_random_ep_len=True |
4,096개 환경의 첫 episode phase 분포 |
| provenance | run_manifest.json |
실행이 요청한 seed와 config를 나중에 감사할 수 있음 |
rough terrain의 seed 0은 학습 seed 42와 다른 난수열입니다
G1 rough-terrain configuration에는 TerrainGeneratorCfg(seed=0)이 따로 있습니다. 이것은 policy training seed와 같은 역할이 아닙니다. 지형 생성기는 자체 NumPy generator를 사용해 sub-terrain 배치와 높이장 구성을 재현합니다. 학습 seed를 42에서 43으로 바꿔도 terrain seed를 0으로 유지하면 생성된 지형 지도는 같은 계약을 따르고, 그 위에서 command·action·reset trajectory만 달라질 수 있습니다.
반대로 terrain seed까지 학습 seed에 묶으면 두 축이 동시에 바뀝니다. policy initialization과 행동 표본이 달라졌는지, 지형 자체가 달라졌는지 분리하기 어려워집니다. terrain generalization을 보려는 실험이라면 여러 terrain seed가 필요하지만, policy seed의 효과를 격리하려는 실험이라면 terrain map을 고정하는 편이 질문에 맞습니다.
이것이 seed를 하나의 전역 숫자로 기록하는 대신 소유권을 적어야 하는 이유입니다. 최소한 training seed, terrain seed, 평가 scenario seed를 구분해야 합니다. camera noise, domain randomization, 데이터 loader처럼 별도 generator를 만드는 구성요소가 생기면 해당 seed와 sampling 시점도 독립 필드로 추가해야 합니다.
같은 seed는 같은 runtime에서만 강한 약속이 됩니다
NVIDIA의 PhysX determinism 문서는 특정 platform과 build에서 rigid body·articulation scene을 같은 API 호출 순서와 time step으로 다시 만들면 동일한 simulation 결과를 기대할 수 있다고 설명합니다. 동시에 platform, compiler optimization, scene 구성이나 설정이 달라지면 결과가 갈라질 수 있다고 명시합니다. actor 하나를 추가하거나 제거하는 일도 constraint 처리 순서를 바꿀 수 있습니다.
Isaac Lab 문서도 같은 hardware와 Isaac Sim·PhysX version을 조건으로 둡니다. GPU가 바쁜 동안 runtime parameter 변경의 적용 순서가 달라지면 floating-point least-significant bit가 달라질 수 있고, 수천 환경과 긴 simulation에서 그 차이가 확대될 수 있다고 경고합니다. 따라서 “seed가 같은데 결과가 다르다”는 말 앞에는 GPU, driver, Isaac Sim/Lab, PhysX, PyTorch, CUDA, 환경 수와 실행 순서가 같은지를 붙여야 합니다.
PyTorch의 reproducibility 문서 역시 release·commit·platform이 달라진 완전한 재현을 보장하지 않습니다. torch.manual_seed는 난수 source를 통제하지만 nondeterministic CUDA algorithm까지 자동으로 금지하지는 않습니다. torch.use_deterministic_algorithms(True), cuDNN benchmark, CUBLAS workspace 같은 설정은 별도의 결정론 모드입니다. 이 모드는 성능을 낮추거나 지원되지 않는 연산에서 오류를 낼 수 있으므로, 일반 학습 기본값과 진단용 strict run을 구분해야 합니다.
현재 G1 custom train 경로에는 seed 배선과 manifest는 구현돼 있습니다. 하지만 소프트웨어 버전·driver·GPU model을 manifest의 명시적 필드로 기록하거나, fresh training을 strict deterministic 조건에서 두 번 실행해 checkpoint tensor까지 비교한 증거는 없습니다. 공식 프레임워크가 제공하는 결정론 옵션이 존재한다는 사실과 이 workspace에서 그 경로를 실행·검증했다는 주장을 섞지 않았습니다.
deterministic evaluation과 deterministic training은 같은 말이 아닙니다
평가에서는 저장된 actor를 inference mode로 두고 같은 scenario command를 반복할 수 있습니다. 현재 eval_rl.py도 NumPy·Torch·CUDA seed를 맞추고, env_cfg.seed를 설정한 뒤 scenario마다 environment를 reset합니다. reset sampler가 command를 다시 뽑더라도 매 step 고정 command를 덮어써 같은 목표 속도를 유지합니다. 이 조건은 두 checkpoint를 같은 tape에서 비교하기 위한 것입니다.
하지만 environment를 reset하는 순간의 initial state, episode offset, 접촉 solver 상태까지 동일하다는 것은 별도 검사가 필요합니다. 결과 JSON에 seed가 적혀 있어도 첫 observation과 첫 action이 같은지 확인하지 않으면 scenario label만 같은 비교가 될 수 있습니다. 현재 평가 스크립트는 seed와 조건을 기록하지만, 첫 N-step observation/action hash를 표준 산출물로 남기지는 않습니다.
학습은 더 어렵습니다. 초기 network, stochastic action, reset command, random episode offset, mini-batch update가 서로 연결돼 있습니다. 같은 seed training A와 B가 마지막 reward만 비슷하다고 해서 bitwise deterministic이라고 말할 수 없습니다. 첫 divergence가 iteration 0의 observation인지, 첫 action인지, optimizer update인지 찾으려면 앞쪽 상태를 순서대로 비교해야 합니다.
same-seed 반복과 multi-seed 재현은 서로 다른 질문입니다
| 검사 | 고정하는 것 | 바꾸는 것 | 답하는 질문 |
|---|---|---|---|
| same-seed repeatability | 코드·config·parent·seed·hardware·runtime | fresh process만 다시 시작 | 동일한 난수열과 실행 순서가 같은 trace를 만드는가? |
| multi-seed replication | 코드·config·parent·평가 gate | training seed | 효과가 다른 학습 trajectory에서도 유지되는가? |
| paired checkpoint evaluation | scenario·evaluation seed·duration | baseline과 candidate checkpoint | 정책 변경이 같은 조건에서 행동을 개선했는가? |
same-seed 반복은 배선과 regression test에 가깝습니다. 두 fresh process의 첫 observation, action, reward, done, rollout hash와 checkpoint tensor가 어느 단계까지 같은지 봅니다. 여기서 차이가 나면 seed 전달, runtime version, 비결정적 연산, API call order를 의심할 수 있습니다.
multi-seed 재현은 일반화 질문입니다. seed 42에서 좋아진 방향이 seed 43·44에서도 유지되는지, 평균만 좋아지고 한 seed의 safety tail이 나빠지지는 않는지 봅니다. 서로 다른 결과가 나오는 것이 검사 실패의 증거는 아닙니다. 분산 자체가 결과이며, 사전에 정한 aggregate와 worst-seed gate가 그 분산을 어떻게 판정할지 결정합니다.
이 두 검사를 섞으면 잘못된 결론이 생깁니다. 같은 seed 두 번의 checkpoint가 동일하다고 해서 다른 seed에서도 좋은 정책이 된다는 보장은 없습니다. 반대로 세 seed에서 비슷한 개선이 나왔다고 해서 동일 seed를 다시 돌렸을 때 tensor까지 같은 deterministic pipeline임을 증명하지도 않습니다.
M68은 효과를 재현했지만 한 seed의 tail 때문에 멈췄습니다
asymmetric actor–critic의 M68 구조는 sealed M62/2100 parent에서 같은 architecture·reward·optimizer·residual bound를 유지하고 seed 42·43·44의 125-update endpoint를 비교했습니다. 각 run은 4,096개 환경을 사용했고 seed 43·44는 각각 12.29M transition을 처리했습니다. 세 seed 모두 vertical CAM z RMSE와 arm contribution을 개선했습니다.
| training seed | z RMSE 개선 | arm contribution 개선 | saturation | 판정 |
|---|---|---|---|---|
| 42 | +3.77% | +6.43% | 0% | 목표 효과 재현 |
| 43 | +4.09% | +5.98% | 0% | 목표 효과 재현 |
| 44 | +3.67% | +5.88% | 0.003125% | strict gate 실패 |
median만 보면 z 개선 3.77%, arm 개선 5.98%였습니다. route·survival·crossing·구조·action-rate gate도 세 seed에서 통과했습니다. 그럼에도 zero-saturation rule은 all-seed 조건이었습니다. seed 44의 한 표본을 평균으로 희석하지 않았기 때문에 판정은 learning_effect_reproduced_promotion_blocked였습니다.
이 사례가 보여 준 것은 seed 44가 나쁜 seed라는 결론이 아닙니다. 극단적인 normalized CAM input에서 현재 architecture의 tail이 드러났다는 것입니다. 그래서 다음 행동은 seed 44를 제외하거나 bound를 넓히는 일이 아니라, 그 표본의 phase와 CAM component를 추적하는 non-learning 진단이었습니다.
M69는 tail을 제한했지만 승인 범위를 arm subsystem으로 남겼습니다
M69는 raw normalized CAM error를 tanh(error)로 바꾸는 한 가지 구조 변경만 적용했습니다. reward, 45차원 arm observation, 8×138 feedback map, optimizer, M62 parent, ±0.20 residual bound는 유지했습니다. seed 42·43·44를 각각 fresh 125 update, 4,096개 환경에서 실행했으며 seed당 12.29M transition이었습니다.
세 endpoint의 z RMSE 개선은 3.54~4.37%, arm contribution 개선은 5.48~6.66%였습니다. termination, measured foot crossing, saturation과 tail은 모두 0이었습니다. M68에서 발견한 rare input path를 제한한 뒤에도 효과가 세 training seed에서 유지된 것입니다.
그렇다고 human-like whole-body gait가 재현됐다는 뜻은 아니었습니다. 10초 robot/reference overlay에서 팔이 body center를 가로지르는 장면과 다리·팔 endpoint 차이가 남았습니다. 그래서 M69의 상태는 bounded CAM-arm subsystem accepted였고, whole-body parent promotion은 보류됐습니다. multi-seed 재현성은 승인 조건 하나를 채웠을 뿐 승인 범위를 자동으로 넓히지 않습니다.
현재 manifest가 남기는 것과 아직 빠진 것을 구분했습니다
train.py는 학습 디렉터리에 run_manifest.json을 씁니다. task, seed, device, 환경 수, 최대 iteration, agent config 경로와 SHA-256, 실제 runner config, parent checkpoint 경로와 SHA-256, 전체 command arguments가 들어갑니다. checkpoint resume 상태 글에서 설명했듯이 checkpoint와 manifest를 함께 봐야 다음 update의 출발점을 복원할 수 있습니다.
| 현재 명시적으로 기록 | 아직 명시적 필드가 없음 |
|---|---|
| task·seed·device·num_envs·max_iterations | GPU model·driver version |
| agent config 경로와 SHA-256 | Isaac Sim·Isaac Lab·PhysX version |
| runner config와 전체 CLI arguments | PyTorch·CUDA·RSL-RL version |
| parent checkpoint 경로와 SHA-256 | workspace commit SHA와 dirty-state fingerprint |
| 실행 요청의 seed provenance | 첫 observation/action/rollout hash와 결정론 검사 결과 |
이 표의 오른쪽 항목은 현재 구현됐다고 주장하지 않습니다. 다음 reproducibility manifest에 추가해야 할 gap입니다. 특히 local HEAD와 실행 config가 달랐는지, driver가 바뀌었는지, 같은 이름의 checkpoint가 실제로 같은 파일인지 확인하려면 seed 외의 fingerprint가 필요합니다.
제가 다음 PPO 실행 전에 적용할 재현성 검사 순서
- 난수 소유권을 적습니다. training, terrain, scenario, observation noise, push 등 각 sampler의 seed와 생성 시점을 분리합니다.
- runtime fingerprint를 봉인합니다. commit·dirty state, config와 parent hash, GPU·driver, Isaac·PyTorch·CUDA·RSL-RL version을 manifest에 남깁니다.
- same-seed short repeat를 먼저 돌립니다. 동일한 fresh process 두 개에서 첫 reset observation, 첫 action, N-step rollout과 one-update checkpoint hash를 비교합니다.
- 첫 divergence에서 멈춥니다. 마지막 reward가 다르다는 사실보다 observation→action→physics→optimizer 중 어디서 처음 갈라졌는지를 찾습니다.
- 그 다음에 multi-seed를 실행합니다. 다른 training seed에 대해 같은 parent·configuration·update 수와 고정된 evaluation gate를 적용합니다.
- 평균과 worst seed를 함께 판정합니다. 한 seed의 safety tail을 평균 개선으로 상쇄하지 않고, 승인 범위를 candidate·subsystem·parent로 구분합니다.
strict deterministic mode는 일반 학습 성능을 높이는 옵션이 아닙니다. regression을 빠르게 찾기 위한 진단 surface입니다. 지원되지 않는 CUDA 연산이 오류를 내거나 처리량이 줄 수 있으므로, 짧은 same-seed canary에서 먼저 사용하고 일반 throughput run과 결과를 섞지 않아야 합니다.
현재 증거가 답하는 범위
현재 G1 학습 entrypoint의 seed 배선과 run manifest는 implemented 상태입니다. M68·M69의 seed 42·43·44 학습과 endpoint 평가는 executed·observed 상태입니다. M68은 learning effect가 세 seed에서 재현됐지만 strict saturation gate로 rejected됐고, M69는 bounded arm subsystem만 accepted됐습니다.
반면 같은 commit·hardware·runtime에서 fresh seed 42 training을 두 번 실행해 첫 rollout과 checkpoint tensor가 일치하는지 확인한 표준 실험은 아직 없습니다. software·driver·GPU fingerprint도 manifest의 명시적 필드로 봉인되지 않았습니다. 따라서 현재 근거로 “seed 42이면 학습을 정확히 다시 만들 수 있다”고 말할 수 없습니다.
seed를 고정하는 목적은 결과를 똑같이 보이게 만드는 것이 아니라, 차이가 생겼을 때 그 차이를 설명할 수 있는 경계를 만드는 것입니다. 다음 검사는 더 많은 seed sweep이 아닙니다. 짧은 fresh same-seed canary 두 개를 동일 runtime에서 실행하고, 첫 observation·action·rollout hash와 one-update checkpoint를 순서대로 비교하는 것입니다. 그 검사를 통과한 뒤에야 multi-seed 분산을 architecture와 objective의 결과로 더 자신 있게 해석할 수 있습니다.
기술 기준: origin/main@ee4d96e의 training/rl/train.py, training/rl/g1_policy_config.py, G1 flat·rough configuration, training/eval/eval_rl.py, RSL-RL runner와 M68·M69 실행 보고서를 대조했습니다. 공식 Isaac Lab·PhysX·PyTorch 문서는 결정론의 범위를 설명하는 기준으로 사용했으며, 이 workspace에서 strict deterministic training을 이미 검증했다는 주장으로 사용하지 않았습니다.