2026년 7월 12일의 M31 FP1c 실험에서는 child A가 예정된 200 control step을 모두 실행했습니다. 종료 코드도 0이었고 timeout과 남은 descendant process도 없었습니다. 프로세스 관점에서는 깔끔한 종료였습니다. 그래도 child B는 시작하지 않았습니다.
이유는 A가 만든 artifact의 dtype이 계약과 달랐기 때문입니다. RSL wrapper에서 나온 dones가 torch.int64[16]였고, 이를 그대로 저장하면서 transition__done과 transition__alive도 정수 tensor가 됐습니다. 승인된 artifact는 bool tensor를 요구했습니다. A가 살아 있었는지, 몇 step을 돌았는지, 정상 종료했는지는 B가 필요로 하는 입력이 유효하다는 증거가 아니었습니다. parent orchestrator는 검증에서 멈췄고 B를 띄우지 않았습니다.
이 사건은 ROS 2 launch를 설계할 때도 그대로 적용됩니다. launch 파일에 state estimator, policy, command bridge를 순서대로 적고 세 프로세스가 모두 떠 있다고 해서 로봇이 준비된 것은 아닙니다. 앞 단계가 다음 단계가 요구하는 정확한 readiness evidence를 만들었을 때만 dependency graph를 진행해야 합니다. 현재 workspace에는 아직 ROS 2 package, .launch.py, LifecycleNode 기반 bringup이 없습니다. 이 글은 구현 완료 보고가 아니라, 지금 분리돼 있는 router·OpenVLA·Isaac 실행 경로와 offline orchestrator의 선례를 바탕으로 live G1 bringup에 필요한 계약을 정리한 기록입니다.
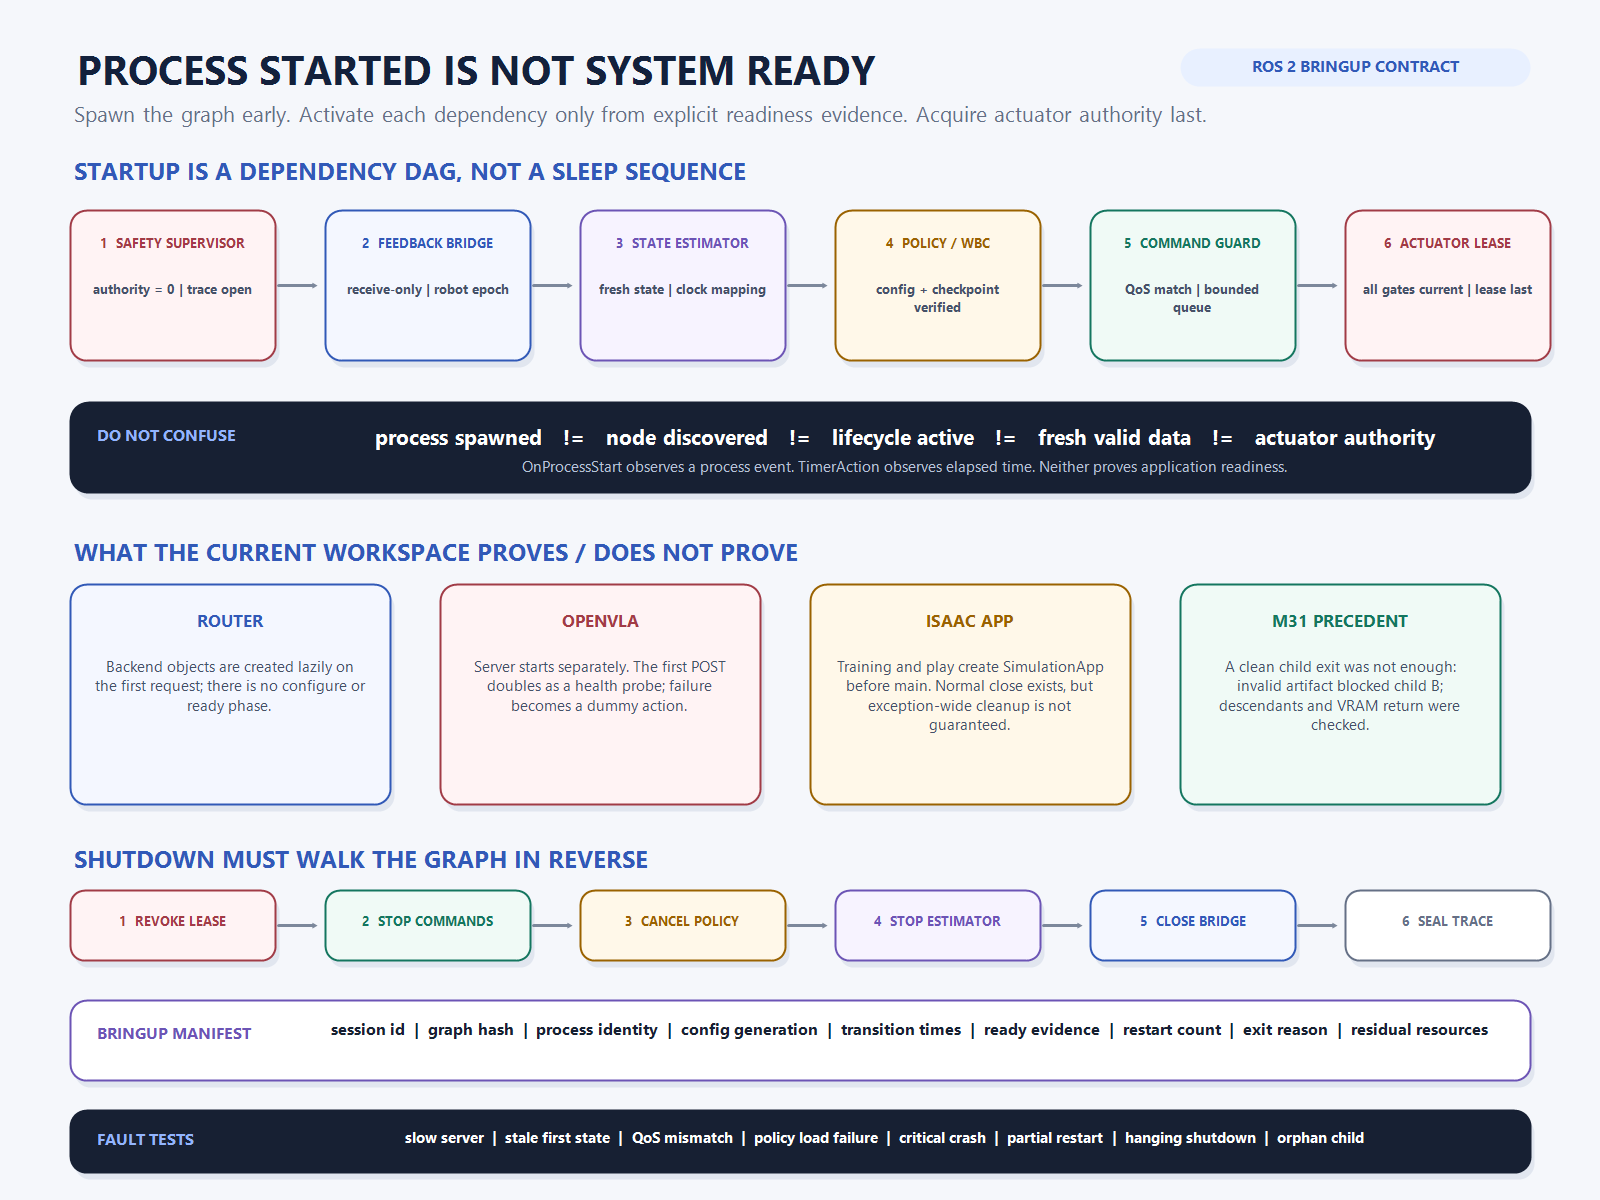
현재 workspace에는 하나의 bringup 명령이 없습니다
지금 프로젝트의 실행 경로는 목적별 CLI로 나뉘어 있습니다. router smoke test는 robot-control-router/scripts/run_backend_once.py로 시작합니다. OpenVLA server는 README에 적힌 것처럼 별도 terminal에서 먼저 실행해야 합니다. Isaac Lab 학습과 재생은 각각 training/rl/train.py, training/rl/play.py가 AppLauncher를 생성하고 simulation environment와 runner를 만듭니다. Humanoid adapter의 apply_to_sim()는 아직 Isaac articulation에 command를 쓰지 않고 앞쪽 숫자를 출력합니다.
저장소 전체에서 ROS 2 package의 package.xml, setup.py, CMakeLists.txt, Python·XML·YAML launch file을 찾지 못했습니다. H1 asset 아래에는 ROS 1 시절의 display.launch와 gazebo.launch가 있지만, 현재 G1 router runtime을 구성하는 ROS 2 bringup은 아닙니다. 연구 노트에 rclpy와 rclcpp 예제가 일부 있을 뿐 executable node 구현도 없습니다.
따라서 “launch 파일 하나를 추가하면 현재 시스템이 연결된다”고 쓰면 단계를 건너뜁니다. 먼저 각 executable의 입력·출력·종료 계약이 있어야 하고, 그다음 launch가 이들을 실행하고 관찰할 수 있습니다. 현재는 어떤 process가 먼저 살아야 하는지보다, 아직 process로 분리되지 않은 component가 무엇인지부터 inventory해야 하는 상태입니다.
launch가 보장하는 것은 실행 요청과 process event입니다
ROS 2 공식 launch tutorial은 launch file을 여러 node와 설정을 함께 시작하는 수단으로 설명합니다. Python·XML·YAML 형식을 사용할 수 있고, Python launch에서는 generate_launch_description()이 LaunchDescription을 반환합니다. 여기까지는 여러 terminal 명령을 한곳에 모으는 기능입니다.
ROS 2 launch system 설계 문서는 한 단계 더 나아갑니다. launch system은 어떤 program을 어떤 argument·environment·working directory로 실행할지 기술하고, 시작한 process의 stdout·stderr·exit code와 signal을 관찰하며, event에 반응합니다. process exit에 따라 다른 process를 시작하거나 전체 shutdown을 요청할 수 있습니다.
그렇지만 OnProcessStart가 알려 주는 것은 operating system process가 시작됐다는 사실입니다. Python interpreter가 실행됐지만 아직 checkpoint를 읽는 중일 수 있고, FastAPI server가 port를 열기 전에 model을 GPU로 올리는 중일 수 있습니다. ROS node가 생성됐더라도 subscription discovery가 끝나지 않았거나 첫 sensor message를 받지 못했을 수 있습니다. launch는 process event를 관찰할 수 있지만 application-specific readiness를 자동으로 추론하지 않습니다.
ROS 2에서는 process와 node의 경계부터 다릅니다
ROS 2에서는 한 process에 여러 composable node가 들어갈 수 있습니다. 반대로 하나의 기능이 remote inference server와 ROS client처럼 여러 process에 걸칠 수도 있습니다. 그래서 process가 죽었다는 사실과 특정 node가 사라졌다는 사실을 같은 것으로 취급할 수 없습니다. launch 설계 문서도 ROS 1과 달리 node와 process를 명확히 구분해야 한다고 설명합니다.
G1 runtime에 적용하면 세 종류의 identity가 필요합니다.
- process identity: PID만 아니라 creation time과 executable·argv·environment hash를 포함합니다. PID는 재사용될 수 있습니다.
- node identity: fully qualified node name, namespace, lifecycle epoch, executor 또는 component container identity를 포함합니다.
- control identity: config generation, checkpoint hash, joint manifest hash, robot epoch, authority lease epoch를 포함합니다.
같은 process 안에서 policy component만 unload됐다면 process heartbeat는 살아 있습니다. 반대로 process가 재시작돼 같은 node name을 다시 등록해도 이전 lifecycle epoch와 command authority를 이어받아서는 안 됩니다. “node가 graph에 보인다”는 진단과 “현재 robot epoch의 command를 보낼 수 있다”는 판단을 분리해야 합니다.
TimerAction은 readiness gate가 아니라 경과 시간 조건입니다
의존 순서를 빠르게 맞출 때 흔히 쓰는 방법은 “A를 띄우고 일정 시간 뒤 B를 시작한다”는 timer입니다. ROS 2의 TimerAction은 지정한 시간이 지난 뒤 action을 한 번 실행합니다. 이 기능 자체는 정확하지만, 경과 시간이 application readiness를 뜻하지는 않습니다.
OpenVLA를 예로 들면 model load 시간은 GPU cache, checkpoint 유무, CUDA 초기화 상태에 따라 달라질 수 있습니다. 고정 지연은 어떤 실행에서는 불필요하게 길고 다른 실행에서는 부족합니다. 더 위험한 경우는 기다리는 동안 process가 살아 있었지만 endpoint가 계속 오류를 반환하는 경우입니다. timer는 실패를 지연시킬 뿐 상태를 확인하지 않습니다.
timer는 최대 대기 시간과 polling cadence를 구현하는 보조 수단으로는 쓸 수 있습니다. 하지만 진행 조건은 별도의 predicate여야 합니다. “OpenVLA process 시작 후 설정된 deadline까지 health endpoint를 확인한다”는 구조라면 경과 시간은 중단 조건이고, health response의 model identity·action schema·device 상태가 readiness evidence입니다. 현재 OpenVLA client에는 별도 health 호출이 없고 첫 /act POST가 사실상 연결 시험까지 겸합니다.
readiness는 node마다 다른 증거 묶음이어야 합니다
모든 node에 공통 /ready=true 하나를 붙이면 다시 의미가 흐려집니다. state estimator의 ready와 policy server의 ready는 요구하는 증거가 다릅니다. boolean 자체보다 어떤 조건으로 계산됐는지와 그 조건의 freshness가 중요합니다.
| component | spawn 이후 필요한 readiness evidence | 실패 시 허용되는 진행 |
|---|---|---|
| safety supervisor | authority epoch 생성, safe controller 연결, trace writer 준비, 초기 lease owner 없음 | 다른 process는 진단용으로 띄울 수 있으나 command authority는 항상 0 |
| feedback bridge | robot identity, hardware mode, robot tick epoch, 첫 유효 packet, command channel은 비활성 | estimator activation 금지 |
| state estimator | fresh input, clock mapping, frame·unit schema, finite state, uncertainty 범위 | policy는 configure 가능하지만 active 금지 |
| RL/WBC policy | config generation, checkpoint·joint manifest hash, observation/action dimension, dummy 금지 | shadow 계산도 시작하지 않거나 명시된 diagnostic mode만 허용 |
| command guard | QoS endpoint match, bounded queue, stale/drop policy, hardware interface identity | publisher inactive, safe hold만 유지 |
| actuator lease | 위 모든 snapshot이 같은 robot·config·lifecycle epoch에서 current | 하나라도 빠지면 lease 발급 금지 |
이 표의 세부 메커니즘은 이미 다른 글이 소유합니다. QoS compatibility는 ROS 2 QoS 계약, clock mapping은 timestamp 동기화 계약, callback 대기는 executor·backpressure 계약, 개별 node의 configure·activate는 Lifecycle Node 계약, config generation은 parameter runtime manifest 계약에 남겨 둡니다. 이번 글의 책임은 그 증거들이 어떤 dependency를 열고 닫는지입니다.
시작 순서는 process 목록보다 dependency DAG로 표현해야 합니다
Dependency DAG는 방향성은 있지만 순환하지 않는 graph입니다. “policy는 estimator의 fresh state와 config bundle에 의존한다”, “command guard는 policy output과 safety supervisor에 의존한다”처럼 다음 단계가 요구하는 입력을 edge로 표현합니다. launch description의 줄 순서와는 다른 구조입니다.
G1 bringup의 첫 목표 순서는 다음처럼 잡을 수 있습니다.
- safety supervisor와 trace path를 먼저 띄우고
authority=0인 새 bringup session을 엽니다. - hardware bridge를 receive-only로 시작해 robot identity와 tick epoch를 고정합니다.
- state estimator를 configure하고 첫 fresh state·clock mapping·frame schema가 맞을 때 active로 전환합니다.
- RL 또는 WBC node가 config·checkpoint·joint manifest를 검증하고 inactive 상태에서 readiness snapshot을 만듭니다.
- command guard와 managed publisher의 QoS·queue·hardware mode를 검증하되 output은 계속 막아 둡니다.
- 전체 snapshot이 같은 epoch에서 current일 때 candidate를 active로 전환합니다.
- 마지막 별도 transaction으로 actuator lease를 발급합니다.
Kilted의 OnStateTransition은 LifecycleNode의 state transition에 반응하는 event handler이고, LifecycleTransition은 지정 node를 목표 state로 전환하는 action을 구성합니다. 따라서 “estimator가 Active가 되면 policy configure를 요청한다” 같은 graph는 launch event로 연결할 수 있습니다.
다만 lifecycle Active만으로 edge를 열어서는 안 됩니다. Active transition event와 application readiness snapshot을 함께 확인해야 합니다. transition 직후 첫 state가 아직 없거나 config generation이 바뀌었다면 downstream은 닫힌 채로 있어야 합니다. launch가 event를 전달하고, 별도의 supervisor node가 여러 evidence를 같은 시점의 snapshot으로 묶는 역할 분담이 적절합니다.
현재 OpenVLA 경로는 첫 작업 요청이 health check까지 떠안습니다
README의 OpenVLA 실행 절차는 server를 별도 terminal에서 먼저 시작한 뒤 router config의 endpoint를 맞추도록 되어 있습니다. 하지만 router는 server process를 소유하지 않고, OpenVLAClient에도 별도의 health·model identity handshake가 없습니다. 첫 task가 들어오면 image를 base64로 읽고 /act에 POST합니다.
서버가 없거나 image가 없거나 response schema가 잘못되면 client는 7차원 dummy action을 반환합니다. VLABackend는 이 action을 postprocess한 뒤 status="ok"인 response를 만듭니다. 즉, 현재 smoke test에서는 unavailable dependency가 process startup failure로 드러나지 않고 정상 모양의 action으로 바뀔 수 있습니다.
이 경로가 잘못됐다고 단정할 수는 없습니다. GPU server 없이 router interface를 시험하려는 dummy 목적에는 유용합니다. 문제는 diagnostic dummy와 live readiness가 같은 response surface를 쓰는 점입니다. 실제 bringup에서는 VLA node가 configure 단계에서 endpoint health, model ID, expected action schema, timeout budget을 검증하고, dummy 허용 여부를 명시해야 합니다. live profile에서는 dummy가 readiness를 만족시키면 안 됩니다.
router의 lazy initialization은 첫 command를 startup test로 만듭니다
Runner._get_backend()는 backend가 처음 선택될 때 객체를 생성하고 cache합니다. RL checkpoint load나 WBC module 초기화도 첫 request 경로에서 일어날 수 있습니다. 이런 lazy initialization은 CLI smoke test를 빠르게 시작하는 데는 편하지만, live control에서는 첫 명령의 latency와 실패 원인을 예측하기 어렵게 만듭니다.
더구나 Runner.run()은 primary backend가 예외를 내면 selector가 지정한 fallback을 같은 request 안에서 즉시 생성하고 실행합니다. fallback도 실패하면 첫 error response가 남지만, 두 번째 실패의 상세 상태는 별도 transition record로 보존되지 않습니다. 현재 log는 response 단위 JSON이지 bringup session과 process topology의 기록이 아닙니다.
bringup에서는 backend construction을 configure 단계로 옮기고, 첫 command 전에 checkpoint와 resource allocation을 끝내야 합니다. fallback도 “primary가 실패했으니 바로 다른 action을 보낸다”가 아니라 authority supervisor가 primary lease를 회수하고 fallback의 readiness snapshot을 새로 확인한 뒤 별도 epoch로 승격해야 합니다. 이 승격 상세는 shadow·canary·rollback 글의 책임이고, launch는 필요한 process와 lifecycle transition을 관리합니다.
재시작 가능 여부는 dependency subtree의 크기로 결정합니다
모든 process crash에 전체 시스템 종료로 대응하면 가용성이 떨어지고, 모든 process를 자동 respawn하면 새 process가 이전 권한을 조용히 이어받을 수 있습니다. 재시작 정책은 해당 component가 어떤 state를 소유하는지와 downstream이 그 state에 의존하는지로 나눠야 합니다.
| 실패 component | 즉시 조치 | 재시작 범위 | 자동 authority 복원 |
|---|---|---|---|
| 비제어 dashboard | 진단 누락 표시 | 해당 process만 가능 | 해당 없음 |
| trace writer | incident buffer 보존, 신규 승격 차단 | writer와 sink만; control 지속 허용 여부는 정책으로 고정 | 금지 |
| policy/VLA/WBC | candidate lease 회수, safe hold | policy 이하 command subtree 재검증 | 금지 |
| state estimator | 모든 learned command 중단 | estimator와 모든 downstream policy·guard | 금지 |
| hardware bridge | safe controller 또는 hardware E-stop 경로 | robot epoch을 새로 열고 전체 subtree 재구성 | 금지 |
| safety supervisor | 외부 watchdog이 authority를 0으로 강제 | 전체 bringup session 재시작 | 절대 금지 |
특히 critical node의 respawn=true 같은 설정만으로는 부족합니다. 새 process는 새 lifecycle epoch와 config snapshot을 가져야 하고, 이전 lease는 만료돼야 합니다. process 이름과 node 이름이 같다는 이유로 이전 authority를 복원하면 crash가 순간적인 command ownership 중복으로 바뀔 수 있습니다.
shutdown은 시작 목록을 거꾸로 닫는 작업이 아닙니다
단순한 application은 생성한 resource를 역순으로 close하면 충분합니다. 로봇 제어에서는 종료 전에 command authority를 먼저 제거해야 합니다. policy process를 먼저 죽였는데 마지막 command가 hardware bridge의 buffer에 남아 있거나 publisher가 계속 active라면, “policy가 종료됐다”와 “actuator가 안전하다” 사이에 빈 구간이 생깁니다.
권장 종료 순서는 다음과 같습니다.
- actuator lease를 회수하고 command epoch을 증가시켜 이전 command를 모두 무효화합니다.
- managed command publisher와 guard를 deactivate하고 safe hold가 적용됐다는 acknowledgement를 확인합니다.
- 진행 중인 policy inference와 remote VLA request를 취소하고 새 task 접수를 막습니다.
- policy·WBC node를 shutdown한 뒤 state estimator의 consumer가 0인지 확인합니다.
- estimator와 feedback bridge를 내리고 hardware channel과 GPU·simulation resource를 닫습니다.
- exit code, 남은 descendant, 마지막 lifecycle/config/authority epoch을 trace에 seal한 뒤 supervisor를 종료합니다.
ROS launch에는 OnProcessExit와 OnShutdown event handler가 있고, process 종료 event에는 대상과 exit code를 연결할 수 있습니다. launch system 설계는 shutdown 시 signal을 보내고 process event에 반응하는 책임을 명시합니다. 그러나 safe hold acknowledgement나 residual GPU allocation은 application-specific이므로 launch event만으로 끝나지 않습니다. bounded graceful shutdown deadline 뒤 terminate·kill로 escalation하고, 어느 단계에서 강제 종료됐는지를 manifest에 남겨야 합니다.
현재 학습 스크립트도 정상 경로의 close와 실패 경로의 close가 다릅니다
training/rl/train.py는 학습이 끝난 뒤 env.close()와 simulation_app.close()를 호출합니다. 정상 종료 경로는 보입니다. 하지만 runner.learn() 전체를 감싸는 try/finally가 아니므로 중간 예외가 나면 두 close가 실행된다는 보장은 없습니다.
training/rl/play.py에는 keyboard subscription 해제를 위한 finally가 있습니다. 다만 env.close()와 simulation_app.close()는 그 finally 바깥, loop 뒤에 있습니다. loop에서 예외가 전파되면 subscription은 해제되지만 뒤의 environment close까지 도달하지 않을 수 있습니다. 이 코드는 live robot bringup이 아니라 Isaac 재생 도구이므로 곧바로 안전 결함이라고 부를 수는 없습니다. 다만 shutdown contract를 별도 계층으로 다뤄야 한다는 근거는 됩니다.
초기의 training/auto/auto_rl_loop.py도 training process와 checkpoint watcher를 함께 띄운 뒤 training이 끝나면 watcher에 terminate()를 보냅니다. 그 뒤 watcher가 실제로 종료됐는지 wait하거나 강제 kill하고 descendant를 확인하는 절차는 이 함수에 없습니다. “종료 신호를 보냈다”와 “resource가 회수됐다”를 구분해야 하는 또 다른 예입니다.
M31 orchestrator는 다음 process보다 검증 artifact를 먼저 요구했습니다
M31의 후속 orchestrator는 더 강한 process contract를 구현했습니다. Windows Job Object를 먼저 만들고 active process limit과 kill-on-close를 설정한 뒤, child를 suspended 상태로 생성해 Job에 할당하고 나서 resume합니다. stdout·stderr capture와 실행 시간에 상한을 두며, 종료 뒤 active process·descendant·VRAM 반환을 검사합니다. retry count도 0으로 고정했습니다.
FP1c에서 child A는 exit code 0으로 끝났지만 artifact validator가 dtype mismatch를 발견했고 B는 시작하지 않았습니다. 이것이 이번 글에서 가져올 핵심 선례입니다. process event는 dependency gate의 입력 중 하나일 뿐, 다음 process를 여는 최종 조건이 아닙니다.
이 선례를 ROS 2에 그대로 복사할 수는 없습니다. M31은 승인된 단발성 Isaac child process와 immutable artifact를 다루는 offline 실험입니다. live ROS graph는 지속적으로 바뀌는 topic freshness, lifecycle state, authority lease를 다룹니다. 그래도 child identity를 실행 전에 고정하고, 다음 단계를 validation 뒤에만 열며, 종료 뒤 descendant와 resource 반환을 확인하는 원칙은 동일합니다.
bringup manifest는 누가 언제 준비됐다고 판단했는지 남겨야 합니다
launch console만 보면 process가 어느 순서로 로그를 출력했는지는 알 수 있지만, 어떤 readiness predicate가 downstream을 열었는지는 복원하기 어렵습니다. 최소 bringup manifest에는 다음 정보가 필요합니다.
{
  "bringup_session_id": "...",
  "dependency_graph_sha256": "...",
  "robot_epoch": 12,
  "nodes": [{
    "node": "/g1/state_estimator",
    "process_identity": {"pid": 4120, "creation_time": "...", "argv_sha256": "..."},
    "config_generation": 19,
    "transitions": [
      {"state": "inactive", "monotonic_ns": 1234},
      {"state": "active", "monotonic_ns": 5678}
    ],
    "ready_evidence": {
      "first_fresh_robot_tick": 184221,
      "clock_mapping_id": "...",
      "joint_manifest_sha256": "..."
    },
    "restart_count": 0,
    "exit": null
  }],
  "authority": {"lease_epoch": 44, "acquired_after_all_gates": true}
}
manifest의 시간은 한 clock 문자열만 적지 말고 host monotonic과 robot tick mapping을 함께 가져야 합니다. node가 재시작되면 같은 이름 아래 새 process identity와 lifecycle epoch를 append합니다. shutdown에서는 요청 reason, lifecycle response, exit code, signal escalation, 남은 descendant·GPU resource를 기록합니다. incident가 발생하면 incident bundle이 해당 bringup session과 authority epoch를 참조합니다.
launch test는 “모두 떴다”보다 실패 때 무엇이 닫히는지를 검증해야 합니다
launch_pytest 공식 문서는 여러 process를 포함한 launch test에서 exit code, 예상치 못한 process death, stdout·stderr, command line, shutdown 결과를 검사할 수 있다고 설명합니다. ReadyToTest action은 test를 시작해도 된다는 test framework의 신호입니다. 이것을 실제 robot application의 readiness로 오해해서는 안 됩니다.
launch_testing_ros에는 지정 topic을 기다리는 WaitForTopics도 있습니다. topic을 한 번 받았다는 것은 wiring smoke에는 유용하지만, timestamp가 fresh한지, frame과 unit이 맞는지, config generation이 같은지는 별도 assertion이 필요합니다.
첫 test suite는 actuator authority를 항상 0으로 고정한 mock hardware에서 다음 fault를 주입해야 합니다.
- OpenVLA process는 살아 있지만 health endpoint가 늦게 준비되도록 하고 timer만으로 policy가 활성화되지 않는지 확인합니다.
- feedback topic은 존재하지만 첫 message가 stale하거나 robot epoch이 다를 때 estimator activation을 막습니다.
- estimator는 Active지만 QoS endpoint가 맞지 않거나 config generation이 바뀐 경우 policy downstream을 닫습니다.
- checkpoint load failure와 dummy VLA를 각각 주입하고 command publisher가 inactive인지 검사합니다.
- critical node가 activation 전·후에 exit하도록 하여 authority가 0을 유지하거나 먼저 회수되는지 확인합니다.
- dashboard 같은 noncritical process만 재시작할 때 control epoch이 불필요하게 바뀌지 않는지 봅니다.
- estimator를 재시작하면 policy·guard subtree가 함께 무효화되고 자동 authority 복원이 없는지 확인합니다.
- shutdown callback을 의도적으로 hang시키고 escalation reason, exit code, descendant 0, resource 반환이 manifest에 남는지 확인합니다.
가장 중요한 assertion은 모든 process가 실행 중이라는 조건이 아닙니다. 어떤 fault에서도 readiness graph가 잘못 열린 적이 없고, command record가 존재한다면 그 command가 유효한 bringup session·config generation·authority lease를 가리킨다는 조건입니다.
첫 구현은 launch 파일보다 dependency contract부터입니다
현재 저장소에 바로 g1_bringup.launch.py를 추가하면 실제 node가 없는 상태에서 shell command만 묶는 파일이 될 가능성이 큽니다. 먼저 각 component의 owner와 readiness schema를 Python dataclass 또는 message schema로 정의하는 편이 낫습니다.
- router, estimator, policy, adapter, safety supervisor, hardware bridge를 어떤 process와 node로 분리할지 정합니다.
- 각 node의 configure input, readiness evidence, lifecycle transition, shutdown acknowledgement를 문서와 mock으로 만듭니다.
- dependency DAG와 restart domain을 정의하고 graph hash를 계산합니다.
- authority 0 mock supervisor가 evidence snapshot을 검증해 edge를 여닫도록 구현합니다.
- 개별 node를 LifecycleNode로 옮기고 parameter generation과 QoS·clock evidence를 연결합니다.
- 그 다음 Python launch description에서 process spawn, lifecycle event, failure propagation, shutdown handler를 wiring합니다.
launch_pytest에서 delayed ready·crash·partial restart·hanging shutdown을 통과한 뒤에만 Isaac bridge를 붙입니다.
이 단계까지 끝나도 실물 G1 command authority는 별도 승인 대상입니다. launch test는 process와 node orchestration을 검증하고, simulator-in-the-loop test는 command와 state의 시간·interface를 검증하며, hardware test는 safe controller와 lease 회수를 검증합니다. 하나의 green check로 세 범위를 대신하지 않습니다.
로봇의 시작은 마지막 process가 뜬 순간이 아닙니다
ROS 2 launch는 여러 executable을 재현 가능한 구성으로 시작하고 process event에 반응하는 기반입니다. 그러나 줄 순서, OnProcessStart, 일정한 sleep, node discovery 중 어느 것도 application readiness를 대신하지 않습니다. 특히 policy·estimator·hardware bridge가 연결된 시스템에서는 “살아 있음”과 “유효한 입력을 생산함”과 “actuator 권한을 가짐”을 따로 기록해야 합니다.
현재 workspace의 router는 첫 request에서 backend를 만들고, OpenVLA는 첫 action 요청이 연결 시험을 겸하며, Isaac 도구의 실패 경로 cleanup은 일관된 contract로 묶여 있지 않습니다. 반면 M31 orchestrator는 clean exit 뒤에도 artifact validation이 실패하면 다음 child를 열지 않는 선례를 남겼습니다. 이 두 상태 사이의 다음 구현은 launch syntax가 아닙니다. dependency마다 필요한 readiness evidence를 정의하고, downstream을 그 증거로만 열며, shutdown에서는 actuator lease를 가장 먼저 회수하는 supervisor 계약입니다.
첫 test에서 확인할 질문도 명확합니다. 모든 node가 정상일 때 로봇이 켜지는지가 아니라, 하나가 늦고 하나가 거짓 ready를 내며 하나가 종료를 거부해도 actuator authority가 한 번도 잘못 열리지 않는가를 확인해야 합니다.