VLA 경로의 계약 테스트를 처음 돌렸을 때 결과는 6개 시나리오 모두 PASS였습니다. 그런데 테스트에 사용한 이미지 경로 중에는 실제 파일이 없는 경우도 있었습니다. 이미지가 없는데도 자연어와 영상을 해석하는 모델 테스트가 통과했다는 것은 이상했습니다.
코드를 따라가 보니 이유는 단순했습니다. OpenVLA 클라이언트는 이미지가 없거나 모델 서버에 연결하지 못하면 7차원에 가까운 0 벡터를 대신 반환했습니다. 그 결과는 status="ok"인 응답으로 포장됐고, Franka adapter는 이 말단장치 이동량을 관절각으로 바꾸지 않은 채 현재 관절 위치를 그대로 유지했습니다. 테스트가 확인한 것은 라우터가 정해진 모양의 응답을 만들 수 있는가였지, OpenVLA가 실제로 추론했는가도, 로봇이 움직였는가도 아니었습니다.
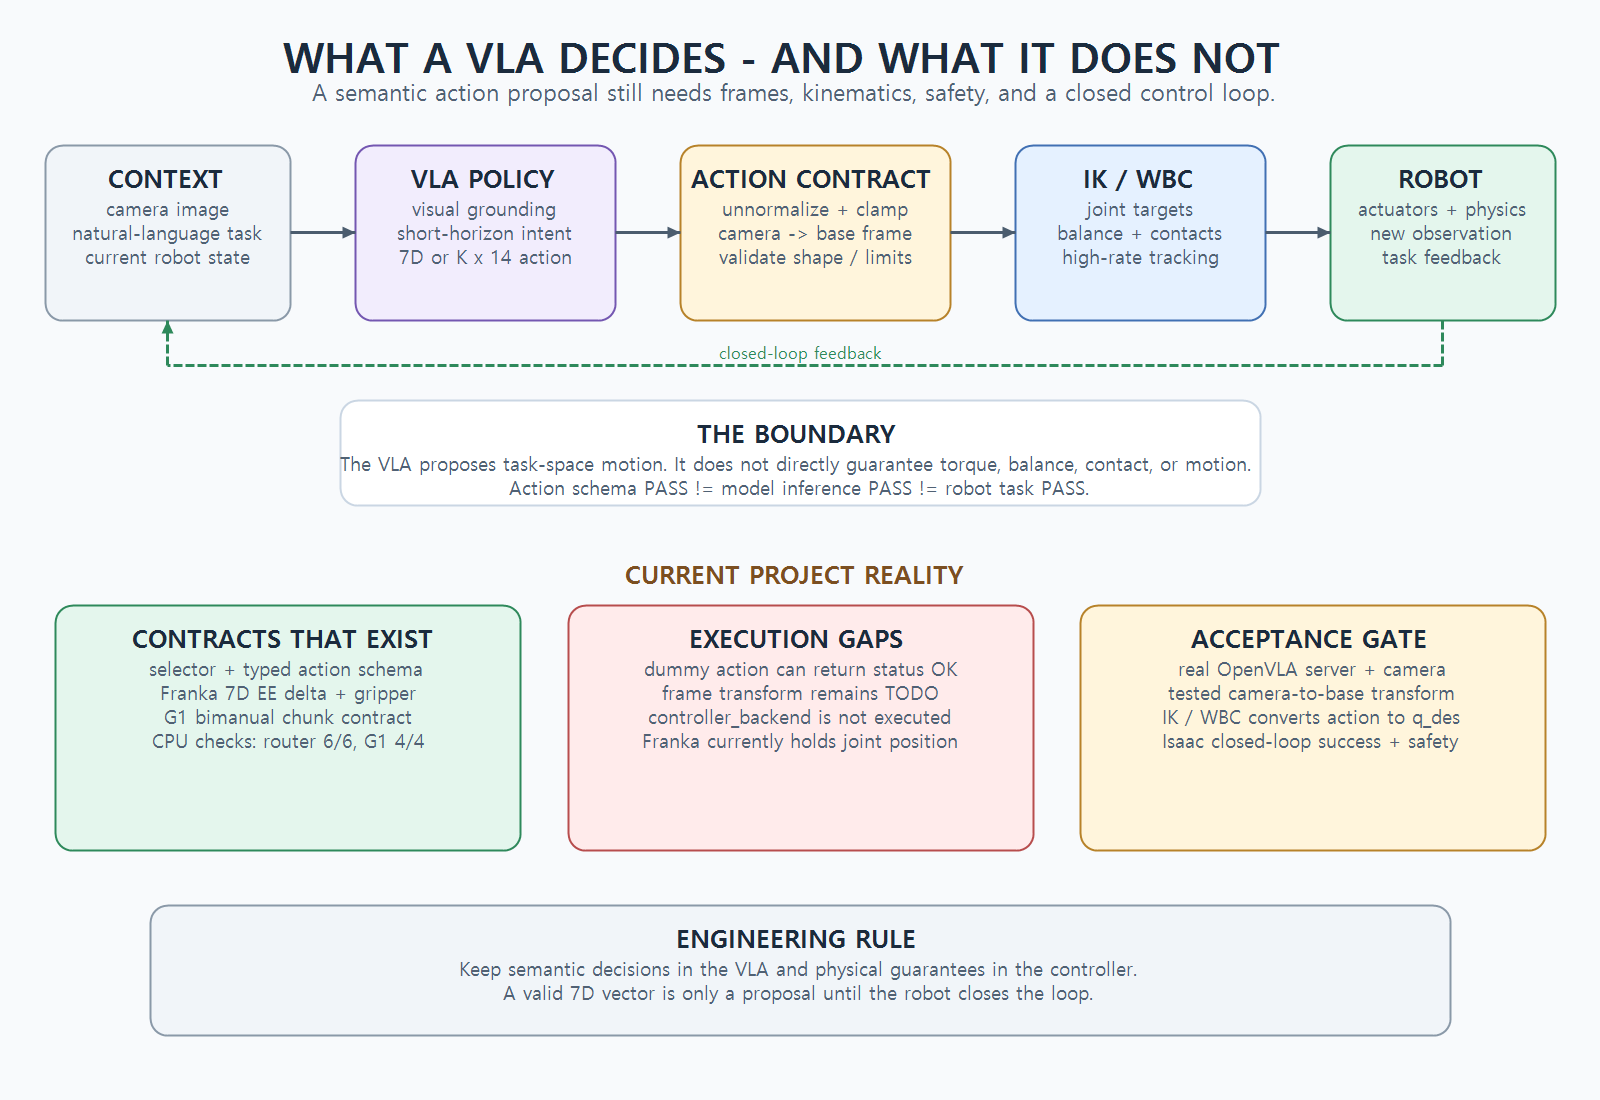
이 시행착오는 VLA를 붙일 때 가장 먼저 구분해야 할 경계를 보여줍니다. VLA가 출력한 action과 모터가 실행하는 명령은 같은 것이 아닙니다. 그 사이에는 좌표계 변환, 역기구학, 전신 제어, 안전 제한, actuator와 물리 피드백이 남아 있습니다. 이번 글에서는 그 경계를 현재 구현을 기준으로 정리합니다.
VLA가 결정하는 것은 ‘의미가 있는 짧은 행동’입니다
VLA(Vision-Language-Action)는 카메라 영상과 자연어 지시를 함께 받아 로봇의 다음 행동을 예측하는 정책입니다. 예를 들어 “빨간 블록을 집어라”라는 명령을 받았을 때 어느 물체가 빨간 블록인지 찾고, 손을 어느 방향으로 움직이며, 그리퍼를 언제 닫을지를 결정합니다. 일반적인 비전-언어 모델이 문장을 출력한다면 VLA는 로봇 데이터로 학습한 action을 출력합니다.
여기서 action은 구현마다 다릅니다. 관절 위치를 직접 예측할 수도 있고, 말단장치의 위치·자세 변화량과 그리퍼 상태를 예측할 수도 있습니다. OpenVLA는 로봇 action을 토큰으로 표현해 언어 모델의 다음 토큰 예측 문제와 연결합니다. RT-2 역시 로봇 action을 텍스트 토큰처럼 표현해 웹 규모의 비전-언어 지식과 로봇 궤적을 함께 학습했습니다. 이 구조가 자연어 이해와 행동 생성을 하나의 모델 안에 넣어 주지만, 출력 토큰이 물리적으로 안전한 토크를 자동 보장해 주는 것은 아닙니다.
현재 프로젝트의 Franka 경로는 한 번의 VLA 출력에 다음 7개 값을 사용합니다.
a_vla = [dx, dy, dz, droll, dpitch, dyaw, gripper]앞의 여섯 값은 말단장치의 위치와 자세를 얼마나 바꿀지 나타내고, 마지막 값은 그리퍼를 얼마나 열거나 닫을지 나타냅니다. 즉 VLA가 제안하는 것은 “2번 관절을 0.3rad 움직여라”가 아니라 “손을 기준 좌표계에서 앞으로 조금 이동하고 집게를 닫아라”에 가깝습니다. 이 선택은 데이터셋과 로봇이 달라도 비교적 재사용하기 쉽지만, 실제 관절을 움직이려면 별도의 변환이 반드시 필요합니다.
7차원 벡터가 관절 명령이 되기까지 네 단계가 더 남습니다
VLA 추론 뒤에 필요한 처리는 단순한 후처리가 아닙니다. 모델의 확률적 출력을 물리 시스템이 받아들일 수 있는 명령으로 바꾸는 제어 경계입니다.
- 정규화를 되돌립니다. 학습 데이터의 action은 보통 각 축의 범위에 맞춰 정규화됩니다. 추론할 때는 데이터셋 통계에 해당하는
unnorm_key로 실제 단위의 action을 복원해야 합니다. 다른 데이터셋의 통계를 사용하면 벡터의 모양은 맞아도 이동 크기가 틀어집니다. - 출력 범위를 제한합니다. 현재 OpenVLA 설정은 병진 변화량을 축마다 약 ±0.03, 회전 변화량을 ±0.05 범위로 제한합니다. 이 clamp는 한 번의 잘못된 추론이 큰 움직임으로 번지는 것을 막는 최소 장치입니다. 다만 clamp를 통과했다는 사실이 충돌 안전이나 도달 가능성을 뜻하지는 않습니다.
- 좌표계를 맞춥니다. 이미지에서 추론한 방향과 로봇 base 좌표계의 방향은 같지 않을 수 있습니다. 카메라의 앞쪽으로 3cm라는 명령을 base 좌표계의 x·y·z 이동으로 바꾸려면 외부 파라미터와 강체 변환이 필요합니다.
- IK 또는 WBC가 관절 목표를 계산합니다. 현재 관절 상태와 말단장치 목표를 이용해
q_des를 구하고, 관절 한계·자세·충돌·접촉과 같은 조건을 함께 처리합니다. 이후 actuator의 PD 제어나 토크 제어가 실제 물리를 움직입니다.
이를 식으로 단순화하면 다음과 같습니다. T는 카메라 좌표계를 base 좌표계로 바꾸는 변환이고, f_IK/WBC는 현재 로봇 상태와 task-space 목표에서 관절 목표를 구하는 함수입니다.
Δx_base = T_camera→base · Δx_vla
q_des = f_IK/WBC(q_current, Δx_base, constraints)
robot_state_next = physics(q_des, robot_state_current)
마지막 줄이 특히 중요합니다. 로봇이 움직인 뒤 새 영상과 관절 상태를 다시 관측해 다음 action을 계산해야 비로소 closed loop가 됩니다. 한 장의 이미지에서 그럴듯한 7차원 벡터를 만든 것만으로는 조작 정책이 완성되지 않습니다.
Action chunking은 제어기를 없애는 기술이 아닙니다
VLA의 추론 주기는 모터 제어 주기보다 느립니다. 매 제어 tick마다 큰 모델을 호출하면 지연과 흔들림이 커질 수 있습니다. 그래서 한 번의 추론으로 앞으로 실행할 K개의 action을 묶어 출력하는 action chunking을 사용합니다. ACT는 긴 조작 동작을 action sequence 단위로 예측해 정밀한 양팔 조작을 다뤘습니다.
A_t = [a_t, a_t+1, ..., a_t+K-1]현재 프로젝트의 단일 Franka OpenVLA 경로는 기본적으로 7차원 단일 action을 기대합니다. 반면 G1 양팔 계약은 왼손 7차원과 오른손 7차원을 합친 14차원 action, 또는 K × 14 chunk를 받을 수 있게 설계했습니다. 구형 7차원 출력이 들어오면 한 손만 활성화하고 다른 손은 대기시키는 호환 경로도 있습니다.
하지만 chunking은 저수준 제어를 대체하지 않습니다. VLA가 여러 개의 task-space waypoint를 미리 제안하더라도 각 waypoint가 도달 가능한지, 두 팔이 충돌하지 않는지, 휴머노이드가 균형을 유지하는지는 매 제어 주기마다 확인해야 합니다. chunk는 저주파 계획 구간이고, IK·WBC는 그 구간을 고주파 물리 명령으로 실현하는 계층입니다.
현재 라우터에는 VLA→WBC라는 이름은 있지만 합성 실행은 없습니다
라우터의 selector 규칙은 시각 정보가 필요한 manipulation 요청에 VLA를 선택하고 controller_backend=WBC를 함께 반환합니다. 설계 의도는 분명합니다. VLA가 의미와 task-space 목표를 만들고 WBC가 관절 수준에서 이를 실현하는 구조입니다.
그런데 현재 Runner는 선택 결과의 backend만 호출합니다. controller_backend는 응답 메타데이터에는 남지만 두 번째 실행 단계로 연결되지 않습니다. 설정 파일과 Theory의 다이어그램만 보면 VLA와 WBC가 이어진 듯 보이지만, 실행 코드에서는 아직 두 backend가 합성되지 않은 상태입니다.
Franka 쪽에는 한 단계가 더 비어 있습니다. adapter가 EE_DELTA_POSE_GRIPPER를 받으면 그리퍼 값은 명령으로 옮기지만, 팔의 q_des는 현재 관절 위치의 복사본을 반환합니다. 실제 IK는 미구현 상태입니다. 시뮬레이터에 적용하는 함수 역시 articulation을 움직이지 않고 명령을 출력하는 stub입니다. 따라서 지금 OpenVLA 서버를 정상 연결해 7차원 action을 받아도 이 경로만으로는 Franka 팔이 움직이지 않습니다.
G1 양팔 경로는 조금 더 진행돼 있습니다. 14차원 또는 chunk action을 받아 어깨·팔꿈치·손목과 허리 관절 목표로 바꾸는 CPU bridge가 있습니다. 다만 이 bridge는 코드 설명대로 dynamics-grade WBC나 IK가 아니라 관절 offset을 경험적으로 매핑하는 계약 검증용 stub입니다. 최대 관절 변화량과 base 속도 같은 안전 제한은 확인할 수 있지만, 접촉과 전신 동역학을 만족하는 양팔 조작기는 아닙니다.
| 단계 | 현재 구현 상태 | 통과했다는 말의 범위 |
|---|---|---|
| 라우팅 | VLA backend와 WBC controller_backend를 선택 | 규칙이 의도한 문자열을 반환함 |
| 모델 호출 | REST client 구현, 실패 시 dummy 7D action 반환 | 응답 schema를 만들 수 있음. 실제 추론 성공은 아님 |
| action 후처리 | shape 검사와 clamp 구현, frame transform은 미구현 | 숫자 범위를 제한함. 좌표 의미가 맞다는 보장은 없음 |
| Franka 변환 | 그리퍼만 반영, 팔 관절은 현재 위치 유지 | adapter contract 유지. 팔 동작은 없음 |
| G1 양팔 변환 | CPU heuristic bridge와 안전 제한 구현 | 14D/chunk 계약과 제한 동작 확인. 실제 WBC는 아님 |
| 시뮬레이터 적용 | 일부 경로가 print/stub 상태 | closed-loop 조작 성공을 평가하지 않음 |
6/6 PASS와 4/4 PASS가 증명한 것, 증명하지 않은 것
test_router_contract.py의 6개 시나리오와 test_g1_bimanual_contract.py의 4개 검사는 모두 통과했습니다. 이 결과는 쓸모가 있습니다. backend 선택, action type, 차원, chunk 처리, 위험한 base 속도 거부 같은 인터페이스 규칙을 CPU에서 빠르게 회귀 검사할 수 있습니다. 모델이나 Isaac Sim을 띄우기 전에 데이터 계약이 깨졌는지 찾는 용도입니다.
문제는 그 숫자를 모델 성능이나 로봇 성능으로 읽을 때 생깁니다. 누락된 이미지에서 dummy action이 나온 시나리오도 schema가 맞으면 PASS가 됩니다. 따라서 현재 결과는 다음 세 문장을 지지하지 않습니다.
- OpenVLA-7B가 현재 카메라 영상을 보고 올바른 action을 추론했다.
- VLA action이 IK 또는 WBC를 거쳐 실제 관절 명령으로 변환됐다.
- Franka나 G1이 Isaac Sim에서 지시한 물체를 집었다.
앞으로는 응답의 상태를 최소한 real_inference, dummy_fallback, failed로 구분해야 합니다. 이미지 누락이나 서버 연결 실패를 ok로 돌려보내면 파이프라인 모니터링에서 가장 중요한 실패가 사라집니다. 최근 RL backend가 checkpoint 누락과 차원 오류에 대해 position hold로 닫히도록 바뀐 것처럼, VLA 경로도 실패 원인을 숨기지 않는 fail-closed 계약이 필요합니다.
G1에서 VLA와 보행 정책의 역할을 섞지 않은 이유
현재 프로젝트에서 VLA는 시각 정보가 필요한 상체 manipulation에, RL과 WBC는 locomotion과 자세·균형 제어에 배치하고 있습니다. 이것은 VLA가 원리적으로 다리 action을 절대 출력할 수 없어서가 아닙니다. 현재 데이터와 action 표현, 실행 주기, 안전 검증 범위를 고려한 구현 경계입니다.
보행은 작은 자세 오차와 접촉 전환이 빠르게 누적됩니다. 현재 G1 PPO 정책은 73차원 관측에서 29차원 관절 위치 offset을 만들고, actuator와 물리 피드백 안에서 반복 실행됩니다. WBC-lite도 gait phase, CoM·자세, swing foot과 관절 제한을 명시적으로 다룹니다. 반면 현재 VLA 경로는 이미지와 자연어에서 손의 짧은 task-space 이동을 만드는 데 초점을 맞췄습니다. 이 출력을 그대로 locomotion loop에 넣으면 발 접촉과 균형을 누가 책임지는지 사라집니다.
따라서 지금의 합리적인 경계는 다음과 같습니다.
- VLA: 어떤 물체를 어떻게 다룰지 해석하고 짧은 말단장치 행동 또는 목표를 제안합니다.
- IK·WBC·저수준 정책: 좌표계를 맞추고 관절·접촉·균형·추종을 책임집니다.
- 안전 계층: 관절 한계, 속도, 충돌, workspace와 비정상 출력을 제한합니다.
- 평가 계층: 물체를 실제로 집었는지, 떨어뜨리지 않았는지, 로봇이 안정적인지 판정합니다.
이 역할 분리가 있어야 실패했을 때 원인을 좁힐 수 있습니다. 손이 반대 방향으로 움직였다면 frame transform을, 관절이 목표를 못 따라갔다면 IK·actuator를, 물체를 잘못 골랐다면 VLA의 시각 grounding과 데이터를 먼저 의심할 수 있습니다.
VLA 경로를 ‘구현됨’으로 바꾸기 위한 다음 검증 순서
현재 상태에서 곧바로 더 큰 VLA를 학습시키는 것은 순서가 아닙니다. 모델 이전에 실행 경계가 닫혀 있어야 학습 결과를 평가할 수 있습니다. 다음 단계는 아래 순서로 진행하는 것이 맞습니다.
- 모델 호출을 fail-closed로 바꿉니다. 실제 추론과 dummy를 상태·로그·평가 결과에서 분리하고, 이미지·endpoint·모델 이름·
unnorm_key를 함께 기록합니다. - raw action 계약을 고정합니다. 7D와 14D/chunk의 차원, 축 순서, 단위, 그리퍼 범위와 정규화 통계를 테스트 fixture로 만듭니다.
- 카메라→base 변환을 구현합니다. 알려진 표적을 카메라 각도별로 배치하고, 같은 물체 이동이 base 좌표계에서 일관된 방향을 만드는지 검사합니다.
- 실제 IK 또는 WBC를 연결합니다. 현재 관절 상태에서 도달 가능성, joint limit, self-collision과 한 step 최대 변화량을 확인한 뒤
q_des를 만듭니다. - Isaac Sim에서 loop를 닫습니다. 카메라 관측→VLA→controller→articulation→다음 관측이 반복되는 실행 trace를 저장합니다.
- 태스크 승인 gate를 통과합니다. 고정된 물체 위치와 조명 seed에서 성공률, 충돌, workspace 이탈, action saturation, 지연을 함께 평가합니다.
이 여섯 단계가 끝난 뒤에야 router contract PASS를 manipulation policy 승인으로 올릴 수 있습니다. 그 전까지 정확한 표현은 “VLA action 인터페이스와 CPU 계약을 구현했다”이지 “자연어로 로봇 조작을 구현했다”가 아닙니다.
VLA의 가치와 제어기의 책임을 동시에 지켜야 합니다
VLA의 강점은 모터 제어를 모두 대신하는 데 있지 않습니다. 사람의 지시와 장면의 의미를 로봇이 실행할 수 있는 짧은 행동으로 바꾸는 데 있습니다. “빨간 블록”이 무엇인지, 어느 손을 먼저 가져가야 하는지, 지금 관측에서 다음에 무엇을 해야 하는지를 데이터로 학습할 수 있다는 점이 핵심입니다.
반대로 좌표계, 도달 가능성, 접촉, 균형, 관절 한계와 빠른 피드백은 제어기가 책임져야 합니다. 현재 프로젝트에서 발견한 dummy PASS와 position hold는 실패라기보다 그 경계를 코드 수준에서 확인하게 만든 좋은 경고였습니다. 7차원 숫자가 반환됐다는 사실과 로봇이 과제를 수행했다는 사실 사이에는 생각보다 많은 공학이 남아 있습니다.
그래서 다음 구현에서는 VLA의 출력 자체보다 그 출력이 어떤 좌표계와 단위를 가지며, 누가 물리적으로 실행하고, 어떤 조건에서 실패로 판정되는가를 먼저 고정하려 합니다. 자연어 명령을 로봇 행동으로 연결하는 파이프라인은 모델 하나가 아니라, 이 경계들이 서로 거짓말하지 않을 때 완성됩니다.
함께 읽기: 로봇에게 자연어 명령을 내리기까지: Physical AI 파이프라인 · WBC와 강화학습은 무엇이 다른가 · 로봇 강화학습 환경 읽기 · G1 보행 정책을 어떻게 학습하고 있는가
참고 자료: OpenVLA 공식 구현 · OpenVLA 논문 · RT-2: Vision-Language-Action Models · ACT: Learning Fine-Grained Bimanual Manipulation with Action Chunking
기술 기준 시점: 2026-07-21. 구현 상태는 origin/main@ee4d96e의 VLA backend, selector·Runner, Franka/G1 adapter와 CPU 계약 테스트를 기준으로 작성했습니다. 6/6 및 4/4는 CPU 인터페이스 검사 결과이며 실제 OpenVLA 추론, Isaac Sim 폐루프 조작 또는 실물 로봇 성능을 뜻하지 않습니다.