M79에서 오른쪽 어깨만 수정하는 phase head를 125회 PPO update로 학습했습니다. 4,096개 환경에서 1,228만8천 transition을 처리했고, 새 head의 출력은 최대 0.1122까지 커졌습니다. 최적화한 arm return 평균도 0.0185166에서 0.0185497로 올라갔습니다. 그런데 목표였던 오른쪽 어깨의 평균 절대 오차는 0.06052rad에서 0.06290rad로, excursion error는 0.15924rad에서 0.16388rad로 나빠졌습니다. 반대쪽 팔과의 lag도 0.12초에서 0.14초로 늘었습니다.
학습이 멈춰 있었던 것은 아닙니다. 새 parameter는 실제로 변했고 total return도 올랐습니다. 다만 그 return 분산의 99.93%를 전신 CAM 항이 차지했고, 여덟 관절을 평균한 tracking 항은 약 0.064%뿐이었습니다. 나머지 일곱 관절과 CAM이 조금 좋아지면 오른쪽 어깨가 나빠져도 전체 목적함수는 올라갈 수 있었습니다. 저는 M80에서 이 구성을 분해해 본 뒤에야 “reward가 증가했다”는 사실과 “원하는 action을 학습했다”는 판단을 분리할 수 있었습니다.
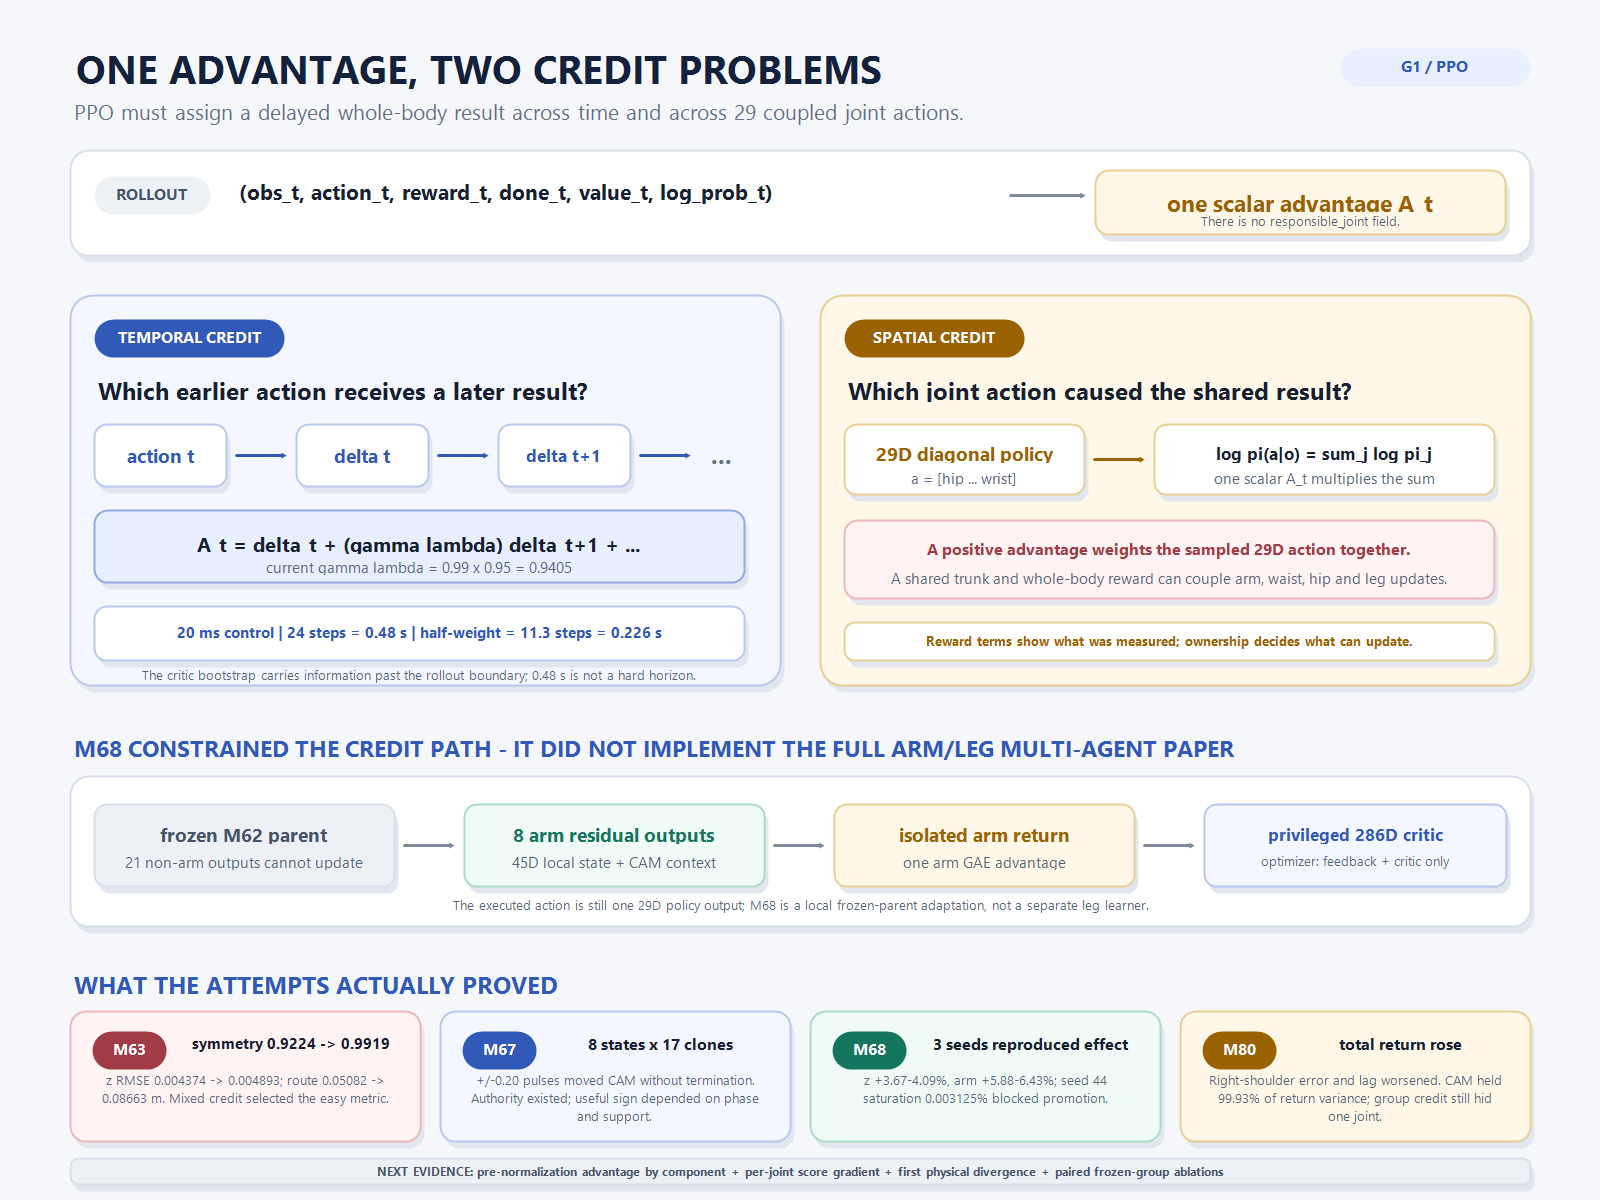
이 문제가 credit assignment, 즉 관측된 결과의 책임을 이전 행동에 배분하는 문제입니다. 시간으로는 늦게 나타난 낙상이나 CAM 변화가 어느 시점의 action 때문인지 정해야 합니다. 공간으로는 29개 관절이 함께 만든 결과를 어느 관절의 policy update에 반영할지 정해야 합니다. 이 글에서는 교과서식 정의보다 현재 G1의 M63→M68과 M79→M80 실패 기록을 따라가며, PPO가 실제로 제공하는 credit과 우리가 구조로 추가한 isolation을 구분합니다.
V·Q·Advantage 글은 return과 GAE 계산을, motion-tracking reward 글은 현재 reward 계약을 맡고 있습니다. 여기서는 그 수식을 다시 유도하지 않습니다. 하나의 advantage가 시간과 29차원 action에 어떻게 배분되며, reward component를 출력하는 것만으로는 왜 책임이 분리되지 않는지에 집중합니다.
Rollout에는 결과와 행동이 있을 뿐 책임 정답은 없습니다
PPO rollout이 저장하는 기본 단위는 같은 시점의 observation, sampled action, log probability, value와 환경 step 뒤의 reward·done입니다. 현재 M67 audit에서 이 순서를 다시 확인했습니다. action_t를 저장한 뒤 physics가 진행되고 reward와 termination이 계산되며, 그 reward가 같은 transition에 들어갑니다. 한 step씩 잘못 밀려 저장되는 배선 오류는 없었습니다.
(o_t, a_t, log π_old(a_t|o_t), V_t)
        ↓ environment step
(r_t, done_t, o_t+1)
        ↓ rollout complete
TD residual → GAE advantage → PPO update
그러나 이 row에는 responsible_time이나 responsible_joint가 없습니다. reward가 0.02초 뒤 계산됐다고 해서 결과의 물리적 원인이 바로 직전 action 하나로 끝나는 것도 아닙니다. joint target은 PD와 관성·접촉을 거쳐 자세를 바꾸고, 그 자세가 몇 step 뒤 CAM이나 발 접촉, route와 낙상에 영향을 줄 수 있습니다. 저장 시점이 맞다는 것은 필요한 조건이지 인과관계가 해결됐다는 뜻은 아닙니다.
시간 방향의 credit은 GAE가 여러 TD residual을 묶어 추정합니다
현재 G1 PPO는 한 action의 평가값으로 한 시점 reward만 쓰지 않습니다. critic의 앞뒤 예측과 reward로 TD residual δ_t를 만들고, Generalized Advantage Estimation(GAE)이 이후 residual을 지수적으로 누적합니다.
δ_t = r_t + γ V(o_t+1) - V(o_t)

Â_t = δ_t
    + (γλ) δ_t+1
    + (γλ)² δ_t+2
    + ...
이 구조 때문에 시점 t의 action은 바로 다음 reward뿐 아니라 이후 상태에서 드러난 결과의 일부 credit도 받습니다. 반대로 먼 미래 residual일수록 (γλ)^k만큼 영향이 줄어듭니다. GAE 논문이 설명하는 핵심 절충도 여기에 있습니다. 더 긴 결과를 포함하면 장기 원인을 반영할 수 있지만 추정 분산이 커지고 critic error의 영향도 오래 퍼집니다.
현재 G1의 시간 상수는 0.48초 rollout보다 단순하지 않습니다
origin/main@ee4d96e의 G1 설정은 policy step 20ms, 환경별 rollout 24 step, γ=0.99, λ=0.95입니다. 한 rollout 조각은 환경별 0.48초이고, GAE의 연속 residual 가중비는 γλ=0.9405입니다. 이 비율은 약 11.3 step, 시간으로 약 0.226초마다 절반으로 줄어듭니다. 같은 비율을 24번 곱한 값은 약 0.229입니다.
| 현재 값 | 시간축 의미 | 주의할 해석 |
|---|---|---|
step_dt=0.02s |
policy action과 reward가 기록되는 간격 | 물리 효과가 한 step 안에 끝난다는 뜻이 아님 |
24 step |
한 update가 환경별로 직접 수집하는 0.48초 조각 | 정책의 학습 horizon이 0.48초에서 잘린다는 뜻이 아님 |
γλ=0.9405 |
GAE에서 이후 TD residual에 곱하는 비율 | reward와 action 사이의 실제 인과성을 증명하지 않음 |
마지막 V(o_T) |
rollout 끝의 미래를 critic으로 bootstrap | critic이 틀리면 경계 너머 credit도 함께 왜곡됨 |
따라서 “낙상이 0.6초 뒤 일어났으니 24-step PPO는 그 원인을 배우지 못한다”는 결론도, “GAE가 있으니 장기 credit은 해결됐다”는 결론도 맞지 않습니다. rollout 경계 밖의 미래는 critic bootstrap을 통해 들어오지만, 그 품질은 value estimation에 의존합니다. 0.48초는 저장 단위이고 GAE는 추정 규칙이지, 물리적 원인을 찾아주는 oracle이 아닙니다.
공간 방향에서는 하나의 advantage가 29차원 joint action을 함께 평가합니다
현재 기본 G1 actor는 29개 관절 action을 diagonal Gaussian으로 만듭니다. joint별 log probability는 더해져 하나의 joint-action log probability가 되고, PPO의 policy gradient에는 같은 scalar advantage가 곱해집니다. policy gradient theorem의 경험적 형태를 현재 continuous action에 맞춰 쓰면 다음과 같습니다.
log π(a_t|o_t) = Σ_j log π_j(a_t,j|o_t)

gradient sample
≈ Â_t · ∇θ log π(a_t|o_t)
= Â_t · Σ_j ∇θ log π_j(a_t,j|o_t)
PPO clipping이 해당 표본의 gradient를 막지 않은 구간에서 Â_t가 양수이면 그 시점에 함께 표본화된 29차원 action의 확률을 높이는 방향이 되고, 음수이면 낮추는 방향이 됩니다. advantage 안에는 “이번 CAM 개선의 70%는 왼쪽 어깨, 20%는 오른쪽 hip, 나머지는 접촉 timing 때문”이라는 분해가 들어 있지 않습니다. Gaussian의 각 관절 score gradient는 sampled action과 mean의 차이에 따라 달라지지만, 결과를 평가하는 scalar는 공유합니다.
actor trunk까지 공유하면 coupling은 parameter 수준에서도 생깁니다. 한 joint의 reward에 유리한 feature update가 같은 hidden representation을 쓰는 다른 output도 바꿀 수 있습니다. Gaussian action과 deterministic 평가 글이 sample·mean·std를 구분했다면, 여기서 필요한 구분은 joint별 sample이 있다고 해서 joint별 책임 신호까지 생기는 것은 아니라는 점입니다.
Reward 항목을 나눠 출력하는 것과 credit을 나누는 것은 다릅니다
TensorBoard나 trace에서 CAM reward, joint tracking reward, action-rate penalty를 따로 기록하면 어떤 항이 total reward를 지배하는지 볼 수 있습니다. 하지만 세 항을 먼저 더한 뒤 GAE를 한 번 계산하면 actor가 받는 것은 여전히 하나의 advantage입니다. component table은 측정 분해이지 optimizer 경로 분해가 아닙니다.
r_total = r_cam + r_joint - r_action_rate
Â_total = GAE(r_total, V)

# logging only
print(r_cam, r_joint, r_action_rate)

# this does not create
Â_cam_for_arm, Â_joint_for_each_joint, Â_rate_for_each_joint
credit 경로를 실제로 좁히려면 적어도 네 가지 소유권을 봐야 합니다. 어떤 reward stream을 transition에 넣는지, 어떤 action log probability로 ratio를 만드는지, 어떤 actor parameter에 gradient를 허용하는지, 어떤 optimizer가 그 parameter를 소유하는지입니다. critic observation을 더 넓히는 일은 baseline의 분산을 줄이는 데 도움을 줄 수 있지만 trainable action의 범위를 대신 제한하지 않습니다.
M63은 섞인 arm return이 쉬운 지표를 선택하는 모습을 보여 줬습니다
M63은 M62/2100 parent의 160차원 actor trunk와 286차원 critic 계약을 유지하고, current·reference CAM 여섯 값을 추가한 6→32→8 bounded arm adapter를 붙였습니다. trainable action은 양쪽 shoulder·elbow 여덟 개로 제한했습니다. 여기까지는 공간 credit을 팔 쪽으로 좁힌 설계였습니다.
문제는 팔 전용 return 안에 paper-aligned CAM 항과 0.25×shoulder symmetry가 함께 있었다는 점입니다. 100 update 뒤 M63/2199의 shoulder balance는 M62 기준 0.9224에서 0.9919로 올라갔습니다. 반면 핵심 vertical CAM z RMSE는 0.004374에서 0.004893으로 나빠졌고, planar route error도 0.05082m에서 0.08663m로 커졌습니다.
이 결과는 PPO가 reward를 무시했다는 증거가 아닙니다. 오히려 섞여 있던 목적 중 adapter가 쉽게 높일 수 있는 symmetry credit을 선택했다는 관찰에 가깝습니다. 전체 arm return이 양수가 되는 action이 핵심 CAM tracking까지 좋아야 한다는 보장은 없었습니다. M63을 기각하고 M64에서는 architecture·parent·bound·optimizer를 그대로 둔 채 symmetry 항만 arm return에서 제거했습니다.
M64·M65는 reward 하나를 지워도 올바른 feedback이 생기지 않는다고 보여 줬습니다
M64의 isolated return은 CAM 항만 남겼습니다. 그럼에도 checkpoint가 진행될수록 route error는 0.06146m에서 0.09723m로, z RMSE는 0.004549에서 0.004930으로 악화됐습니다. 직접 symmetry reward가 없는데도 shoulder balance는 0.9502에서 0.9982에 가까워졌습니다. 쉬운 항 하나를 지웠지만 adapter가 상황에 따라 다른 correction을 내는지는 아직 보장하지 못했습니다.
M65에서는 PPO를 돌리지 않고 같은 M64/2199를 adapter gain 0, +1, -1로 재생했습니다. 학습된 +1 adapter는 route 0.09227m, z RMSE 0.004889였습니다. adapter를 끈 gain 0은 route 0.04922m와 z RMSE 0.004344로 parent 행동을 회복했습니다. 부호를 뒤집은 -1은 z RMSE 0.004331로 더 낮았지만 route는 0.08866m였고 local arm metric도 나빠졌습니다.
trace를 보면 M64 adapter의 max bound use는 36.4%에서 93.5%까지 커졌지만 phase에 따른 출력 범위는 평균 대비 0.80%에서 0.27%로 줄었습니다. adapter는 CAM error에 반응하는 feedback보다 거의 고정된 양측 자세 offset을 학습했습니다. reward 항을 정리한 뒤 남은 병목은 observation aliasing과 gradient 구조였습니다. M66은 zero-CAM-error에서 residual이 정확히 0이 되도록 바꿨지만 최대 출력이 0.005666, 허용 범위의 2.83%에 머물며 사실상 no-op이 됐습니다.
M67은 action authority와 학습 credit을 분리해 검사했습니다
세 번의 100-update 실패 뒤에는 reward coefficient를 다시 만지지 않았습니다. M67은 PPO도 실행하지 않고 M62 상태 여덟 개를 각각 17개 환경으로 복제했습니다. 하나는 baseline, 나머지는 여덟 shoulder·elbow 관절에 ±0.20 policy-unit pulse를 0.30초 동안 적용했습니다. 총 136개 paired environment에서 termination은 없었습니다.
pulse는 CAM을 실제로 움직였습니다. 최대 normalized response는 x 0.007528, y 0.008795, z 0.004596이었고 anchor 이동은 xyz 최대 5.53·2.86·3.30mm였습니다. 왼쪽·오른쪽 shoulder pitch의 source별 최적 부호는 final z-CAM absolute error를 평균 0.000340·0.000358 줄였습니다. 개선 source 비율은 87.5%·75.0%였습니다.
이 결과가 증명한 것은 “팔 channel에 authority가 있다”는 사실입니다. 어느 관측에서도 같은 부호가 정답이라는 뜻은 아니었습니다. gait phase와 support에 따라 유용한 action sign이 달라졌고, M66은 CAM 여섯 값만 보면서 그 차이를 구분하지 못했습니다. contact actionability 글에서도 사용한 것처럼, bounded pulse는 reward가 낮은 원인이 action으로 바꿀 수 없는 물리량인지, learner가 그 action을 찾지 못한 것인지 분리하는 검사입니다.
M68은 reward·observation·parameter ownership을 함께 좁혔습니다
M68은 M62의 whole-body actor와 distribution을 고정한 채 여덟 upper-arm residual만 새로 학습했습니다. base actor가 받던 160차원 observation에 45차원 arm-local context를 붙였습니다. 여기에는 base 높이·heading·속도·gravity, 여덟 arm joint의 위치·속도 오차, 이전 arm action, phase·support, current·reference CAM이 들어갔습니다.
새 feedback은 45개 값을 그대로 MLP에 넣는 대신 CAM error와 46차원 context의 outer product로 138개 feature를 만듭니다. zero CAM error에서는 residual이 정확히 0이고, 각 arm output은 tanh 뒤 ±0.20으로 제한됩니다. parent actor의 나머지 state는 frozen hash로 감시했습니다.
학습 reward도 환경의 whole-body total을 쓰지 않았습니다. post-step에서 저장한 CAM tracking, 작은 arm joint-reference tracking, arm action-rate regularizer를 20ms로 적분한 isolated arm return으로 transition reward를 교체했습니다. optimizer는 새 arm_feedback과 critic parameter만 소유했습니다. critic은 286차원 privileged whole-body observation을 유지했습니다.
frozen M62 actor (160D) ───────────────┐
                                      ├─ 29D action
45D arm context → 8D bounded residual ┘

isolated arm reward → one arm GAE advantage
privileged 286D critic → value baseline

trainable: arm_feedback + critic
frozen: parent actor + non-arm outputs + action std
이 구조는 reward component를 출력만 한 것이 아닙니다. 전신 reward가 transition에 들어오는 길을 막고, non-arm parameter가 gradient로 움직이는 길도 막았습니다. 그 결과 “팔 return이 좋아졌는데 leg actor까지 바뀌었다”는 설명을 구조적으로 배제할 수 있었습니다. 다만 여덟 arm output 사이에는 여전히 하나의 advantage가 공유됩니다.
M68은 논문의 완전한 multi-agent 재현이 아니라 frozen-parent 적응입니다
M61에서 다시 읽은 Learning Humanoid Arm Motion via Centroidal Momentum Regularized Multi-Agent Reinforcement Learning은 팔과 다리에 별도 actor·critic, observation, reward를 두고 centralized training·decentralized execution을 사용합니다. 논문은 single-agent에서 arm·leg reward를 하나의 scalar return으로 합치면 서로 충돌할 수 있다고 보고, 두 agent의 return을 나눠 상호 간 gradient interference를 줄입니다.
현재 M68은 그 경계를 참고한 로컬 adaptation입니다. 실제 실행 action은 여전히 하나의 29차원 policy output이며, lower body를 학습하는 별도 leg actor·leg rollout·leg GAE는 없습니다. frozen parent가 lower-body·waist·wrist 행동을 그대로 제공하고 새 arm residual만 움직입니다. 그래서 M68 결과를 “G1 multi-agent PPO 구현 완료”나 논문 재현 결과로 쓰지 않습니다.
privileged critic의 의미도 제한해야 합니다. 전신 정보를 본 critic이 arm advantage의 variance를 낮추는 기준선을 만들 수는 있지만, actor observation에 없는 phase 차이를 행동 시점에 새로 제공하지는 않습니다. actor가 45차원 local context에서 구분할 수 있는 패턴만 배울 수 있습니다. actor·critic 정보 경계의 상세는 asymmetric actor–critic 글에 남겨 두었습니다.
M68은 세 seed에서 효과를 재현했지만 승격되지는 않았습니다
한 update canary는 wiring만 확인했습니다. base actor는 bitwise unchanged였고 새 feedback weight 1,104개만 변했습니다. 이후 seed 42에서 100-update block 두 번을 실행했고 25-update마다 64개 deterministic environment를 10초씩 평가했습니다. M68/2225는 M62 대비 z RMSE 3.77%, arm contribution 6.43%를 개선했고 residual saturation은 0이었습니다.
같은 M62 parent에서 seed 43·44를 각각 125 update로 다시 학습했습니다. 세 seed의 z RMSE 개선은 3.67–4.09%, arm contribution 개선은 5.88–6.43% 범위였습니다. route·survival·crossing과 structural gate도 유지됐습니다. 여기까지는 state-conditioned arm learning effect가 한 seed 우연이 아니라는 observed evidence입니다.
그러나 seed 44의 right shoulder pitch residual에서 0.003125% saturation tail이 나왔고 max residual은 0.19752로 ±0.20 경계에 가까웠습니다. 사전에 고정한 all-seed zero-saturation gate를 통과하지 못했습니다. 효과 재현과 checkpoint 승격을 분리해 M68은 promotion blocked로 남겼습니다. credit isolation이 좋아졌다는 사실은 walking success나 배포 가능성을 자동으로 증명하지 않습니다.
M79·M80은 팔 안에서도 scalar credit이 다시 섞일 수 있음을 드러냈습니다
M68 이후 오른쪽 shoulder timing만 고치기 위해 M79는 Linear(45,1) phase head 하나에 optimizer ownership을 줬습니다. 나머지 actor는 frozen이었고 출력 bound도 남아 있었습니다. 이 정도로 parameter를 좁히면 credit 문제가 끝난 것처럼 보였습니다.
하지만 transition reward는 M68의 aggregate arm return을 그대로 사용했습니다. M80 decomposition에서 CAM 항은 total return sample variance의 M77 99.9237%, M79 99.9295%를 차지했습니다. 여덟 joint tracking 항은 각각 0.0703%, 0.0644%였고 action-rate는 약 0.006%였습니다. 오른쪽 어깨가 tracking squared error에서 차지하는 비율이 16.02%에서 19.04%로 악화되어도 다른 관절과 CAM이 이를 가릴 수 있었습니다.
이 사례는 parameter ownership만 좁히는 것으로 target-specific credit이 완성되지 않는다는 증거입니다. 학습 가능한 parameter는 오른쪽 어깨 하나였지만 reward가 그 action의 결과를 충분히 민감하게 측정하지 않았습니다. M81에서 direct right-shoulder trajectory return으로 바꾼 뒤에도 acceptance gate는 통과하지 못했으므로, reward 직접성만으로 제어 가능성이 보장된다고도 말할 수 없습니다. 관측, action authority, reward sensitivity, 시간 지연을 한 묶음으로 확인해야 합니다.
다음 진단은 advantage가 만들어지기 전과 gradient가 적용된 뒤를 함께 기록해야 합니다
현재 공통 로그는 reward component와 일부 run의 arm return을 보여 주지만, 모든 버전에서 component가 어느 시간 구간의 raw advantage를 지배했는지 연결하지 않습니다. normalized advantage만 보면 원래 신호 크기와 terminal tail도 사라집니다. 다음 instrumentation에서는 update 직전의 temporal credit와 parameter update 직전의 spatial credit를 같은 transition ID로 묶어야 합니다.
per transition:
  reward_components_before_sum
  total_reward_after_dt
  td_residual
  raw_advantage_before_normalization
  terminal / timeout / phase / support

per action dimension:
  sampled_action - mean_action
  score_gradient d(log pi)/d(mean_j)
  trainable_parameter_owner
  raw / clipped action

causal validation:
  paired joint pulse
  frozen-group ablation
  first physical divergence step
  route / contact / CAM / morphology gates
reward component마다 discounted reward-to-go를 진단용으로 계산하면 어느 항이 시간축을 지배하는지 볼 수 있습니다. 다만 component별 critic 없이 그것을 곧바로 정확한 component advantage라고 부르지는 않습니다. 관절별 score gradient도 “그 관절이 실제 원인”이라는 증명이 아니라 이번 sample이 update에 준 방향을 보여 주는 값입니다. 인과 주장은 같은 초기 상태의 pulse나 frozen-group ablation처럼 action을 직접 바꾼 paired test와 결합해야 합니다.
이 글의 구현·실험 수치는 origin/main@ee4d96e의 코드와 G1Walk_training_report.md에 고정했습니다. 다만 당시 환경 파일의 RSL-RL 의존성은 Git branch를 따라가도록 되어 있어 과거 실행 binary의 정확한 commit은 현재 저장소만으로 재확인할 수 없습니다. policy gradient와 GAE 경로는 원 논문과 현재 RSL-RL source로 교차 검사했지만, 과거 run을 bitwise 재현했다는 주장에는 사용하지 않습니다.
정리: credit assignment는 reward 식보다 넓은 학습 경로의 문제입니다
PPO는 rollout에 책임 정답을 저장하지 않습니다. 시간 방향에서는 GAE가 뒤의 TD residual을 감쇠해 현재 action의 advantage를 추정하고, 공간 방향에서는 하나의 scalar advantage가 29차원 joint action의 log probability에 곱해집니다. shared reward와 shared parameter를 그대로 두면 arm·waist·hip·leg 사이의 책임도 함께 섞입니다.
M63은 섞인 arm return이 쉬운 shoulder symmetry를 선택할 수 있음을, M64·M66은 reward 정리와 equilibrium 제약만으로 state-dependent feedback이 생기지 않음을 보여 줬습니다. M67은 팔 action authority가 실제로 존재하며 유용한 sign이 phase·support에 따라 달라진다는 증거를 추가했습니다. M68은 observation, isolated return, frozen parameter와 optimizer ownership을 함께 좁힌 뒤 세 seed에서 재현되는 효과를 만들었지만 strict saturation gate 때문에 승격되지는 않았습니다. M80은 그 뒤에도 여덟 관절 평균과 CAM-dominated return이 한 관절의 악화를 숨길 수 있음을 다시 확인했습니다.
다음 검증: M79/M80 trace를 기준으로 reward component, raw TD residual·advantage, 오른쪽 shoulder score gradient와 first physical divergence를 같은 row에 저장합니다. 그 뒤 동일 초기 상태에서 right-shoulder pulse와 frozen-head ablation을 paired 실행해 “PPO가 그 parameter를 바꿨다”와 “그 action이 목표 물리량을 바꿨다”를 한 증거 체인으로 연결합니다.
참고 자료
- Policy Gradient Methods for Reinforcement Learning with Function Approximation
- High-Dimensional Continuous Control Using Generalized Advantage Estimation
- Proximal Policy Optimization Algorithms
- RSL-RL PPO rollout·advantage update 구현
- Learning Humanoid Arm Motion via Centroidal Momentum Regularized Multi-Agent Reinforcement Learning