G1 actor의 observation 73개를 실물 센서 목록으로 바꿔 적다가 첫 줄에서 막혔습니다. 정책은 20ms마다 body frame의 base linear velocity 3개를 받습니다. 그런데 실제 로봇에는 base_lin_vel_b라는 센서가 없습니다. Isaac Lab에서는 root_lin_vel_w를 바로 읽고 quaternion으로 body frame에 돌리면 끝납니다. 실물에서는 IMU의 가속도를 적분하거나, 발 접촉과 관절 기구학을 결합하거나, 외부 위치 추정기를 붙여야 비슷한 값을 만들 수 있습니다.
이 차이를 무시하면 시뮬레이터 안에서 잘 걷는 policy를 저장해 놓고도 실물의 첫 inference packet을 만들지 못합니다. tensor shape은 73으로 맞을 수 있습니다. 그러나 한 값은 완전한 시뮬레이터 상태이고 다른 값은 bias·drift·지연을 가진 추정치라면, 두 observation은 같은 데이터가 아닙니다. 강화학습 환경의 observation contract가 “무엇을 넣는가”를 정했다면, 이번 글은 그 값이 어디서 왔으며 어느 시각을 나타내는가를 추적합니다.
결론부터 적으면 현재 저장소에는 state estimator의 수학적 뼈대가 있지만, G1의 RL actor와 실물 센서 사이에 검증된 estimator 경로는 아직 없습니다. Direct G1 환경은 시뮬레이터 truth를 직접 읽고, WBC 평가용 G1 경로 역시 truth를 우회 입력합니다. H1 키보드 데모는 estimator를 생성하지만 실제 update를 호출하지 않고 속도 0과 양발 접촉 true를 넣습니다. “state estimator가 구현되어 있다”와 “policy가 estimator의 출력을 받아 실행된다”는 서로 다른 완료 조건입니다.
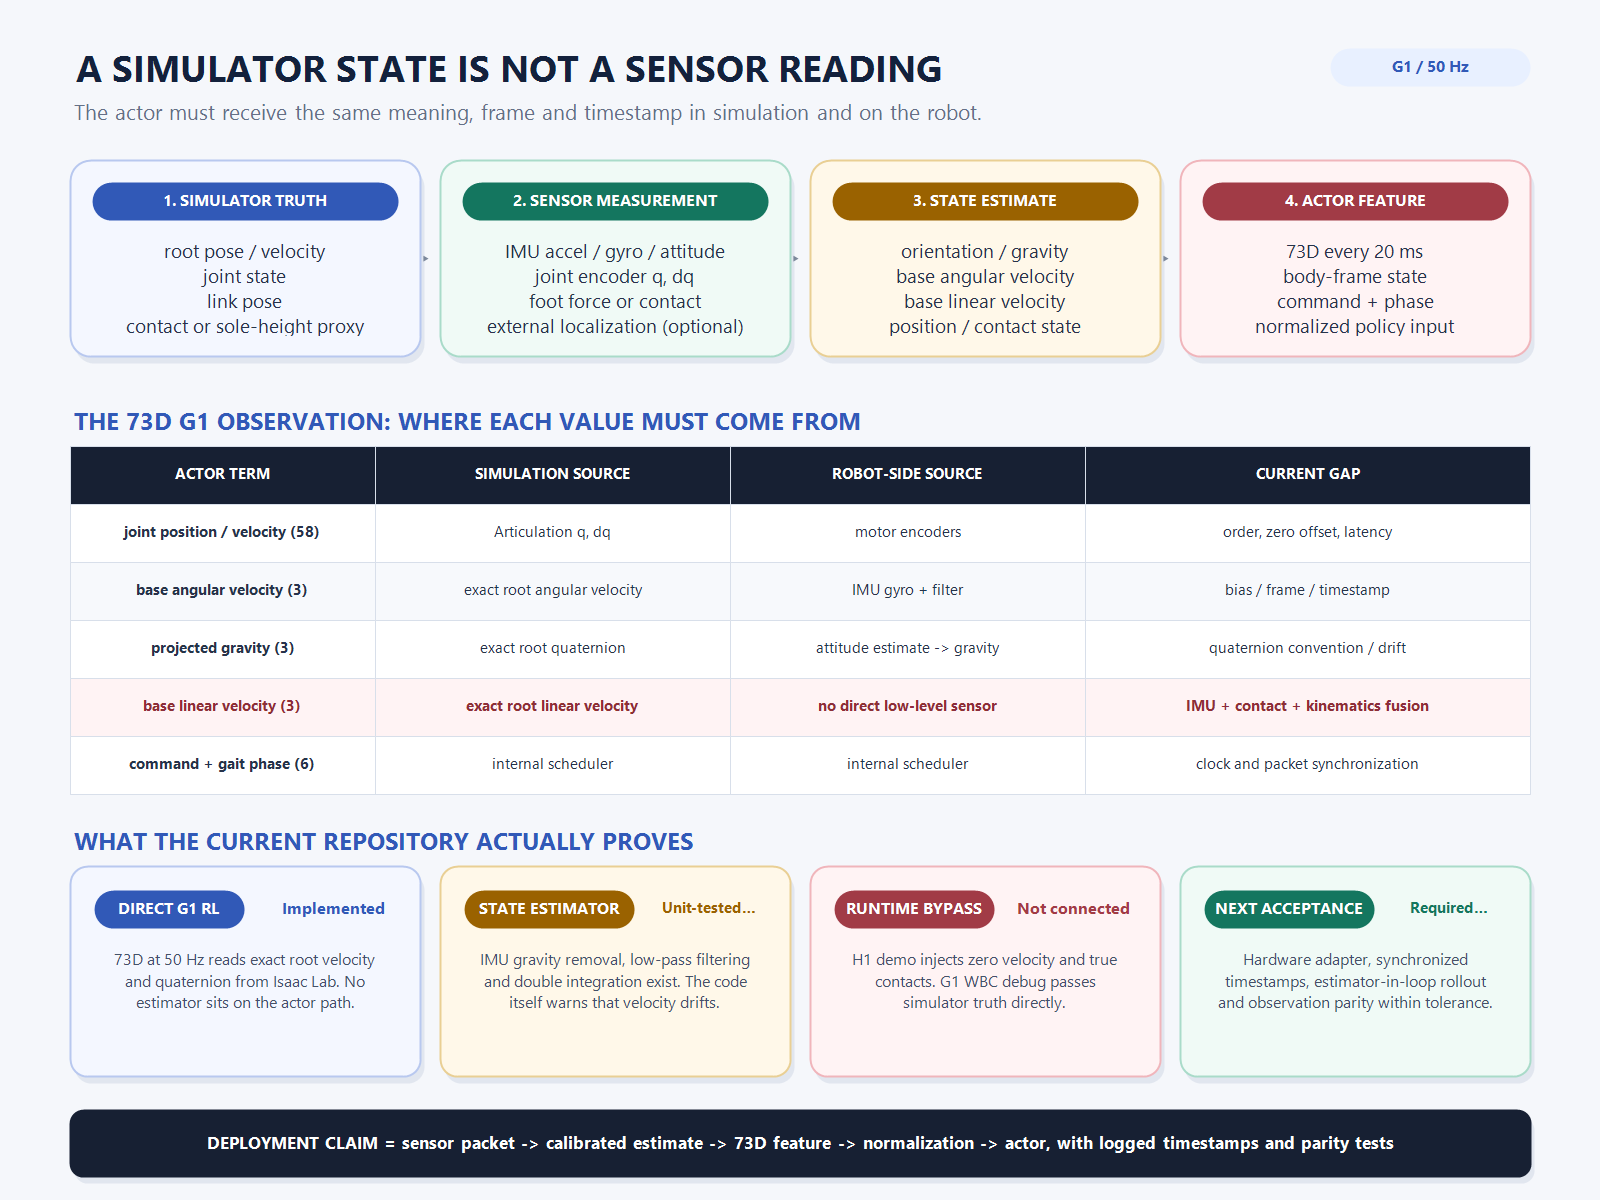
state, measurement, estimate를 같은 단어로 부르면 검증 경계가 사라집니다
먼저 세 종류의 값을 구분해야 합니다. state는 위치·자세·속도처럼 시스템을 기술하는 물리량입니다. 시뮬레이터는 내부 적분 결과를 알고 있으므로 root pose와 root velocity를 거의 비용 없이 제공합니다. measurement는 IMU의 각속도·가속도, 모터 encoder의 관절각·관절속도, 발의 힘처럼 센서가 실제로 내보낸 값입니다. measurement에는 bias, noise, saturation, dropout, 각 센서의 서로 다른 timestamp가 붙습니다.
estimate는 measurement와 모델을 결합해 계산한 state의 추정치입니다. 예를 들어 projected gravity는 attitude quaternion으로 중력 벡터를 body frame에 회전해 만들 수 있습니다. base linear velocity는 IMU 가속도를 적분하는 것만으로는 빠르게 drift하므로, 지면에 붙어 있다고 판단한 발의 기구학적 속도나 외부 odometry를 correction으로 써야 합니다. 2012년 Bloesch 등의 legged state estimation 연구도 onboard IMU와 관절 encoder, 간헐적인 발 접촉을 하나의 필터에서 결합합니다. 핵심은 “센서 하나가 base velocity를 준다”가 아니라 여러 불완전한 관측으로 상태를 추정한다는 점입니다.
Isaac Lab의 ArticulationData 문서는 root_state_w를 position, quaternion, linear velocity, angular velocity로 정의하고, projected_gravity_b와 body-frame velocity도 이 root state에서 계산합니다. 이것은 시뮬레이션 API로 제공되는 상태입니다. 반면 Unitree의 G1/H1/H1-2 저수준 상태 예시는 IMU state와 각 motor의 q, dq, 추정 torque 등을 읽습니다. 고수준 motion service가 별도의 velocity를 제공할 수 있더라도, 저수준 정책 배포에서 Isaac Lab의 정확한 root velocity와 동일한 센서 channel이 자동으로 생기는 것은 아닙니다.
현재 Direct G1 actor는 73개를 어디서 읽는가
origin/main@ee4d96e의 sim/envs/g1_walk/g1_walk_env.py는 policy observation layout을 명시합니다. physics는 200Hz이고 decimation은 4이므로 actor는 50Hz, 즉 20ms마다 한 번 호출됩니다. observation은 다음 73차원입니다.
| 항목 | 차원 | 현재 시뮬레이션 출처 | 실물에서 필요한 출처 |
|---|---|---|---|
| base linear velocity, body frame | 3 | root_lin_vel_w를 quaternion으로 회전 |
IMU·접촉·관절 기구학 또는 외부 odometry를 융합한 추정치 |
| base angular velocity, body frame | 3 | root_ang_vel_w를 quaternion으로 회전 |
IMU gyro의 축·bias·filter를 맞춘 값 |
| projected gravity | 3 | root quaternion으로 world gravity를 회전 | attitude estimate로 같은 중력 벡터를 회전 |
| effective velocity command | 3 | 환경 내부 command | runtime command router의 동일 시점 명령 |
| gait phase sin/cos + swing side | 3 | episode step 기반 scheduler | 실행기와 동기화한 phase clock |
| joint position minus nominal | 29 | robot.data.joint_pos |
encoder q를 runtime joint order와 zero offset에 맞춘 값 |
| joint velocity | 29 | robot.data.joint_vel |
encoder dq 또는 일관된 미분·filter 결과 |
코드의 동작 자체는 분명합니다. root quaternion, world-frame root linear/angular velocity, joint position/velocity를 읽습니다. 두 속도와 중력은 quat_apply_inverse로 body frame에 옮기고, command와 phase를 붙인 뒤 고정된 순서로 concatenate합니다. world·body·joint frame 글에서 다룬 좌표 변환은 이 단계의 의미를 설명합니다. 이번에 중요한 점은 변환식보다 그 입력이 센서가 아니라 시뮬레이터 내부 상태라는 사실입니다.
이 observation을 “실물에서 얻을 수 있는 정보만 사용했다”고 부르기에는 아직 이릅니다. 정보 종류는 deployment-inspired에 가깝습니다. joint q/dq, gyro, attitude는 대응되는 센서 경로를 설계할 수 있습니다. 그러나 대응 가능하다는 것과 실제 adapter·calibration·timestamp를 통과했다는 것은 다릅니다. 특히 base linear velocity 3개는 현재 계약에서 가장 큰 미완성 항목입니다.
관절 encoder는 가장 쉬운 항목이지만 그대로 복사할 수는 없습니다
29개의 joint position과 29개의 joint velocity는 센서 대응이 가장 명확합니다. 그래도 encoder packet을 tensor에 순서대로 넣는 것으로 끝나지 않습니다. 저장소의 policy는 asset runtime joint order를 기준으로 nominal pose를 빼고, 그 순서를 action 29차원과 공유합니다. 실물 SDK의 motor index가 이 순서와 하나라도 다르면 왼쪽 hip의 각도가 오른쪽 knee feature로 들어갈 수 있습니다.
zero offset도 계약의 일부입니다. 시뮬레이터의 0rad와 encoder raw 0가 같은 기계적 자세인지, boot calibration 이후 q가 이미 보정되었는지, nominal pose를 어느 공간에서 빼는지를 고정해야 합니다. dq도 마찬가지입니다. firmware가 제공하는 dq와 q를 finite difference한 값은 filter와 delay가 다릅니다. actor가 20ms마다 실행되더라도 sensor packet이 20ms 경계에 정확히 도착한다는 보장은 없습니다.
policy joint feature at control tick k

q_feature[k]  = reorder(q_encoder[t_q]) - q_nominal
dq_feature[k] = reorder(dq_encoder[t_dq])

required log:
  control_tick_timestamp
  source_packet_timestamp
  motor index -> policy joint index
  zero offset / unit / sign convention
  stale age = control_tick_timestamp - source_packet_timestamp
shape test는 29개가 들어왔다는 사실만 확인합니다. 배포 parity test는 동일한 자세에서 sim과 robot adapter가 같은 관절 의미·부호·단위를 내놓는지 확인해야 합니다. 이 검사는 policy inference 이전에 독립적으로 통과시킬 수 있습니다.
angular velocity와 projected gravity도 IMU raw를 그대로 넣는 값이 아닙니다
base angular velocity는 gyro와 가장 가깝습니다. 그러나 현재 Direct 환경은 world-frame root angular velocity를 정확한 root quaternion으로 body frame에 회전합니다. 실물 IMU gyro가 이미 IMU sensor frame의 각속도를 내보낸다면, IMU 설치 자세와 policy base frame 사이의 고정 extrinsic을 적용해야 합니다. bias 제거와 low-pass filter는 값뿐 아니라 phase lag도 바꿉니다. 훈련 때 지연 없는 root angular velocity를 썼는데 배포 때만 강한 filter를 걸면 같은 동작 중에도 actor가 보는 시점이 달라집니다.
projected gravity는 자세 quaternion으로 중력 방향을 body frame에 투영한 3차원 벡터입니다. yaw는 중력 방향을 바꾸지 않으므로 보행 actor가 roll과 pitch를 읽기에 유용합니다. 그렇다고 IMU quaternion을 무조건 복사하면 되는 것은 아닙니다. quaternion 순서가 wxyz인지 xyzw인지, world-to-body인지 body-to-world인지, IMU frame과 pelvis/root frame의 extrinsic이 무엇인지가 모두 맞아야 합니다. 좌표계 글에서 보았듯이 부호 하나가 바뀌면 앞으로 기울었는데 뒤로 기울었다고 policy에 보고할 수 있습니다.
현재 sim/wbc/state_estimator.py는 입력 quaternion을 orientation으로 사용하고, rotation matrix로 body-frame gravity를 만든 뒤 IMU acceleration에서 제거합니다. angular velocity에는 0.85의 low-pass 계수를 적용합니다. 이 코드는 변환의 출발점은 제공하지만, G1 IMU packet의 quaternion convention과 mounting extrinsic을 검증하는 hardware adapter는 아닙니다.
base linear velocity가 가장 어려운 이유는 IMU가 속도를 측정하지 않기 때문입니다
가속도를 한 번 적분하면 속도가 된다는 식은 맞지만, 실물에서는 작은 오차도 계속 누적됩니다.
a_world = R(q) (a_imu - b_a) - g
v[k+1] = v[k] + a_world dt
p[k+1] = p[k] + v[k+1] dt
여기서 자세 q가 조금만 틀려도 중력 9.81m/s²의 일부가 수평 가속도로 섞입니다. 예를 들어 1도의 tilt error만 있어도 약 0.17m/s²의 가짜 수평 성분이 생길 수 있습니다. bias와 vibration까지 더해지면 정지한 로봇의 추정 속도도 움직입니다. 다시 그 속도를 적분한 위치는 더 빠르게 벌어집니다.
다리가 지면에 붙는 순간은 drift를 줄일 단서를 줍니다. 접촉한 발이 미끄러지지 않는다고 가정하면, 관절 encoder와 forward kinematics로 base의 상대 운동을 제한할 수 있습니다. 그래서 legged state estimator는 IMU prediction에 contact와 kinematics correction을 결합합니다. 다만 접촉 판단이 틀리거나 발이 미끄러지면 correction 자체가 오염됩니다. 절대 위치와 yaw처럼 onboard proprioception만으로 관측하기 어려운 자유도도 남습니다. 필터를 붙였다는 사실보다 어떤 상태가 observable하고 어떤 가정을 썼는지가 더 중요합니다.
현재 저장소의 StateEstimator는 이 복잡성을 의도적으로 줄인 버전입니다. gravity를 제거한 IMU acceleration을 적분하고, 이전 velocity와 새 적분값을 0.85 계수로 섞은 뒤, 다시 velocity를 적분해 position을 만듭니다. contact input은 bool이면 그대로 쓰고 force 값이면 10N을 넘는지 이진화합니다. 그러나 contact state는 velocity correction에 사용되지 않습니다. 코드 주석도 이것이 full contact-aided EKF가 아니며 단순 IMU 적분은 drift한다고 명시합니다.
접촉은 actor 입력과 reward·estimator 입력을 분리해서 봐야 합니다
현재 Direct G1 73차원 actor에는 왼발·오른발 contact bit가 들어가지 않습니다. phase와 target swing side는 환경의 내부 scheduler가 만든 명령 상태이지 측정 접촉이 아닙니다. 반면 reward와 termination을 계산할 때는 발 접촉이 필요합니다. Direct 환경은 이 asset 경로에서 contact force를 사용하지 않고, authored sole box의 world z 최솟값이 0.11m보다 낮은지를 접촉 proxy로 씁니다.
이 값은 foot force sensor가 아닙니다. 바닥 높이와 sole geometry를 아는 시뮬레이터 전용 판정입니다. 다른 motion-tracking 환경에서는 Isaac Lab ContactSensor의 net_forces_w를 사용하는 경로도 있습니다. 하나는 sole-height proxy이고 다른 하나는 시뮬레이션 contact force입니다. 둘 다 실물 foot force packet과 threshold·noise·latency가 자동으로 같아지지는 않습니다.
이 구분은 estimator 설계에서 중요합니다. actor에 contact bit를 추가하지 않더라도, base velocity estimator가 contact를 correction으로 사용할 수 있습니다. 그 경우 contact는 policy feature가 아니라 policy feature를 만드는 내부 추정기 input입니다. privileged actor·critic 정보 경계처럼 “누가 최종 tensor를 보는가”와 “그 tensor를 만들 때 어떤 센서를 썼는가”를 따로 기록해야 합니다.
단위 테스트가 증명한 것은 함수 계약이지 추정 정확도가 아닙니다
training/eval/eval_wbc.py의 StateEstimator 테스트는 orientation 변환, 50N/5N contact threshold, bool passthrough, reset 시 nominal height, 필수 output key를 검사합니다. 이 테스트는 유용합니다. quaternion helper가 완전히 뒤집히거나 contact threshold 분기가 망가지는 회귀를 잡을 수 있습니다.
하지만 synthetic input을 넣은 unit test는 bias가 있는 IMU로 30초 걸었을 때 velocity가 얼마나 drift하는지, 발이 미끄러질 때 contact correction이 안정적인지, 센서 packet이 늦었을 때 추정기가 어느 시각을 출력하는지 증명하지 않습니다. “28개 WBC 평가가 통과했다”는 말도 이 경계를 붙여 써야 합니다. 그것은 현재 함수와 모듈의 계약 검증이지 hardware-in-the-loop state estimation acceptance가 아닙니다.
| 완료 단계 | 현재 상태 | 증거 |
|---|---|---|
| 설계 | 있음 | IMU·encoder·contact를 입력으로 받는 StateEstimator interface |
| 구현 | 부분 완료 | gravity 제거, low-pass, 단순 적분, contact threshold |
| 단위 실행 | 완료 | 합성 orientation·contact·reset·key 테스트 |
| G1 runtime 연결 | 미완료 | RL actor와 G1 WBC debug 모두 sim truth를 직접 사용 |
| estimator-in-loop rollout | 미실행 | 동일 policy를 truth observation과 estimated observation으로 비교한 trace 없음 |
| 실물 배포 검증 | 미완료 | G1 sensor adapter·timestamp·parity·drift acceptance 없음 |
estimator를 생성한 것과 runtime에 연결한 것도 다릅니다
이 차이는 현재 두 실행 경로에서 명확히 보입니다. sim/envs/h1_walk/h1_keyboard_walk.py는 StateEstimator 객체를 생성합니다. 그러나 control loop에서는 estimator.update(...)를 호출하지 않습니다. 로봇의 sim pose와 joint q/dq를 읽고, base_euler·base_lin_vel·base_ang_vel은 0, 양발 contact는 true인 dictionary를 직접 만듭니다. gait scheduler의 예정 접촉을 CoM planner와 WBC QP에 따로 넘깁니다.
G1 WBC 디버그 경로도 다른 방식으로 estimator를 건너뜁니다. training/eval/debug_g1_motion_trace.py의 _g1_wbc_actions는 Isaac Lab root quaternion과 root linear velocity를 읽고 body frame으로 변환합니다. joint q/dq와 Euler angle도 sim truth에서 만들어 G1WBCWalkingController.step에 바로 넣습니다. WBC 한 스텝 글의 scheduler→trajectory→CoM→joint target 흐름은 구현되어 있지만, 그 첫 입력을 실제 센서에서 만드는 경로는 아직 별도 과제입니다.
이것은 실패를 숨겨야 할 이유가 아니라 다음 작업을 정확히 자르는 근거입니다. estimator가 없어서 전체 WBC를 다시 설계해야 하는 상태는 아닙니다. interface와 최소 구현은 있습니다. 다만 G1-specific adapter, timestamp policy, contact-aided correction, runtime 연결, parity evaluation이 필요합니다.
50Hz actor 앞에서는 값의 크기만큼 timestamp가 중요합니다
Direct G1 환경에서 physics step은 5ms, actor step은 20ms입니다. 시뮬레이터의 root pose·velocity·joint state는 같은 simulation tick에 접근할 수 있습니다. 실물에서는 IMU가 500Hz, motor state가 500Hz 또는 다른 rate, command router가 50Hz처럼 서로 다른 주기로 들어올 수 있습니다. 가장 최근 packet을 하나씩 꺼내 concatenate하면 각 항목이 서로 다른 물리 시각을 나타냅니다.
예를 들어 control tick 12.000s에 actor를 호출하면서 joint q는 11.999s, gyro는 11.998s, attitude는 11.990s, velocity estimate는 11.980s의 값을 쓴다면 tensor shape은 맞지만 하나의 상태 snapshot은 아닙니다. command와 gait phase도 해당 state가 측정된 시점이 아니라 inference 시점만 보고 갱신하면 phase가 어긋날 수 있습니다. physics step과 decimation 글이 시뮬레이터의 시간 구조를 다뤘다면, 실물 adapter에는 packet age와 interpolation 규칙이 추가되어야 합니다.
observation_packet[k] = {
  control_time:        t_k,
  joint_time:          t_q,
  imu_time:            t_imu,
  estimator_time:      t_est,
  command_time:        t_cmd,
  max_stale_age:       max(t_k - t_source),
  estimator_covariance_or_health,
  raw_73d_before_normalization,
  normalized_73d_seen_by_actor
}
정규화도 이 뒤에 붙습니다. running mean·variance 글에서 다룬 것처럼 raw feature의 분포가 바뀌면 동일한 물리 상태가 다른 normalized input이 됩니다. estimator의 noise·filter·bias가 바뀌면 raw observation 분포부터 달라집니다. 따라서 state estimator parity와 observation normalization parity를 한 번에 뭉뚱그리지 말고, raw 73D 경계와 normalized 73D 경계를 모두 로그로 남겨야 합니다.
학습 쪽에서는 noise 추가보다 estimator-in-the-loop 비교가 먼저입니다
sim-to-real을 준비할 때 흔히 observation noise와 latency randomization을 바로 추가합니다. 필요할 수 있지만, 현재 어떤 실물 추정기를 쓸지 모르는 상태에서 임의의 Gaussian noise를 뿌리면 실제 mismatch를 가리는 새 가정이 됩니다. 우선 같은 simulation trajectory에서 두 observation builder를 병렬로 실행하는 편이 낫습니다.
# teacher / truth path
obs_truth = build_from_sim_root_state(sim_state)

# deployment candidate path
sensor_packet = simulate_imu_encoder_contact(sim_state, noise, latency)
estimate = state_estimator.update(sensor_packet)
obs_est = build_from_estimate(estimate, command, phase)

log:
  obs_truth - obs_est
  action_mean(obs_truth) - action_mean(obs_est)
  first physical divergence step
  fall / route / contact / torque metrics
첫 단계는 observation별 bias, RMSE, phase lag, stale age를 비교하는 것입니다. 두 번째는 frozen actor에 두 observation을 넣어 action mean이 어디서 갈라지는지 봅니다. 세 번째는 동일 초기 상태의 paired environment에서 estimator path만 바꿔 rollout하고 first physical divergence를 기록합니다. 그다음에야 실제 estimator error 분포를 바탕으로 훈련 noise·delay·bias range를 정할 수 있습니다. G1 sim-to-real 검증 글의 전체 mismatch stack 가운데 이번 작업은 observation provenance와 state-estimation layer를 닫는 일입니다.
현재 프로젝트에서 받아들일 수 있는 state-estimation 완료 조건
“EKF를 구현했다”를 완료 조건으로 두면 필터 클래스만 생기고 policy 경로는 그대로일 수 있습니다. 반대로 처음부터 실물 자유보행을 요구하면 작은 회귀도 찾기 어렵습니다. 현재 코드 구조에 맞춘 순서는 다음과 같습니다.
- G1 sensor schema 고정: IMU quaternion·gyro·accel, motor q/dq, foot force/contact 후보, packet timestamp와 frame을 문서화합니다.
- joint parity 통과: 29개 joint order·sign·unit·zero offset을 정지 자세와 작은 관절 sweep으로 검증합니다.
- attitude parity 통과: roll/pitch 방향, quaternion 순서, IMU-to-base extrinsic, projected gravity를 known-pose test로 검증합니다.
- velocity estimator health 정의: 정지 drift, 일정 속도 tracking, 접촉 전환, slip 조건에서 bias·RMSE·지연 상한을 정합니다.
- estimator-in-loop simulation: Direct G1 actor의 truth observation을 estimated observation으로 교체하거나 병렬 비교합니다.
- paired rollout gate: 동일 seed·초기 상태에서 생존, route, contact, torque와 first divergence를 비교합니다.
- hardware shadow mode: 실물에서 action을 적용하기 전에 sensor→estimate→73D→actor를 기록만 하고 packet age와 saturation을 점검합니다.
여기서 base velocity estimator를 어떤 알고리즘으로 만들지는 아직 열려 있습니다. 간단한 complementary filter, contact-aided EKF/InEKF, kinematic odometry, 외부 VIO를 후보로 비교할 수 있습니다. 선택 기준은 이름이 아니라 50Hz actor가 요구하는 body-frame velocity의 bias·지연·failure mode와 로컬 GPU/CPU 실행 비용입니다. 절대 위치가 필요 없는 locomotion actor라면 모든 global state를 복원할 이유도 없습니다.
정리: observation의 차원보다 데이터 계보가 먼저입니다
현재 G1 actor는 73차원이라는 명확한 입력 계약을 갖습니다. 그러나 그중 root linear/angular velocity와 root quaternion 기반 gravity는 Isaac Lab이 알고 있는 정확한 state에서 만들어집니다. joint q/dq는 encoder에 대응하기 쉽지만 순서·offset·timestamp 검증이 남아 있습니다. command와 gait phase는 센서가 아니라 runtime 내부 상태이며, sensor snapshot과 동기화되어야 합니다.
StateEstimator는 IMU·encoder·contact input interface, gravity 제거, filtering, 단순 적분과 unit test를 제공합니다. 반면 contact-aided correction은 없고, H1 demo와 G1 WBC debug는 아직 estimator를 runtime에 연결하지 않습니다. 따라서 현재의 정확한 표현은 “state estimation skeleton 구현 및 단위 계약 검증”이지 “G1 policy 실물 관측 경로 완료”가 아닙니다.
다음 검증: G1 73D observation builder를 truth source와 estimated source 두 경로로 분리합니다. 시뮬레이션에서 IMU·encoder·contact packet과 timestamp를 생성해 estimator를 거친 뒤, raw 73D 오차·actor action 차이·first physical divergence를 같은 transition ID로 기록합니다. 이 비교가 통과해야 observation noise와 latency randomization의 범위를 실제 오차에 맞춰 정할 수 있습니다.
참고 자료
- Isaac Lab ArticulationData: root state와 derived body-frame properties
- Isaac Lab Contact Sensor
- Unitree ROS 2: G1/H1/H1-2 low-level state 예제
- State Estimation for Legged Robots: Consistent Fusion of Leg Kinematics and IMU
- Contact-Aided Invariant Extended Kalman Filtering for Legged Robot State Estimation