로봇 학습 코드를 정리하다가 흥미로운 비대칭을 발견했습니다. training/rl/에는 G1 보행을 학습하고 재생하고 평가하기 위한 코드와 실험별 검증 도구가 빽빽하게 쌓여 있습니다. 반면 training/il/의 실제 파일은 README, 환경 정의, Octo fine-tuning 스크립트까지 세 개뿐입니다. README에는 OpenVLA, Octo, π0, ACT, Diffusion Policy가 나란히 적혀 있지만, 그것은 앞으로 만들 구조에 가깝습니다. 지금 실행 가능한 범위와 같다고 읽으면 안 됩니다.
이 차이는 단순히 한쪽 개발이 늦어서 생긴 것이 아닙니다. G1 보행과 언어 기반 조작은 애초에 학습 신호를 얻는 방법이 다릅니다. 보행은 시뮬레이터 안에서 수천 대를 동시에 넘어뜨려 보며 보상을 계산할 수 있습니다. 조작은 “컵을 잡되 찌그러뜨리지 않고 지정된 선반에 놓는다” 같은 행동을 숫자 하나로 빈틈없이 표현하기 어렵습니다. 그래서 보행에는 강화학습이, 조작과 VLA에는 사람의 시연을 따라 하는 모방학습이 먼저 등장합니다.
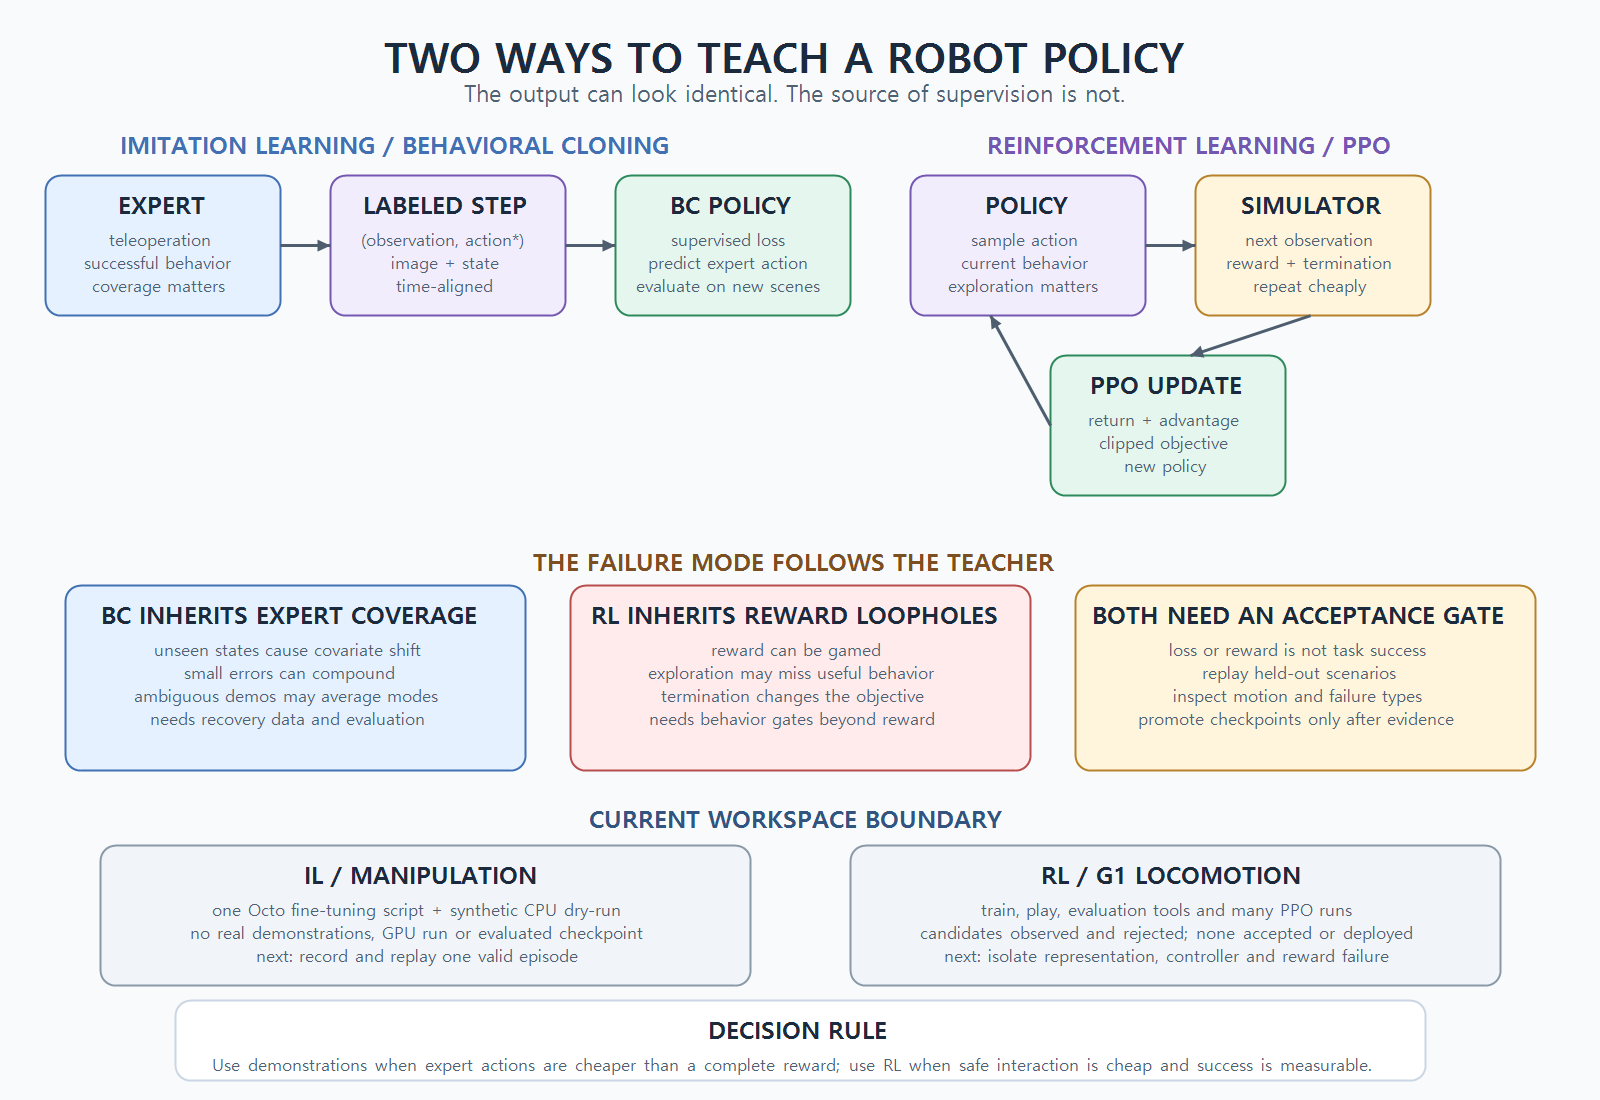
같은 정책을 만들지만, 정답이 들어오는 위치가 다릅니다
행동 복제(Behavioral Cloning, BC)는 가장 단순한 형태의 모방학습입니다. 시연 데이터에 관측 o_t와 전문가 행동 a_t*가 함께 들어 있고, 정책이 낸 행동이 전문가 행동에 가까워지도록 지도학습합니다.
BC: θ* = argmin E[(o,a*)~D] L(πθ(o), a*)카메라 영상과 관절 상태를 보고 사람이 움직인 end-effector delta나 관절 명령을 맞히는 문제라고 생각하면 됩니다. 학습 중에는 환경이 “좋았다”라고 평가하지 않습니다. 데이터에 기록된 행동 자체가 정답표입니다.
강화학습은 정답 행동을 받지 않습니다. 현재 정책이 상태에서 행동을 뽑고, 환경이 다음 상태와 보상을 돌려줍니다. PPO라면 그 rollout으로 advantage를 추정한 뒤, 좋은 결과와 연결된 행동의 확률을 올리고 나쁜 결과와 연결된 행동의 확률을 내립니다.
RL: o_t → a_t ~ πθ(a|o_t) → environment → r_t, o_(t+1)
    rollout → return / advantage → policy and value update
따라서 BC의 성능 상한은 시연의 범위와 품질에 강하게 묶이고, RL의 성능은 reward와 탐색이 허용한 범위에 묶입니다. 한 문장으로 줄이면 BC는 전문가의 사각지대를 물려받고, RL은 보상 함수의 빈틈을 물려받습니다.
BC는 데이터를 만들 때 이미 학습 문제의 절반을 결정합니다
BC에서 “데이터가 있다”는 말은 영상 파일이 있다는 뜻이 아닙니다. 같은 시점의 이미지·로봇 상태·행동이 동일한 시간축과 좌표계로 묶여 있어야 합니다. action이 현재 관측에서 실행한 명령인지 다음 관측을 만든 명령인지, 단위가 radian인지 meter인지, episode가 성공·실패·시간초과 중 무엇으로 끝났는지까지 알아야 합니다.
이 프로젝트의 HDF5 writer와 변환기는 episode group, 이미지, state, action, language를 저장하는 뼈대까지는 갖췄습니다. 그러나 실제 로봇 또는 Isaac Sim에서 수집한 시연은 아직 없고, step별 timestamp와 action frame도 완전히 고정되지 않았습니다. 자세한 계약은 로봇 학습용 episode 데이터 글에 따로 정리했습니다. 이 관문을 건너뛰고 Octo나 OpenVLA부터 돌리면 loss는 내려가도 로봇은 엉뚱한 좌표계의 행동을 정확히 재현할 수 있습니다.
시연 데이터만으로는 왜 작은 오차가 커지는가
BC의 대표적인 실패는 covariate shift입니다. 학습 데이터에는 전문가가 방문한 상태가 주로 들어 있습니다. 실제 실행 중 정책이 조금 틀어져 낯선 상태로 들어가면, 그 상태에서 복구하는 전문가 행동을 배운 적이 없습니다. 잘못된 행동은 다음 관측을 더 낯설게 만들고 오차가 시간에 따라 누적됩니다. Ross와 동료들의 DAgger 논문이 지적한 핵심도 순차 의사결정에서는 정책의 출력이 다음 입력 분포를 바꾼다는 점입니다.
또 하나는 정답이 하나가 아닐 때 생깁니다. 장애물을 왼쪽으로 피하는 시연과 오른쪽으로 피하는 시연을 단순 MSE로 회귀하면 두 행동의 평균인 직진을 학습할 수 있습니다. 그래서 연속 조작에서는 한 스텝의 평균 행동보다 행동 묶음과 분포를 모델링하는 방법을 사용합니다. ACT는 action chunk를 생성하고, Octo는 diffusion action head로 여러 가능한 연속 행동을 표현합니다. 다만 모델 구조가 데이터의 시간 정렬 오류까지 고쳐 주지는 않습니다.
강화학습은 시연 대신 환경과 보상 함수를 요구합니다
RL은 전문가 행동이 없어도 됩니다. 대신 정책이 실패해도 다시 시작할 수 있는 환경, 원하는 행동을 수치로 구분하는 reward, 학습을 끊을 termination 조건이 필요합니다. 실물 휴머노이드에서 수십만 번 넘어지게 만들 수는 없지만 Isaac Lab에서는 서로 다른 초기 상태를 가진 수천 개 환경을 GPU에서 병렬로 실행할 수 있습니다. 이것이 현재 G1 보행 경로가 PPO를 선택한 현실적인 이유입니다.
현재 설정은 4,096개 환경에서 24 step을 모아 한 번의 업데이트에 98,304개 transition을 만듭니다. 이 rollout을 actor와 critic이 함께 사용하고 PPO clipping으로 한 번의 갱신이 지나치게 멀리 가지 않도록 제한합니다. 메커니즘 자체는 PPO 소개글에서 자세히 다뤘습니다.
하지만 병렬화는 올바른 목표를 보장하지 않습니다. 발을 높이 들라는 보상을 주면 앞으로 걷기보다 제자리에서 발만 흔드는 정책이 나올 수 있고, 생존 보상을 크게 주면 전진하지 않고 버티는 정책이 유리해질 수 있습니다. 이것은 알고리즘이 reward를 오해한 것이 아니라, 우리가 적은 수식을 정확히 최적화한 결과입니다. 실제 G1 실험에서 reward 개선과 눈으로 본 보행 개선을 분리한 이유도 여기에 있습니다.
현재 저장소에서 두 경로의 성숙도는 같지 않습니다
origin/main@ee4d96e를 기준으로 보면 RL과 IL은 아래처럼 다른 단계에 있습니다. README에 적힌 목표 구조와 디스크에 존재하는 구현을 일부러 분리해 읽었습니다.
| 검증 단계 | G1 RL / PPO | 조작 IL / BC |
|---|---|---|
| 문제·인터페이스 설계 | 구현됨 | episode와 모델 경로 설계됨 |
| 학습 코드 | train.py와 G1 환경·설정 존재 |
Octo JAX fine-tuning 스크립트 1개 존재 |
| 입력 검증 | Isaac Lab 병렬 rollout 실행 | 합성 HDF5 기반 CPU dry-run |
| 실제 학습 실행 | 다수의 G1 PPO 실험 수행 | 실제 시연·pretrained weight·GPU run 없음 |
| 행동 평가 | 영상·발 교차·이동거리 gate로 후보 기각 | fine-tuned 정책 행동 평가 없음 |
| 채택·배포 | 승인 checkpoint 없음 | 승인 checkpoint 없음 |
여기서 CPU dry-run의 의미도 제한해야 합니다. 현재 Octo 스크립트는 HDF5를 읽고, 기본값으로 관측 2 step과 미래 행동 4 step의 batch를 만드는 경로를 확인합니다. 원격 main에는 JAX/Optax 학습 loop와 checkpoint 저장 코드도 들어 있습니다. 그러나 합성 데이터로 batch shape가 맞았다는 사실은 pretrained Octo를 불러 실제 demonstration으로 gradient update를 끝냈다는 증거가 아닙니다. 특히 transformer freeze, 새 action head, checkpoint 재시작은 첫 GPU 실험에서 따로 검증해야 합니다.
반대로 RL 경로가 더 길다고 해서 완료된 것도 아닙니다. G1 PPO는 학습을 여러 차례 실행했지만, 최근 후보들은 정량 지표 또는 영상 검증에서 탈락했습니다. 현재 상태는 “RL이 성공했다”가 아니라 실패를 재현하고 기각할 수 있는 평가 체계가 IL보다 먼저 만들어졌다에 가깝습니다. 전체 경과는 현재 G1 학습 방법과 중단 이유에 기록했습니다.
조작에는 BC가, 보행에는 RL이 자주 쓰이는 이유
이 구분은 로봇 종류보다 비용 구조에서 나옵니다. 물체를 잡고 조립하는 작업은 접촉 순서와 미세한 손 경로를 reward 항으로 전부 쓰기 어렵습니다. 대신 사람이 원격조작으로 성공 경로를 보여 주면 목표 행동을 직접 기록할 수 있습니다. 언어 명령과 영상까지 함께 저장하면 VLA fine-tuning의 입력도 됩니다. Octo가 서로 다른 로봇의 대규모 episode로 사전학습한 뒤 새 관측·action space에 적응하도록 설계된 이유입니다.
보행은 반대입니다. 사람이 G1의 20여 개 관절 목표를 매 순간 시연하는 비용이 높고, 균형을 잃는 경계 상태를 충분히 수집하기도 어렵습니다. 시뮬레이터에서는 forward velocity, 자세, 접촉, 에너지, termination을 반복 측정할 수 있습니다. 따라서 RL이 탐색으로 복구 동작까지 발견할 여지가 있습니다. 다만 reward가 실제 보행 품질을 대리하지 못하면, 대규모 탐색은 잘못된 목표를 더 빨리 최적화할 뿐입니다.
둘을 섞는 방법은 있지만, 순서를 건너뛸 수는 없습니다
실제 로봇 정책은 BC와 RL 중 하나만 고르는 경우보다 단계적으로 결합하는 경우가 많습니다. 전문가 시연으로 초기 정책을 만든 뒤 RL로 미세조정하면 무작위 탐색을 줄일 수 있습니다. 시뮬레이터의 강한 teacher 정책이 만든 trajectory를 작은 student가 모방하게 할 수도 있습니다. 기존 제어기 위에 residual policy만 RL로 학습하면 안전한 기본 동작을 유지하면서 보정량만 탐색할 수 있습니다.
그러나 이 프로젝트에서 이 조합들은 아직 채택된 구현이 아닙니다. BC 초기화라고 부르려면 실제 시연 데이터, 재현 가능한 fine-tuning checkpoint, held-out episode 평가가 먼저 있어야 합니다. RL fine-tuning이라고 부르려면 동일한 action·observation 계약으로 환경이 연결되고, reward와 안전 gate가 정해져야 합니다. 두 미완성 경로를 붙인다고 완성된 hybrid가 되지는 않습니다.
현재 프로젝트에서의 선택 규칙
지금 단계에서는 태스크마다 다음처럼 나누는 편이 가장 솔직합니다.
- G1 보행: PPO를 주 학습 경로로 유지합니다. 다만 승인되지 않은 checkpoint를 더 오래 학습하기 전에 관측 표현, action contract, reward와 제어기 경계를 먼저 진단합니다.
- Franka·휴머노이드 조작: BC 또는 VLA fine-tuning보다 episode 계약을 먼저 확정합니다. 한 개의 실제 teleoperation episode를 기록하고 재생했을 때 영상·state·action이 같은 사건을 가리키는지 확인합니다.
- 언어 명령 실행: VLA는 고수준 action proposal을 만들고, IK·WBC·저수준 정책이 실행 가능한 관절 명령으로 바꾸는 경계를 유지합니다. 이 구조는 VLA와 controller의 경계에 정리했습니다.
- loco-manipulation: 보행 정책과 조작 정책이 각각 자체 평가 gate를 통과한 뒤 결합합니다. 아직은 hybrid 학습보다 인터페이스와 실패 원인을 분리할 단계입니다.
다음 실험은 거대한 모델 학습이 아니라 한 episode 검증입니다
IL 경로의 다음 단계는 OpenVLA와 Octo를 동시에 비교하는 일이 아닙니다. Isaac Sim에서 한 번의 teleoperation episode를 기록하고, timestamp·frame·unit·action 의미를 검사한 뒤 동일한 trajectory를 재생하는 것입니다. 그 파일이 Octo loader와 window iterator를 통과하면 작은 실제 fine-tuning을 실행하고, 학습에 쓰지 않은 장면에서 action 범위·smoothness·태스크 성공률을 확인합니다.
RL 경로의 다음 단계 역시 PPO epoch를 늘리는 것이 아닙니다. 현재 G1 후보가 왜 보상은 얻으면서 보행 형상은 나빠졌는지 표현·controller·reward 중 어느 층에서 발생했는지를 고정 조건 평가로 좁혀야 합니다. 두 경로 모두 “학습이 돌아갔다”보다 “행동이 평가 gate를 통과했다”가 완료 조건입니다.
BC와 RL의 차이는 어느 쪽이 더 지능적인가가 아닙니다. 사람이 정답 행동을 제공할 수 있는가, 환경이 시행착오를 감당할 수 있는가, 그리고 성공을 수치로 빈틈없이 정의할 수 있는가의 차이입니다. 이 세 질문에 답하면 알고리즘 선택은 자연스럽게 따라옵니다. 같은 강화학습 안에서도 PPO와 SAC처럼 데이터를 다루는 방식이 갈리는 지점이 있습니다.
함께 읽기: Physical AI 전체 파이프라인 · episode 데이터 계약 · PPO의 작동 원리 · 현재 G1 학습 상태 · VLA와 controller의 경계
논문과 구현 참고: DAgger · PPO · ACT · Octo
기술 기준 시점: 2026-07-21. 저장소 상태는 origin/main@ee4d96e를 기준으로 확인했습니다. README의 목표 디렉터리와 실제 존재하는 구현 파일을 구분했으며, 승인된 IL 또는 G1 RL checkpoint가 있다는 뜻으로 읽어서는 안 됩니다.