강화학습과 PPO란 무엇인가 — 로봇에게 보상으로 가르치는 법
로봇에게 걷는 모습을 수천 장 보여 주는 방법만으로는, 미끄러질 때 어떻게 회복할지까지 가르치기 어렵습니다. 강화학습은 로봇이 직접 시도하고 그 결과에 […]
로봇에게 걷는 모습을 수천 장 보여 주는 방법만으로는, 미끄러질 때 어떻게 회복할지까지 가르치기 어렵습니다. 강화학습은 로봇이 직접 시도하고 그 결과에 […]
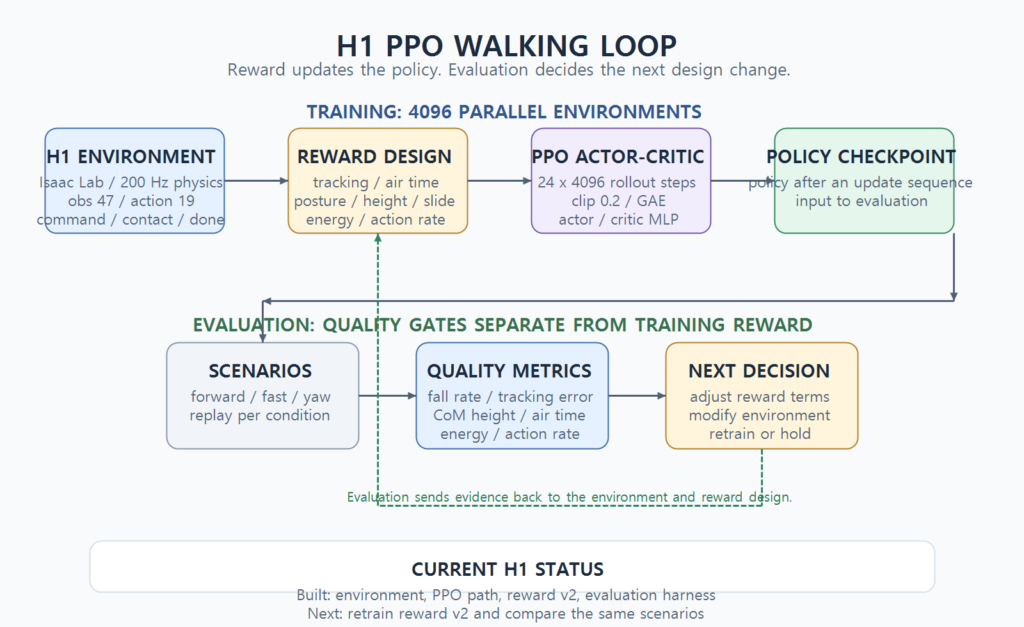
H1 보행에서 처음 얻은 체크포인트는 평균 episode length가 743까지 올라갔지만, 저는 그것을 자연 보행이라고 받아들이지 않았습니다. 넘어지지 않는 시간과 사람이

Epoch·iteration·step을 같은 학습 횟수로 비교하면 왜 틀리는지, 현재 Octo 모방학습과 G1 RSL-RL PPO 코드의 sample·batch·optimizer update 경계를 실제 설정값으로 계산해 정리합니다.
최근 G1 실험에서는 PPO 업데이트를 거친 로봇이 넘어지지 않고 계속 걸었는데도 새 정책을 채택하지 않았습니다. 느린 보행 경로가 기준보다 짧아졌기
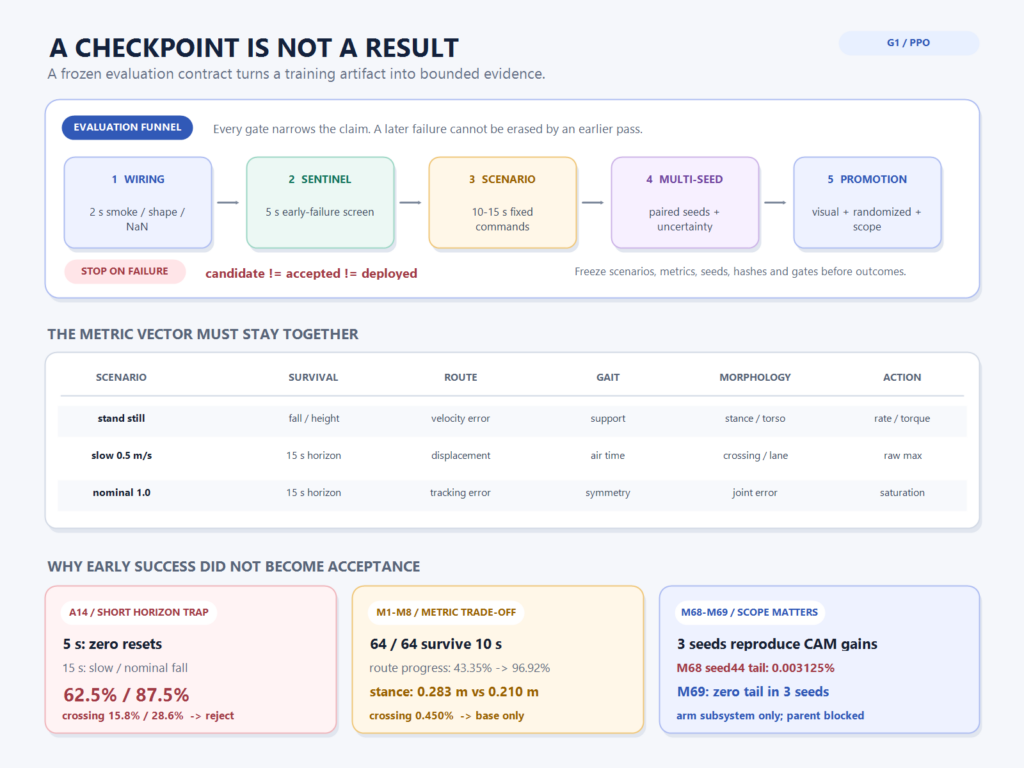
G1 motion-tracking 학습에서 가장 판단하기 어려웠던 순간은 로봇이 바로 넘어질 때가 아니었습니다. 오히려 64개 환경이 10초 동안 모두 살아남고, 기준
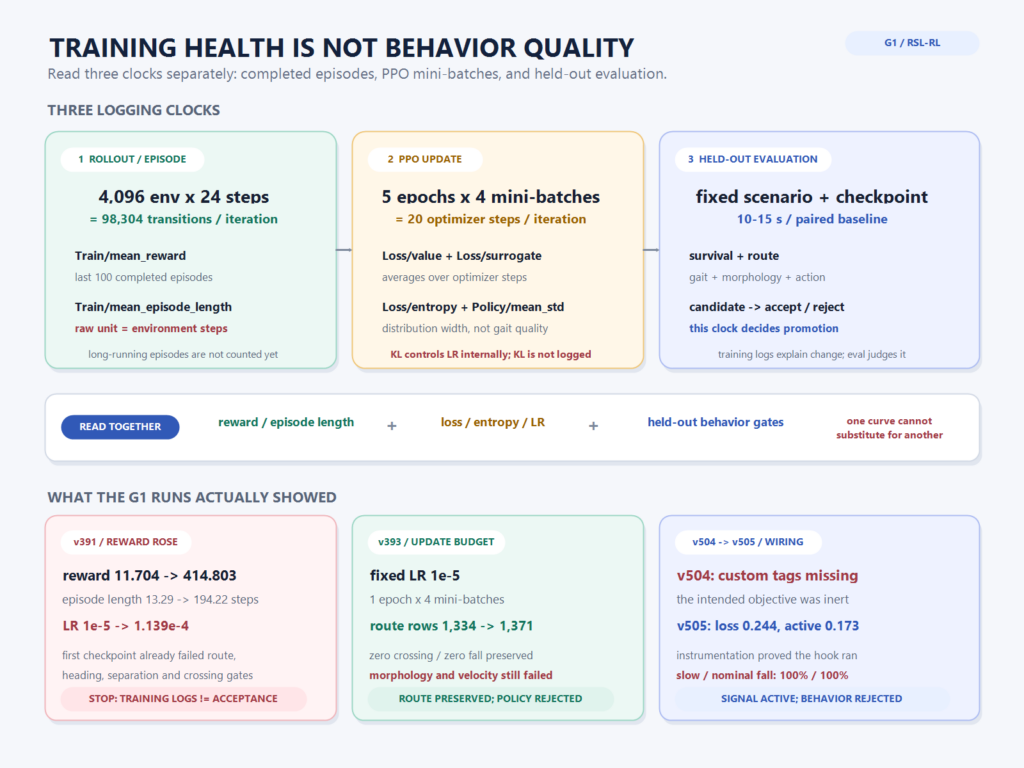
G1 v391 학습에서는 TensorBoard의 숫자만 보면 정책이 빠르게 좋아지는 것처럼 보였습니다. Train/mean_reward는 11.704에서 414.803으로 올랐고, Train/mean_episode_length도 13.29에서 194.22로 늘었습니다. adaptive
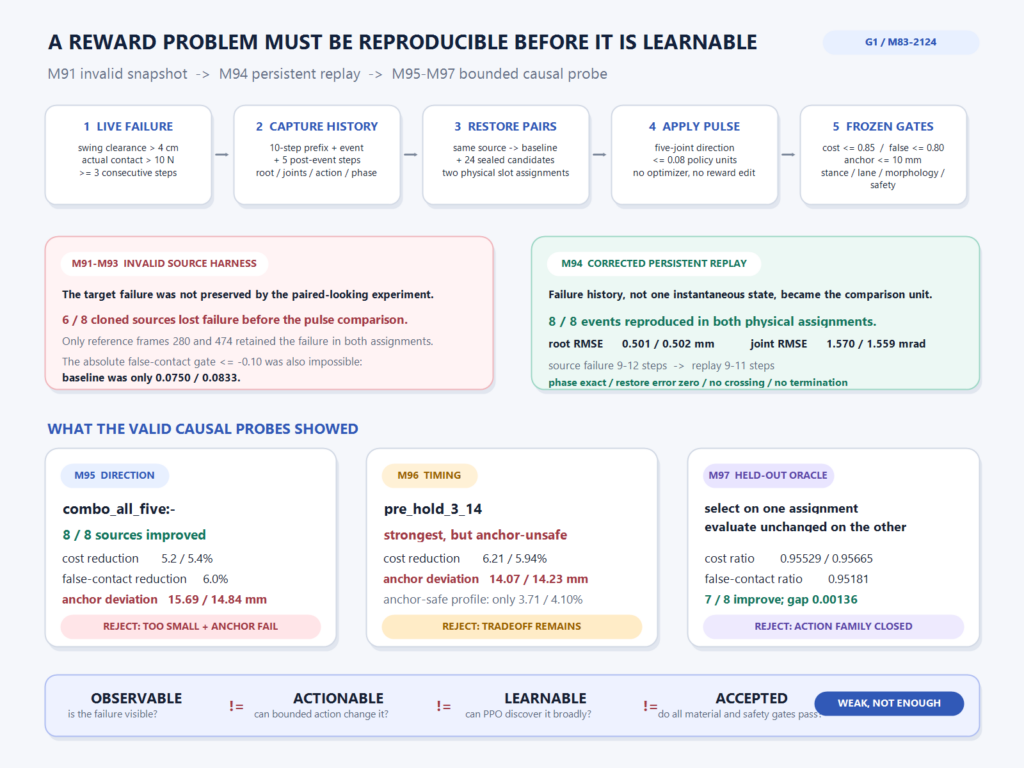
M95에서 다섯 관절에 작은 pulse를 넣자, 재현해 둔 여덟 개의 접촉 실패가 8개 모두 같은 방향으로 줄었습니다. 보통이라면 “유효한 방향을
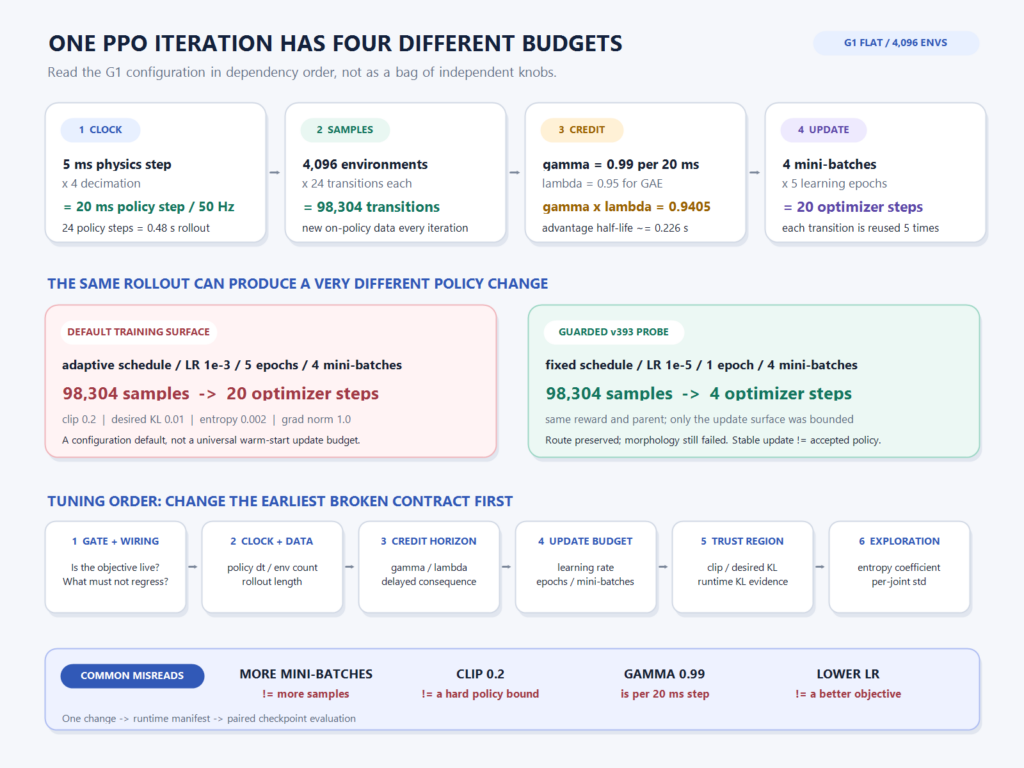
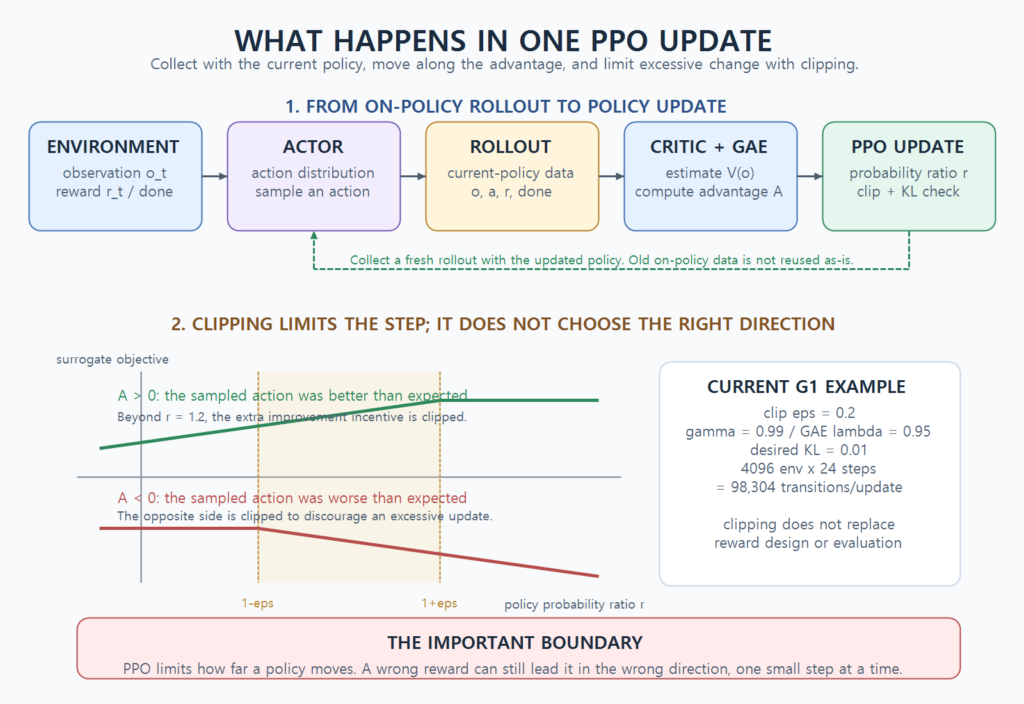
현재 G1 기본 설정은 한 번의 PPO iteration에서 98,304개의 transition을 모은 뒤 20번의 optimizer step을 수행합니다. 경로가 갑자기 무너지는 현상을

G1 PPO의 seed 재현성을 확인하던 M68 실험에서는 seed 42·43·44가 모두 목표로 삼은 두 지표를 개선했습니다. vertical CAM z RMSE는 3.67~4.09%,

현재 G1 기본 설정은 PPO iteration 하나를 위해 4,096개 환경에서 각각 24 step을 수집합니다. 한 번에 생기는 transition은 98,304개입니다. 이