G1 환경 설정에는 policy가 50Hz로 동작한다고 적혀 있습니다. 그런데 router smoke test에서 다섯 step을 실행해 보면 프로그램은 100ms를 기다리지 않습니다. policy_step을 0, 1, 2, 3, 4로 바꾸면서 가능한 한 빨리 다섯 번 추론할 뿐입니다. 반대로 Isaac Lab의 play.py는 한 step마다 시뮬레이션 시간을 20ms 전진시키지만, 그 계산이 실제 시계에서도 20ms 안에 끝났는지는 검사하지 않습니다.
두 실행 모두 쓸모가 있습니다. 전자는 request와 action의 자료형이 연결되는지 확인하고, 후자는 policy가 시뮬레이션 안에서 로봇을 움직이는지 보여줍니다. 다만 어느 쪽도 센서로부터 읽은 정보가 실제 20ms 안에 관절 명령으로 도착한다는 증거는 아닙니다. 저는 처음에 dt=1/200, decimation=4라는 두 줄을 보고 제어 주기 문제는 이미 정리됐다고 생각했습니다. 실행 경로를 시간 순서로 다시 펼쳐 보니, 그 두 줄이 보장하는 것은 20ms의 시뮬레이션 시간이었습니다.
이번 글은 그 차이를 기록합니다. 범위는 G1의 실시간 경로입니다. 센서가 물리량을 포착한 순간부터 state estimator, 73차원 actor observation, policy inference, 명령 전송과 actuator 수락을 거쳐 관절이 반응하기까지 어디에 시계가 필요하고, 현재 저장소는 그중 어디까지 구현했는지를 추적했습니다.
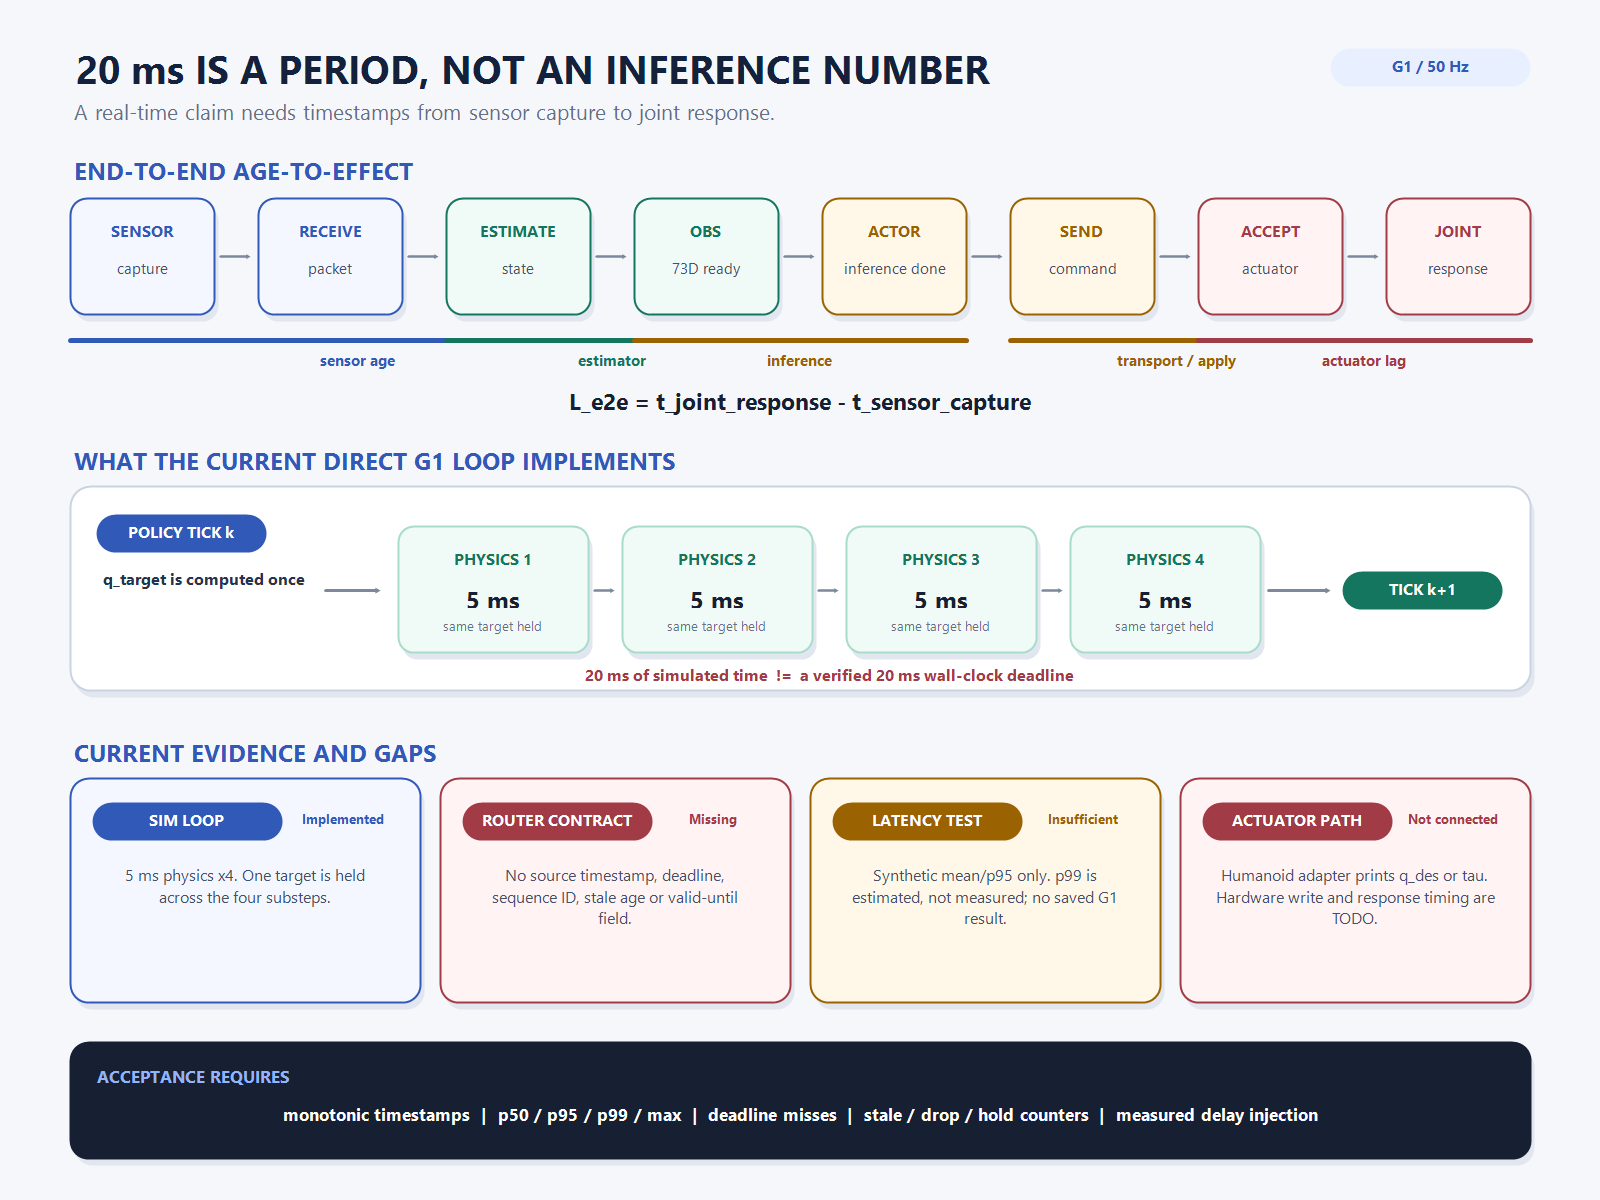
20ms는 inference budget이 아니라 control period입니다
50Hz의 역수는 20ms입니다. 이 값은 actor 하나에 20ms를 모두 써도 된다는 뜻이 아닙니다. 제어 tick k에서 사용할 observation이 준비되고, actor가 action을 만들고, 그 결과가 명령 인터페이스를 통과해 actuator에 수락되어야 다음 tick 전의 명령으로 의미가 있습니다. 센서 packet이 이미 오래됐다면 추론이 아무리 빨라도 controller는 과거를 보고 움직입니다.
실시간 경로의 사건을 다음처럼 놓을 수 있습니다.
t_sensor_capture
  -> t_packet_receive
  -> t_state_estimate
  -> t_observation_ready
  -> t_inference_done
  -> t_command_send
  -> t_actuator_accept
  -> t_joint_response

end-to-end age-to-effect
  = t_joint_response - t_sensor_capture
여기에는 서로 다른 종류의 시간이 섞여 있습니다. sensor age는 control tick에서 바라본 measurement의 나이입니다. estimator latency는 measurement를 actor가 쓸 상태로 바꾸는 시간이고, inference latency는 observation이 준비된 뒤 action을 얻기까지의 시간입니다. transport/apply latency는 action이 나온 뒤 actuator interface가 명령을 수락하기까지, actuator lag는 수락된 목표가 실제 관절 응답으로 나타날 때까지입니다.
예를 들어 sensor age가 12ms, 추정과 feature 생성이 2ms, inference가 6ms, 전송과 적용이 4ms라면 명령이 수락되는 시점에 이미 24ms가 지났습니다. 이 숫자는 현재 G1에서 측정한 결과가 아니라 budget을 설명하기 위한 예시입니다. 요점은 “inference 6ms니까 20ms 안에 충분하다”는 판단이 전체 경로에서는 틀릴 수 있다는 데 있습니다.
현재 Direct G1 환경이 실제로 구현한 시간 구조
origin/main@ee4d96e의 g1_walk_env_cfg.py에서 physics timestep은 1/200초, 즉 5ms이고 decimation은 4입니다. 따라서 actor는 시뮬레이션 시간 기준으로 20ms마다 한 번 호출됩니다. g1_walk_env.py의 _pre_physics_step()은 actor action을 복사하고 범위를 제한한 뒤 다음 위치 목표를 만듭니다.
q_target = nominal_q + 0.25 * clipped_action
robot.set_joint_position_target(q_target)
Isaac Lab의 DirectRLEnv 실행 순서를 보면 _pre_physics_step()은 RL step마다 한 번 호출되고, _apply_action()과 physics step은 decimation 횟수만큼 반복됩니다. 현재 G1에서는 한 번 만든 q_target을 5ms짜리 physics step 네 번 동안 유지합니다. 이것은 20ms 주기의 명확한 sample-and-hold입니다. 위치 목표가 어떻게 implicit PD와 torque로 이어지는지는 action→position target→PD→torque 경로를 다룬 글에서 별도로 정리했습니다.
여기서 헷갈렸던 부분은 “네 번 유지한다”와 “20ms 지연시킨다”가 같은 말처럼 보였다는 점입니다. 둘은 다릅니다. sample-and-hold는 tick k에서 만든 새 목표를 네 substep에 계속 적용하는 방식입니다. action delay는 tick k에서 만든 목표를 지금 적용하지 않고 과거 명령이나 buffer 속 명령을 적용하는 현상입니다. 현재 Direct G1 환경의 _prev_actions는 action-rate reward를 계산하기 위한 이전 action일 뿐, 통신 지연을 재현하는 queue가 아닙니다. 검색한 실행 경로에는 observation delay buffer나 action delay buffer가 없습니다.
따라서 현재 환경이 구현한 사실은 다음처럼 좁혀 말해야 합니다.
| 항목 | 현재 상태 | 코드가 증명하는 것 |
|---|---|---|
| physics timestep | 구현 | 시뮬레이션 시간이 5ms 단위로 전진한다 |
| policy period | 구현 | actor action 하나가 4 substep, 총 20ms 동안 유지된다 |
| wall-clock 20ms deadline | 미검증 | 실제 계산과 전송이 20ms 안에 끝나는지 기록하지 않는다 |
| sensor/estimator delay | 미구현 | timestamp가 붙은 측정·추정 buffer가 없다 |
| action/transport delay | 미구현 | 과거 action을 선택하거나 지연 분포를 주입하는 queue가 없다 |
| actuator response lag | 일부 모델링 | 시뮬레이터의 관절·PD 동역학은 있으나 실물의 측정 분포로 검증하지 않았다 |
Isaac Lab의 시간·decimation·병렬 rollout 자체는 Isaac Lab의 시간은 왜 실제 시간과 다른가에서 다뤘습니다. 이번 글에서 더 필요한 질문은 그 시뮬레이션 주기를 runtime deadline으로 잘못 읽지 않는 것입니다.
play.py의 20ms는 벽시계의 20ms가 아닙니다
G1의 play.py는 observation을 받고 policy를 호출한 다음 env.step(actions)를 실행합니다. loop 안에는 다음 tick의 절대 시각까지 기다리는 sleep_until, deadline을 넘겼는지 세는 counter, 늦은 action을 버리는 규칙이 없습니다. 렌더링이나 GPU physics가 충분히 빠르면 실제 시간보다 빠르게 돌 수 있고, 반대로 GUI와 physics가 느리면 20ms의 시뮬레이션을 계산하는 데 실제로 20ms보다 오래 걸릴 수도 있습니다.
이것이 simulation clock과 monotonic wall clock을 따로 기록해야 하는 이유입니다. simulation clock은 reward와 gait phase, episode 길이를 정의합니다. monotonic wall clock은 OS 시간 보정의 영향을 받지 않으면서 실제 실행 간격과 deadline miss를 측정합니다. 파일 이름에 쓰는 time.time() 하나로 두 역할을 대신할 수 없습니다.
router의 run_backend_once.py도 같은 오해를 만들기 쉽습니다. 각 loop에서 time_s = step * 0.02를 넣지만 20ms를 기다리지는 않습니다. 이 값은 synthetic state의 진행 시간을 흉내 낸 것이지 scheduler가 지킨 wall-clock tick가 아닙니다. 결국 이 smoke test가 통과했다는 말은 schema와 backend 호출이 연결됐다는 뜻으로 남겨야 합니다.
센서의 나이를 모르면 estimator가 빨라도 소용없습니다
이전 글에서 시뮬레이터 state와 실제 sensor measurement의 경계를 추적했습니다. Direct G1 actor는 Isaac Lab이 가진 정확한 root velocity와 quaternion을 읽어 73차원 observation을 만듭니다. 실물에서는 IMU, joint encoder, contact와 선택적인 외부 위치 정보가 서로 다른 시각에 도착하고 state estimator가 이를 결합해야 합니다.
latency 관점에서는 값의 종류만큼 timestamp의 출처가 중요합니다. joint position packet은 2ms 전 값인데 base velocity estimate는 14ms 전 measurement를 기반으로 할 수 있습니다. 단순히 두 tensor를 현재 시각에 concatenate하면 shape은 맞지만 같은 물리 시각의 상태가 아닙니다. 최소한 다음 정보가 observation과 함께 보존되어야 합니다.
control_tick_monotonic_ns
sensor_capture_timestamp_ns
packet_receive_timestamp_ns
estimate_timestamp_ns
observation_ready_timestamp_ns
source_sequence_id
stale_age_ns
clock_domain / synchronization status
현재 BackendRequest에는 robot profile, task profile, observation, state, instruction이 있지만 source timestamp, sequence ID, deadline, stale age가 없습니다. BackendResponse에도 action이 생성된 시각, 언제까지 유효한지, deadline을 넘겼는지 표현하는 필드가 없습니다. router 바깥에서 시간을 재는 것만으로 평균 호출 시간은 얻을 수 있지만, 어떤 센서 packet을 사용한 action인지까지 복원할 수는 없습니다.
GPU inference를 재는 타이머도 쉽게 거짓말합니다
PolicyLoader는 numpy observation을 tensor로 만들고 지정한 device에서 policy를 실행한 뒤 결과를 .cpu().numpy()로 가져옵니다. 여기에 현재 timing이나 warm-up, deadline 처리는 없습니다. CPU에서는 time.perf_counter()로 함수 앞뒤를 재는 방식이 대체로 직관적이지만 CUDA 연산은 비동기로 enqueue될 수 있습니다.
PyTorch의 공식 CUDA semantics 문서는 GPU 시간을 정확히 재려면 측정 구간 앞뒤에서 torch.cuda.synchronize()를 사용하거나 CUDA Event를 쓰라고 설명합니다. 동기화 없이 Python 함수의 반환 시각만 재면 GPU kernel이 끝나기 전의 시간을 읽을 수 있습니다. 현재 코드의 .cpu()는 결과를 CPU로 가져오기 위해 진행을 기다리게 되지만, 그것만으로 H2D copy, model execution, D2H copy, Python 후처리를 단계별로 분리해 주지는 않습니다.
# 측정 설계 예시
warm_up_policy()

t_obs_ready = monotonic_ns()
record_h2d_start()
record_cuda_event_start()
action_gpu = policy(obs_gpu)
record_cuda_event_end()
action_cpu = action_gpu.cpu().numpy()
t_action_ready = monotonic_ns()

report:
  observation build
  host-to-device
  GPU execution
  device-to-host
  postprocess
  total request-to-action
여기서도 평균만 보면 안 됩니다. model을 처음 호출할 때의 warm-up, CUDA context 생성, 메모리 할당, background load, logging I/O가 긴 꼬리를 만듭니다. 배포 전에는 warm-up 이후의 steady state와 cold start를 분리해 기록해야 합니다.
현재 latency benchmark를 그대로 합격 판정에 쓰기 어려운 이유
저장소에는 eval_backends.py와 이를 감싼 benchmark_latency.py가 있습니다. synthetic request로 backend를 warm-up한 뒤 time.perf_counter()로 backend.run_step()의 시간을 재고 mean과 p95를 계산합니다. 목적 자체는 좋습니다. 다만 현재 G1의 end-to-end 실시간성을 주장하기에는 네 가지 빈칸이 있습니다.
- G1 실측 결과 artifact가 없습니다. 스크립트는 있지만 현재 revision에서 신뢰할 수 있는 G1 latency 결과 JSON을 찾지 못했습니다.
- 측정 범위가 backend 호출뿐입니다. sensor ingress, state estimation, observation 생성, serialization, transport, adapter write, actuator response가 빠져 있습니다.
- p99를 측정하지 않습니다. 코드에서 p99는
p95 * 1.3으로 만든 근사값입니다. 존재하지 않는 percentile을 실측값처럼 보고해서는 안 됩니다. - 합격 조건이 mean 중심입니다. 평균이 20ms보다 작아도 일부 tick이 20ms를 넘으면 real-time deadline은 깨집니다.
ROS 2의 공식 real-time programming 자료도 periodic task에서는 평균뿐 아니라 최대 latency와 jitter, deadline 준수가 중요하다고 설명합니다. 현재 benchmark는 없애야 할 코드가 아니라 범위를 정확히 붙여야 할 코드입니다. 이름을 붙인다면 “synthetic backend call microbenchmark”에 가깝습니다. G1 deployment acceptance는 그 위에 별도로 만들어야 합니다.
| 지표 | 왜 필요한가 | 현재 상태 |
|---|---|---|
| p50 | 일반적인 실행 시간의 중심 | backend benchmark에서 계산 가능 |
| p95 | 상위 꼬리의 반복적인 느려짐 | backend benchmark에서 계산 |
| p99 | 드물지만 제어를 흔드는 긴 지연 | 실측하지 않고 근사 |
| max | 실험 중 최악의 정지·stall 확인 | 합격 판정에 포함되지 않음 |
| deadline miss rate | 20ms tick을 실제 몇 번 놓쳤는지 | counter 없음 |
| sensor stale age | actor가 얼마나 오래된 상태를 봤는지 | request contract에 없음 |
| drop/hold count | 늦은 명령에 어떤 대응을 했는지 | 정책 없음 |
router가 빨라도 actuator까지 연결됐다는 뜻은 아닙니다
runner.py는 request를 만들고 backend를 선택해 run_step()을 호출한 뒤 응답 JSON을 저장합니다. 현재는 synchronous한 흐름이고 rate controller, absolute deadline, watchdog이 없습니다. 응답 뒤에 step별 JSON 파일을 쓰는 것도 실제 loop에서는 별도 계측해야 합니다. 파일 쓰기가 항상 문제가 된다고 단정할 수는 없지만, control path에 동기 I/O가 들어 있으면 tail latency의 원인이 될 수 있기 때문입니다.
더 큰 경계는 HumanoidAdapter입니다. response의 q_des나 tau를 joint target 형태로 변환하지만 apply_to_sim()은 현재 값을 출력하고 실제 Isaac Sim articulation 또는 Unitree SDK로 쓰는 부분은 아직 구현되지 않은 상태입니다. 즉 지금 측정할 수 있는 router latency가 빨라도 sensor→actor→real actuator의 마지막 구간까지 검증한 것이 아닙니다.
현재 G1 candidate checkpoint의 readiness 문서도 이 경계를 지킵니다. forced-RL live-state smoke는 3/3 성공했고 짧은 closed-loop bridge는 150/150 step을 생존했지만 lateral/yaw drift와 action saturation이 컸습니다. 문서는 candidate를 deployment-ready로 승격하지 않습니다. 이 결과는 shape와 짧은 시뮬레이션 폐루프가 이어졌다는 증거이지, 20ms runtime contract의 합격표는 아닙니다.
지연과 actuator lag를 같은 randomization으로 묶으면 원인을 잃습니다
sim-to-real에서 latency를 넣자는 말은 맞지만, 어느 위치에 넣는지가 더 중요합니다. sensor delay는 actor가 과거 state를 보게 만듭니다. estimator delay와 jitter는 feature마다 age가 달라지는 문제를 만듭니다. action transport delay는 actor가 만든 명령이 늦게 적용되게 합니다. actuator lag는 명령이 제시간에 수락됐더라도 관절이 목표를 따라가는 속도를 바꿉니다.
이 네 가지를 하나의 “delay=10ms” 파라미터로 합치면 policy가 무엇에 견딘 것인지 알기 어렵습니다. 다음과 같이 buffer 위치를 분리해야 합니다.
observation delay:
  obs[k] <- state_buffer.select(tick_time - sampled_sensor_age)

estimator jitter:
  estimate_ready_time <- capture_time + sampled_estimator_delay

action delay:
  applied_action[k] <- action_buffer.select(apply_time)

actuator response:
  q, dq <- actuator_model(q_des, tau, gain, friction, bandwidth)
여기에는 한 가지 구현상의 함정이 더 있습니다. policy period가 20ms이므로 action을 integer policy step으로만 지연시키면 가능한 지연이 0ms, 20ms, 40ms처럼 거칠어집니다. 실물에서 측정한 전송 지연이 5~15ms 범위라면 이를 0 또는 20ms로 반올림하는 셈입니다. 현재 physics step은 5ms이므로 substep 단위 queue를 쓰거나 timestamp를 가진 command를 physics step에서 선택해야 더 세밀하게 재현할 수 있습니다. 이것은 아직 구현됐다는 설명이 아니라 현재 시간 구조에서 따라오는 설계 결론입니다.
Theory.md와 sim-to-real 노트에는 latency와 domain randomization의 예시 범위가 이미 있습니다. 하지만 예시 범위가 문서에 존재하는 것과 Direct G1 env가 그 분포를 실제로 sampling하는 것은 별개의 완료 조건입니다. 이번 점검에서는 해당 delay injection 경로를 G1 환경에서 찾지 못했습니다. 앞으로는 먼저 hardware에서 분포를 측정한 뒤, 같은 단위와 같은 buffer 위치로 시뮬레이션에 옮겨야 합니다.
이 접근은 선행 연구와도 맞닿아 있습니다. Tan 등은 사족보행 policy를 실물로 옮길 때 actuator model과 latency를 시뮬레이션에 포함했고, 이를 정확히 모델링하지 않은 controller는 실제 로봇에서 실패했다고 보고했습니다. 여기서 가져와야 할 결론은 임의로 큰 delay를 주면 된다는 것이 아니라, 실물에서 실패를 만드는 동역학과 지연을 구분해 모델링해야 한다는 점입니다.
deadline을 놓쳤을 때 무엇을 할지도 policy contract입니다
실시간 시스템은 모든 tick이 제시간에 끝난다는 희망만으로 만들 수 없습니다. action이 20ms를 넘겼을 때 어떤 명령을 적용할지 미리 정해야 합니다. 선택지는 hold last command, 늦은 action drop, 제한된 safe posture, backend fallback, actuator disable처럼 여러 가지입니다. 어느 것이 맞는지는 로봇과 task에 따라 다르지만 규칙이 없다는 상태가 가장 위험합니다.
특히 늦게 도착한 action을 무조건 적용하면 이미 바뀐 상태에 과거 판단을 덮어쓸 수 있습니다. 따라서 response에는 최소한 sequence ID, generation timestamp, valid-until 또는 target tick이 필요합니다. runtime은 이를 이용해 다음을 기록해야 합니다.
- deadline 전에 도착해 정상 적용한 action 수
- 늦어서 버린 stale action 수
- 이전 command를 유지한 tick 수와 연속 hold 길이
- safe state 또는 fallback으로 전환한 횟수와 원인
- sensor stale, estimator failure, inference overrun, transport error의 구분
이 글에서는 어떤 안전 정책을 확정하지 않습니다. 현재 adapter가 실물 actuator에 연결되지 않은 상태에서 구체적인 timeout 값을 정하면 근거 없는 숫자가 되기 때문입니다. 먼저 필요한 것은 event timestamp와 fail-closed한 실험 harness입니다.
제가 다음에 만들 latency acceptance test
이번 코드 추적을 마친 뒤, "inference를 몇 ms에 했는가" 하나만 재는 계획을 버렸습니다. 다음 검증은 계층을 세 단계로 나눠야 합니다.
1. Actor microbenchmark
G1의 실제 73차원 observation과 candidate checkpoint를 사용합니다. CPU와 GPU를 구분하고, warm-up 이후 최소 수천 회의 p50·p95·p99·max를 저장합니다. GPU에서는 CUDA Event와 host wall clock을 함께 사용해 model 실행과 전체 request-to-action을 분리합니다. 이 단계는 policy 자체의 계산 비용을 측정합니다.
2. Router-in-the-loop benchmark
timestamp가 포함된 BackendRequest/Response를 사용하고 selector, feature build, tensor copy, inference, adapter conversion, logging을 구간별로 잽니다. logging on/off 결과를 분리하고 deadline miss, stale, drop, hold counter를 결과 artifact에 저장합니다. 기존 episode timestamp와 schema 계약은 offline data의 시간 구조를 다루고, 여기서는 live control packet의 시간 계약을 다룹니다.
3. Sensor-to-actuator hardware-in-the-loop test
sensor capture 또는 hardware timestamp에서 시작해 actuator가 command를 수락한 시각과 joint response까지 측정합니다. 가능하다면 GPIO 또는 외부 계측처럼 서로 다른 장치의 clock을 검증할 수 있는 기준도 둡니다. 그 분포를 얻은 뒤에 observation delay, action delay, actuator lag를 Direct G1 환경의 서로 다른 지점에 주입합니다.
| 단계 | 입력→출력 | 합격 증거 | 현재 판정 |
|---|---|---|---|
| Actor | 73D observation→29D action | 실측 p50/p95/p99/max, CPU·GPU 분리 | 미측정 |
| Router | timestamped request→timestamped command | 구간별 latency, deadline miss, stale/drop/hold | contract 미구현 |
| Simulator | action→5ms×4 physics | sample-and-hold 및 delay buffer 단위 test | hold 구현, delay buffer 없음 |
| Adapter | command→actuator interface | 전송·수락 timestamp와 오류 처리 | 출력만 구현 |
| Robot | sensor capture→joint response | end-to-end distribution과 deadline acceptance | 미실행 |
이번 점검에서 확인한 결론
현재 G1의 50Hz는 거짓 설정이 아닙니다. Direct G1 환경은 5ms physics step 네 번마다 actor action을 갱신하고, 그 사이에는 동일한 위치 목표를 유지합니다. 다만 이것은 simulation-time control period입니다. 실제 sensor packet의 나이, estimator 계산, actor inference, router와 adapter, actuator 수락과 관절 응답이 모두 20ms 안에 들어온다는 주장은 아직 할 수 없습니다.
가장 먼저 고쳐야 할 것은 model을 더 빠르게 만드는 일이 아니라 시간이 어디에서 사라졌는지 관측할 수 있는 contract입니다. monotonic timestamp, sequence ID, target tick, valid-until, deadline miss와 stale/drop/hold counter가 있어야 다음 최적화가 inference인지 estimator인지 transport인지 판단할 수 있습니다. 그리고 실물에서 얻은 분포를 observation delay, action delay, actuator lag로 나눠 시뮬레이터에 되돌려 넣어야 sim-to-real loop가 닫힙니다.
전체 배포 경계는 G1 sim-to-real 검증 스택에서 다뤘습니다. 이번 글이 그 지도에 추가한 것은 하나입니다. 20ms는 config에 적는 숫자가 아니라, sensor에서 actuator까지 모든 사건에 timestamp를 남긴 뒤에야 검증되는 계약입니다.
참고 자료
- Isaac Lab, DirectRLEnv source — policy step과 decimation substep의 실행 순서
- PyTorch, CUDA semantics — 비동기 CUDA 연산의 정확한 시간 측정
- ROS 2, Understanding real-time programming — periodic deadline, jitter와 최대 latency
- Tan et al., Sim-to-Real: Learning Agile Locomotion For Quadruped Robots — actuator model과 latency를 포함한 sim-to-real 사례