현재 저장소에는 서로 다른 두 policy 경로가 있습니다. G1 보행 actor는 73개의 숫자를 받아 29개 관절 action을 내는 MLP입니다. OpenVLA 경로는 RGB image와 자연어 instruction을 REST server로 보내 7차원 조작 action을 받도록 설계돼 있습니다. 둘 다 입력을 행동으로 바꾸는 신경망 policy인데 내부 모양은 전혀 다릅니다.
이 차이를 단순히 “Transformer가 더 최신이라서”라고 설명하면 실제 모델 선택에 도움이 되지 않습니다. MLP, CNN, Transformer는 우열표가 아니라 입력 안에 어떤 구조가 있다고 가정하고 그 관계를 어떤 방식으로 계산할 것인가에 대한 서로 다른 답입니다. 이 글에서는 현재 G1 MLP를 기준점으로 삼아 세 구조의 계산 방식과 실패 조건을 비교하고, 모델 구조와 PPO·BC 같은 학습 방법이 왜 별개의 축인지 정리합니다.
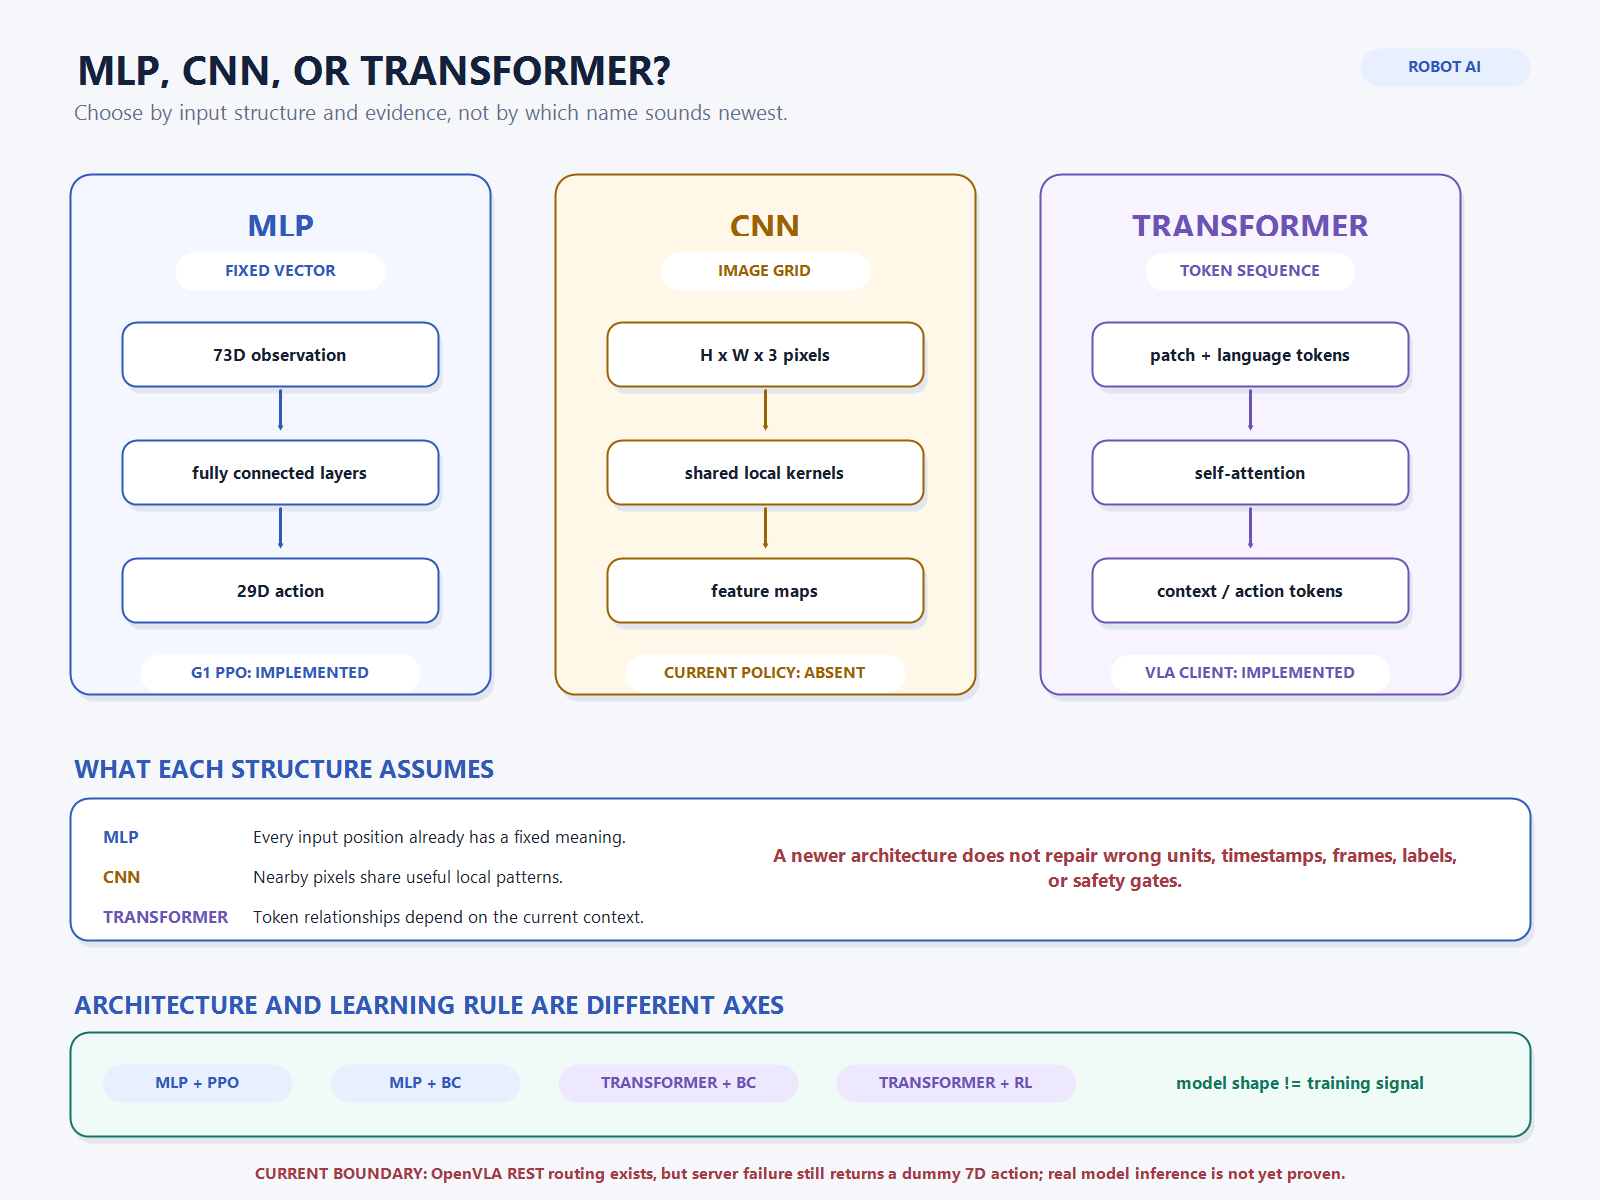
모델 구조를 고른다는 것은 데이터의 관계를 미리 정하는 일입니다
신경망은 결국 parameter를 가진 함수입니다. 앞 글에서 살펴본 것처럼 forward pass가 현재 weight로 출력을 만들고, loss와 gradient, optimizer step이 그 weight를 바꿉니다. 자세한 학습 사건은 AI 모델 학습 입문 글이 맡습니다. 이번에 분리해서 볼 것은 같은 update 절차 안에서도 layer의 연결 방식이 왜 달라지는가입니다.
예를 들어 G1 observation의 10번째 값은 임의의 숫자가 아니라 특정 joint position과 연결돼 있습니다. 반면 이미지의 한 pixel은 카메라가 조금 이동하면 다른 위치로 옮겨집니다. 문장의 “컵”이라는 token은 앞에 “빨간”이 있는지, “컵을 내려놓아”가 있는지에 따라 참고해야 할 문맥이 달라집니다. 이 세 입력을 하나의 납작한 vector로 만들 수는 있지만, flatten할 수 있다는 사실과 그 표현이 계산에 적합하다는 사실은 다릅니다.
| 구조 | 입력에서 보존하는 관계 | parameter를 공유하는 방식 | 대표적인 로봇 입력 |
|---|---|---|---|
| MLP | 고정된 feature index | 각 layer의 모든 입력·출력 연결 | joint state, command, compact sensor vector |
| CNN | 2D 이웃과 공간 격자 | 같은 kernel을 여러 위치에 반복 적용 | RGB, depth, height map |
| Transformer | token 사이의 문맥 관계 | 같은 attention projection을 모든 token에 적용 | language, image patch, trajectory, multimodal token |
MLP는 의미가 고정된 벡터를 빠르게 action으로 바꿉니다
다층 퍼셉트론(Multi-Layer Perceptron, MLP)은 linear layer와 activation을 순서대로 연결합니다. PyTorch의 model 구성 문서에서 설명하는 nn.Linear처럼 한 layer의 각 출력은 이전 layer 전체와 weight로 연결됩니다.
h1 = ELU(W1 · observation + b1)
h2 = ELU(W2 · h1 + b2)
action = W4 · h3 + b4
현재 G1 actor는 73 → 512 → 256 → 128 → 29 구조입니다. 입력은 body-frame linear·angular velocity 각 3개, projected gravity 3개, effective command 3개, gait phase 2개, target swing side 1개, joint position offset 29개, joint velocity 29개로 구성됩니다. 마지막 29개 출력은 관절 이름을 스스로 읽는 것이 아니라 미리 고정한 joint 순서에 대응합니다. 이 actor MLP의 weight와 bias는 205,853개입니다.
여기서 MLP의 장점과 약점이 동시에 나옵니다. 73개 feature의 의미와 순서가 정확히 고정돼 있으면 한 번의 dense matrix 연산으로 action을 빠르게 계산할 수 있습니다. 하지만 joint order가 바뀌어도 shape는 여전히 73일 수 있고, MLP는 첫 번째 값의 의미가 달라졌다는 사실을 알지 못합니다. 그래서 joint order·checkpoint 호환성 글에서는 tensor shape보다 ordered manifest를 먼저 검증했습니다.
MLP가 시간을 기억하는 것도 아닙니다. 현재 frame 하나만 넣으면 직전 contact가 어떻게 바뀌었는지 내부 state로 보존하지 않습니다. 짧은 history를 observation에 이어 붙이거나 recurrent module을 추가해야 합니다. 이 경계는 observation history와 POMDP 글에 분리해 두었습니다. 구조가 단순하다는 것은 무능하다는 뜻이 아니라, 입력 계약이 더 많은 책임을 진다는 뜻입니다.
CNN은 작은 kernel을 이동시키며 이미지의 국소 패턴을 찾습니다
합성곱 신경망(Convolutional Neural Network, CNN)은 이미지 전체를 한 번에 dense layer에 연결하지 않습니다. 작은 kernel이 가로·세로 위치를 이동하며 같은 weight로 주변 pixel을 계산합니다. PyTorch Conv2d 문서의 weight shape가 out_channels × in_channels × kernel_h × kernel_w인 이유입니다. image width와 height가 커져도 같은 kernel parameter를 여러 위치에서 재사용합니다.
224×224 RGB image를 곧바로 64개 출력에 fully connected로 연결하면 bias까지 9,633,856개의 parameter가 필요합니다. 반면 3×3 kernel로 3채널을 64채널 feature map으로 바꾸는 convolution은 1,792개입니다. 이 비교는 실제 프로젝트 model 크기가 아니라 weight sharing의 효과를 보여 주는 산술 예시입니다.
fully connected: (224 × 224 × 3) × 64 + 64 = 9,633,856
3×3 convolution: (3 × 3 × 3) × 64 + 64 = 1,792
같은 edge나 corner가 image 왼쪽에 있든 오른쪽에 있든 같은 kernel로 찾을 수 있다는 가정은 camera 입력에 잘 맞습니다. 여러 convolution layer를 쌓으면 작은 edge에서 texture와 object part로 receptive field가 넓어집니다. 대신 멀리 떨어진 두 영역의 관계는 여러 layer를 거쳐야 연결되고, camera calibration·depth alignment·좌표계 같은 기하 정보가 틀리면 feature가 좋아도 robot-frame action은 틀릴 수 있습니다.
현재 workspace에는 RGB episode schema와 image path를 받는 VLA client가 있지만, CNN을 학습해 action을 내는 별도 policy는 확인되지 않습니다. 따라서 “카메라 경로가 있다”와 “CNN perception이 구현·실행됐다”를 같은 상태로 쓰지 않습니다. pixel이 실제 3D point가 되기 위한 계약은 CameraInfo와 optical frame 글이 소유합니다.
Transformer는 token마다 지금 참고할 상대를 다시 계산합니다
Transformer는 입력을 token sequence로 보고 self-attention으로 token 사이의 관계를 계산합니다. Attention Is All You Need에서 제안한 핵심 계산은 각 token을 query, key, value로 투영한 뒤 query와 key의 유사도로 value를 섞는 것입니다.
Attention(Q, K, V) = softmax(QKᵀ / √d) VMLP의 고정 연결과 달리 attention weight는 현재 입력 내용에 따라 달라집니다. “빨간 블록을 집어라”라는 instruction token이 image 안의 어느 patch와 강하게 연결될지 매 입력에서 다시 계산할 수 있습니다. 다만 token 순서를 attention만으로 알 수는 없으므로 position information이 필요하고, full self-attention은 token 수 n에 대해 n × n 관계를 만듭니다. 문맥 범위가 넓어지는 대신 token 수와 memory cost가 함께 커집니다.
이미지도 token으로 바꿀 수 있습니다. Vision Transformer는 image를 patch로 나누고 각 patch를 vector로 투영해 Transformer에 넣었습니다. 224×224 image를 16×16 patch로 나누면 14×14, 즉 196개 patch token이 생깁니다. CLS token을 제외해도 한 attention score map은 196×196=38,416개의 token pair를 가집니다. patch를 더 작게 만들면 공간 해상도는 높아지지만 attention 비용도 증가합니다.
VLA는 하나의 Transformer가 아니라 여러 구조를 이어 붙인 시스템입니다
VLA를 “이미지용 Transformer” 한 단어로 줄이면 내부 경계를 놓칩니다. OpenVLA는 SigLIP과 DINOv2 visual encoder의 feature를 projector로 Llama 2 embedding 공간에 맞추고, language와 image context에서 tokenized action을 예측합니다. visual encoder, connector, language backbone, action representation이 연결된 구조입니다.
더구나 Transformer block 안에도 MLP가 들어갑니다. ViT의 patch projection은 convolution으로 구현할 수도 있고, 일부 robot policy는 CNN feature를 Transformer에 넘긴 뒤 마지막 action head를 다시 MLP로 만듭니다. 따라서 실제 model을 읽을 때 “CNN인가 Transformer인가”를 하나만 고르는 대신 어느 구간이 공간 특징을 만들고, 어느 구간이 token을 융합하며, 어느 head가 action을 출력하는가를 봐야 합니다. 전체 VLA 입력·action 흐름은 VLA 입문 글에 남겨 두었습니다.
모델 구조와 학습 방법은 서로 다른 축입니다
MLP·CNN·Transformer는 계산 graph의 구조입니다. PPO·behavior cloning(BC)·self-supervised learning은 parameter를 바꾸는 학습 신호와 objective입니다. 둘을 같은 분류표에 놓으면 “Transformer는 지도학습이고 MLP는 강화학습” 같은 잘못된 결론이 생깁니다.
| 모델 구조 | 가능한 학습 방법 | 현재 프로젝트 예 |
|---|---|---|
| MLP | PPO, SAC, BC, regression | G1 actor·critic을 PPO로 학습하도록 구현 |
| CNN | classification, contrastive learning, BC, RL | 현재 독립 CNN policy 실행 근거 없음 |
| Transformer | next-token prediction, BC, offline RL, online RL | VLA 설계·REST client는 있으나 실제 inference 미검증 |
같은 Transformer라도 OpenVLA는 action token 예측에, Octo는 관측·task token을 처리한 뒤 diffusion action head에 사용할 수 있습니다. 반대로 같은 PPO도 vector MLP나 recurrent policy, visual encoder가 붙은 actor를 학습할 수 있습니다. 시연과 reward의 차이는 BC와 강화학습 비교 글, PPO의 update는 PPO 작동 원리 글이 각각 맡습니다.
현재 workspace에서 실제로 확인된 상태는 세 구조가 서로 다릅니다
workspace@4f0d6a3을 기준으로 G1 MLP에는 environment, PPO config, training entry point, checkpoint에서 actor layer를 복원하는 PolicyLoader가 있습니다. 이 경로는 executable code로 구현돼 있습니다. 그러나 router의 G1 checkpoint path는 현재 null이므로 승인된 G1 actor가 runtime에 배포됐다는 뜻은 아닙니다.
VLA 쪽에는 openvla/openvla-7b라는 model name, REST endpoint, image와 instruction payload, 7D action post-processing이 선언돼 있습니다. 하지만 OpenVLAClient는 server가 없거나 image를 읽지 못해도 near-zero dummy action을 반환하며, 상위 VLABackend는 그 결과를 status="ok"로 포장합니다. 현재 코드만 보면 실제 Transformer가 계산한 7D action과 fallback 7D action을 응답 status로 구분할 수 없습니다.
Octo fine-tuning 파일도 model load와 dataset adapter의 형태는 적혀 있지만 training loop는 구현되지 않은 stub입니다. 이 세 상태를 나란히 놓으면 “MLP는 구현됐고 Transformer는 미구현”처럼 단순화할 수도 없습니다. G1은 학습·로딩 code path가 구현됐지만 배포 checkpoint가 비어 있고, VLA는 routing client가 구현됐지만 server-side model execution evidence가 없으며, Octo는 계획과 adapter 수준입니다.
| 경로 | 설계 | 실행 가능한 local code | 실제 model 계산 증거 | 승인·배포 |
|---|---|---|---|---|
| G1 MLP PPO | 있음 | environment·train·loader | 과거 실험은 별도 기록, 현재 router는 checkpoint null | 아님 |
| classic CNN policy | 일반 이론 노트 | 독립 action policy 없음 | 없음 | 아님 |
| OpenVLA Transformer | config·router contract | REST client·post-process | server/model provenance 없음 | 아님 |
| Octo Transformer | adapter·학습 인자 | synthetic dry-run path | training loop가 stub | 아님 |
구조 선택은 입력, 시간 범위, 계산 예산, 실패 비용 순서로 읽습니다
새 model을 볼 때 parameter 수부터 비교하기보다 입력의 관계를 먼저 봅니다. joint state처럼 index 의미가 고정되고 한 control tick의 계산 시간이 짧아야 한다면 MLP가 강한 기준선입니다. image의 local texture와 edge가 핵심이라면 CNN의 weight sharing이 합리적입니다. 여러 camera patch와 language, state history를 문맥에 따라 연결해야 한다면 Transformer가 필요한 관계를 더 직접 표현할 수 있습니다.
그 다음에는 정보량과 latency를 함께 봅니다. 더 많은 frame과 더 작은 image patch는 더 많은 token을 만들지만, stale image를 오래 계산해 늦은 action을 내면 control 품질은 오히려 나빠질 수 있습니다. sensor age부터 actuator response까지의 예산은 latency budget 글이 소유합니다. 모델 구조가 크다는 사실만으로 perception error, timestamp mismatch, action frame 오류를 해결하지 못합니다.
마지막은 실패를 어떻게 알아챌 것인가입니다. MLP는 input index와 normalization hash를, CNN은 resize·crop·camera calibration과 feature source를, Transformer는 tokenizer·position·context length·model identity를 checkpoint와 함께 남겨야 합니다. 어떤 구조든 action shape 하나만 맞는 것은 약한 증거입니다. 입력과 weight, 전처리, output provenance가 같은 run ID로 연결돼야 실제 inference라고 부를 수 있습니다.
다음 검증은 Transformer를 더 크게 만드는 일이 아니라 dummy와 real inference를 분리하는 일입니다
현재 VLA 경로에서 가장 먼저 닫아야 할 문제는 model 성능 비교가 아닙니다. server를 의도적으로 끈 요청과 실제 OpenVLA server가 응답한 요청이 같은 status="ok"로 보이지 않게 해야 합니다. 응답에는 최소한 inference_mode, model/checkpoint ID, image hash, preprocessing ID, latency, fallback reason이 필요합니다.
그 뒤 고정 image와 instruction 한 쌍을 canary로 사용해 real response와 server-off dummy를 비교할 수 있습니다. action이 7차원이라는 조건만 보지 않고, model provenance가 존재하는지, 반복 요청의 deterministic 조건이 무엇인지, post-process 전후 값과 clamp가 어떻게 달라졌는지를 확인합니다. VLA action 이후 camera frame과 WBC·IK 경계는 VLA 제어 경계 글에서 이어집니다.
세 구조의 차이는 무엇을 연결하느냐에서 시작합니다
MLP는 의미가 고정된 vector index를 dense connection으로 묶습니다. CNN은 같은 local kernel을 image 여러 위치에 공유합니다. Transformer는 현재 context에서 token pair의 관계를 다시 계산합니다. 셋은 같은 loss와 optimizer로도 학습할 수 있고, 하나의 VLA 안에서 함께 사용될 수도 있습니다.
현재 프로젝트에서 방어 가능한 결론도 여기까지입니다. G1의 vector MLP code path는 구현돼 있지만 승인 checkpoint가 router에 배포된 상태는 아닙니다. camera와 language를 받는 VLA routing은 구현돼 있지만 실제 Transformer inference와 dummy fallback의 provenance가 닫히지 않았습니다. 다음 선택은 더 최신 model 이름이 아니라, 입력 구조와 실행 증거를 일치시키는 데서 시작해야 합니다.