로봇 실험은 학습 버튼을 누르기 전에 시작된다
로봇에게 새로운 동작을 가르치는 일은 언제 시작될까요. 처음에는 학습 프로그램을 실행하는 순간이라고 생각했습니다. 하지만 몇 번 작업을 이어 보니, 그보다 […]
진행 중인 로보틱스 프로젝트의 설계, 구현, 실험 기록
로봇에게 새로운 동작을 가르치는 일은 언제 시작될까요. 처음에는 학습 프로그램을 실행하는 순간이라고 생각했습니다. 하지만 몇 번 작업을 이어 보니, 그보다 […]
어제의 로봇 실험을 오늘 다시 열었을 때, 무엇이 같아야 “재현했다”고 말할 수 있을까요. 처음에는 같은 코드를 실행해 비슷한 결과가 나오면
로봇 학습은 버튼을 누르고 오래 기다리면 저절로 좋아질까요? PPO는 시행착오를 반복하며 행동 정책을 다듬는 강화학습 방법이지만, 실제 작업에서 더 어려운

프로젝트를 기록하다 보면 “어차피 같은 로봇 작업인데 한곳에 모으면 되지 않을까”라는 생각이 듭니다. 저도 처음에는 설계 메모와 실험 결과, 다음
로보틱스 분야를 따라가다 보면 새 모델과 새로운 학습 방법이 거의 매달 나옵니다. 이름만 보면 지금 쓰는 도구를 곧바로 바꾸지 않으면
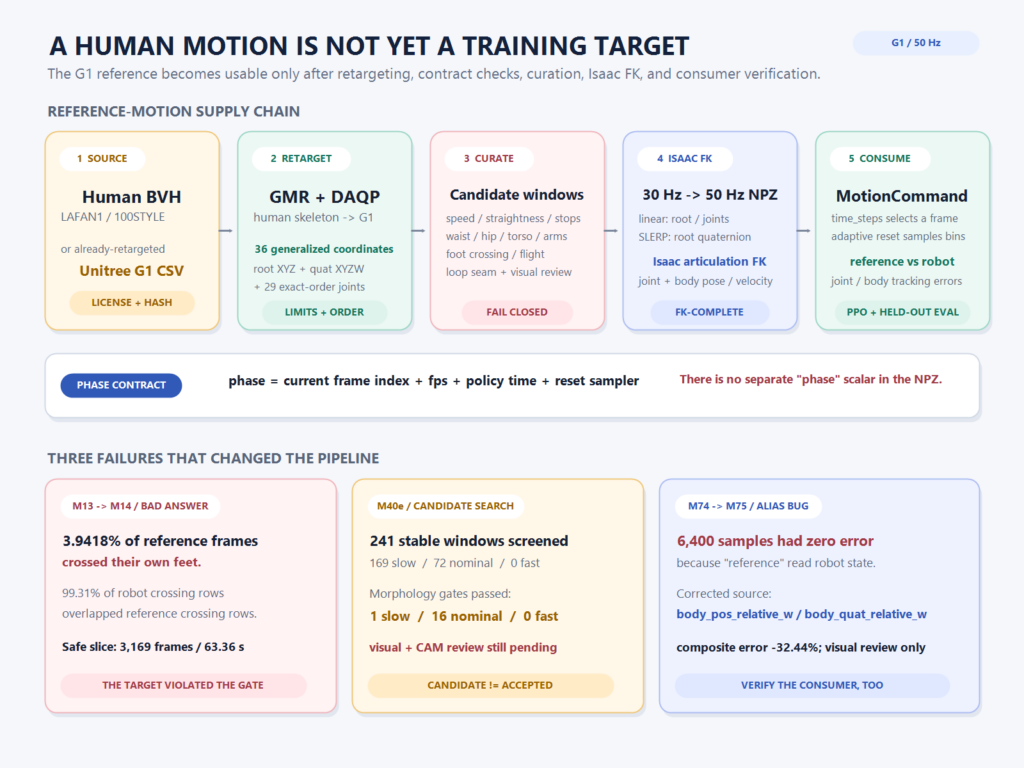
G1 보행 정책을 학습시키면서 한동안 이상한 현상을 보고 있었습니다. 로봇의 발 교차를 실패로 판정하도록 평가기를 만들었는데, 학습된 로봇은 특정 구간에서
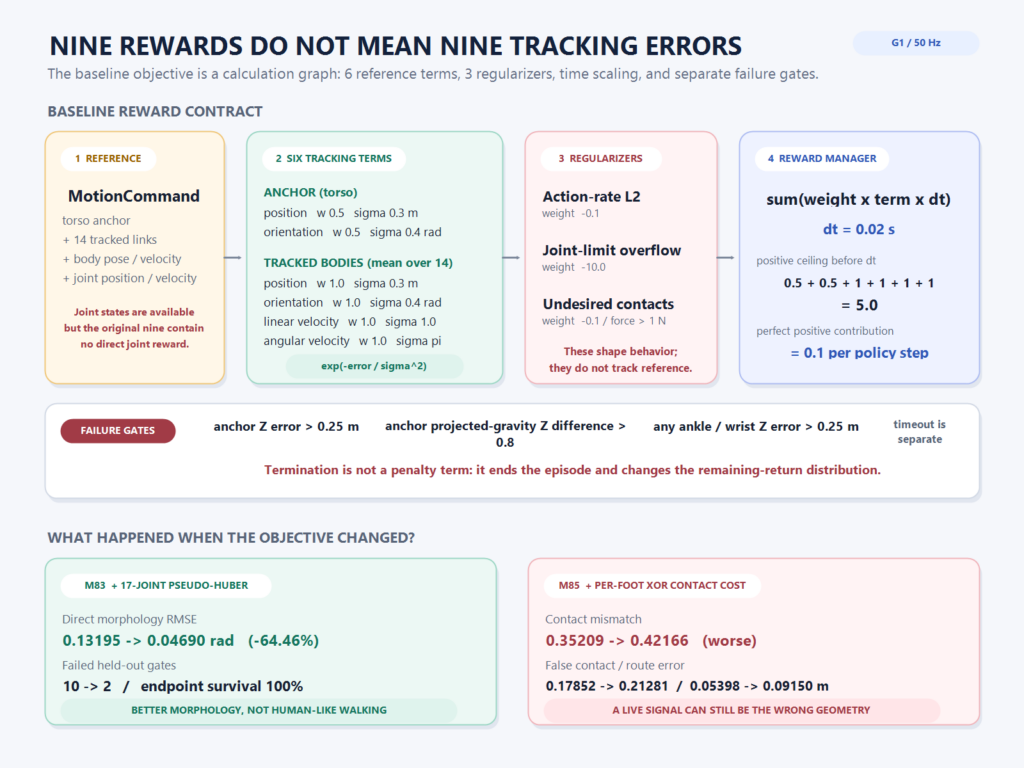
G1 모션 트래킹 정책을 처음 학습했을 때, 환경에는 이미 9개의 reward term이 있었습니다. 몸통의 위치와 자세, 여러 링크의 위치와 자세,
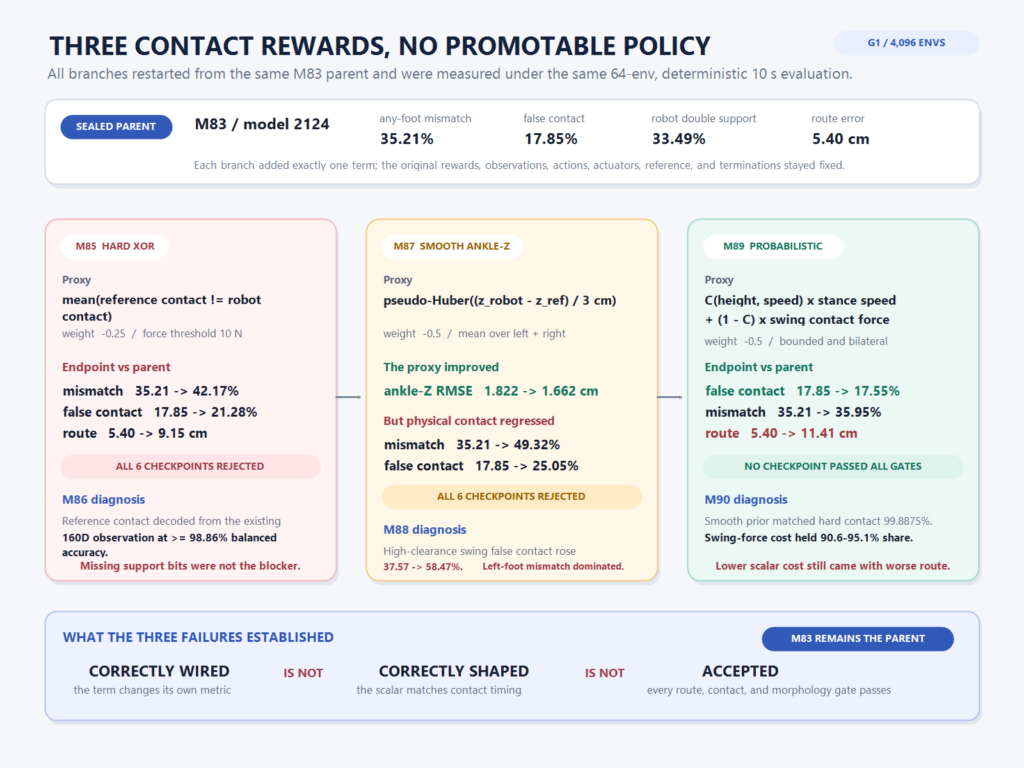
발목 높이 오차는 1.822cm에서 1.662cm로 줄었습니다. 제가 추가한 reward가 계산되고, PPO가 그 값을 실제로 최적화했다는 뜻이었습니다. 그런데 같은 정책의 false
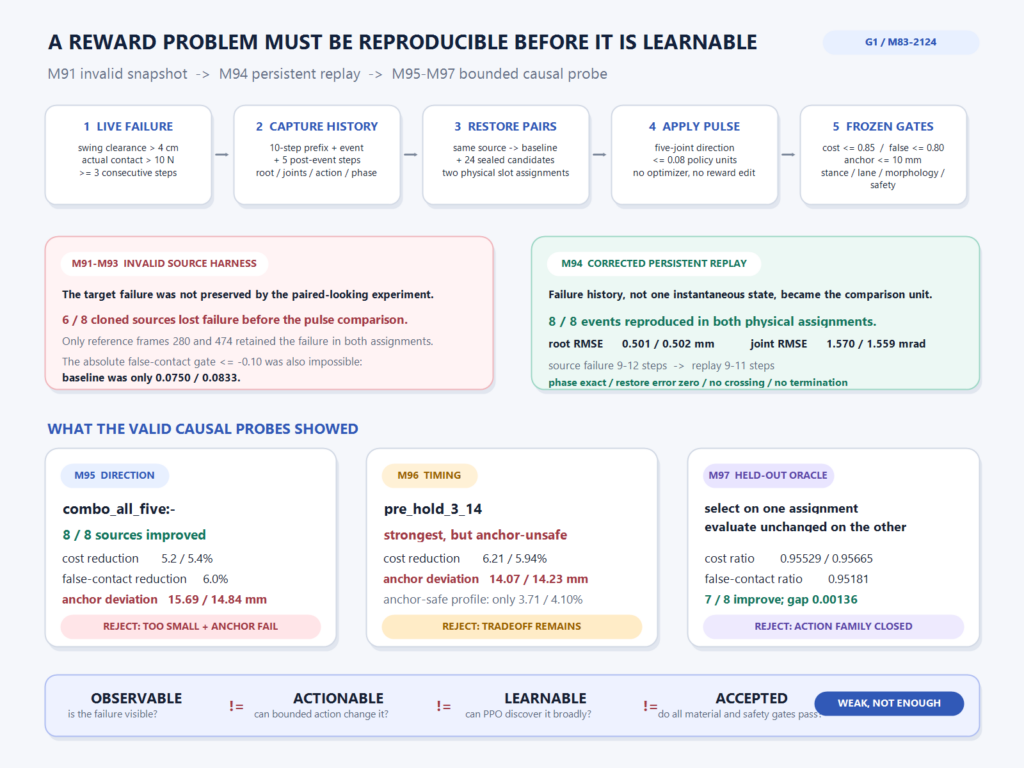
M95에서 다섯 관절에 작은 pulse를 넣자, 재현해 둔 여덟 개의 접촉 실패가 8개 모두 같은 방향으로 줄었습니다. 보통이라면 “유효한 방향을
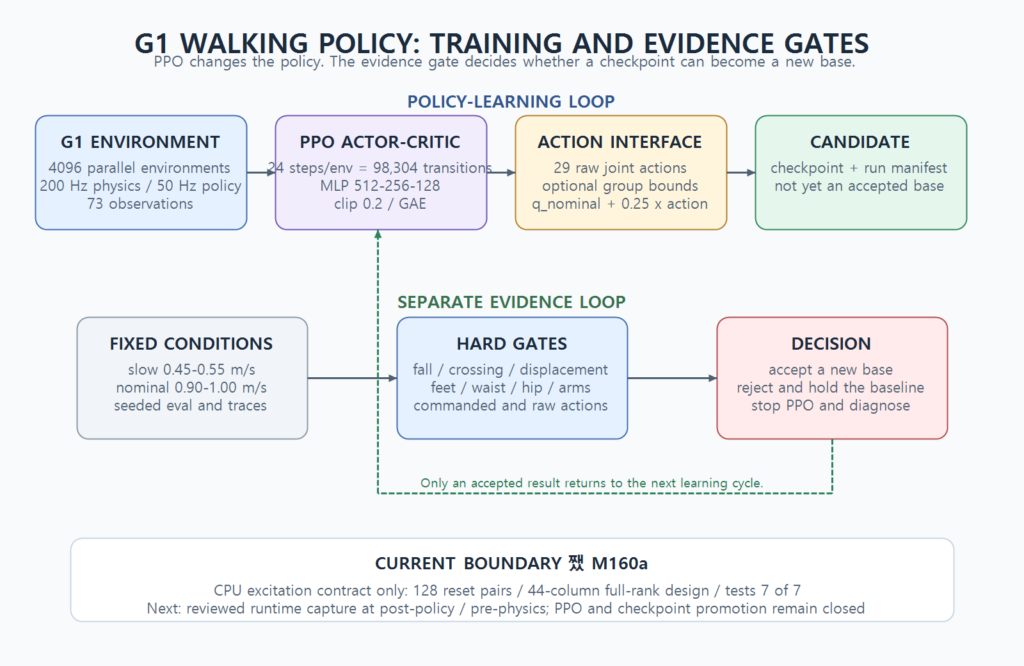
G1이 넘어지지 않고 앞으로 걸었습니다. 처음에는 이것만으로 학습이 성공했다고 생각하기 쉽습니다. 하지만 최근 실험에서 가장 중요한 판단은 새 체크포인트를 채택한