G1이 가상환경에서 앞으로 걷기까지 — 실패한 학습 루프를 다시 설계한 기록
로봇이 넘어지지 않고 앞으로 움직이면, 이제 “걷기에 성공했다”고 말해도 될까요? 3주 넘게 G1 보행 정책을 학습시키며 이 질문의 기준이 계속 […]
로봇이 넘어지지 않고 앞으로 움직이면, 이제 “걷기에 성공했다”고 말해도 될까요? 3주 넘게 G1 보행 정책을 학습시키며 이 질문의 기준이 계속 […]

로봇이 원하는 대로 걷지 못할 때, 가장 먼저 해야 할 일은 보상을 바꾸거나 학습을 더 오래 돌리는 일일까요? 저도 한동안은
로봇에게 새로운 동작을 가르치는 일은 언제 시작될까요. 처음에는 학습 프로그램을 실행하는 순간이라고 생각했습니다. 하지만 몇 번 작업을 이어 보니, 그보다
어제의 로봇 실험을 오늘 다시 열었을 때, 무엇이 같아야 “재현했다”고 말할 수 있을까요. 처음에는 같은 코드를 실행해 비슷한 결과가 나오면

프로젝트를 기록하다 보면 “어차피 같은 로봇 작업인데 한곳에 모으면 되지 않을까”라는 생각이 듭니다. 저도 처음에는 설계 메모와 실험 결과, 다음
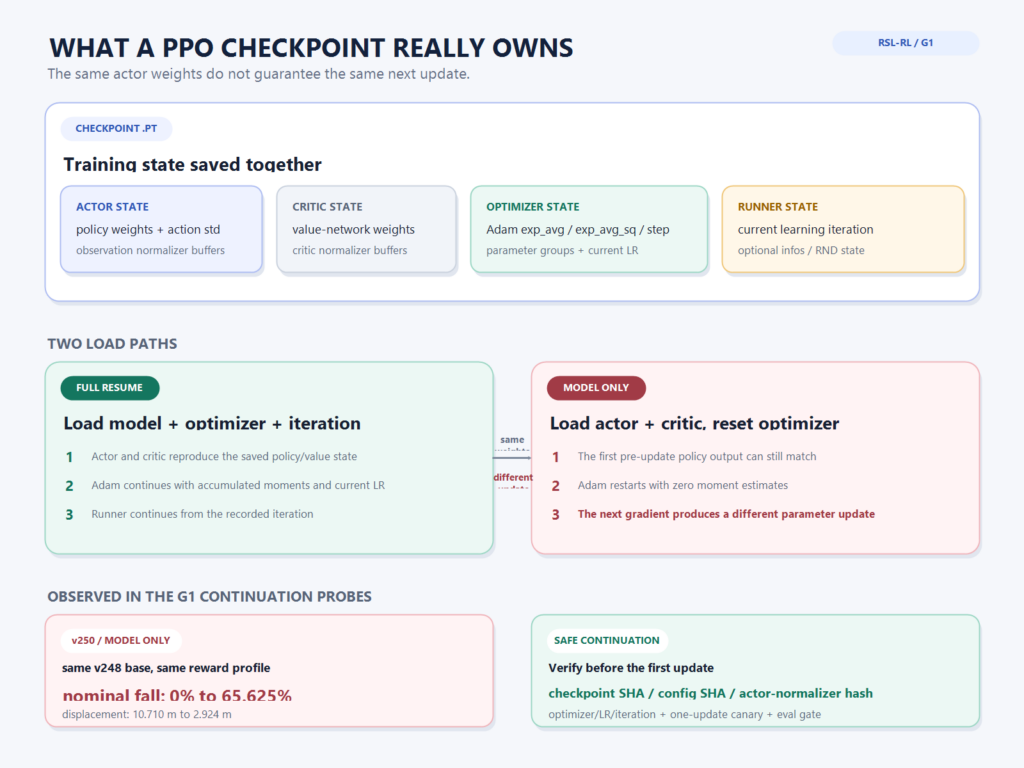
v248의 G1 정책은 slow와 nominal 평가에서 한 번도 넘어지지 않았습니다. nominal 이동 거리는 10.710m였습니다. 이 체크포인트에서 보상 함수, 관측·행동 차원,
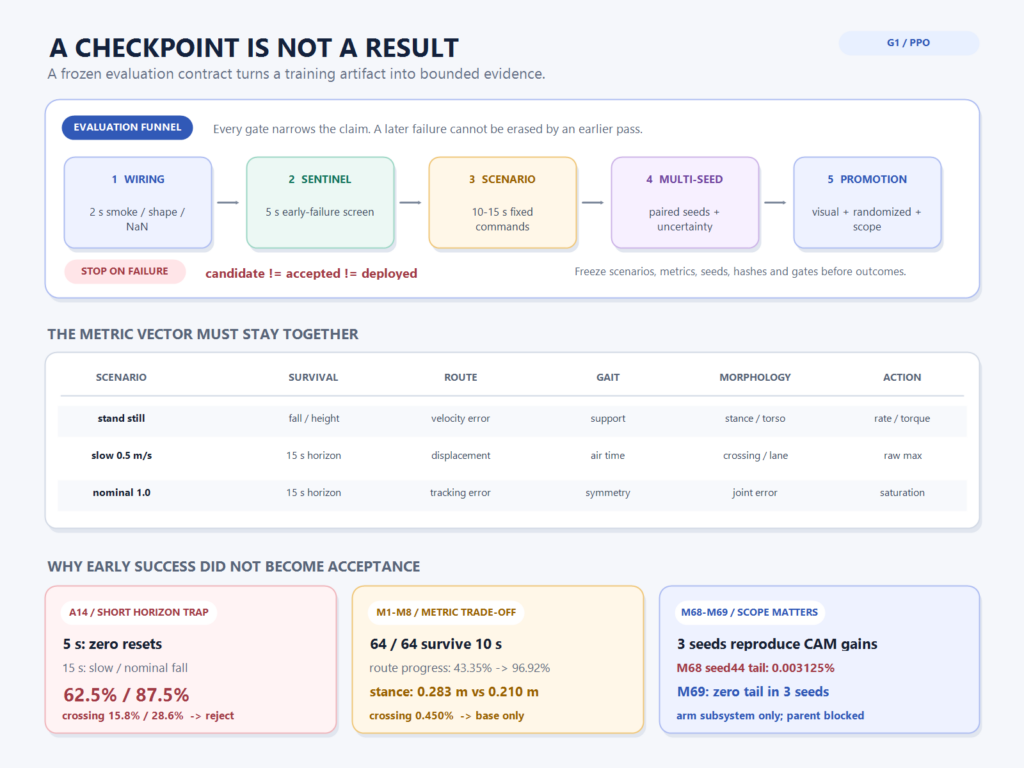
G1 motion-tracking 학습에서 가장 판단하기 어려웠던 순간은 로봇이 바로 넘어질 때가 아니었습니다. 오히려 64개 환경이 10초 동안 모두 살아남고, 기준
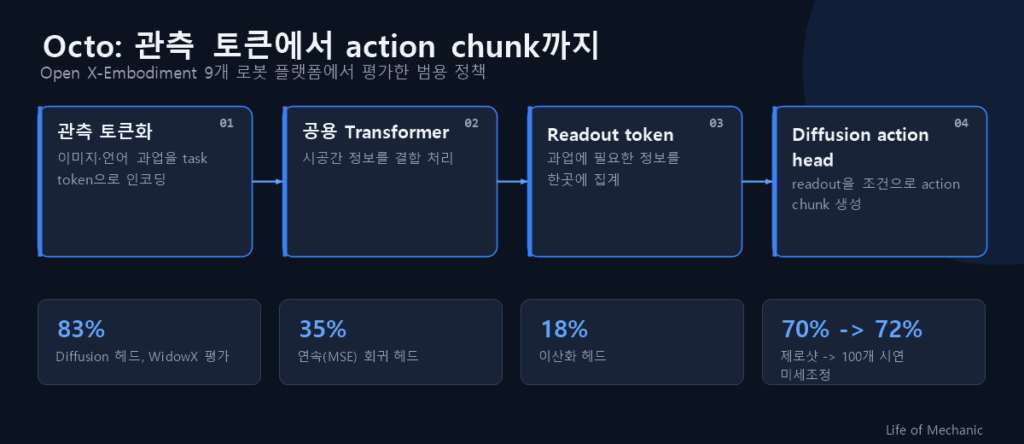
새 로봇 과제를 시작할 때, 처음부터 정책을 학습해야 할까요. Octo는 다양한 로봇 시연으로 미리 학습한 정책을 새로운 관측과 행동 공간에
WBC 모듈 평가에서 28개 점검 항목이 모두 통과했습니다. 처음에는 이 숫자를 그대로 “보행이 된다”는 결과처럼 적고 싶었지만, 그 표현은 정확하지
정책의 한 지표가 좋아지면 다음 체크포인트로 승격시키고 싶어집니다. G1 보행 실험에서도 M158d는 접촉 횟수를 87회에서 71회로 줄였고, 충격량은 9.8347 N·s에서