finetune_octo.py --dry_run을 실행하면 마지막에 PASSED가 나옵니다. 합성 HDF5 네 개를 만들고, 각 episode에 30장의 카메라 영상과 14차원 robot state, 7차원 action, “pick up the red cube”라는 지시를 넣습니다. 현재와 직전 관측 두 개를 묶어 미래 action 네 개를 예측하는 batch도 정상적인 shape로 생성됩니다.
하지만 이 데이터로 빨간 큐브를 집는 법을 배울 수는 없습니다. RGB·state·action은 무작위로 만들어졌고 문장만 고정돼 있기 때문입니다. dry-run이 증명한 것은 배열이 loader와 학습 코드 사이를 통과한다는 사실까지입니다. 화면 속 물체와 문장, 손의 움직임이 같은 사건을 가리킨다는 증거는 아닙니다.
이 차이를 이해하고 나서 VLA를 보는 기준도 바뀌었습니다. VLA는 자연어를 모터 명령으로 번역하는 거대한 챗봇이 아닙니다. 현재 관측과 지시가 주어졌을 때, 시연 데이터에서 그 상황에 대응했던 로봇 action의 분포를 예측하는 정책에 가깝습니다. 이 글은 VLA 내부의 입력·표현·action head·학습 신호를 따라갑니다. 출력 이후의 좌표 변환과 IK·WBC는 VLA와 저수준 제어 사이의 경계에서 별도로 다룹니다.
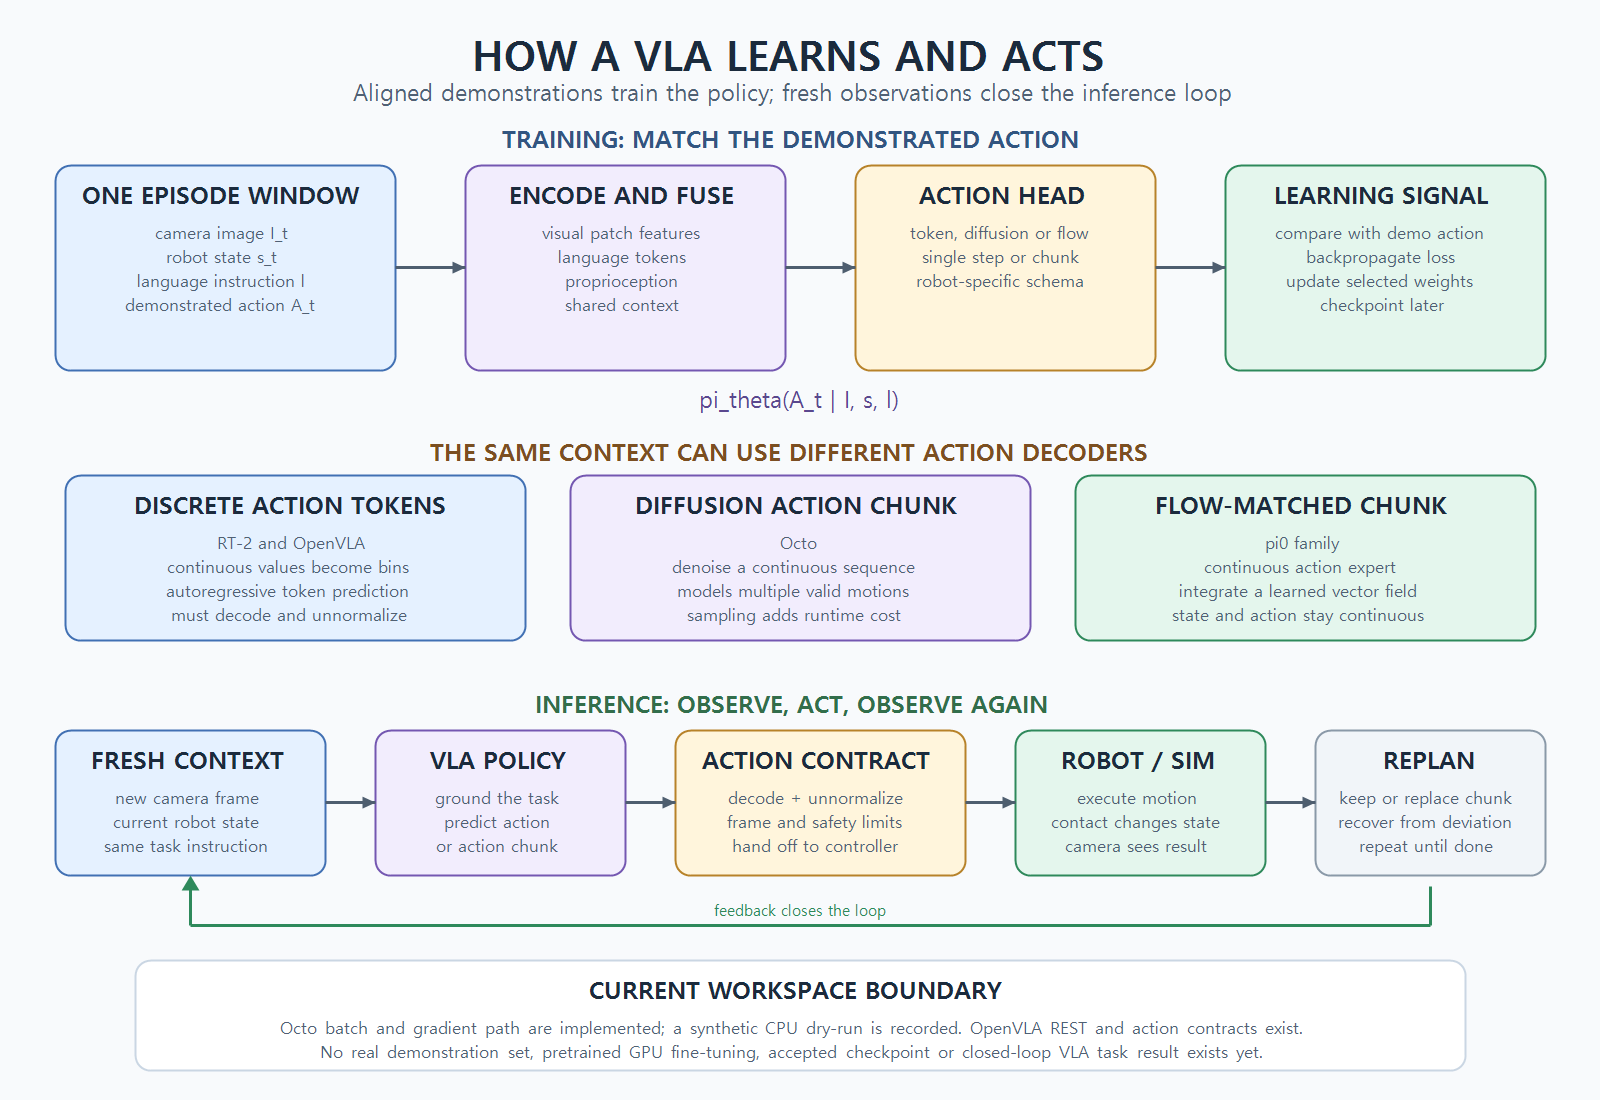
VLA의 핵심은 세 입력이 아니라 하나의 조건부 정책입니다
VLA는 Vision-Language-Action의 약자입니다. 카메라가 본 장면, 자연어로 표현한 태스크, 필요하면 관절 위치나 그리퍼 상태 같은 고유수용감각(proprioception)을 받아 다음 행동을 예측합니다. 비전-언어 모델(VLM)이 주로 문장이나 점수를 출력한다면, VLA는 로봇 trajectory로 학습한 action을 출력 공간에 추가합니다.
이를 간단히 쓰면 다음과 같습니다. I는 최근 영상, s는 로봇 상태, l은 language instruction, A는 한 개 또는 여러 step의 action입니다.
pi_theta(A_t:t+H-1 | I_t-w+1:t, s_t-w+1:t, l)이 식에서 중요한 것은 입력 종류의 개수가 아닙니다. 모델은 “빨간 큐브”라는 단어만 보고 움직이지 않습니다. 어떤 픽셀이 그 물체인지, 손이 현재 어디에 있는지, 시연자가 같은 상황에서 어느 방향으로 움직였는지를 함께 조건으로 사용합니다. 같은 문장이라도 큐브가 왼쪽에 있으면 왼쪽 action이, 오른쪽에 있으면 오른쪽 action이 나와야 합니다. 언어는 목표를 고정하지만 실제 움직임은 관측이 결정합니다.
한 학습 샘플에서는 이미지·상태·지시·action이 같은 시간을 가리켜야 합니다
VLA 학습의 정답은 사람이 써 준 설명문이 아니라 시연 trajectory의 action입니다. 예를 들어 시점 t의 이미지에 손이 컵 왼쪽에 있고, state에 현재 관절 자세가 기록돼 있으며, 그 다음 네 step의 action이 오른쪽 이동을 나타낸다면 모델은 그 조건에서 오른쪽으로 움직이는 패턴을 배웁니다. 이미지가 한 프레임 늦거나 action timestamp가 앞당겨지면 같은 손동작도 반대 의미가 될 수 있습니다.
현재 Octo용 loader는 HDF5의 agentview_rgb, 선택적인 wrist_rgb, robot_state, actions, language_instruction을 읽습니다. WindowBatchIterator는 기본적으로 과거 두 관측을 보고 현재부터 네 step의 action chunk를 만듭니다. 이 구현은 시간축을 자를 위치를 정했지만, 실제 카메라 timestamp와 제어 명령이 물리적으로 동기화됐다는 것까지 확인하지 않습니다.
그래서 먼저 필요한 검사는 모델 loss가 아닙니다. 한 episode를 사람이 펼쳐 보고 각 프레임, state, action을 같은 시간축에 겹쳤을 때 손의 실제 이동 방향과 저장된 action 부호가 일치해야 합니다. 좌표계·단위·제어 주기·gripper 의미도 함께 고정돼야 합니다. 이 데이터 계약은 로봇 학습 episode를 시간축으로 설계하는 방법에 정리해 두었습니다.
이미지와 문장은 토큰이 되지만, 로봇 상태까지 반드시 문장일 필요는 없습니다
모델 내부에서는 카메라 영상이 patch 단위의 시각 feature로 바뀌고, 자연어는 subword token으로 나뉩니다. projector나 작은 encoder가 서로 다른 feature 차원을 Transformer가 처리할 공통 embedding 공간으로 맞춥니다. 그 뒤 attention이 “빨간”이라는 언어 표현과 이미지 안의 후보 영역, 현재 손 위치 사이의 관계를 계산합니다.
다만 모든 VLA가 입력을 완전히 같은 방식으로 처리하지는 않습니다. OpenVLA는 DINOv2와 SigLIP을 결합한 시각 encoder의 patch embedding을 projector로 Llama 2 입력 공간에 보내고, 언어 모델이 tokenized action을 예측합니다. Octo는 관측과 태스크를 유연한 block 구조로 묶은 Transformer 표현 위에 가벼운 action head를 붙입니다. π0는 이미지·언어 backbone과 함께 로봇 state와 action을 처리하는 별도의 action expert를 두고 연속 행동을 생성합니다.
따라서 “VLA는 이미지와 문장을 token으로 바꾼다”는 설명만으로는 부족합니다. 토큰은 정보를 모델이 계산할 수 있는 표현으로 바꾸는 방법이고, 최종 목적은 현재 로봇에서 실행할 action의 조건부 분포를 배우는 것입니다. state를 생략할 수 있는 태스크도 있지만, 같은 장면에서 손의 현재 자세에 따라 다음 움직임이 달라진다면 proprioception은 모호함을 줄이는 핵심 입력이 됩니다.
action head가 VLA의 출력 문법을 결정합니다
공통 표현을 만든 뒤에는 그것을 실제 행동으로 복원해야 합니다. 이 역할을 action head가 맡습니다. 모델을 비교할 때 backbone 크기만 보면 놓치기 쉬운 부분입니다. 같은 이미지와 지시를 받아도 action head가 다르면 학습 loss, 출력 형식, 추론 지연, 제어 주기가 함께 달라집니다.
| 방식 | 대표 모델 | 학습하는 것 | 실행 전에 확인할 것 |
|---|---|---|---|
| 이산 action token | RT-2, OpenVLA | 연속 action을 구간으로 나눈 뒤 다음 token을 예측 | bin 범위, token 순서, de-tokenize와 unnormalization |
| diffusion action chunk | Octo | 노이즈가 섞인 연속 action 묶음을 조건에 맞게 복원 | chunk 길이, sampling 횟수, replanning 주기 |
| flow-matching action chunk | π0 계열 | 노이즈에서 연속 action으로 이동하는 vector field를 학습 | 적분 step, state/action schema, 제어 빈도 |
RT-2는 연속 action을 이산화하고 텍스트 token처럼 출력하는 방식으로 VLM과 로봇 제어를 같은 생성 문제에 넣었습니다. OpenVLA도 이 계열입니다. 장점은 기존 언어 모델의 autoregressive 출력 구조를 활용할 수 있다는 점입니다. 대신 token을 다시 연속값으로 복원해야 하고, 학습 데이터의 범위와 다른 normalization 통계를 쓰면 같은 token이 다른 이동량이 됩니다. 이 경계는 RT-2 행동 토큰 글에서 더 자세히 설명합니다.
Octo의 diffusion head는 한 점을 직접 회귀하기보다 여러 step의 연속 action chunk를 노이즈에서 복원합니다. 여러 접근 경로가 모두 가능한 장면에서 그 평균에 해당하는 어색한 행동으로 수렴하는 문제를 줄일 수 있습니다. 대신 한 번의 forward로 끝나는 단순 회귀와 달리 sampling 과정이 있고, 몇 step을 미리 실행할지와 언제 새 관측으로 chunk를 교체할지가 runtime 조건이 됩니다. 현재 Octo 후보의 구현 상태는 Octo 기준선 글에 기록했습니다.
π0는 flow matching으로 연속 action distribution을 만듭니다. 미리 정한 noise와 시연 action 사이에서 어느 방향으로 이동해야 하는지를 vector field로 학습하고, 추론 시 그 장을 적분해 action chunk를 얻습니다. diffusion과 마찬가지로 연속적이고 여러 모드를 표현할 수 있지만, 학습 목표와 sampling dynamics는 같지 않습니다. 이 세 방식을 “최신 모델이 이전 모델을 대체했다”는 순서로 읽기보다, 어떤 action 문법과 제어 주기가 제 데이터에 맞는지 비교해야 합니다.
학습할 때는 정답 action이 있지만 추론할 때는 피드백만 남습니다
학습에서는 시연 action을 알고 있습니다. 예측한 token이나 action chunk가 시연과 얼마나 다른지 계산하고 gradient로 parameter를 바꿉니다. 이것은 행동 복제(Behavior Cloning)입니다. VLA가 큰 VLM을 사용해도 로봇 fine-tuning의 직접적인 supervision은 결국 “이 관측과 지시에서 시연자가 어떤 action을 냈는가”입니다. BC와 강화학습이 서로 다른 정답을 사용하는 이유는 모방학습과 강화학습의 차이에서 비교했습니다.
추론에서는 정답 action을 보여 줄 사람이 없습니다. 정책이 낸 action을 실행하면 물체와 로봇의 상태가 바뀌고, 다음 카메라 frame과 state를 다시 넣어야 합니다. 이 폐루프가 없으면 처음 예측한 경로가 조금 빗나갔을 때 수정할 근거가 사라집니다. action chunk도 미래를 확정하는 계획표가 아닙니다. 일부를 실행한 뒤 새 관측과 충돌하면 남은 chunk를 버리고 다시 예측할 수 있어야 합니다.
이 때문에 offline validation loss와 실제 태스크 성공률은 같은 지표가 아닙니다. loss는 저장된 시연 분포 안에서 action을 얼마나 잘 맞췄는지 보여 줍니다. 실제 성공률은 정책이 자기 action 때문에 조금씩 달라지는 관측을 다시 받아도 회복하는지를 봅니다. 데이터셋에서는 거의 나오지 않은 상태로 한 번 벗어나면, 다음 action 오차가 다시 새로운 상태를 만들며 누적될 수 있습니다.
7차원 action은 보편적인 로봇 언어가 아닙니다
현재 OpenVLA backend는 [dx, dy, dz, droll, dpitch, dyaw, gripper] 형태의 7차원 값을 기대합니다. 숫자 모양만 보면 Franka, WidowX, 다른 로봇 팔에서 재사용할 수 있을 것처럼 보입니다. 실제 의미는 데이터셋의 좌표계와 normalization, gripper convention, 제어 주기에 묶여 있습니다. dx=0.02가 camera frame에서의 2cm인지 base frame에서 정규화된 값인지 모르면 동일한 벡터가 다른 동작이 됩니다.
cross-embodiment 학습이 어려운 이유도 여기에 있습니다. 서로 다른 로봇의 image와 language는 비슷한 의미 공간에 놓을 수 있지만, joint 수와 reachable workspace, gripper 방향, action rate는 다릅니다. Octo가 새 action space에 맞춰 head를 바꿀 수 있도록 설계한 이유, OpenVLA가 데이터셋별 unnormalization 통계를 요구하는 이유가 모두 이 차이에서 나옵니다. action schema를 맞추지 않은 채 여러 데이터셋을 섞으면 모델은 같은 label 아래에서 서로 다른 물리를 배우게 됩니다.
현재 워크스페이스에는 학습 경로와 추론 계약이 있지만 채택된 VLA는 없습니다
origin/main@ee4d96e 기준으로 Octo 쪽에는 HDF5 loader, 관측 window와 action horizon을 만드는 iterator, JAX jit train step, learning-rate schedule, checkpoint 저장 경로가 구현돼 있습니다. 합성 CPU dry-run도 기록돼 있습니다. 그러나 실제 Franka 시연, pretrained Octo weight를 사용한 GPU fine-tuning, validation episode와 closed-loop 성공 결과는 없습니다. 따라서 현재 상태는 학습 코드 경로가 구현되고 합성 schema 검사가 실행된 단계이지, 정책이 학습되거나 받아들여진 단계가 아닙니다.
OpenVLA 쪽에는 이미지 경로와 instruction을 REST endpoint로 보내고 7차원 응답을 받는 client, action shape 검사와 clamp가 구현돼 있습니다. 서버나 이미지가 없으면 near-zero dummy action으로 돌아가는 fallback도 있습니다. 이 경로는 router contract를 시험하는 데 유용하지만 실제 model inference의 증거가 아닙니다. camera-to-base 변환과 Franka IK도 아직 닫히지 않았습니다. 더 자세한 구현 상태는 OpenVLA 기준점 글과 앞서 링크한 제어 경계 글이 소유합니다.
정리하면 현재 프로젝트에는 두 종류의 준비가 있습니다. 하나는 시연 데이터를 VLA batch로 바꾸고 loss를 계산하는 학습 경로입니다. 다른 하나는 VLA가 낸 action을 router가 받을 수 있는 추론 계약입니다. 두 경로가 각각 존재해도 같은 checkpoint를 가운데 놓고 실제 episode를 끝까지 실행한 것은 아닙니다. 인터페이스 준비, 실제 실행, 관찰된 행동, 평가 gate 통과를 구분하는 이유입니다.
첫 실제 검증은 큰 모델보다 한 episode의 정렬에서 시작합니다
다음 검사는 모델 순위를 정하는 벤치마크가 아닙니다. 실제 Franka episode 하나를 수집해 시간축을 펼치고, image_t, state_t, action_t:t+3, instruction을 나란히 확인하는 일입니다. 영상에서 손이 오른쪽으로 움직일 때 저장된 translation action의 부호가 맞는지, 그리퍼가 닫히는 frame과 label이 일치하는지, reset 뒤 데이터가 이전 episode와 섞이지 않는지를 먼저 봅니다.
이 검사를 통과한 뒤에야 작은 train/validation split을 고정하고 실제 pretrained weight로 fine-tuning을 실행할 수 있습니다. 그 다음에도 loss 감소, action 범위, non-dummy inference, scripted 기준선과의 차이, closed-loop 성공을 서로 다른 gate로 남겨야 합니다. 한 단계의 통과를 다음 단계의 성공으로 바꾸어 말하지 않습니다.
VLA를 이해하는 가장 실용적인 방법은 모델 이름을 외우는 것이 아니라 두 개의 화살표를 분리하는 것입니다. 학습 화살표는 정렬된 시연에서 관측·지시와 action의 관계를 배웁니다. 실행 화살표는 그 action이 바꾼 세계를 다시 관측하며 오차를 수정합니다. 현재 제 작업에서 먼저 닫아야 할 것은 첫 번째 화살표의 실제 데이터 정렬입니다.
함께 읽기: RFM 논문 읽기 지도 · RT-2와 행동 토큰 · Octo 기준선 · OpenVLA 연결 경계 · VLA 출력 이후의 제어 경계 · episode 데이터 계약
원문: RT-2 · OpenVLA · Octo · π0
기술 기준 시점: 2026-07-21. workspace 설명은 origin/main@ee4d96e를 기준으로 하며, 논문이 보고한 성능을 이 프로젝트의 실행 결과로 사용하지 않았습니다.