현재 G1 저장소에서 offline과 replay를 검색하면 이미 오프라인 강화학습을 구현한 것처럼 보이는 파일이 나옵니다. offline_control_authority_diagnostic는 checkpoint와 trace를 읽고 action 방향을 계산하고, offline_upper_body_clamp_replay는 기록된 CSV에서 clamp 조건을 바꿔 봅니다. persistent_contact_replay는 실패 직전의 상태 이력을 다시 시뮬레이터에 넣습니다.
하지만 이 셋 중 어느 것도 offline RL trainer가 아닙니다. 첫 두 경로는 새 정책을 학습하지 않는 읽기 전용 수치 진단이고, contact replay 계획에는 아예 learning: false가 적혀 있습니다. 여기서 offline은 “Isaac Sim을 실행하지 않고 저장된 자료를 분석한다”는 실행 방식입니다. 강화학습에서 말하는 offline은 다른 경계입니다. 고정된 데이터셋을 받은 뒤 학습 중에는 환경에 새 행동을 시험해 보거나 새 transition을 요청하지 않는 것을 뜻합니다.
이 차이를 놓치면 SAC가 replay buffer를 사용하니 offline RL이라고 부르거나, CSV를 다시 계산했으니 정책을 offline으로 학습했다고 기록하기 쉽습니다. 이 글은 PPO와 SAC의 경험 수명 주기를 다시 비교하지 않습니다. 환경 피드백이 열려 있는 학습과 닫혀 있는 학습의 경계, 그리고 닫힌 데이터셋에서 분포 밖 행동(out-of-distribution action)이 왜 문제가 되는지를 현재 G1 데이터 상태에 맞춰 정리합니다.
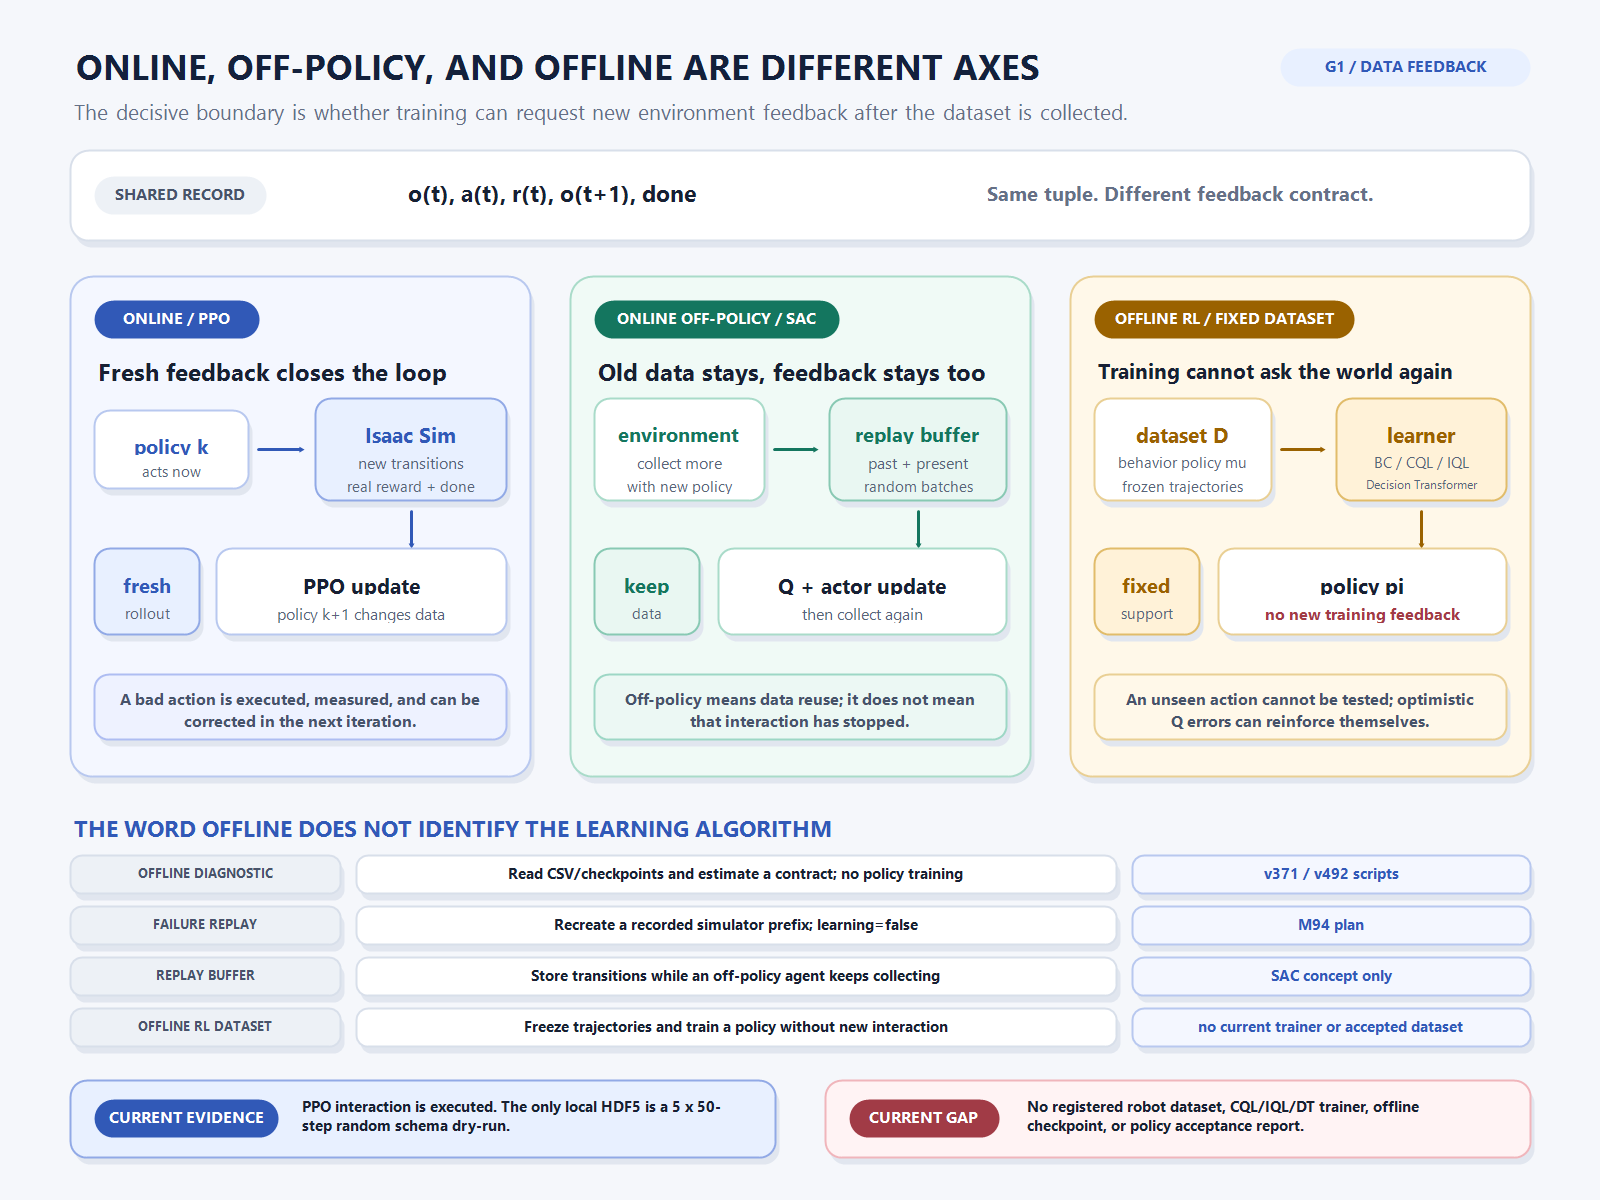
Online과 offline의 경계는 데이터 파일이 아니라 피드백 루프입니다
온라인 강화학습은 현재 정책이 환경에서 행동하고, 그 결과로 다음 데이터를 만든 뒤, 갱신된 정책이 다시 다른 데이터를 만드는 폐루프입니다. PPO는 한 iteration마다 현재 정책으로 새 rollout을 모으고, SAC는 과거 경험을 buffer에 남겨 두면서도 갱신된 정책으로 환경을 계속 실행합니다. 둘의 경험 재사용 방식은 다르지만 환경으로 돌아가는 화살표는 살아 있습니다.
online RL
policy π_k → environment → new transition D_k → update → policy π_(k+1)
     ↑___________________________________________________________|

offline RL
fixed dataset D = {(s, a, r, s', done)} → repeated updates → policy π
                                      no new training interaction
offline RL은 수집을 먼저 끝냅니다. 사람의 원격조작, 기존 controller, 이전 정책, 여러 품질의 정책이 만든 trajectory를 하나의 고정 데이터셋 D로 묶고 그 안에서만 policy와 value를 학습합니다. 학습기가 이상한 행동을 높게 평가해도 환경에 실행해서 틀렸다는 transition을 추가할 수 없습니다. 그래서 offline RL의 핵심 난점은 GPU를 쓰지 않는다는 의미의 offline이 아니라, 오류를 반박해 줄 새 경험이 차단된 상태에서 policy improvement를 해야 한다는 데 있습니다.
추론과 학습도 분리해서 봐야 합니다. offline으로 학습한 정책을 나중에 Isaac Sim이나 실제 로봇에서 실행하는 것은 당연히 가능합니다. “offline”은 배포 때 환경을 보지 않는다는 뜻이 아니라, 해당 학습 단계에서 환경 interaction으로 데이터셋을 갱신하지 않는다는 뜻입니다.
On-policy·off-policy는 online·offline과 같은 축이 아닙니다
on-policy는 update에 사용하는 경험이 현재 정책에서 왔는지를 묻습니다. off-policy는 다른 정책이 만든 경험도 학습에 사용할 수 있는지를 묻습니다. online은 학습 도중 새 interaction을 얻을 수 있는지를 묻습니다. 질문이 다르기 때문에 한 줄의 반대말로 합치면 안 됩니다.
| 경로 | 경험을 만든 정책 | 학습 중 새 데이터 | 현재 프로젝트 상태 |
|---|---|---|---|
| PPO | 현재 정책과 가까운 rollout | 매 iteration 수집 | G1에서 구현·실행됨, 승인 정책은 없음 |
| SAC | 과거·현재 여러 정책 | replay를 쓰면서 계속 수집 | README의 후보, G1 실행 증거 없음 |
| CQL·IQL | 고정 데이터셋의 behavior policy | 없음 | trainer·config·checkpoint 없음 |
| Decision Transformer | 고정 trajectory를 만든 임의의 정책들 | 없음 | 논문 노트만 있고 구현 없음 |
SAC를 offline dataset에 그대로 적용할 수는 있지만, 그것이 안전하게 동작한다는 뜻은 아닙니다. 표준 SAC는 replay buffer에서 transition을 뽑는 동시에 현재 actor가 제안한 action의 Q값을 사용합니다. 온라인에서는 잘못 높은 Q를 따라 행동한 뒤 실제 결과가 buffer에 들어와 오류를 고칠 기회가 있습니다. 고정 dataset에서는 그 보정 transition이 영원히 오지 않습니다. 같은 off-policy 알고리즘도 피드백 화살표가 닫히면 별도의 offline 제약이 필요해지는 이유입니다.
고정 trajectory에 reward가 있다고 곧바로 offline RL이 되지는 않습니다
행동 복제(BC)와 offline RL은 같은 데이터 파일을 읽을 수 있습니다. 둘 다 s_t와 a_t를 사용하지만, 학습 목표는 다릅니다. BC는 데이터의 행동을 정답으로 보고 π(s_t)가 a_t를 재현하게 합니다. 성공한 시연만 모았다면 유용한 baseline이지만, 나쁜 trajectory와 좋은 trajectory가 섞여 있을 때 reward를 이용해 어느 행동을 더 선호해야 하는지는 직접 배우지 않습니다.
offline RL은 reward와 다음 상태를 사용해 장기 return을 비교합니다. 데이터셋을 수집한 behavior policy를 그대로 복제하는 대신, 데이터 안에서 더 나은 결과와 연결된 행동을 강조해 policy improvement를 시도합니다. 이론적으로는 여러 불완전한 trajectory의 좋은 구간을 연결할 수도 있습니다. 그러나 데이터가 어떤 상태에서 어떤 행동을 한 번도 보여 주지 않았다면, 그 행동의 결과는 기록 안에 없습니다. reward 열이 존재한다고 coverage가 생기지는 않습니다.
이 경계는 BC와 강화학습의 차이에서 다룬 정답 신호의 차이보다 한 단계 뒤의 문제입니다. 이번 글의 질문은 “reward를 쓰는가”가 아니라 “reward를 이용해 데이터 밖의 행동을 선호하려 할 때 그 값을 무엇으로 믿을 것인가”입니다.
분포 밖 행동의 Q값은 왜 근거 없이 높아지는가
고정 데이터셋을 만든 정책을 behavior policy μ라고 하겠습니다. 어떤 G1 상태에서 μ가 작은 관절 목표만 사용했다면 dataset에는 그 주변 action과 실제 결과만 있습니다. Q network는 입력 공간 전체에 숫자를 출력하므로, 기록에 없던 큰 hip·arm action에도 값을 내놓습니다. 그 숫자는 관측된 return으로 직접 맞춰진 값이 아니라 신경망의 외삽입니다.
dataset action:        a_D ~ μ(a|s)
learned policy action: a'  ~ π(a|s)

Bellman target: y = r + γ Q_target(s', a')

if a' is outside dataset support:
Q_target(s', a') is an extrapolation, not an observed result
문제는 actor가 Q가 큰 action을 찾도록 학습된다는 점입니다. 실제로 좋은 행동과 우연히 과대평가된 행동이 섞여 있으면 actor는 후자를 고를 수 있습니다. 그 action이 다음 Bellman target에 들어가면 낙관적인 값이 다시 Q를 키웁니다. CQL 논문이 지적한 distributional shift는 이 feedback을 가리킵니다. 표준 off-policy RL이 fixed dataset에서 실패할 수 있는 이유는 과거 데이터를 재사용해서가 아니라, 새 policy가 dataset이 뒷받침하지 않는 action의 값을 계속 질의하기 때문입니다.
온라인 환경이라면 이 오류를 행동으로 실행해 볼 수 있습니다. G1이 바로 넘어지면 낮은 reward와 termination이 새 transition으로 들어옵니다. offline에서는 그 반증이 없습니다. 따라서 “dataset에서 보지 못한 action이 더 좋아 보인다”는 것은 탐색 후보가 아니라 위험 신호입니다. 특히 29차원 연속 action에서는 각 관절 값이 개별 범위 안에 있어도 그 조합이 데이터에서 전혀 관측되지 않았을 수 있습니다.
CQL은 데이터 밖 Q값에 낙관 비용을 부과합니다
Conservative Q-Learning(CQL)은 Bellman error만 줄이지 않고, dataset action보다 다른 action의 Q값이 근거 없이 높아지는 것을 벌점으로 누릅니다. 연속 action의 실제 구현은 여러 분포에서 action을 sampling하지만, 핵심은 다음 개념식으로 볼 수 있습니다.
L_CQL = Bellman_error
      + α [ logsumexp_a Q(s,a) - E_(a_D~D) Q(s,a_D) ]
대괄호 안의 첫 항은 다양한 action의 Q를 끌어내리고, 두 번째 항은 데이터에서 실제 관측된 action의 Q를 상대적으로 지킵니다. 결과적으로 learned policy가 좋아한다고 주장하는 action과 behavior data의 action 사이에 보수적인 간격을 만듭니다. CQL의 목표는 모든 action 값을 무조건 낮추는 것이 아니라, policy가 이용할 값의 낙관 오류를 줄이는 것입니다.
대가도 있습니다. α가 너무 작으면 OOD overestimation이 남고, 너무 크면 데이터 안에 있는 개선 가능성까지 눌러 behavior policy보다 나아지지 못할 수 있습니다. 논문 benchmark의 성능을 현재 G1에 옮겨 적을 수 없는 이유가 여기에 있습니다. 현재 G1에는 action coverage를 측정한 fixed dataset도, CQL regularizer를 바꿔 비교한 run도 없습니다.
IQL은 보지 못한 행동의 값을 직접 묻지 않습니다
Implicit Q-Learning(IQL)은 다른 길을 택합니다. value 학습 중 최신 policy가 만든 새로운 action을 Q에 넣는 대신, dataset에 들어 있는 (s, a_D)만 사용합니다. 상태별 Q 분포의 높은 expectile을 V(s)로 맞추고, 그 값을 다음 상태의 target으로 사용합니다.
V(s)  ← upper expectile of Q(s, a_D)
Q(s,a_D) ← r + γ V(s')

advantage A(s,a_D) = Q(s,a_D) - V(s)
policy ← behavior cloning weighted by exp(β A)
마지막 policy 추출은 advantage가 큰 dataset action을 더 강하게 복제합니다. 그래서 단순 BC처럼 모든 행동을 같은 비중으로 따라 하지 않으면서도, value update 과정에서 dataset 밖 action의 Q를 직접 질의하지 않습니다. 다만 “OOD 문제가 사라졌다”는 뜻은 아닙니다. neural network가 학습한 policy는 실행 시 데이터와 다른 action을 낼 수 있고, dataset에 복구 상태가 없으면 그 상태에서의 행동은 여전히 근거가 약합니다. IQL의 in-sample value 학습은 중요한 방어선이지 deployment 보증서가 아닙니다.
현재 프로젝트의 첫 offline value baseline으로 IQL을 고려할 이유는 명확합니다. 연속 action에서 데이터 행동만으로 value를 학습하고, BC baseline과 policy extraction을 직접 비교할 수 있습니다. 그러나 이 선택은 실제 dataset coverage와 reward 품질을 확인한 뒤의 제안입니다. 지금은 학습할 실제 trajectory corpus가 없으므로 알고리즘 선정이 구현 완료보다 앞서 있습니다.
Decision Transformer는 Q 대신 return 조건부 행동을 학습합니다
Decision Transformer는 Bellman backup과 Q function 대신 trajectory를 sequence modeling 문제로 바꿉니다. return-to-go, state, action을 시간 순서대로 넣고 원하는 return과 과거 context를 조건으로 다음 action을 예측합니다.
(R_t, s_t, a_t, R_(t+1), s_(t+1), a_(t+1), ...)
                                  → causal Transformer → next action
구조만 보면 VLA와도 연결하기 쉽습니다. 영상·상태·행동 sequence에 return 또는 task condition을 붙이고, action을 autoregressive하게 생성할 수 있기 때문입니다. 저장소에 Decision Transformer 논문 노트가 있고 RFM evolution timeline에서 VLA의 선행 흐름으로 연결한 이유도 여기에 있습니다.
그러나 높은 목표 return을 입력한다고 데이터에 없던 성공 전략이 자동으로 생기는 것은 아닙니다. return condition과 상태 history가 어떤 행동과 함께 등장했는지를 모델링하므로, 원하는 return 구간의 trajectory가 너무 적거나 서로 다른 behavior가 뒤섞이면 condition을 해석하기 어렵습니다. Q overestimation을 직접 쓰지 않는 대신 sequence coverage와 return-conditioning support를 확인해야 합니다. 따라서 Decision Transformer도 “고정 로그만 넣으면 최적 정책이 나온다”는 우회로가 아닙니다.
데이터셋 크기보다 먼저 behavior coverage를 기록해야 합니다
offline RL dataset에는 observation과 action의 shape 외에 누가 왜 그 행동을 했는지가 중요합니다. 하나의 PPO checkpoint만 같은 명령으로 반복 실행한 데이터는 깨끗할 수 있지만 action 분포가 좁습니다. 무작위 action을 섞으면 coverage는 넓어져도 낙상 transition만 늘어날 수 있습니다. 여러 checkpoint, scripted controller, 사람 조작, 실패 복구를 섞으면 다양성은 생기지만 behavior mixture를 추적하지 않으면 어떤 데이터가 개선에 기여했는지 알 수 없습니다.
최소한 episode별로 collector 종류와 version, source checkpoint hash, command·terrain·seed, 성공·termination 이유, control frequency, action scale과 joint order를 보존해야 합니다. transition에는 s_t와 a_t뿐 아니라 s_(t+1), reward, terminated와 truncated 구분이 있어야 합니다. reward가 나중에 바뀌었다면 어떤 수식과 revision으로 다시 계산했는지도 lineage에 남겨야 합니다.
이 항목들은 episode 시간축과 HDF5·RLDS 계약이 이미 소유한 내용입니다. offline RL에서 새로 추가되는 질문은 그 위의 support audit입니다. 상태 구간별 action 범위와 density, 성공·실패 비율, contact·termination 같은 희귀 사건 수, collector별 coverage를 계산해야 합니다. 단순한 train/validation random split은 같은 trajectory의 인접 상태를 양쪽에 흘려 넣어 성능을 부풀릴 수 있으므로 episode·scenario·seed 단위로 나눠야 합니다.
현재 HDF5 파일은 학습 데이터가 아니라 저장 계약의 dry-run입니다
현재 데스크탑의 data/raw/에는 11,841,463 byte의 dryrun_test.hdf5가 하나 있습니다. writer의 기본 dry-run은 50 step짜리 episode 다섯 개를 만들며, RGB image·14차원 state·7차원 action·reward·done을 저장합니다. 하지만 image는 임의 픽셀이고 state와 action도 난수입니다. 이 파일은 HDF5 group과 dtype이 생성되는지를 검사했을 뿐, 로봇 행동의 인과관계를 담지 않습니다.
Raw Data Registry와 Processed Data Registry에는 실제 항목이 없고 예시 행만 남아 있습니다. 원격조작 collector와 Isaac Sim synthetic generator도 README에서 예정 상태입니다. origin/main@ee4d96e와 현재 worktree를 검색해도 CQL·IQL·Decision Transformer trainer, offline dataset config, offline checkpoint, policy evaluation report는 확인되지 않았습니다.
반면 원격 main의 G1 자동화에는 offline diagnostic과 replay 도구가 존재합니다. v371 도구는 CSV row에 action clamp 후보를 수학적으로 적용하고 training_launch_allowed: false를 유지합니다. v492는 source trace와 checkpoint 방향을 분석하지만 “PPO를 실행하거나 checkpoint를 만들지 않는다”고 명시합니다. M94 persistent replay도 learning: false인 simulator failure reproduction입니다. 이 파일들은 실패를 값싸게 좁히는 훌륭한 진단 자산이지만, dataset에서 새 policy를 최적화하는 offline RL 증거로 세면 안 됩니다.
Offline metric만으로 새 정책을 승인할 수는 없습니다
offline training loss가 내려가도 행동 품질을 바로 증명하지 못합니다. CQL의 Q가 보수적으로 보이거나 IQL의 expectile loss가 안정되어도, 실제 policy가 낯선 state에 들어갔을 때 어떤 action을 내는지는 환경 실행에서 확인해야 합니다. logged return과 learned Q의 일치도만으로는 policy-induced state distribution을 관측할 수 없습니다.
그래서 평가를 두 층으로 나눠야 합니다. 첫째는 dataset 밖으로 나가지 않는 정적 검사입니다. held-out episode에서 value calibration, action log-likelihood, dataset action과 policy action의 거리, action saturation, collector별 성능을 봅니다. importance sampling이나 fitted Q evaluation 같은 off-policy evaluation도 보조 지표로 사용할 수 있지만, 긴 horizon과 연속 action에서는 variance·model bias가 커질 수 있습니다.
둘째는 frozen simulator gate입니다. 학습 데이터에 없던 seed·초기 자세·명령·terrain에서 policy를 실행하고 return뿐 아니라 낙상률, episode length, route 유지, 발 교차, joint limit·action saturation, contact event를 함께 측정합니다. 이 evaluation rollout은 학습 dataset에 다시 넣지 않아야 순수한 offline 비교가 유지됩니다. 정책을 고치기 위해 새 transition을 추가하는 순간부터는 offline-to-online fine-tuning 단계로 이름을 바꿔야 합니다.
이 구조는 G1 checkpoint 평가 계약의 wiring smoke·scenario·multi-seed gate를 재사용할 수 있습니다. 다만 비교 대상에 behavior policy와 BC를 반드시 넣어야 합니다. offline RL이 dataset collector보다 실제로 나아졌는지, 단순 복제보다 reward를 유용하게 사용했는지를 동시에 확인해야 하기 때문입니다.
첫 실험은 BC와 IQL을 같은 고정 snapshot에서 비교하는 것입니다
현재 단계에서 CQL·IQL·Decision Transformer를 한꺼번에 구현하는 것은 비교가 아닙니다. 먼저 실제 G1 또는 조작 task의 짧은 trajectory corpus를 만들어 데이터 계약과 coverage를 통과시켜야 합니다. 그다음 하나의 immutable dataset ID와 hash를 고정하고 BC를 behavior baseline으로 학습합니다. 같은 train split과 observation·action normalization을 사용해 IQL을 붙이면 reward를 이용한 policy improvement가 단순 복제보다 실제로 도움이 되는지를 볼 수 있습니다.
| 단계 | 고정할 것 | 통과 증거 |
|---|---|---|
| Dataset snapshot | episode ID·hash, collector/checkpoint, reward revision, action contract | registry와 split manifest가 실제 파일을 가리킴 |
| Coverage audit | command·terrain·seed·contact·termination별 표본 수 | 희귀 사건과 비지원 구간이 보고서에 표시됨 |
| Behavior baseline | BC architecture·normalization·update budget | held-out action error와 frozen-sim 행동 지표 |
| Offline value baseline | 같은 dataset의 IQL expectile·temperature·seed | BC 대비 개선과 safety metric 비열화 없음 |
| Acceptance | 학습에 쓰지 않은 scenario·multi-seed | return 하나가 아니라 낙상·route·action limit gate 통과 |
첫 gate는 “IQL loss가 수렴했는가”가 아닙니다. 동일한 frozen simulator 조건에서 BC보다 return 또는 task success가 좋아지면서 낙상과 action limit 위반이 악화되지 않아야 합니다. dataset support에서 멀어진 action이 성능 향상의 주원인이라면, 그것은 발견일 수도 있지만 먼저 OOD 위험으로 분류해야 합니다. 반복 seed에서도 같은 방향이 확인된 뒤에만 offline candidate라고 부를 수 있습니다.
CQL은 그다음 비교가 적절합니다. IQL의 in-sample 접근과 CQL의 explicit pessimism이 같은 데이터에서 어떤 trade-off를 만드는지 볼 수 있습니다. Decision Transformer는 충분한 trajectory 다양성과 return range가 확보되고 sequence context가 필요한 task에서 별도 축으로 비교해야 합니다. 모델 규모가 다르므로 optimizer step만 맞추지 말고 dataset transition 수, gradient update, GPU 시간, inference latency까지 함께 기록해야 합니다.
고정 로그는 시행착오를 없애지 않고 수집 시점으로 옮깁니다
offline RL의 장점은 위험한 exploration을 학습 중에 반복하지 않아도 된다는 점입니다. 이미 축적된 로봇 로그를 재사용하고 여러 알고리즘을 같은 snapshot에서 비교할 수 있습니다. 그러나 환경과의 시행착오가 사라지는 것은 아닙니다. 어떤 policy와 조건으로 데이터를 모았는지, recovery와 failure가 얼마나 포함됐는지, reward와 action 의미가 보존됐는지가 학습 가능 범위를 미리 결정합니다.
현재 프로젝트에서 방어 가능한 상태는 여기까지입니다. G1 PPO는 Isaac Sim과 상호작용하는 online 경로로 구현·실행됐지만 승인된 보행 정책은 없습니다. HDF5 writer와 난수 dry-run은 구현·실행됐지만 실제 robot trajectory dataset은 승인되지 않았습니다. offline 진단과 failure replay는 실행 자산이지만 policy learning이 아닙니다. CQL·IQL·Decision Transformer는 논문 수준의 후보이며, 현재 G1 offline checkpoint가 있다는 근거는 없습니다.
따라서 다음 작업은 offline RL trainer부터 만드는 일이 아닙니다. 실제 episode 하나를 시간축과 action 의미가 보존된 상태로 수집하고, 여러 collector로 확장할 때 behavior coverage를 측정한 뒤 immutable dataset snapshot을 만드는 일입니다. 그 snapshot에서 BC와 IQL을 같은 평가 계약으로 비교해야 “로봇 로그만으로 더 나은 정책을 만들 수 있는가”라는 질문에 처음으로 실험 가능한 형태가 생깁니다.
함께 읽기: episode 데이터의 시간축 계약 · BC와 강화학습의 차이 · PPO와 SAC의 데이터 수명 주기 · checkpoint 평가 계약 · seed와 재현성 계약 · model-free와 model-based RL의 경계
논문 원문: Offline Reinforcement Learning: Tutorial, Review, and Perspectives on Open Problems · Conservative Q-Learning · Implicit Q-Learning · Decision Transformer · D4RL
기술 기준 시점: 2026-07-22. 구현 상태는 origin/main@ee4d96e와 현재 desktop worktree를 대조했습니다. 논문 benchmark는 현재 G1의 실험 결과가 아니며, 저장소의 offline diagnostic·replay 파일은 학습기가 아닌 읽기 전용 분석 또는 simulator 재현으로 분류했습니다.