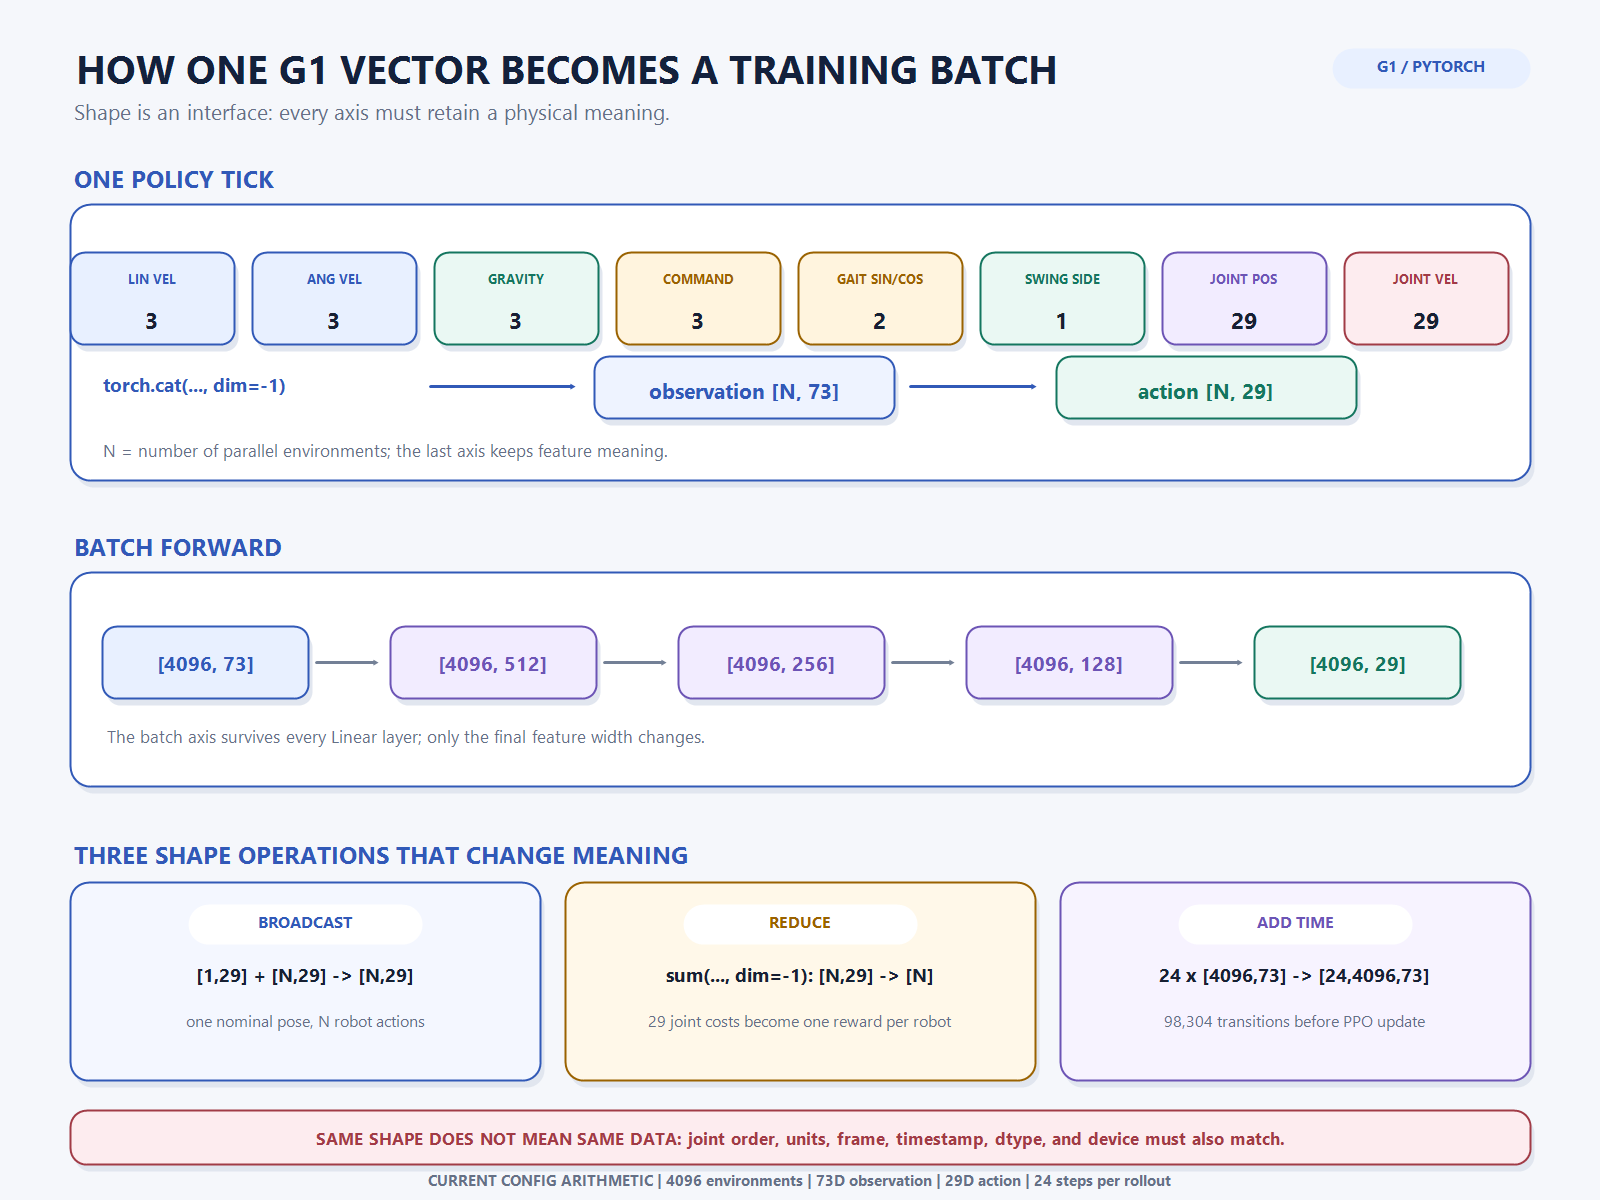
G1 보행 환경의 observation은 73차원입니다. 이 문장만 읽으면 길이 73인 숫자 목록 하나를 떠올리기 쉽습니다. 하지만 실제 학습 명령의 기본값은 4,096개 환경입니다. 한 번의 policy step에서 actor가 받는 것은 [73]이 아니라 4,096대의 상태를 쌓은 [4096, 73] tensor입니다.
이 차이를 놓치면 코드가 실행되더라도 의미가 달라질 수 있습니다. 관절 축을 합쳐야 할 때 환경 축을 평균내거나, 한 로봇의 기준 자세를 4,096대에 적용하려다 엉뚱한 축으로 broadcast할 수 있습니다. 저는 tensor를 단순한 다차원 숫자 상자가 아니라 각 축의 물리적 의미를 보존하는 인터페이스로 읽어야 한다고 정리했습니다. 이 글에서는 현재 G1 코드의 shape를 따라가며 scalar·vector·matrix·tensor·batch가 실제 학습에서 무엇을 뜻하는지 설명합니다.
Tensor에는 숫자보다 먼저 확인할 네 가지가 있습니다
PyTorch의 Tensor 문서는 tensor를 한 가지 data type의 원소를 담는 다차원 행렬로 정의합니다. 구현을 읽을 때는 여기에 네 가지 질문을 붙여야 합니다. shape는 축의 개수와 길이, dtype은 원소의 수치 표현, device는 CPU 또는 GPU 중 저장·계산 위치, semantics는 각 축과 index가 실제로 가리키는 대상을 말합니다.
예를 들어 torch.Size([4096, 29])만으로는 이 값이 action인지 joint velocity인지 알 수 없습니다. 두 tensor가 모두 float32이고 같은 GPU에 있어도 첫 번째 29개가 서로 다른 joint order를 사용하면 덧셈은 정상 실행되고 로봇에는 틀린 명령이 전달됩니다. 그래서 shape 검사는 필요하지만 충분하지 않습니다. joint order와 checkpoint 호환성 글에서 ordered name과 hash를 별도로 검사한 이유도 여기에 있습니다.
| 표현 | 예시 shape | 현재 G1에서의 의미 | 주의할 점 |
|---|---|---|---|
| scalar | [] 또는 숫자 하나 |
전체 batch의 평균 reward처럼 모든 축을 줄인 값 | 어느 환경의 실패인지 복원할 수 없음 |
| vector | [73] |
한 G1의 한 시점 observation | feature 순서·단위·frame이 고정돼야 함 |
| matrix | [4096, 73] |
4,096개 환경의 한 시점 observation batch | 첫 축은 환경, 마지막 축은 feature |
| 3D tensor | [24, 4096, 73] |
24 policy step의 observation rollout | 시간축과 환경축을 바꾸면 trajectory 의미가 달라짐 |
| 4D tensor | [B, C, H, W] |
일반적인 image batch 예시 | 현재 G1 73D policy 입력은 image가 아님 |
73차원은 여덟 observation 조각을 마지막 축으로 붙인 결과입니다
현재 G1WalkEnv는 body-frame linear velocity 3개와 angular velocity 3개, projected gravity 3개, ramp가 적용된 velocity command 3개, gait phase의 sin·cos 2개, 목표 swing side 1개, nominal pose 대비 joint position 29개, joint velocity 29개를 만듭니다. 각 조각에는 이미 환경축 N이 있습니다. PyTorch의 torch.cat 문서처럼, 연결할 축을 제외한 shape가 같아야 합니다.
obs = torch.cat([
    base_lin_vel,                # [N, 3]
    base_ang_vel,                # [N, 3]
    projected_gravity,           # [N, 3]
    effective_commands,          # [N, 3]
    gait_phase_sin_cos,          # [N, 2]
    target_swing_side,           # [N, 1]
    joint_pos - nominal_q,       # [N, 29]
    joint_vel,                   # [N, 29]
], dim=-1) # [N, 73]dim=-1은 마지막 축을 뜻합니다. 따라서 여덟 조각의 feature 폭 3+3+3+3+2+1+29+29가 73으로 합쳐지고 환경 수 N은 그대로 남습니다. 만약 환경축으로 연결하면 서로 다른 로봇의 표본을 이어 붙이는 전혀 다른 데이터가 됩니다. 숫자 73은 observation의 내용이 아니라 마지막 축의 길이일 뿐이며, 세부 feature 계약은 로봇 강화학습 환경 글이 맡습니다.
Batch는 평균값이 아니라 독립된 표본을 같은 연산에 태우는 축입니다
batch는 여러 표본을 한꺼번에 계산하기 위해 추가한 축입니다. Isaac Lab의 DirectRLEnv 문서도 여러 sub-environment를 병렬로 실행하는 vectorized environment를 전제로 합니다. 현재 설정의 num_envs=4096는 G1 한 대를 4,096번 순차 실행한다는 뜻이 아니라, 같은 task 구조를 가진 4,096개 환경 상태를 batch tensor로 관리하도록 구성했다는 뜻입니다.
첫 번째 환경의 observation은 obs[0], 100번째 환경은 0부터 세므로 obs[99]입니다. obs[:, 0:3]은 모든 환경의 body-frame linear velocity 세 값을 고릅니다. 콜론의 위치가 바뀌면 “어느 로봇인가”와 “어느 feature인가”가 바뀝니다. batch 연산이 빠른 이유를 이해하기 전에 이 indexing 의미가 먼저 고정돼야 합니다.
병렬 환경 수는 실행 시 --num_envs로 바뀔 수 있습니다. 따라서 코드는 4,096이라는 숫자를 observation 연산에 박아 두지 않고 N을 보존합니다. 64개로 재생하면 [64, 73], 한 환경만 쓰면 [1, 73]이 됩니다. 마지막 feature 폭 73은 같은 policy 계약 안에서 유지됩니다.
MLP는 batch축을 보존하고 마지막 feature축만 바꿉니다
현재 actor 구조는 73 → 512 → 256 → 128 → 29입니다. PyTorch nn.Linear 문서에 따르면 linear layer는 마지막 입력 차원을 in_features로 해석하고, 그 앞의 차원은 그대로 보존합니다. 첫 layer의 weight shape는 [512, 73]이고, [4096, 73]을 넣으면 출력은 [4096, 512]입니다.
[4096, 73]
  → Linear(73, 512)  → [4096, 512]
  → Linear(512, 256) → [4096, 256]
  → Linear(256, 128) → [4096, 128]
  → Linear(128, 29)  → [4096, 29]
여기서 actor가 4,096개 policy를 가진 것은 아닙니다. 205,853개의 동일한 parameter를 모든 환경 표본에 공유합니다. 각 row가 다른 observation을 가지므로 action row는 달라지지만, 계산 규칙은 하나입니다. MLP의 구조와 parameter 수는 MLP·CNN·Transformer 비교 글, weight가 바뀌는 과정은 AI 모델 학습 글에서 이어서 볼 수 있습니다.
Broadcasting은 한 기준 자세를 N대에 공유하지만 축 오류도 숨길 수 있습니다
G1의 nominal joint pose는 처음에 길이 29인 vector입니다. 코드에서는 unsqueeze(0)으로 앞에 크기 1인 축을 넣어 [1, 29]로 만듭니다. action은 [N, 29]입니다. 그러면 아래 연산은 같은 nominal pose를 각 환경 row에 적용해 [N, 29] target을 만듭니다.
nominal_q : [1, 29]
actions   : [N, 29]
q_target  = nominal_q + 0.25 * actions  # [N, 29]
PyTorch broadcasting 규칙은 뒤쪽 축부터 비교해 길이가 같거나 한쪽이 1일 때 자동으로 크기를 맞춥니다. expand는 singleton dimension을 더 큰 view로 보이게 하며 새 메모리를 반드시 복사하지 않습니다. 이 덕분에 nominal pose 4,096개를 직접 복제할 필요가 없습니다.
편리함에는 위험도 있습니다. [N, 1] scale을 [N, 29] action에 곱하는 것은 각 환경에 하나의 scale을 적용합니다. 반면 [29] scale은 각 joint에 하나의 scale을 모든 환경에 공유합니다. 두 연산 모두 정상 실행되므로 shape만 보고 의도를 구분하기 어렵습니다. 변수 이름, 축 주석, assertion이 필요한 이유입니다. 그 결과가 실제 torque로 바뀌는 과정은 position action과 PD actuator 글에 분리해 두었습니다.
Reduction은 관절축을 지우되 환경축은 남겨야 합니다
reward를 계산할 때는 반대 방향의 연산이 필요합니다. 예를 들어 29개 joint torque의 제곱은 [N, 29]입니다. 이를 torch.sum(..., dim=-1)로 합치면 joint축이 사라져 [N]이 됩니다. PyTorch sum 문서에서 keepdim=False일 때 지정한 차원이 제거되는 동작입니다.
joint_cost : [N, 29]
reward     = joint_cost.sum(dim=-1)  # [N]

# 환경마다 reward 하나를 유지한다.
# reward.mean()을 호출해야 그때 전체 batch scalar가 된다.
환경별 reward [N]를 너무 일찍 평균내면 어느 환경이 넘어졌는지, 어떤 command 구간에서 penalty가 커졌는지 사라집니다. 학습 optimizer에는 평균 loss가 필요할 수 있지만, 진단에서는 distribution과 terminal 표본을 보존해야 합니다. episode 종료와 timeout을 환경별로 유지하는 이유는 termination·reset 글, 평균 scalar와 실제 평가를 구분하는 방법은 PPO 로그 판독 글에 연결됩니다.
Rollout은 batch 앞에 시간축을 하나 더 만듭니다
G1 PPO 설정은 환경마다 24 policy step을 수집한 뒤 update하도록 되어 있습니다. 한 시점의 observation이 [4096, 73]이라면 24개 시점을 쌓은 논리적 shape는 [24, 4096, 73]이고, transition 수는 24×4096=98,304입니다. 이 수는 실제 실행 로그에서 측정한 처리량이 아니라 현재 config의 산술 결과입니다.
| 대상 | 논리적 shape | float32 원소 수 | 순수 원소 크기 |
|---|---|---|---|
| 한 tick observation | [4096, 73] |
299,008 | 약 1.14 MiB |
| 한 tick action | [4096, 29] |
118,784 | 약 0.45 MiB |
| actor 첫 hidden | [4096, 512] |
2,097,152 | 8.00 MiB |
| 24-step observation | [24, 4096, 73] |
7,176,192 | 약 27.38 MiB |
표의 메모리는 원소 수에 float32의 4 byte만 곱한 이론값입니다. simulator state, critic observation, action distribution, reward, done, return, advantage, activation, gradient, optimizer state와 framework overhead는 포함하지 않았습니다. 따라서 “G1 학습은 27.38 MiB면 된다”는 결론으로 읽으면 안 됩니다. 시간축·환경축·policy step의 관계는 physics step과 vector rollout 글에서 더 자세히 다룹니다.
한 대만 추론할 때도 batch축을 잠시 만들어야 합니다
router의 PolicyLoader는 한 로봇에서 받은 [73] NumPy observation을 float32 tensor로 만들고 unsqueeze(0)을 호출합니다. PyTorch 문서대로 크기 1인 축이 앞에 들어가 [1, 73]이 됩니다. 학습 때와 같은 actor가 이를 받아 [1, 29]를 출력하고, squeeze(0)이 batch축만 제거해 [29]로 돌려줍니다.
runtime observation [73]
  → unsqueeze(0)  → [1, 73]
  → actor         → [1, 29]
  → squeeze(0)    → [29]
여기서 인자 없이 squeeze()를 쓰면 길이가 1인 다른 축까지 함께 사라질 수 있습니다. 현재 action 폭은 29라 문제가 드러나지 않지만, scalar action이나 singleton channel을 다루면 결과 rank가 달라질 수 있습니다. 제거할 축을 squeeze(0)처럼 명시하는 편이 인터페이스를 더 잘 보존합니다.
Image와 sequence는 같은 tensor라도 축의 문법이 다릅니다
G1의 73D vector policy만 보면 [batch, feature] 두 축이면 충분합니다. camera를 붙이면 흔히 [batch, channel, height, width], 시간 history를 붙이면 [batch, time, feature] 또는 library 계약에 따라 [time, batch, feature]가 됩니다. RGB image의 3은 feature 3개가 아니라 color channel이며, sequence의 두 번째 축은 순서가 있는 시간 또는 token입니다.
[B, 3, 224, 224]와 [B, 224, 224, 3]은 원소 수가 같지만 CNN이 기대하는 layout이 다를 수 있습니다. 마찬가지로 observation history [B, T, 73]을 잘못 reshape하면 각 환경의 시간이 다른 환경의 feature와 섞일 수 있습니다. 현재 policy의 시간 정보 경계는 observation history와 recurrent policy 글, image의 pixel 기하는 CameraInfo와 optical frame 글에서 이어집니다.
Dtype과 device가 다르면 같은 shape도 같은 계산이 아닙니다
tensor는 원소의 data type과 저장 위치도 가집니다. 현재 G1 환경은 device=self.device로 command와 상태 buffer를 만들며, runtime loader는 observation을 명시적으로 torch.float32로 변환한 뒤 policy device로 옮깁니다. 이 두 선택이 맞지 않으면 CPU/GPU device mismatch 오류가 나거나, 의도하지 않은 dtype 변환으로 계산 비용과 수치 범위가 달라질 수 있습니다.
그렇다고 모든 tensor를 무조건 float32로 바꾸면 되는 것도 아닙니다. contact 여부와 done은 boolean 의미가 있고, joint index는 정수 의미가 있습니다. timestamp를 float로 저장할 때는 정밀도와 epoch 범위를 따져야 합니다. dtype은 메모리 최적화 옵션이기 전에 값의 종류와 허용 범위를 표현하는 계약입니다.
Shape 검사는 경계에서 실패하도록 만들어야 합니다
현재 코드에는 observation 폭 73과 action 폭 29가 config에 선언돼 있고, 환경은 여덟 항목의 ordered layout과 각 폭을 연결 전에 검사합니다. checkpoint loader도 actor layer에서 입력·출력 차원을 추론합니다. 그러나 실행 시 전달된 73개 값의 ordered feature name, unit, frame, normalization identity까지 tensor 자체가 보존하지는 않습니다. 같은 shape의 잘못된 observation이 통과할 여지가 남아 있습니다.
다음 구현에서는 actor 호출 직전에 최소한 아래 계약을 한 번에 검사할 필요가 있습니다.
shape == [N, 73]이며 마지막 축의 ordered feature manifest가 checkpoint와 같은가- action 이전과 이후의 batch 크기
N이 보존되는가 - dtype과 device가 policy parameter와 호환되는가
- NaN·Inf가 없고 각 feature의 unit·frame·normalization ID가 일치하는가
- rollout flatten과 mini-batch 복원 뒤에도 time·environment index가 같은 transition을 가리키는가
이 검사는 모델이 잘 걷는다는 증거가 아닙니다. shape와 의미가 어긋난 입력을 성능 문제로 오해하지 않게 하는 배선 검사입니다. 실제 checkpoint가 같은 조건에서 재현되는지는 checkpoint 상태와 resume 글과 checkpoint 평가 계약 글에서 별도로 판정합니다.
Tensor shape는 계산 모양이면서 로봇 시스템의 인터페이스입니다
현재 G1의 한 observation은 [73] vector이고, 4,096개 병렬 환경에서는 [4096, 73] batch가 됩니다. MLP는 batch축을 보존하며 마지막 feature축을 512·256·128·29로 바꿉니다. reward reduction은 joint축을 없애 [4096]을 만들고, 24-step rollout은 시간축을 추가해 98,304개 transition을 구성합니다.
하지만 shape가 같다는 사실은 joint order, unit, frame, timestamp와 normalization까지 같다는 뜻이 아닙니다. 제가 다음으로 검증할 대상은 더 큰 batch가 아니라, observation manifest와 checkpoint identity를 runtime에서 묶고 일부러 joint 순서·dtype·batch축을 바꿨을 때 어느 경계에서 거부되는지 확인하는 fault test입니다. Tensor를 읽는 일은 괄호 안 숫자를 세는 데서 끝나지 않고, 그 숫자가 어느 로봇의 어떤 시점과 물리량을 가리키는지 보존하는 데서 끝납니다.