현재 코드에는 같은 G1 policy를 다루는 두 경로가 있습니다. training/rl/train.py는 Isaac Lab 환경과 RSL-RL의 OnPolicyRunner를 만든 뒤 runner.learn()을 호출합니다. 반면 router의 PolicyLoader.infer()는 checkpoint에서 actor를 복원하고 torch.no_grad() 안에서 action 하나를 계산합니다. 둘 다 신경망에 관측을 넣지만, 앞의 경로만 가중치를 바꿉니다.
이 차이를 설명하지 않으면 “학습했다”, “모델을 실행했다”, “checkpoint를 불러왔다”가 비슷한 말처럼 들립니다. 실제로는 서로 다른 사건입니다. 이 글에서는 현재 G1 환경의 73차원 observation과 29차원 action을 따라가며, forward pass가 무엇을 계산하고 loss·gradient·optimizer가 어느 순간 모델을 바꾸는지 정리합니다. PPO의 clipping 수식이나 reward 설계 전체는 기존 글에 남기고, 여기서는 신경망 학습에서 실제로 변하는 것이 무엇인가만 다룹니다.
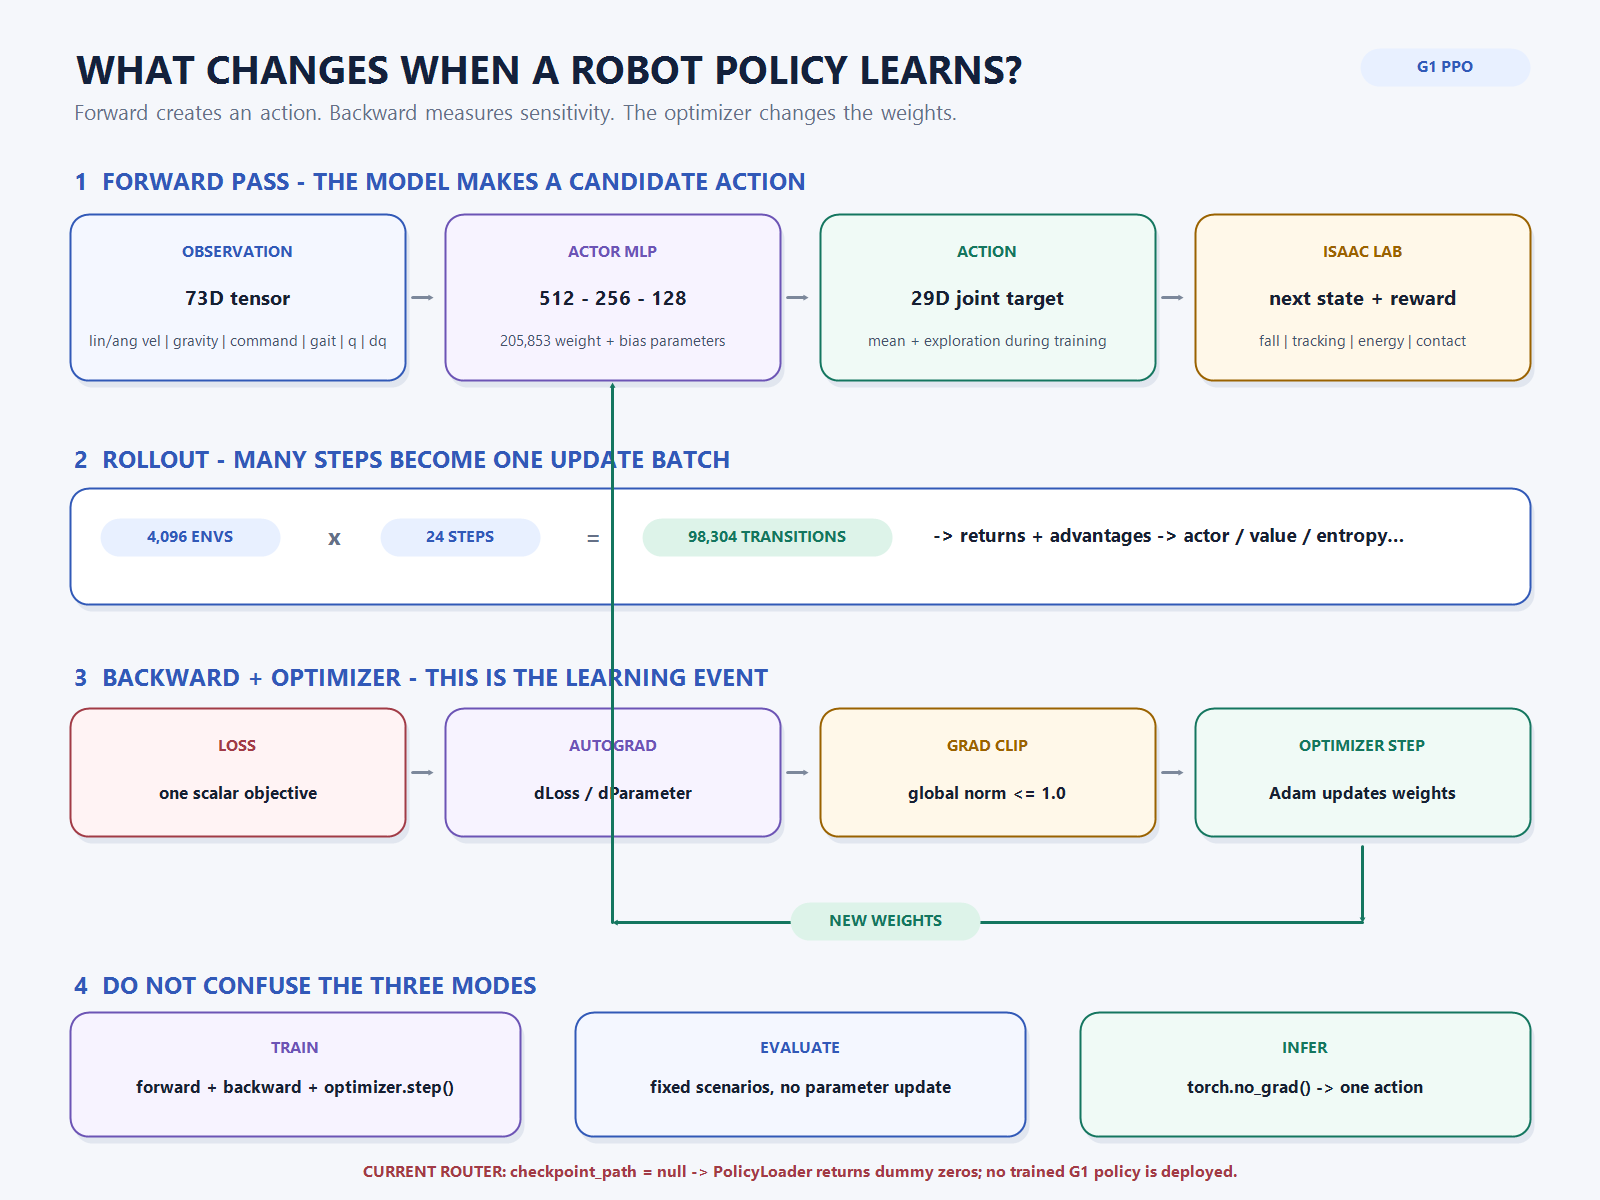
신경망이 학습한다는 말은 parameter tensor가 바뀐다는 뜻입니다
신경망은 경험을 문장으로 기억하는 주체가 아니라 입력을 출력으로 바꾸는 함수입니다. PyTorch의 공식 신경망 구성 문서처럼 linear layer는 입력에 저장된 weight와 bias를 적용하고, activation이 비선형성을 더합니다. 학습 가능한 값은 model.parameters()로 추적되는 tensor입니다.
hidden = ELU(W1 @ observation + b1)
hidden = ELU(W2 @ hidden + b2)
action = W4 @ hidden + b4
현재 G1 기본 actor는 73 → 512 → 256 → 128 → 29 구조의 MLP입니다. MLP는 여러 linear layer를 순서대로 연결한 가장 기본적인 신경망입니다. 각 layer의 weight와 bias를 세면 actor MLP에 205,853개의 parameter가 있습니다. 학습용 Gaussian policy의 29개 action 표준편차 parameter까지 포함하면 actor 쪽은 205,882개입니다. 별도의 critic parameter도 같은 optimizer가 갱신하므로 이 숫자를 전체 PPO model 크기로 읽으면 안 됩니다. 여기서 중요한 점은 지능 점수가 아니라 학습 중 바뀔 수 있는 scalar를 구체적으로 셀 수 있다는 것입니다.
| layer | weight shape | bias | parameter 수 |
|---|---|---|---|
| 입력→hidden 1 | 512 × 73 | 512 | 37,888 |
| hidden 1→2 | 256 × 512 | 256 | 131,328 |
| hidden 2→3 | 128 × 256 | 128 | 32,896 |
| hidden 3→action | 29 × 128 | 29 | 3,741 |
| actor MLP 합계 | 205,853 | ||
73과 29도 임의의 숫자가 아닙니다. 현재 G1WalkEnv는 body-frame linear·angular velocity 각 3개, projected gravity 3개, ramp가 적용된 속도 명령 3개, gait phase의 sin·cos 2개, 목표 swing side 1개, nominal 자세에서 뺀 joint position 29개, joint velocity 29개를 이어 붙입니다. actor의 출력 29개는 곧바로 torque가 아니라 nominal joint position에 action_scale=0.25를 곱한 offset으로 더해지는 목표입니다. 관측과 행동의 의미는 G1 강화학습 환경 글, action 이후 PD와 torque는 위치·속도·토크 제어 글에 분리해 두었습니다.
forward pass는 현재 weight로 action을 계산할 뿐입니다
관측 하나가 actor를 통과해 29차원 출력을 만드는 계산을 forward pass라고 부릅니다. 각 linear layer는 이전 벡터를 행렬과 곱하고 bias를 더합니다. 현재 설정의 ELU activation은 결과를 단순 직선 조합으로만 남기지 않고 음수와 양수 영역을 비선형으로 바꿉니다. 여러 layer를 쌓으면 관절 상태와 명령의 조합에 따라 서로 다른 action mapping을 표현할 수 있습니다.
하지만 forward pass가 실행됐다는 사실만으로 학습은 일어나지 않습니다. 같은 observation과 같은 weight를 넣으면 같은 actor mean이 나옵니다. 학습 중에는 이 mean과 별도의 standard deviation으로 Gaussian distribution을 만들고 sample을 뽑아 탐색합니다. RSL-RL의 ActorCritic 구현에서도 inference는 actor mean을 반환하고 training action은 분포에서 sample합니다. 같은 checkpoint인데 학습 영상과 평가 영상의 행동이 달라 보일 수 있는 이유입니다.
현재 PolicyLoader.infer()는 NumPy observation을 float32 tensor로 바꾸고 batch 차원 하나를 붙인 뒤 actor를 호출합니다. 여기에는 reward 계산도, loss도, optimizer도 없습니다. checkpoint가 없거나 읽히지 않으면 loader는 같은 크기의 zero action을 반환합니다. 따라서 router가 action 배열을 돌려줬다는 사실만으로 실제 학습된 policy가 실행됐다고 판단하면 안 됩니다.
지도학습의 정답 대신 로봇 강화학습은 rollout에서 학습 신호를 만듭니다
이미지 분류라면 입력 image와 정답 label을 비교해 틀린 정도를 loss로 만들 수 있습니다. 보행에는 각 20ms마다 “이 29차원 action이 정답”이라고 적힌 label이 없습니다. policy가 action을 내고 Isaac Lab이 다음 state, reward, 종료 여부를 반환하는 상호작용을 먼저 모아야 합니다. 이 연속 기록이 rollout입니다.
reward는 한 simulation step의 결과를 평가합니다. 목표 속도를 따라갔는지, 몸통이 기울었는지, torque를 과도하게 썼는지 같은 여러 항을 합칩니다. return은 이후 reward를 시간에 따라 합친 값이고, advantage는 같은 state에서 선택한 action이 critic의 예상보다 얼마나 나았는지를 추정합니다. 그 상세는 V·Q·Advantage 글이 맡습니다.
PPO는 이 advantage를 사용해 좋았던 action의 확률은 높이고 나빴던 action의 확률은 낮추는 surrogate objective를 만듭니다. 동시에 critic이 return을 더 잘 예측하도록 value loss를 계산하고, 탐색이 너무 빨리 사라지지 않도록 entropy 항을 둡니다. PPO 원 논문이 interaction으로 표본을 모은 뒤 surrogate objective를 여러 mini-batch epoch에 걸쳐 최적화하는 구조를 제안한 이유입니다.
reward와 loss는 같은 숫자가 아닙니다
reward는 환경이 행동 결과에 붙이는 신호입니다. loss는 그 reward와 value, old policy probability 등을 이용해 parameter를 어느 방향으로 바꿀지 계산하기 위한 optimization objective입니다. reward는 보통 크게 만들고 싶고 loss는 optimizer 관례상 작게 만들지만, 부호를 바꾸면 같은 목적을 표현할 수 있습니다. “reward가 내려갔으니 loss가 올라갔다”처럼 두 곡선을 일대일로 대응시키면 안 됩니다.
현재 G1 PPO 설정에는 value loss coefficient 1.0, entropy coefficient 0.002, clip parameter 0.2가 있습니다. 최종 optimization에는 actor surrogate, critic value error, exploration 항이 서로 다른 역할로 들어갑니다. actor loss가 줄어도 critic이 좋아졌다는 뜻은 아니고, value loss가 줄어도 실제 보행이 좋아졌다는 뜻은 아닙니다. 각각 어느 parameter group에 gradient를 보내는지 확인해야 합니다.
더 근본적인 한계도 있습니다. optimizer는 주어진 objective를 줄일 뿐, 그 objective가 사람이 원하는 보행을 정확히 표현하는지 판단하지 않습니다. 발을 끌면서도 넘어지지 않아 reward를 얻거나, 저속 경로를 포기하고 다른 조건의 점수를 지킬 수 있습니다. reward hacking 글과 motion-tracking reward 계약을 loss 밖의 문제로 따로 둔 이유입니다.
backpropagation은 결과에서 각 weight의 책임을 역으로 계산합니다
forward pass 동안 PyTorch는 어떤 tensor 연산이 어떤 결과를 만들었는지 computational graph를 추적할 수 있습니다. PyTorch Autograd 공식 설명처럼 automatic differentiation은 복잡한 계산을 따라 여러 parameter에 대한 편미분을 계산하며, 이것이 backpropagation 기반 학습의 중심입니다.
loss.backward()를 호출하면 마지막 loss에서 actor와 critic의 weight까지 chain rule을 거꾸로 적용합니다. 각 parameter의 gradient는 “이 값을 아주 조금 바꿨을 때 현재 loss가 얼마나 변하는가”를 나타냅니다. gradient가 크다는 것은 민감하다는 뜻이지 그 parameter가 로봇 실패의 원인으로 확정됐다는 뜻은 아닙니다. rollout distribution과 loss 설계가 바뀌면 같은 weight에도 다른 gradient가 생깁니다.
계산 경로가 끊기면 gradient도 끊깁니다. tensor를 detach했거나 frozen parameter가 optimizer에 등록되지 않았거나, 조건문에서 custom loss가 실제 objective에 더해지지 않았다면 로그에 숫자가 보여도 actor는 움직이지 않을 수 있습니다. 반대로 torch.no_grad()는 gradient graph 자체를 만들지 않습니다. 현재 router inference가 model을 바꾸지 않는 가장 직접적인 코드 증거입니다.
gradient를 계산한 뒤에도 optimizer.step() 전에는 모델이 그대로입니다
PyTorch의 공식 optimization loop는 세 사건을 분리합니다. 이전 gradient를 비우고, loss.backward()로 새 gradient를 계산한 다음, optimizer.step()으로 parameter를 갱신합니다. backward가 끝났다는 것과 새 weight가 저장됐다는 것은 같은 일이 아닙니다.
optimizer.zero_grad()
loss.backward()       # gradient 계산
clip_grad_norm_(model.parameters(), 1.0)
optimizer.step()      # 이 줄에서 weight 변경
현재 G1 설정은 learning rate 1.0e-3와 maximum gradient norm 1.0을 선언합니다. learning rate는 gradient를 어느 크기로 parameter 변화에 반영할지 정합니다. gradient clipping은 전체 norm이 너무 클 때 update 방향은 유지하면서 크기를 제한합니다. 둘 다 폭주를 줄이는 장치지만 좋은 행동 방향을 선택해 주지는 않습니다.
현재 training entry point가 사용하는 RSL-RL PPO의 공식 구현은 기본 optimizer로 Adam을 선택하고 actor와 critic parameter를 함께 등록합니다. Adam은 현재 gradient만 쓰지 않고 gradient의 1차·2차 moment 추정치를 state로 보존합니다. 그래서 같은 model weight와 같은 새 batch가 있어도 optimizer state가 다르면 다음 update가 달라질 수 있습니다. learning rate와 update budget을 바꾸는 순서는 PPO 하이퍼파라미터 글에서 더 깊게 다뤘습니다.
한 번의 robot step과 한 번의 learning iteration은 다릅니다
현재 기본 설정은 4,096개 environment에서 각각 24 step을 수집합니다. 한 iteration의 rollout은 4,096 × 24 = 98,304 transition입니다. policy가 20ms마다 action을 냈다고 그때마다 weight가 바뀌는 것이 아닙니다. 24 step을 모은 뒤 return과 advantage를 계산하고 나서 optimization이 시작됩니다.
이 98,304개 표본은 네 mini-batch로 나뉘고, 같은 rollout을 다섯 epoch 반복합니다. 논리적으로 한 mini-batch에는 24,576 transition이 들어가며 한 iteration에 20번의 optimizer step이 생깁니다. multi-GPU나 구현 세부에 따라 실제 분할은 달라질 수 있지만, 현재 단일-device 설정을 읽는 기본 산술은 이렇습니다.
| 단위 | 현재 G1 기본 설정 | parameter가 바뀌는가 |
|---|---|---|
| physics step | 5ms simulation 진행 | 아니오 |
| policy step | 20ms마다 observation→action | 아니오 |
| rollout | 4,096 env × 24 step | 아니오 |
| mini-batch optimizer step | 4 mini-batch × 5 epoch | 예 |
| learning iteration | rollout 수집 + 20 optimizer step | 예, 여러 번 |
이 구분이 없으면 학습 속도를 잘못 해석합니다. simulation FPS가 빨라졌다는 것은 rollout 수집이 빨라졌다는 뜻일 수 있지만 optimizer 계산이 빨라졌다는 보장은 없습니다. 반대로 epoch 수를 늘리면 같은 data를 더 많이 재사용하지만 새 물리 경험이 늘지는 않습니다. 자세한 다중 시간축은 Isaac Lab step·decimation·rollout 글로 연결합니다.
train·evaluate·infer는 같은 checkpoint를 써도 목적이 다릅니다
| mode | 입력 | gradient·update | 판정 |
|---|---|---|---|
| train | 현재 policy가 만든 rollout | graph 생성, backward, optimizer step | objective 최적화가 실행됐는가 |
| evaluate | 고정 scenario와 checkpoint | 없음 | 선언한 behavior gate를 통과하는가 |
| infer | 현재 observation 한 묶음 | no_grad, 없음 |
요구 시간 안에 action을 만드는가 |
학습은 parameter를 바꾸기 위한 실행이고, 평가는 바꾸지 않은 candidate를 고정 조건에서 판정하는 실행입니다. inference는 실제 runtime에서 action을 얻는 계산입니다. 평가를 학습 중간 reward로 대신할 수 없고, inference 한 번 성공을 학습 완료라고 부를 수도 없습니다.
확률 policy에서는 action 선택 방식도 달라질 수 있습니다. 학습은 Gaussian에서 sample해 exploration을 만들고, 평가는 mean action으로 반복성을 높이는 경우가 많습니다. 현재 G1의 std·entropy와 deterministic 평가 차이는 Gaussian action 탐색 글에 남겨 두었습니다.
checkpoint는 model 파일이지만 학습을 그대로 이어 주는지는 내용에 달려 있습니다
PyTorch의 state_dict 설명에 따르면 model state는 layer 이름과 parameter tensor를 연결한 dictionary입니다. optimizer도 별도 state_dict를 가지며 optimization state와 hyperparameter를 저장합니다. inference만 한다면 actor weight로 충분할 수 있지만, 동일한 학습을 이어가려면 optimizer moment와 iteration, learning rate schedule, observation normalizer 같은 상태가 필요합니다.
현재 PolicyLoader는 rsl_rl checkpoint의 model_state_dict에서 actor.* key만 골라 MLP를 복원합니다. 이것은 inference 경로로는 합리적입니다. 하지만 critic과 optimizer state를 버렸으므로 이 actor 파일을 다시 불러 학습한다고 원래 run의 연속이 되는 것은 아닙니다. model-only load와 full resume의 차이는 PPO checkpoint·resume 글이 소유합니다.
loss가 줄었다는 사실은 학습 배선의 증거이지 좋은 보행의 증거가 아닙니다
학습을 네 단계로 나누면 과장하기 어려워집니다. loss가 계산됐는지, gradient가 actor까지 도달했는지, optimizer step 뒤 parameter가 실제로 달라졌는지, 새 checkpoint가 행동 평가를 통과했는지 각각 증거가 필요합니다. 앞 단계 통과가 뒤 단계를 자동으로 증명하지 않습니다.
| 증거 | 확인 방법 | 증명하는 것 | 아직 모르는 것 |
|---|---|---|---|
| finite loss | actor·value·entropy·custom loss log | objective code path 실행 | actor에 gradient가 도달했는가 |
| finite gradient | layer별 gradient norm | loss가 parameter와 연결됨 | optimizer가 실제로 바꿨는가 |
| parameter delta | step 전후 tensor diff·hash | weight update 발생 | 행동이 좋아졌는가 |
| behavior delta | baseline과 paired trace | 관측 가능한 정책 변화 | 전체 평가 gate 통과 |
| acceptance | 고정 scenario·multi-seed 평가 | 선언한 범위의 checkpoint 승인 | 실물 배포 안전 |
현재 G1 작업에서는 training reward와 episode length가 좋아져도 route·heading·morphology gate가 나빠진 사례가 있었습니다. 그 때문에 TensorBoard scalar를 읽는 순서와 한계는 PPO 학습 로그 글, checkpoint 승격 조건은 평가 계약 글로 분리했습니다. optimizer가 목적함수를 잘 줄였다는 사실과 목적함수가 올바른 행동을 골랐다는 판단 사이에는 평가가 필요합니다.
현재 G1 경로에서 구현된 것과 아직 열려 있는 것을 다시 나눕니다
현재 source에는 73차원 observation과 29차원 action을 가진 Isaac Lab 환경, actor·critic hidden dimension과 PPO hyperparameter를 선언한 YAML, OnPolicyRunner.learn()을 호출하는 training entry point가 있습니다. router 쪽에는 checkpoint shape에서 observation과 action dimension을 추론해 actor를 복원하는 loader도 구현돼 있습니다.
하지만 robot-control-router/configs/backends/rl_g1_walk.yaml의 checkpoint_path는 null입니다. loader는 이 경우 dummy zero action으로 fallback합니다. 따라서 현재의 정확한 상태는 학습·추론 code path가 구현돼 있다는 것이며, 이 checked-in router 설정에 승인된 G1 checkpoint가 배포돼 있다는 뜻은 아닙니다.
다음 검증은 새로운 학습을 오래 돌리는 일이 아닙니다. 한 iteration canary에서 actor parameter hash를 update 전후로 남기고, layer별 gradient norm·global clipped norm·optimizer step 수·parameter delta를 같은 run ID에 묶어야 합니다. 그 checkpoint를 deterministic 고정 scenario에서 parent와 비교해 action과 behavior가 어느 시점부터 달라졌는지 확인합니다. 이 연결이 있어야 “loss가 살아 있다”에서 “의도한 parameter가 움직였다”, 다시 “평가 가능한 행동 변화가 생겼다”로 증거를 올릴 수 있습니다.
AI 학습을 이해하는 가장 짧은 기준은 어떤 값이 언제 바뀌는지 추적하는 것입니다
신경망이 action을 출력했다고 학습한 것은 아닙니다. forward pass는 현재 weight로 계산합니다. rollout은 환경과 상호작용한 표본을 만듭니다. loss는 그 표본에서 바꾸고 싶은 방향을 scalar objective로 압축합니다. backward는 각 parameter의 민감도를 gradient로 계산합니다. optimizer step이 weight를 바꾸고, checkpoint가 그 상태를 저장합니다. 평가는 새 weight가 실제 행동 기준을 통과하는지 별도로 판정합니다.
새 AI 모델이나 논문을 볼 때도 같은 순서로 읽을 수 있습니다. 입력과 출력의 shape는 무엇인지, 학습 가능한 parameter는 어디에 있는지, 어떤 data가 loss를 만들고, gradient가 어느 모듈까지 흐르며, optimizer가 무엇을 저장하고, 어떤 평가가 update의 의미를 확인하는지 묻습니다. 이 질문에 답할 수 있으면 “AI가 배웠다”는 한 문장을 실행 가능한 구성요소와 검증 가능한 사건으로 나눌 수 있습니다.