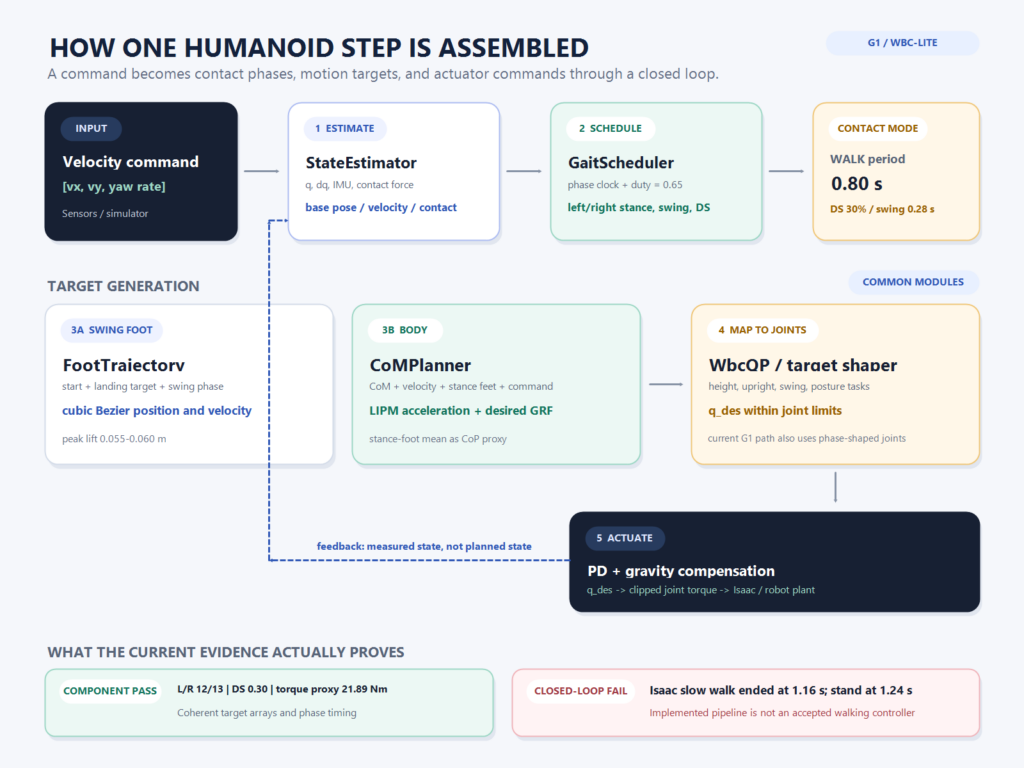
휴머노이드의 한 걸음은 어떻게 만들어지는가: gait scheduler부터 WBC QP까지
G1 WBC-lite 보행 목표 생성기를 10초 동안 돌리면 왼발 12회, 오른발 13회의 교대 스텝이 나옵니다. 좌우 스텝 수 비대칭은 0.08이고, […]
G1 WBC-lite 보행 목표 생성기를 10초 동안 돌리면 왼발 12회, 오른발 13회의 교대 스텝이 나옵니다. 좌우 스텝 수 비대칭은 0.08이고, […]
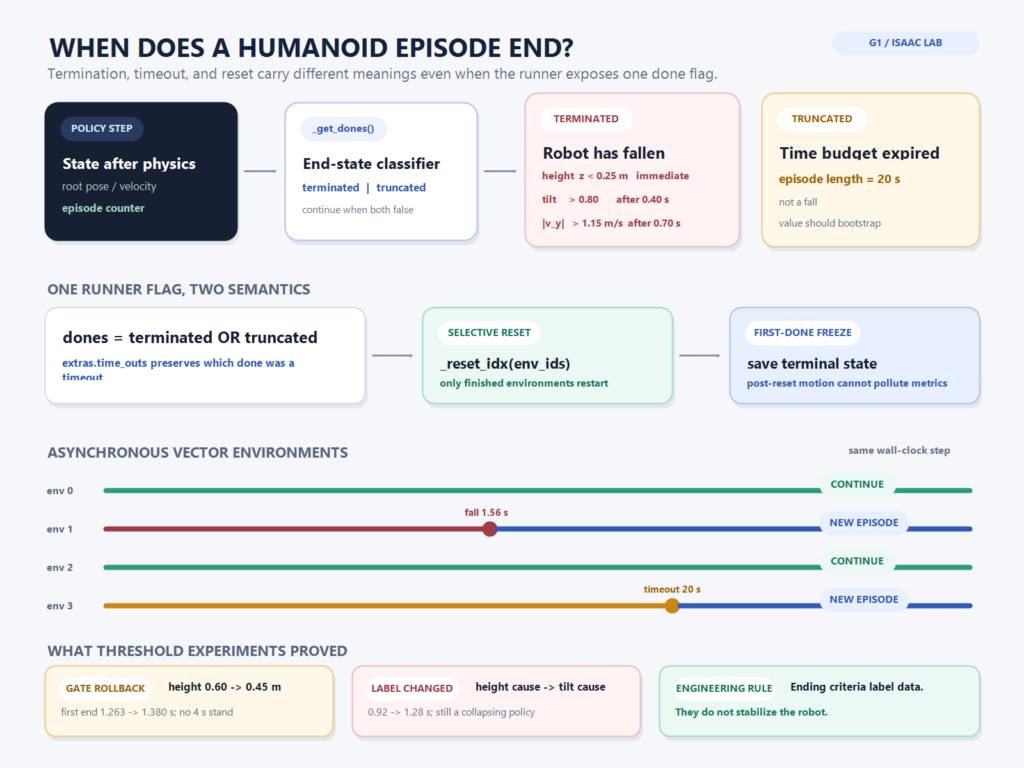
G1의 넘어짐 판정 높이를 0.60m에서 0.45m로 낮춰 본 적이 있습니다. 첫 종료 시점은 1.263초에서 1.380초로 늦어졌습니다. 그러나 목표였던 4초 정지는
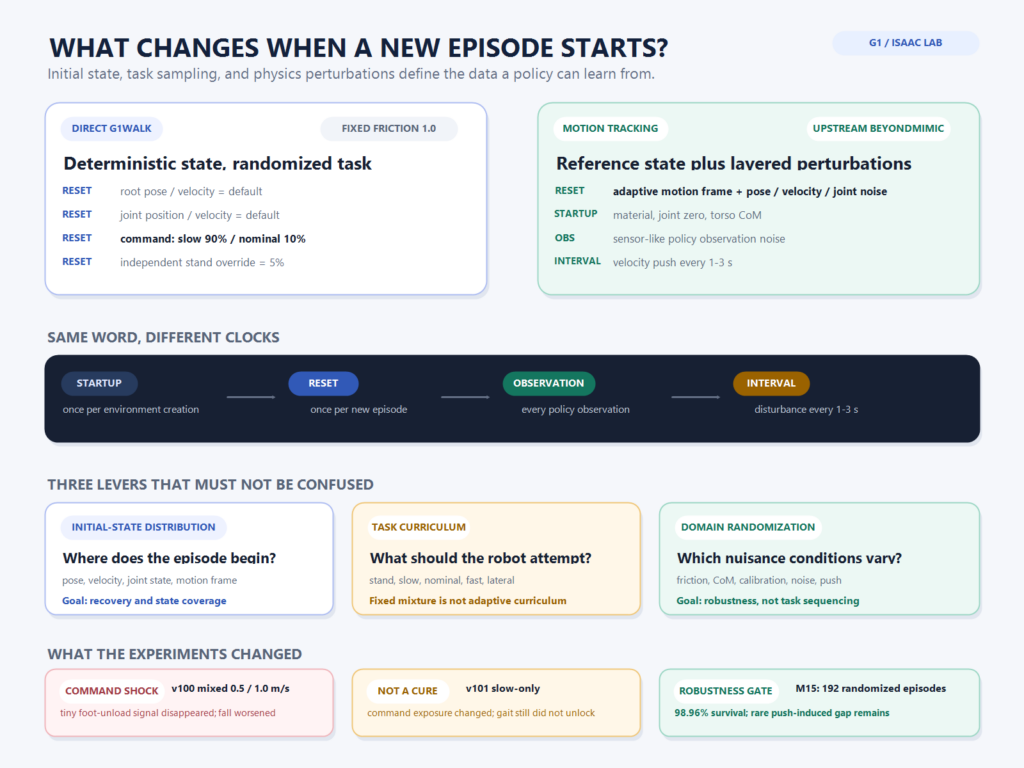
v99의 G1 정책은 아직 걷지 못했지만, nominal 명령에서 처음으로 아주 작은 single-support 신호를 만들었습니다. 두 발 중 하나가 떠 있던
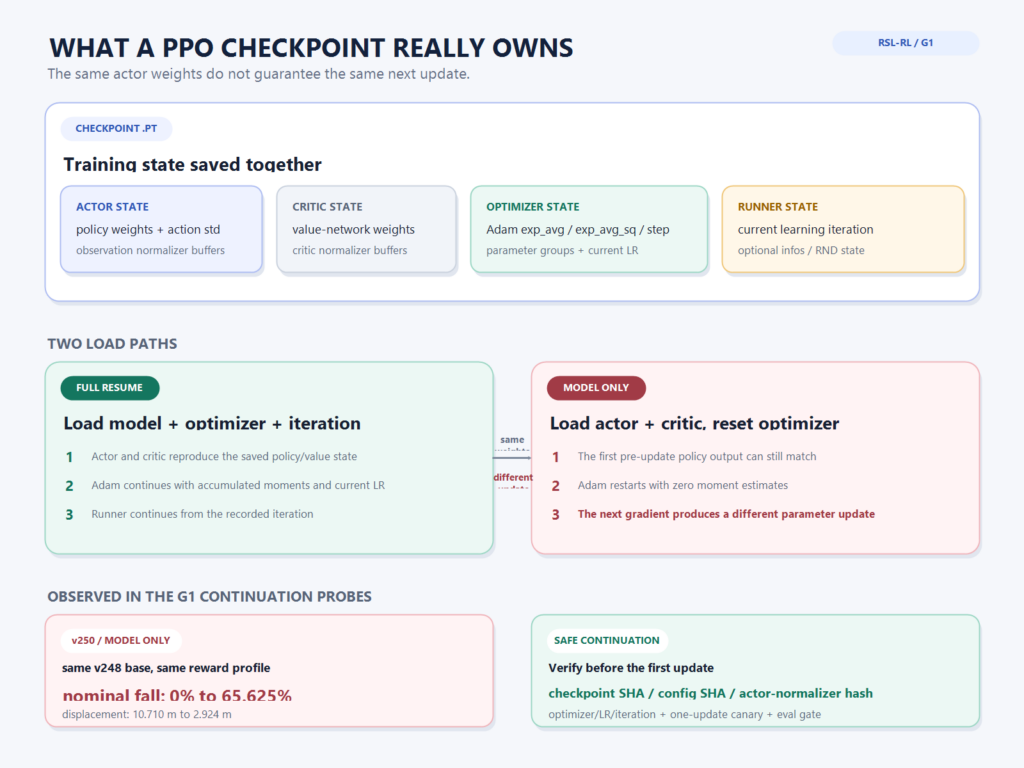
v248의 G1 정책은 slow와 nominal 평가에서 한 번도 넘어지지 않았습니다. nominal 이동 거리는 10.710m였습니다. 이 체크포인트에서 보상 함수, 관측·행동 차원,
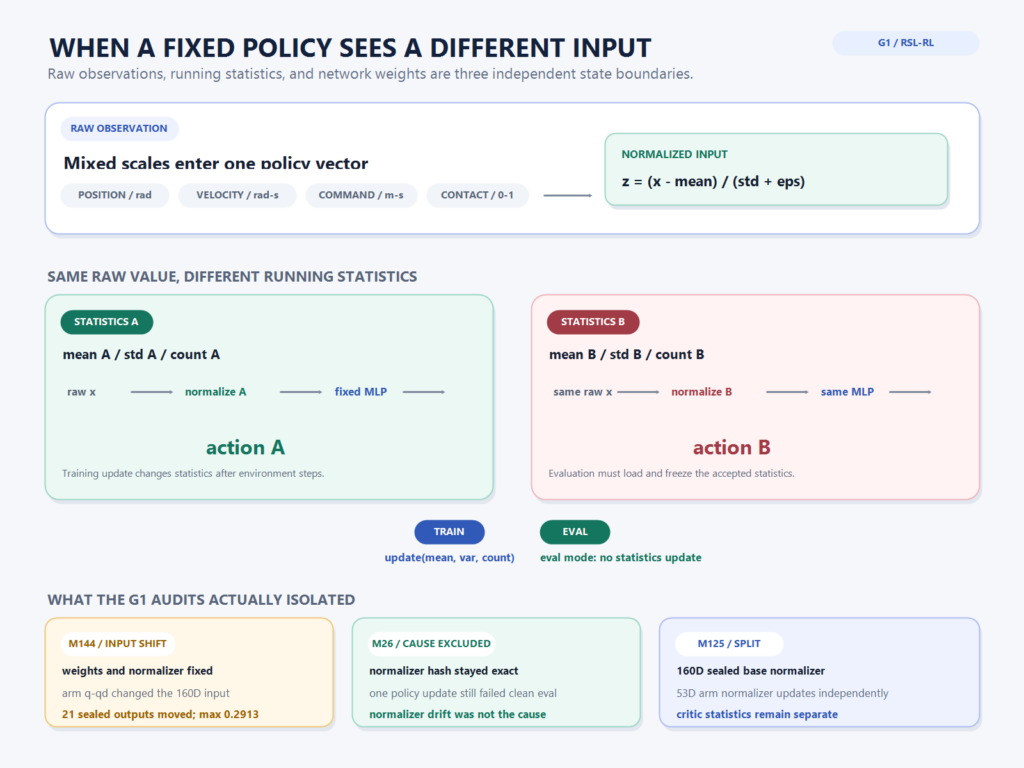
M144의 actor isolation audit에서는 M15 network weight와 observation normalizer를 모두 고정했습니다. lower body·waist·wrist에 해당하는 21개 action row도 학습 대상에서 제외했습니다.
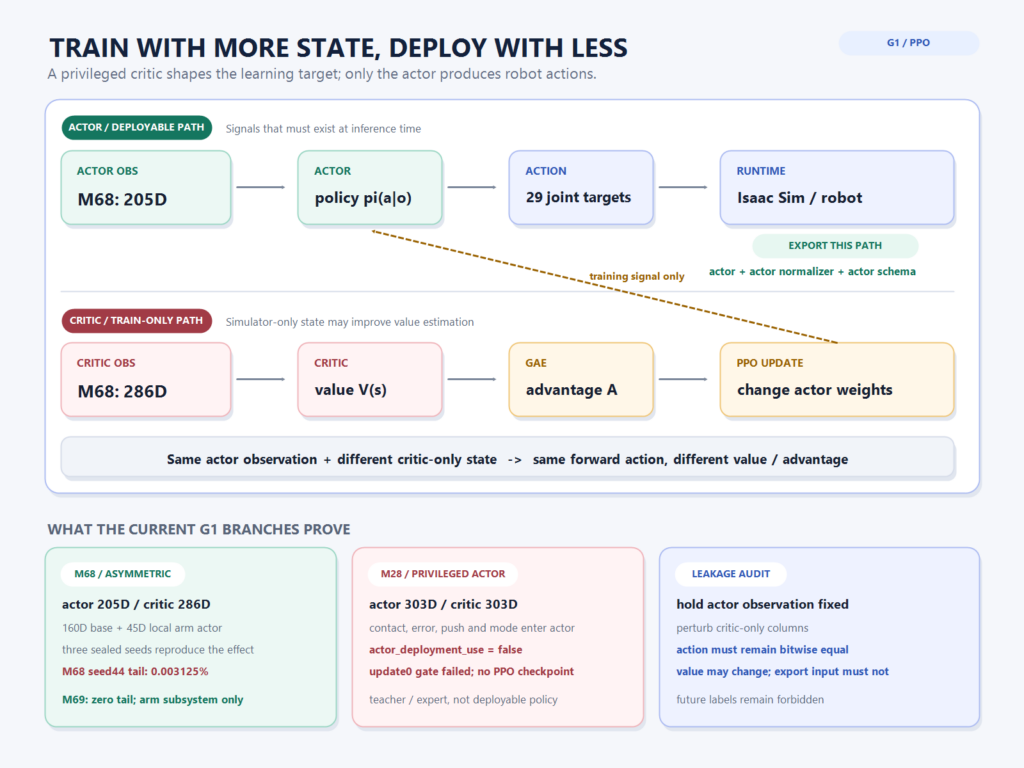
M68의 one-update canary가 저장한 shape는 actor 205차원, critic 286차원, action 29차원이었습니다. 이후 seed 42에서 100 update를 두 block 실행했고, model_2225.pt는
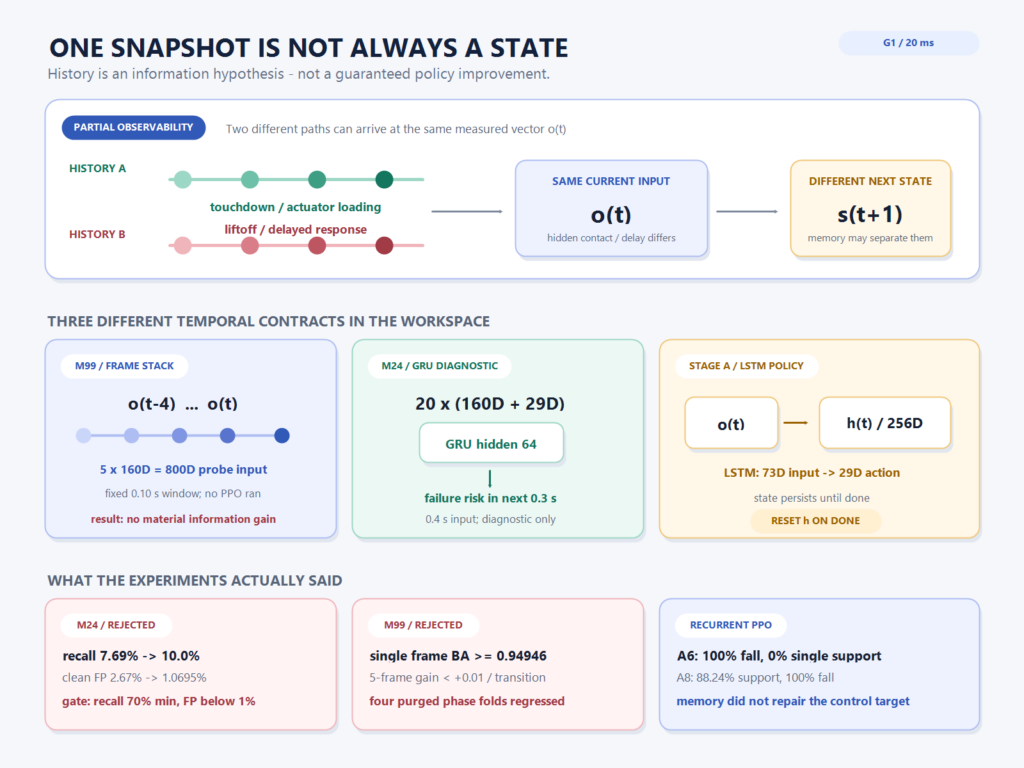
G1 정책에 과거 관측을 붙이기 전에 먼저 정보량부터 재봤습니다. M99에서는 현재 160차원 observation 한 장과 최근 다섯 장을 이어 붙인
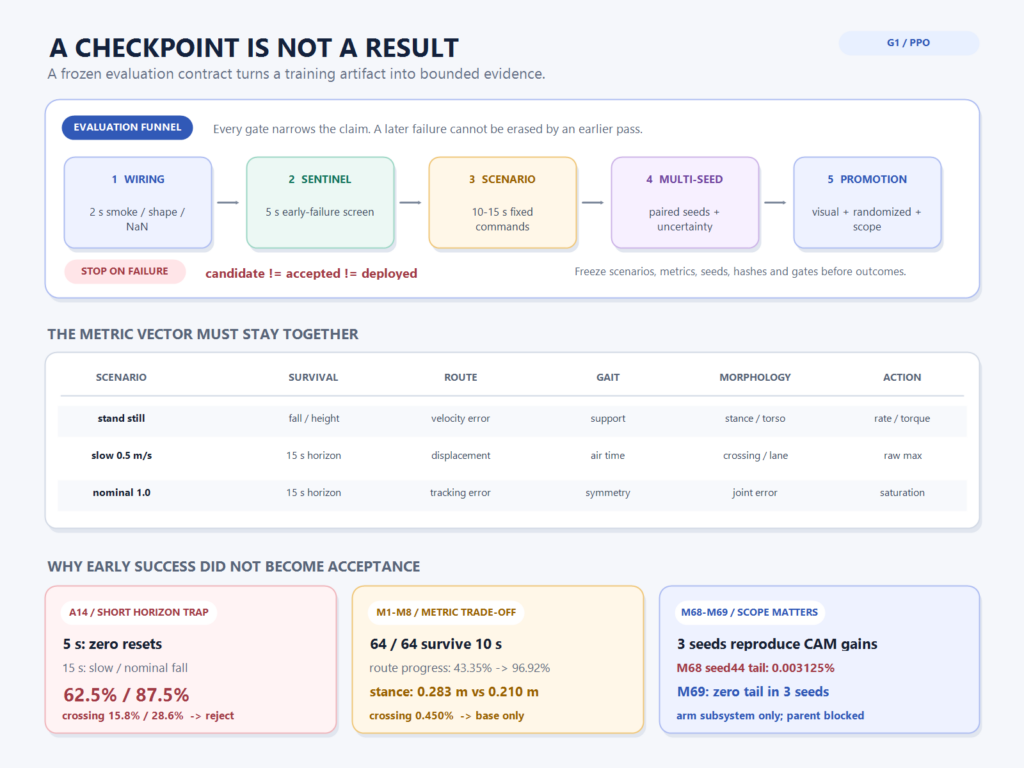
G1 motion-tracking 학습에서 가장 판단하기 어려웠던 순간은 로봇이 바로 넘어질 때가 아니었습니다. 오히려 64개 환경이 10초 동안 모두 살아남고, 기준
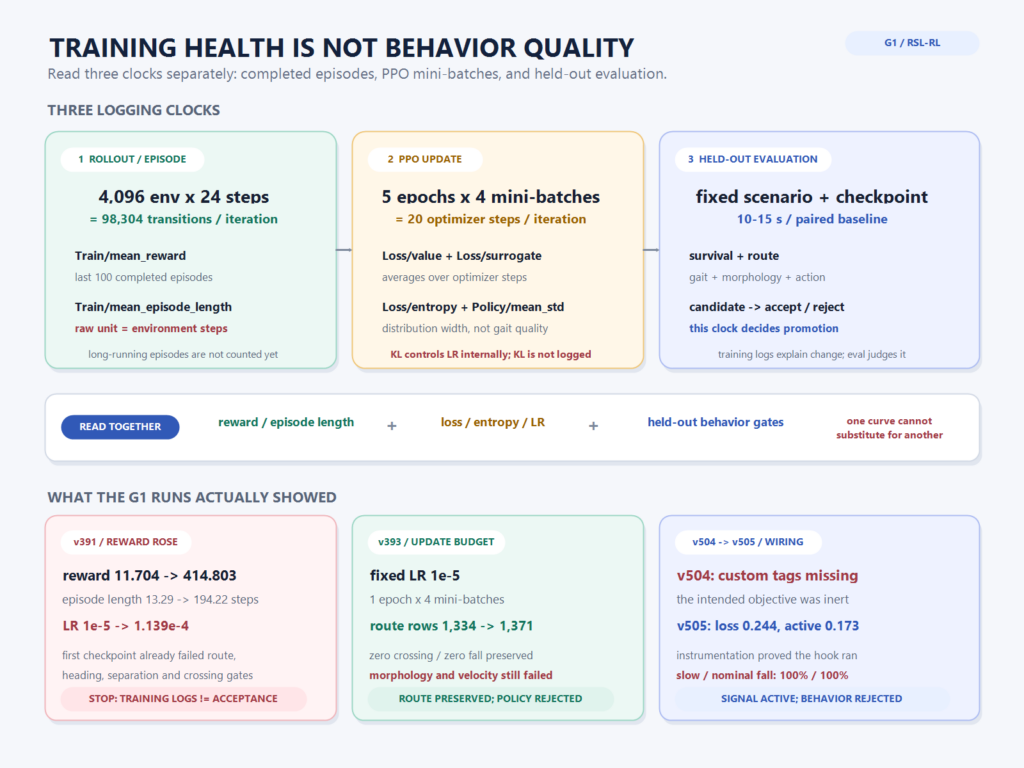
G1 v391 학습에서는 TensorBoard의 숫자만 보면 정책이 빠르게 좋아지는 것처럼 보였습니다. Train/mean_reward는 11.704에서 414.803으로 올랐고, Train/mean_episode_length도 13.29에서 194.22로 늘었습니다. adaptive
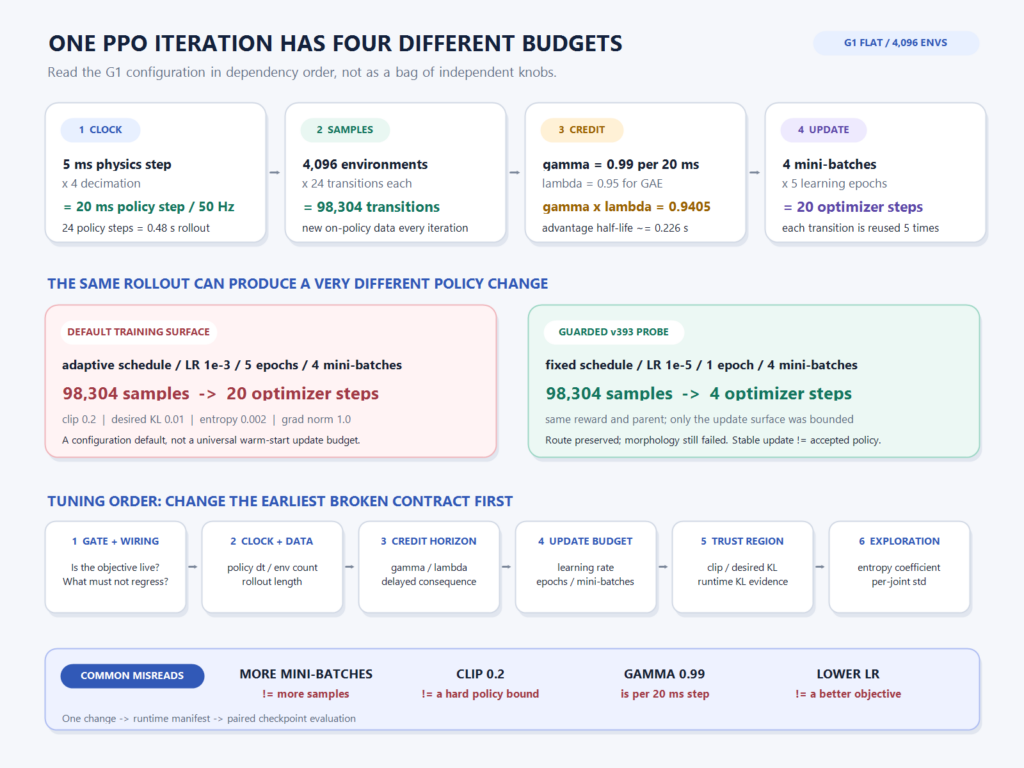
현재 G1 기본 설정은 한 번의 PPO iteration에서 98,304개의 transition을 모은 뒤 20번의 optimizer step을 수행합니다. 경로가 갑자기 무너지는 현상을