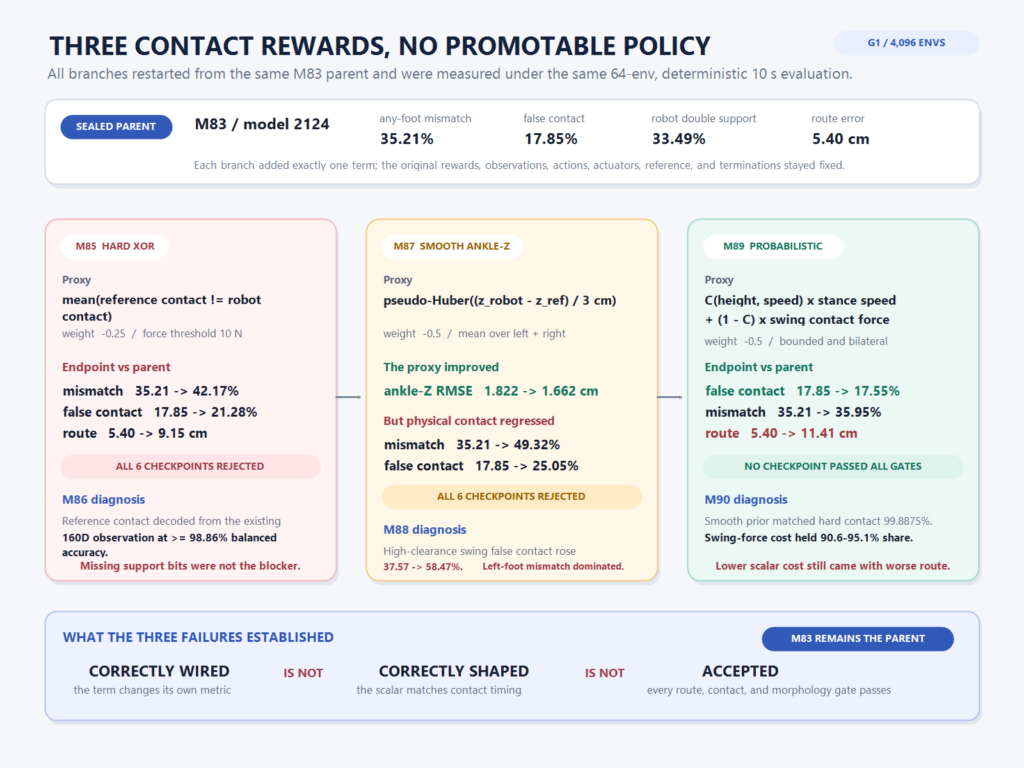
발을 디디라고 보상했는데 접촉이 더 나빠졌다: G1 contact reward 세 번의 실패
발목 높이 오차는 1.822cm에서 1.662cm로 줄었습니다. 제가 추가한 reward가 계산되고, PPO가 그 값을 실제로 최적화했다는 뜻이었습니다. 그런데 같은 정책의 false […]
발목 높이 오차는 1.822cm에서 1.662cm로 줄었습니다. 제가 추가한 reward가 계산되고, PPO가 그 값을 실제로 최적화했다는 뜻이었습니다. 그런데 같은 정책의 false […]

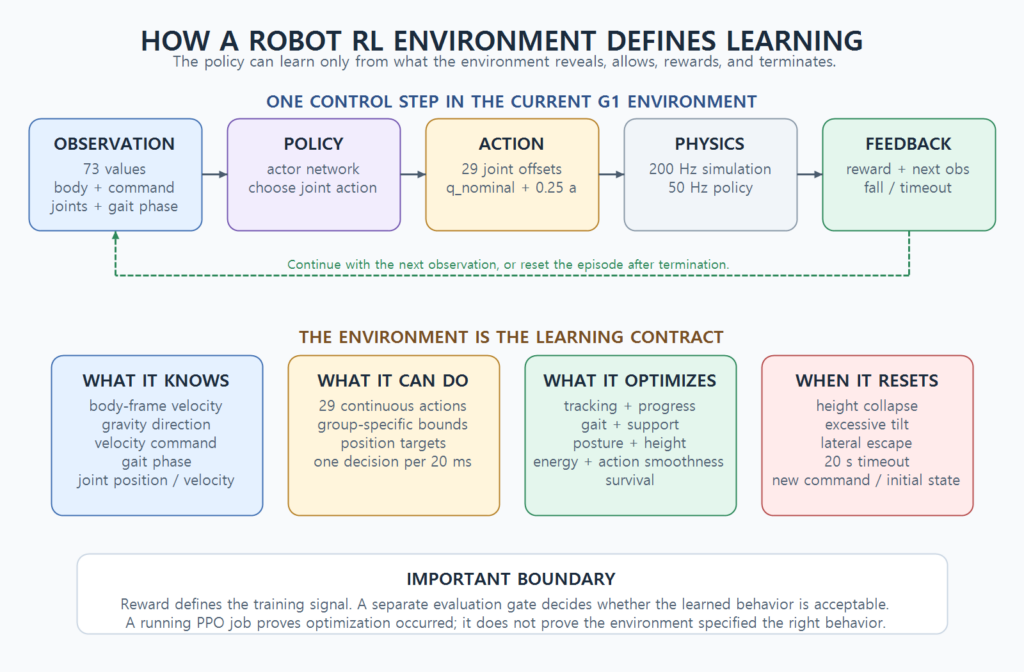
현재 G1 PPO는 Isaac Sim에서 한 iteration마다 4,096개 환경 × 24 step, 총 98,304개의 transition을 만듭니다. 시뮬레이터는 action을 받은 로봇의
초기 G1 보행 환경에서는 발을 조금 들어도 공중 시간 보상이 음수가 되는 구간이 있었습니다. 정책은 발을 들지 않는 쪽으로 움직였습니다.
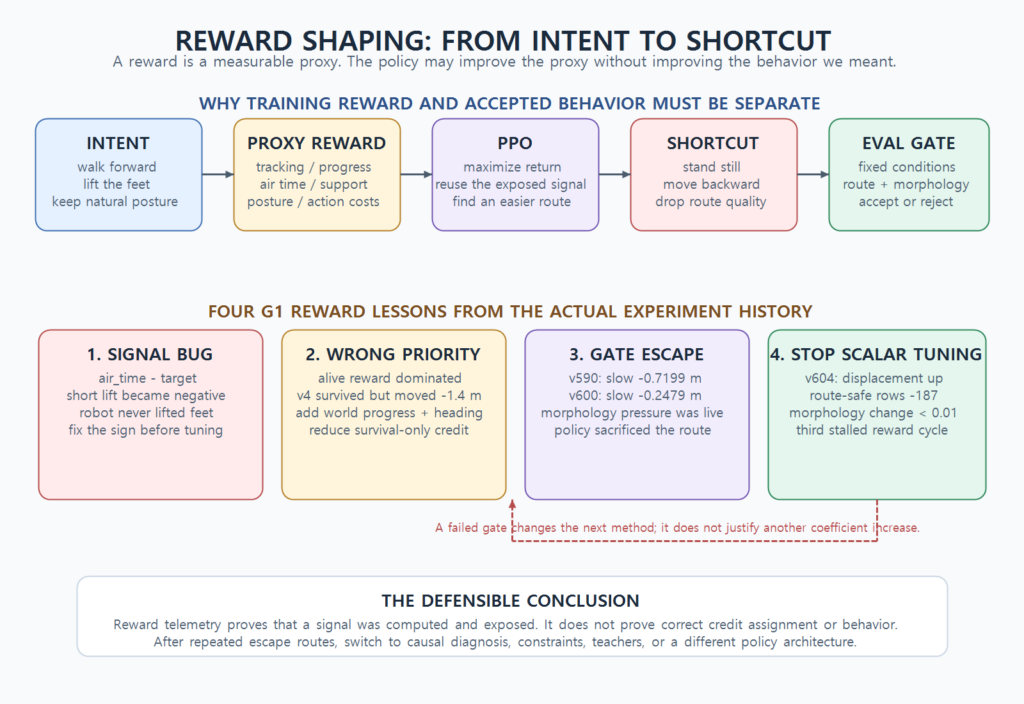
G1 보행 정책의 한 실험에서는 느린 명령 구간의 이동거리가 0.187m 늘었습니다. 넘어지거나 발이 교차하는 문제도 없었습니다. 숫자만 보면 정책이 좋아진
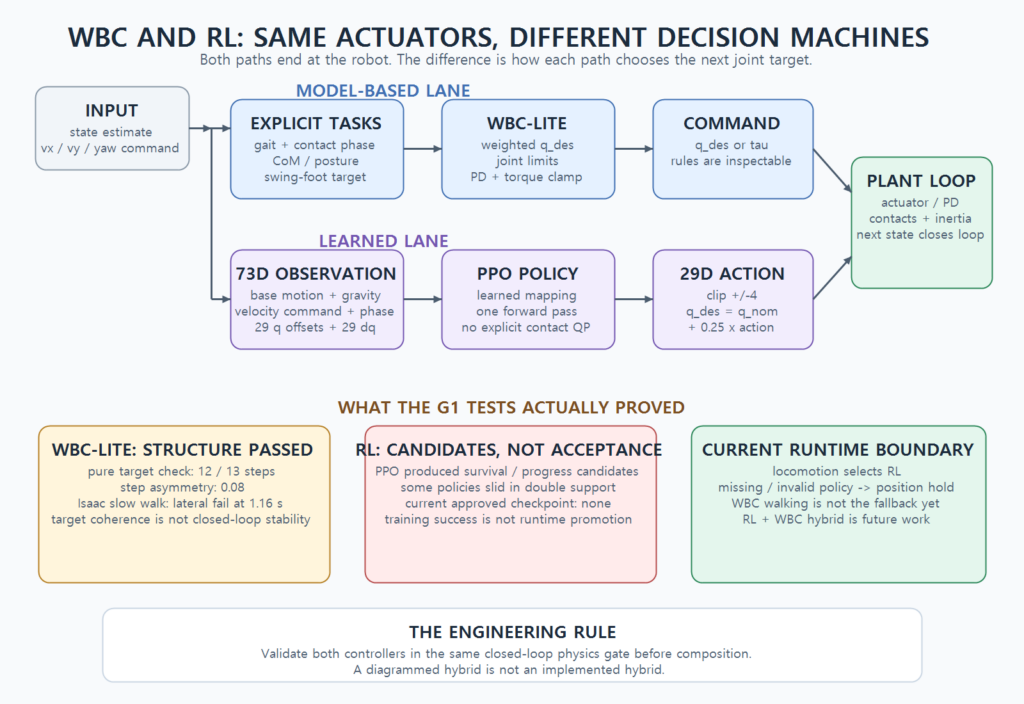
G1용 WBC-lite 보행 목표 생성기는 순수 Python 검사에서 왼발 12회, 오른발 13회의 교대 스텝을 만들었습니다. 스텝 수 비대칭은 0.08이었고, single

로봇 학습 코드를 정리하다가 흥미로운 비대칭을 발견했습니다. training/rl/에는 G1 보행을 학습하고 재생하고 평가하기 위한 코드와 실험별 검증 도구가 빽빽하게 쌓여