
팔을 덜 쓰게 보상했더니 로봇은 뒤로 걸었다 — 네 번의 reward 수정으로 본 보행 변화
네 번의 reward 변경에서 학습 점수와 생존 시간은 모두 올랐지만 전진 거리, 발 교차, 팔 사용량은 서로 다른 방향으로 움직였습니다. 학습 곡선과 고정 평가를 함께 보며 reward가 올라가도 원하는 보행이 보장되지 않는 이유를 정리합니다.
네 번의 reward 변경에서 학습 점수와 생존 시간은 모두 올랐지만 전진 거리, 발 교차, 팔 사용량은 서로 다른 방향으로 움직였습니다. 학습 곡선과 고정 평가를 함께 보며 reward가 올라가도 원하는 보행이 보장되지 않는 이유를 정리합니다.
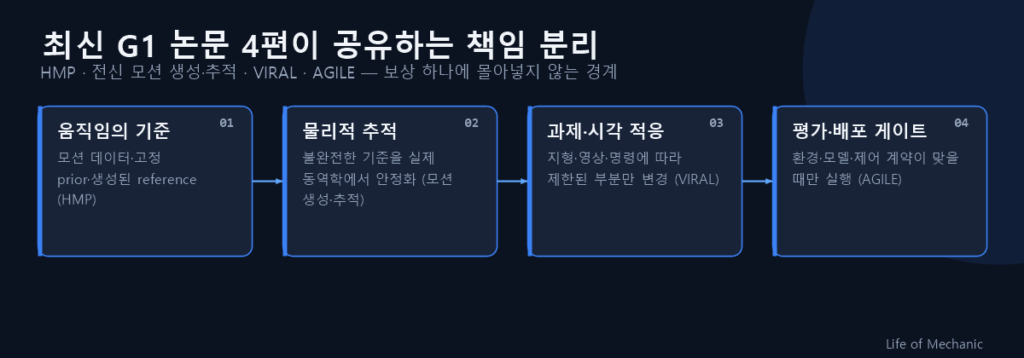
휴머노이드의 걸음이 마음에 들지 않을 때 보상 계수를 더 고치면 결국 원하는 움직임에 도달할 수 있을까요? 최근 G1 전신 제어

로봇이 원하는 대로 걷지 못할 때, 가장 먼저 해야 할 일은 보상을 바꾸거나 학습을 더 오래 돌리는 일일까요? 저도 한동안은
로봇에게 걷는 모습을 수천 장 보여 주는 방법만으로는, 미끄러질 때 어떻게 회복할지까지 가르치기 어렵습니다. 강화학습은 로봇이 직접 시도하고 그 결과에
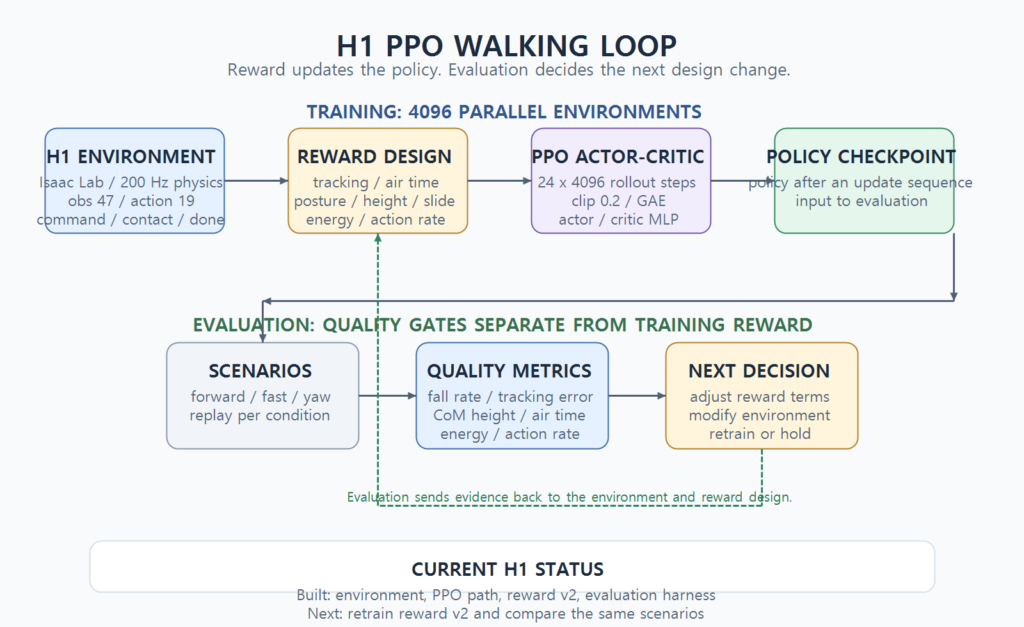
H1 보행에서 처음 얻은 체크포인트는 평균 episode length가 743까지 올라갔지만, 저는 그것을 자연 보행이라고 받아들이지 않았습니다. 넘어지지 않는 시간과 사람이
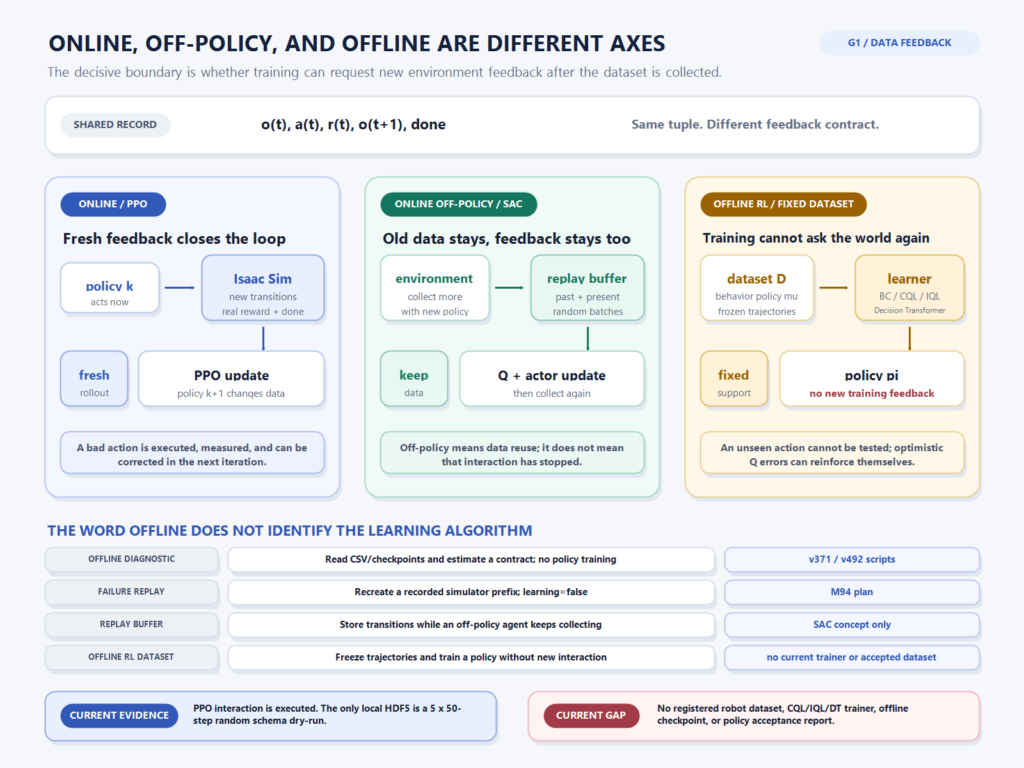
현재 G1 저장소에서 offline과 replay를 검색하면 이미 오프라인 강화학습을 구현한 것처럼 보이는 파일이 나옵니다. offline_control_authority_diagnostic는 checkpoint와 trace를 읽고 action 방향을
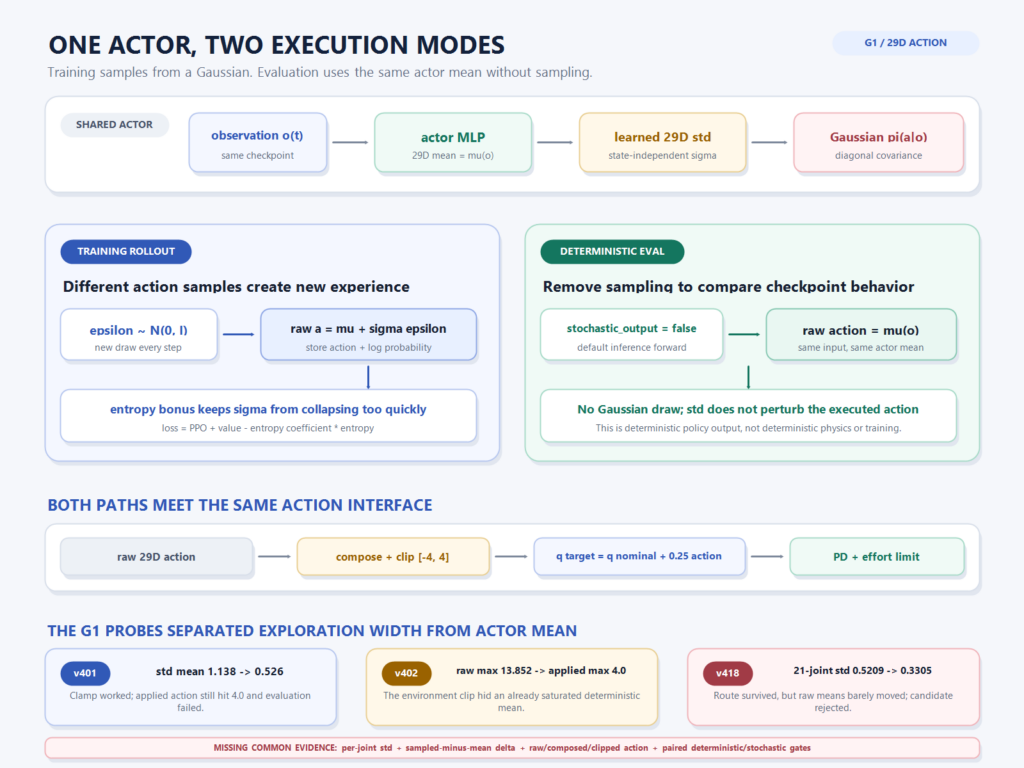
G1의 비정상적인 상체 동작이 큰 탐색 noise 때문인지 확인하려고 v401에서 actor의 standard deviation을 직접 줄였습니다. 전체 std 평균은 1.138에서 0.526으로,
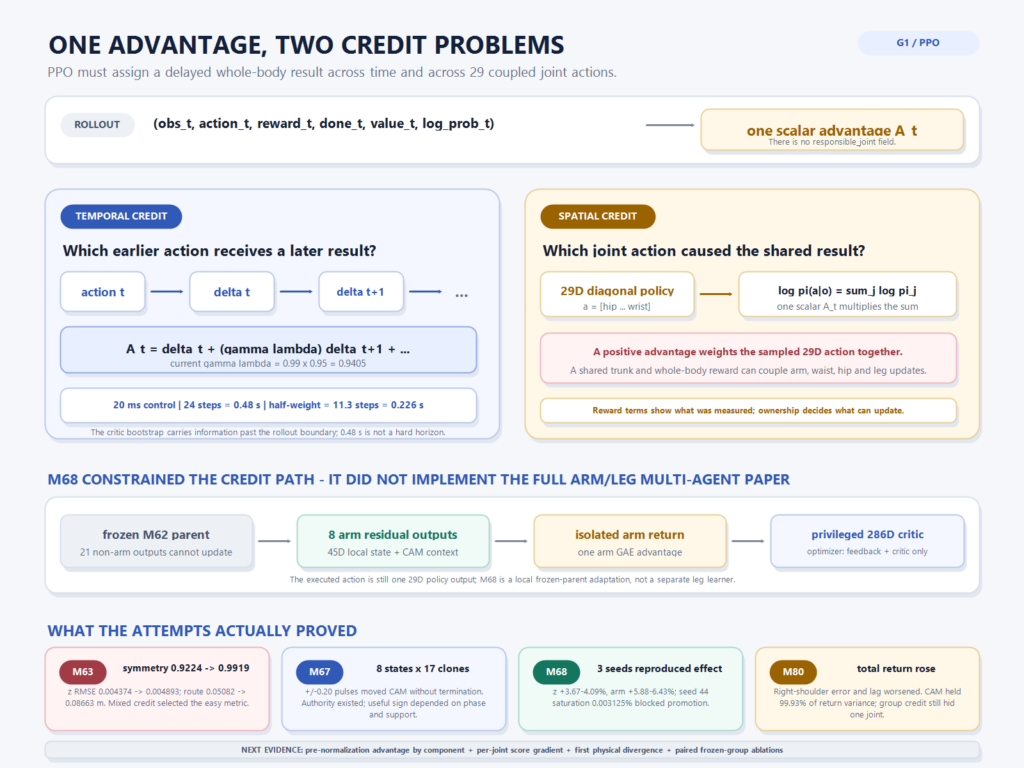
M79에서 오른쪽 어깨만 수정하는 phase head를 125회 PPO update로 학습했습니다. 4,096개 환경에서 1,228만8천 transition을 처리했고, 새 head의 출력은 최대 0.1122까지
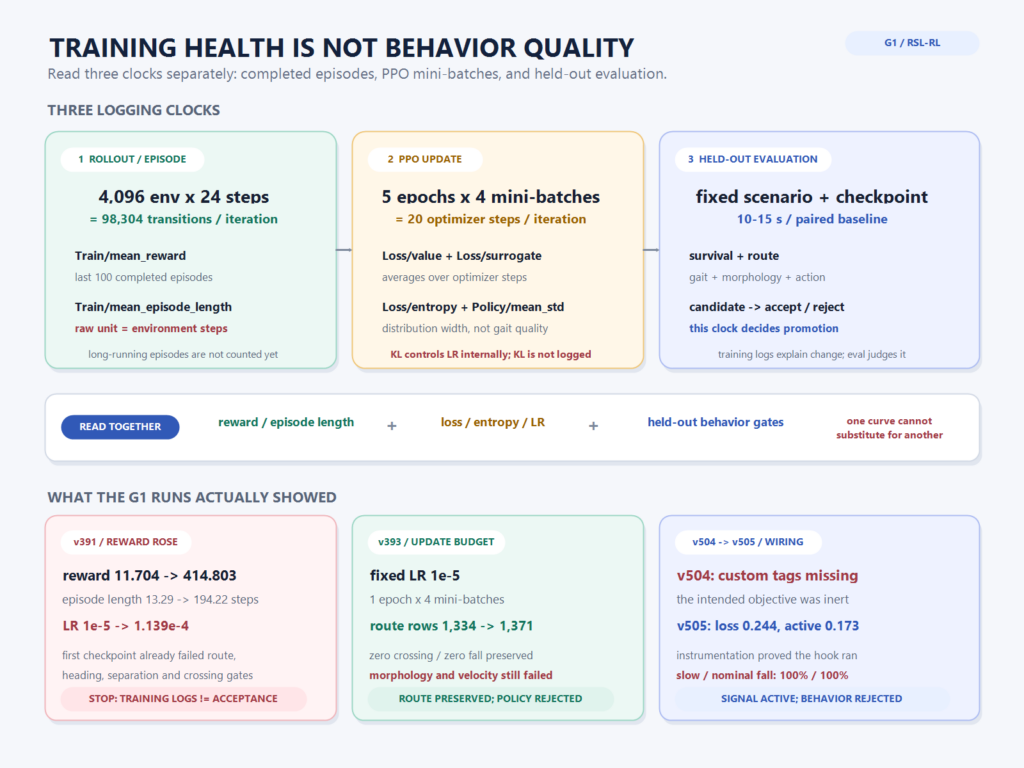
G1 v391 학습에서는 TensorBoard의 숫자만 보면 정책이 빠르게 좋아지는 것처럼 보였습니다. Train/mean_reward는 11.704에서 414.803으로 올랐고, Train/mean_episode_length도 13.29에서 194.22로 늘었습니다. adaptive
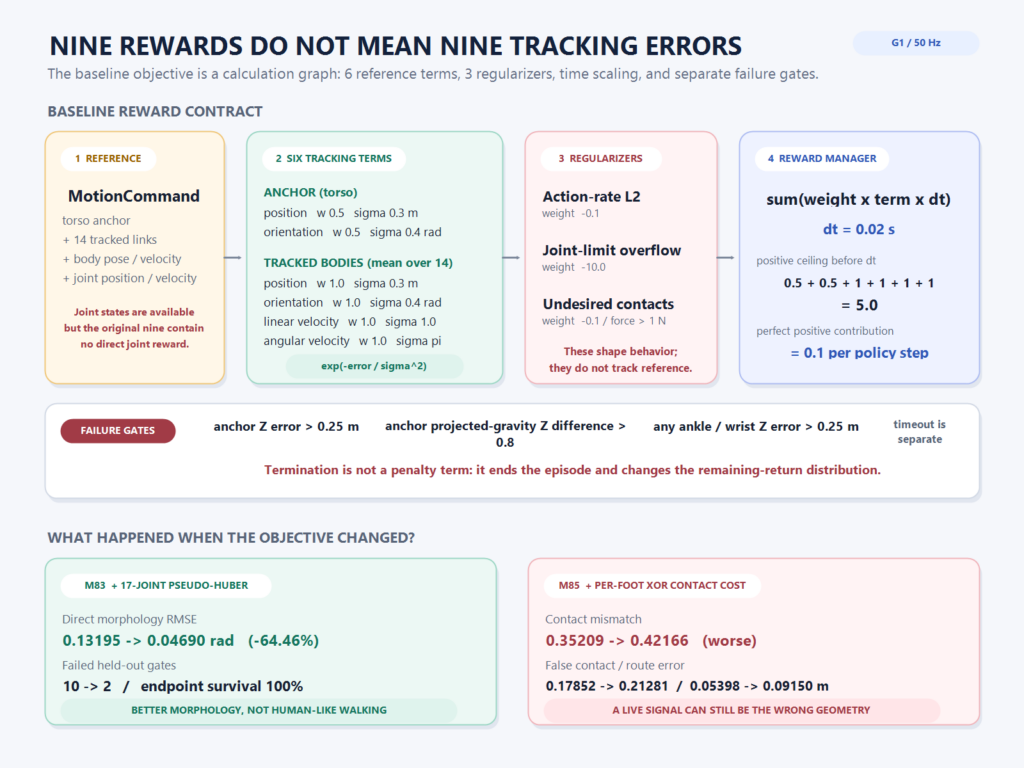
G1 모션 트래킹 정책을 처음 학습했을 때, 환경에는 이미 9개의 reward term이 있었습니다. 몸통의 위치와 자세, 여러 링크의 위치와 자세,