걷기는 풀렸다, 다음은 잡기다 — G1 양팔 매니퓰레이션에서 부딪힌 벽들 (계속)
G1이 걷는 데 성공한 뒤 다음 목표는 팔로 물건을 집는 일이었습니다. 그런데 로봇의 손에는 물건을 만질 수 있는 표면조차 없었습니다. 거기서부터 시작해 지금까지 부딪힌 문제와, 확정된 것과 아직 안 되는 것을 구분해 남긴 기록입니다.
G1이 걷는 데 성공한 뒤 다음 목표는 팔로 물건을 집는 일이었습니다. 그런데 로봇의 손에는 물건을 만질 수 있는 표면조차 없었습니다. 거기서부터 시작해 지금까지 부딪힌 문제와, 확정된 것과 아직 안 되는 것을 구분해 남긴 기록입니다.
로봇이 넘어지지 않고 앞으로 움직이면, 이제 “걷기에 성공했다”고 말해도 될까요? 3주 넘게 G1 보행 정책을 학습시키며 이 질문의 기준이 계속
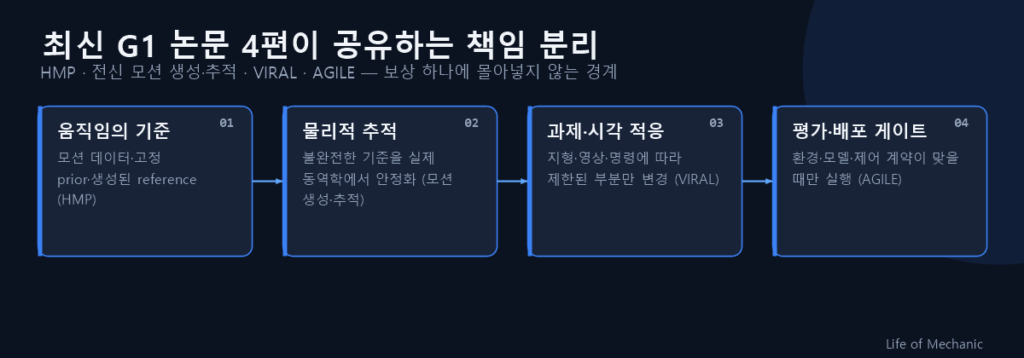
휴머노이드의 걸음이 마음에 들지 않을 때 보상 계수를 더 고치면 결국 원하는 움직임에 도달할 수 있을까요? 최근 G1 전신 제어
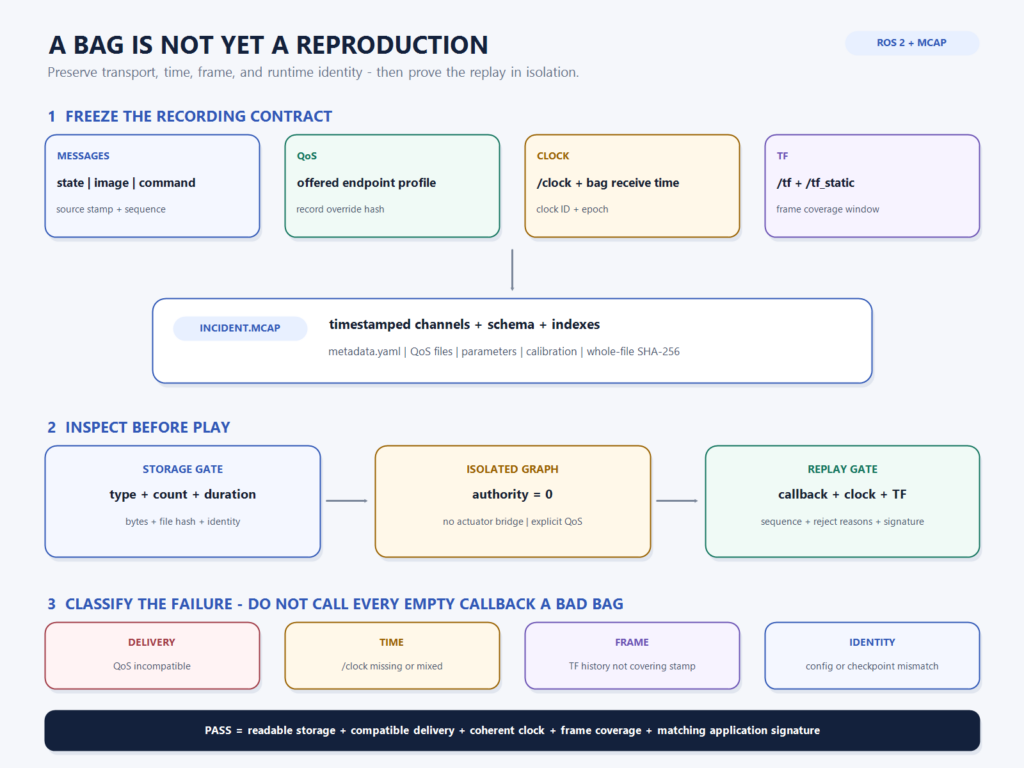
rosbag에 topic과 message count가 있어도 같은 실패가 재현되는 것은 아닙니다. QoS 호환성, /clock, /tf와 /tf_static, MCAP 무결성, 실행 identity를 하나의 재현 계약으로 묶고 authority-0 시험의 통과 기준을 정리합니다.
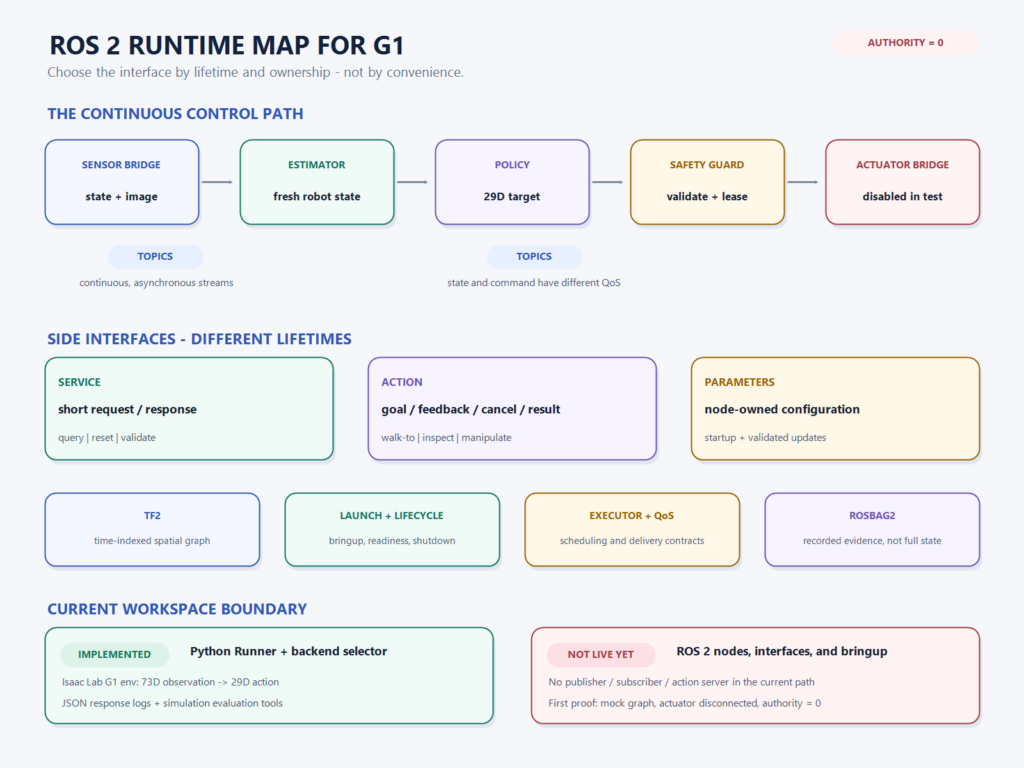
현재 G1의 73차원 관측→29차원 행동 경로와 아직 구현되지 않은 live ROS 2 graph를 구분하며 node·topic·service·action의 역할을 설명합니다.

현재 G1의 73차원 관측과 29차원 행동을 따라 forward, rollout, loss, backward, optimizer step, checkpoint의 차이를 설명합니다.
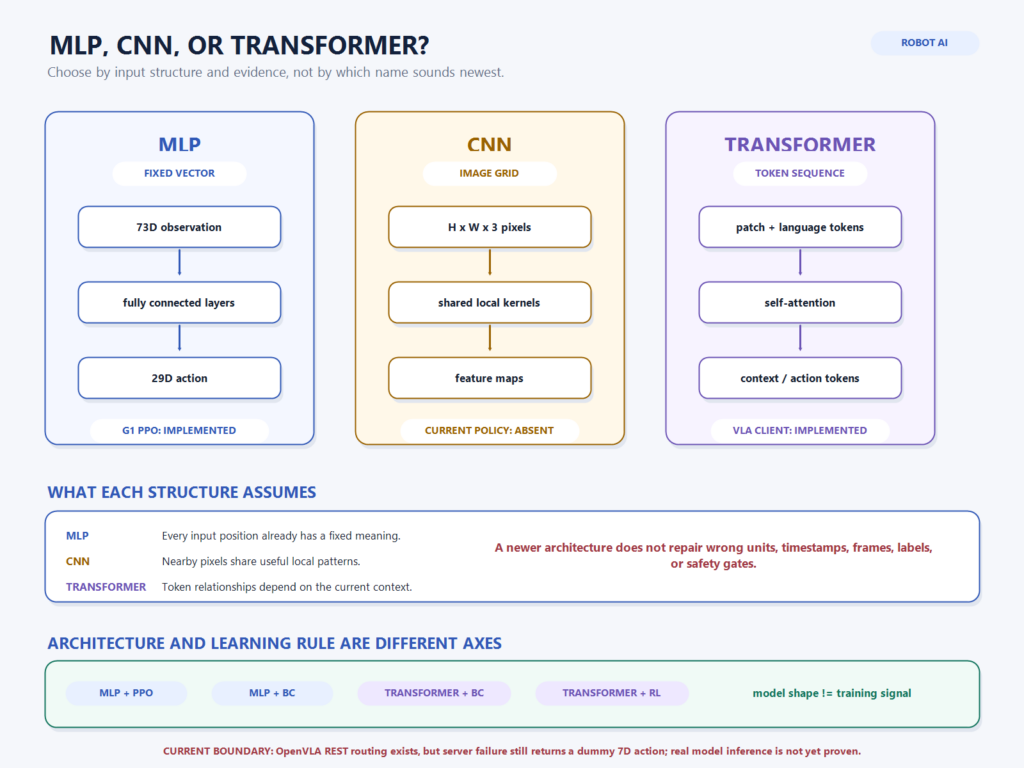
현재 G1의 73차원 MLP와 OpenVLA 경로를 기준으로 MLP·CNN·Transformer가 입력 구조를 어떻게 다르게 처리하는지 설명합니다.
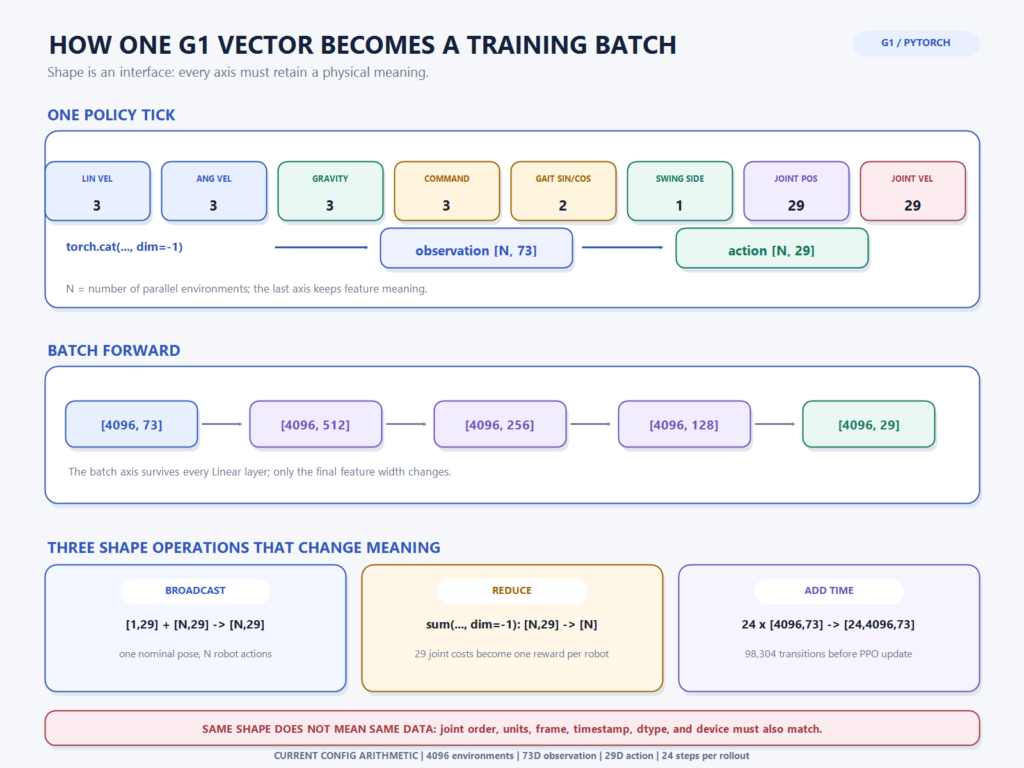
현재 G1의 73차원 관측과 4,096개 병렬 환경을 기준으로 tensor shape, batch, broadcasting, reduction, rollout의 의미와 흔한 축 오류를 설명합니다.
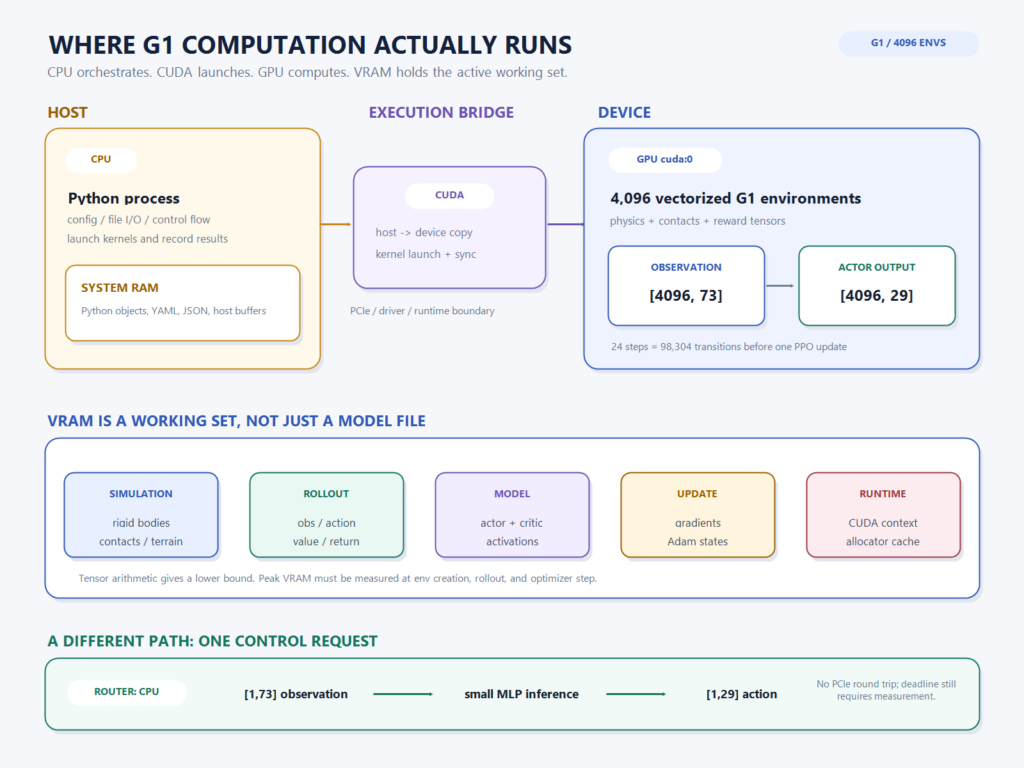
현재 G1의 GPU 학습 경로와 CPU 단일 추론 경로를 따라 CPU·GPU·CUDA·VRAM의 역할, 데이터 이동, 메모리 peak와 검증 경계를 설명합니다.

Epoch·iteration·step을 같은 학습 횟수로 비교하면 왜 틀리는지, 현재 Octo 모방학습과 G1 RSL-RL PPO 코드의 sample·batch·optimizer update 경계를 실제 설정값으로 계산해 정리합니다.