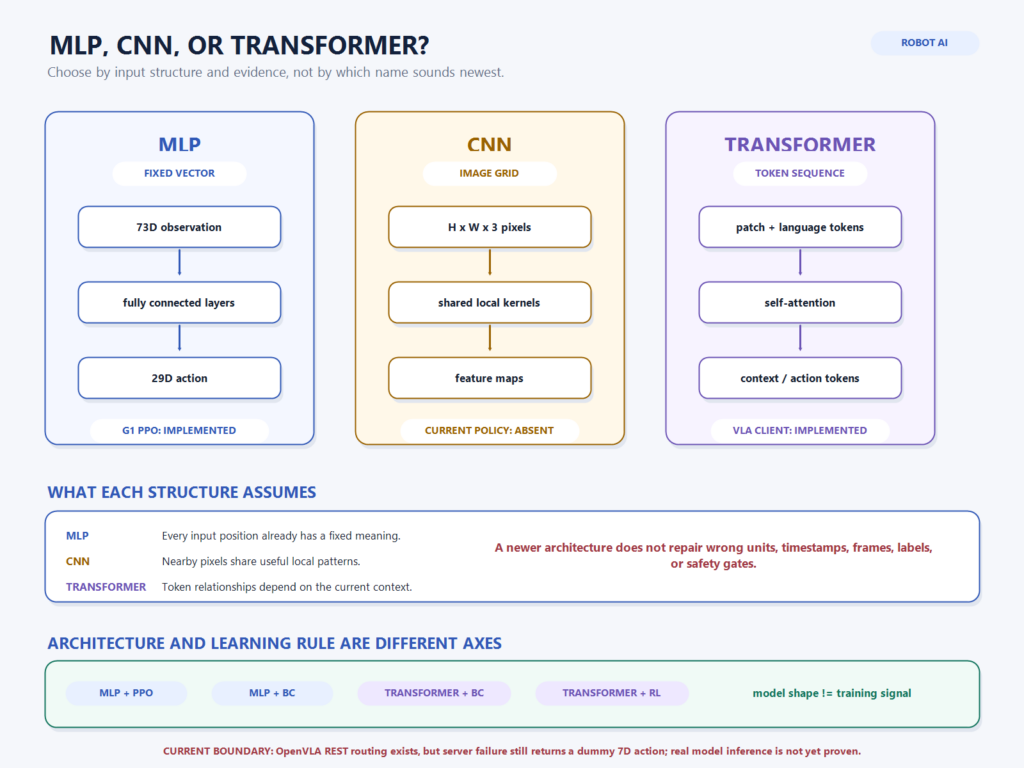
MLP·CNN·Transformer는 무엇이 다른가: G1 정책과 VLA로 읽는 AI 모델 구조
현재 G1의 73차원 MLP와 OpenVLA 경로를 기준으로 MLP·CNN·Transformer가 입력 구조를 어떻게 다르게 처리하는지 설명합니다.
현재 G1의 73차원 MLP와 OpenVLA 경로를 기준으로 MLP·CNN·Transformer가 입력 구조를 어떻게 다르게 처리하는지 설명합니다.

Epoch·iteration·step을 같은 학습 횟수로 비교하면 왜 틀리는지, 현재 Octo 모방학습과 G1 RSL-RL PPO 코드의 sample·batch·optimizer update 경계를 실제 설정값으로 계산해 정리합니다.
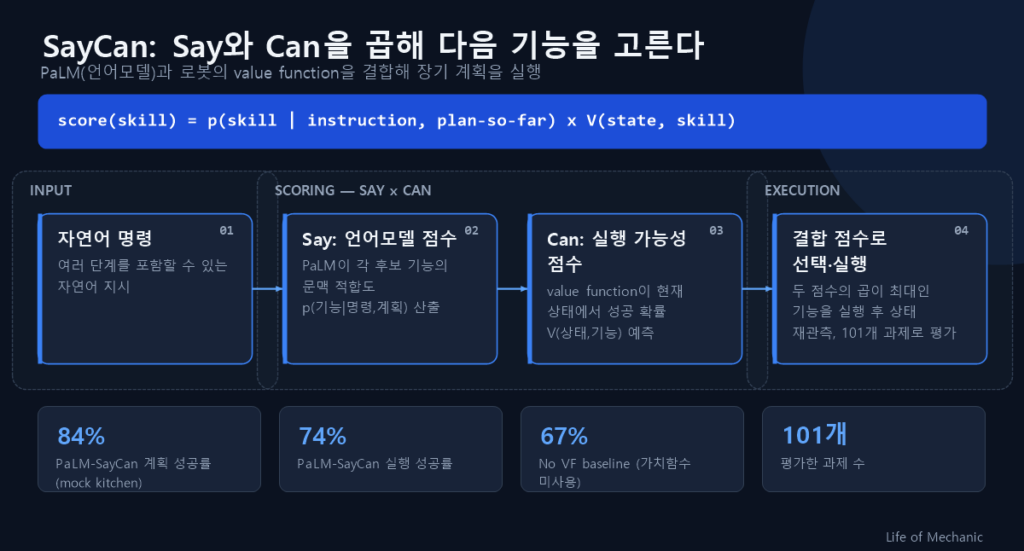
로봇에게 “정리해 줘”라고 말했을 때, 말의 뜻을 이해하는 것과 실제로 할 수 있는 동작을 고르는 것은 다른 문제입니다. 언어 모델은
인터넷에서 배운 ‘작다’, ‘가깝다’, ‘도구로 쓸 수 있다’ 같은 지식이 로봇의 손 움직임으로 이어질 수 있을까요. RT-2는 이 질문을 시각언어

자연어 명령을 로봇 행동으로 연결하는 논문을 읽을 때, 처음에는 SayCan과 RT-2를 같은 계열로 묶어 두었습니다. 둘 다 사람이 말한 목표를

finetune_octo.py –dry_run을 실행하면 마지막에 PASSED가 나옵니다. 합성 HDF5 네 개를 만들고, 각 episode에 30장의 카메라 영상과 14차원 robot state, 7차원
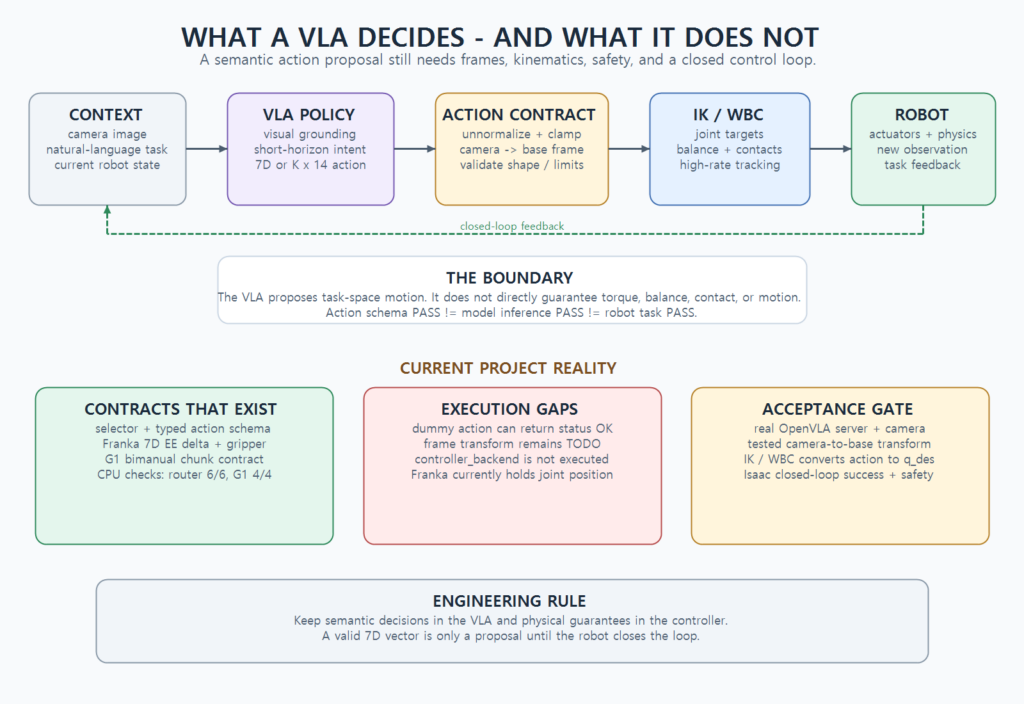
VLA 경로의 계약 테스트를 처음 돌렸을 때 결과는 6개 시나리오 모두 PASS였습니다. 그런데 테스트에 사용한 이미지 경로 중에는 실제 파일이
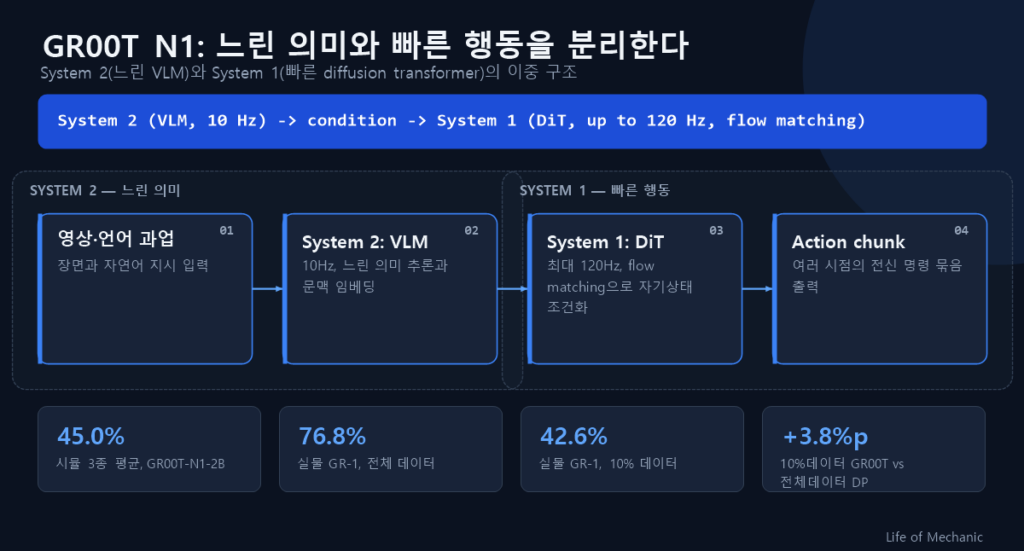
휴머노이드에게 필요한 것은 좋은 언어 이해일까요, 아니면 빠르고 안정적인 전신 동작일까요. GR00T N1은 이 질문을 둘 중 하나로 고르지 않고,
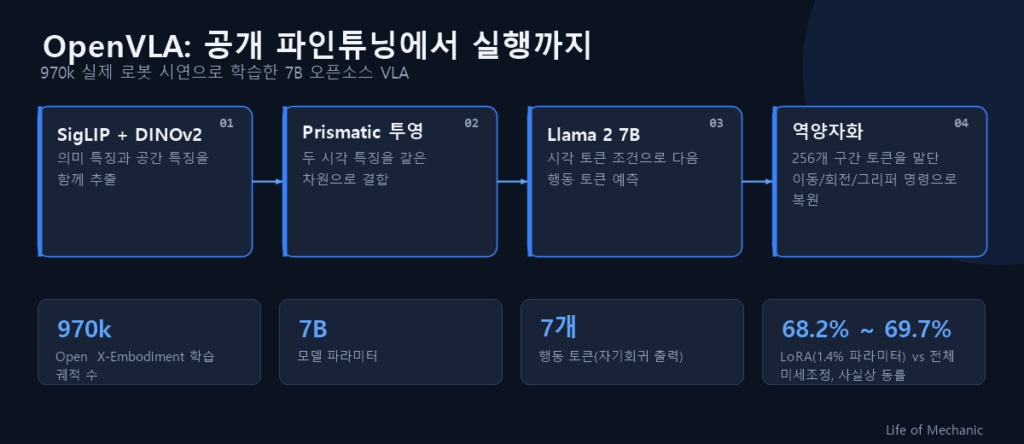
OpenVLA를 처음 보았을 때 제가 관심을 가진 이유는 ‘오픈소스 VLA’라는 이름보다, 공개된 모델을 새 로봇 과제에 맞게 적응시키려면 무엇이 필요한지
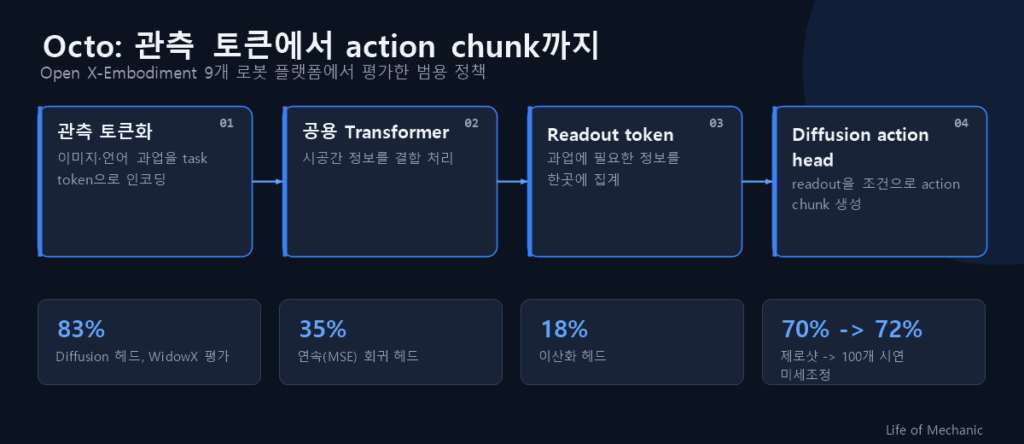
새 로봇 과제를 시작할 때, 처음부터 정책을 학습해야 할까요. Octo는 다양한 로봇 시연으로 미리 학습한 정책을 새로운 관측과 행동 공간에