왜 로봇 프로젝트는 데모보다 평가 기준을 먼저 만드는가
로봇이 몇 걸음 움직이는 장면을 보면, 사람은 먼저 “됐다”는 말을 하고 싶어집니다. 저 역시 보행 정책을 다룰 때 처음에는 넘어지지 […]

로봇이 몇 걸음 움직이는 장면을 보면, 사람은 먼저 “됐다”는 말을 하고 싶어집니다. 저 역시 보행 정책을 다룰 때 처음에는 넘어지지 […]

Epoch·iteration·step을 같은 학습 횟수로 비교하면 왜 틀리는지, 현재 Octo 모방학습과 G1 RSL-RL PPO 코드의 sample·batch·optimizer update 경계를 실제 설정값으로 계산해 정리합니다.
어제의 로봇 실험을 오늘 다시 열었을 때, 무엇이 같아야 “재현했다”고 말할 수 있을까요. 처음에는 같은 코드를 실행해 비슷한 결과가 나오면

로봇에게 “앞으로 걸어”라고 말하면, 실제로는 무엇이 그 말을 움직임으로 바꾸는 걸까요? 처음에는 언어를 이해하는 AI 모델 하나를 잘 고르면 될
화면 속 인공지능이 잘 답하는 것과 로봇이 실제로 움직이는 일은 무엇이 다를까요. 로봇은 말을 이해하는 것만으로는 물건을 집거나 균형을 잡을
집의 데스크톱에서 하던 로봇 작업을 노트북에서 이어야 할 때, 무엇을 먼저 가져가야 할까요. 처음에는 저장소만 최신 상태로 맞추면 충분하다고 생각했습니다.
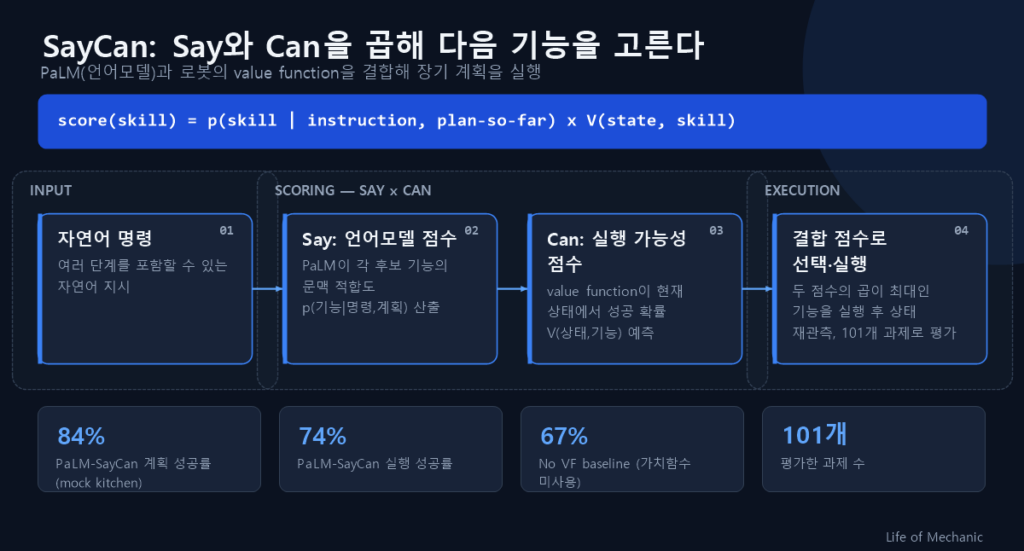
로봇에게 “정리해 줘”라고 말했을 때, 말의 뜻을 이해하는 것과 실제로 할 수 있는 동작을 고르는 것은 다른 문제입니다. 언어 모델은
로봇 연구에서 자주 나오는 ‘정책(policy)’은 무엇일까요. 처음에는 로봇에게 시킬 행동을 순서대로 적어 둔 목록이라고 생각하기 쉽습니다. 하지만 실제로 정책은 현재
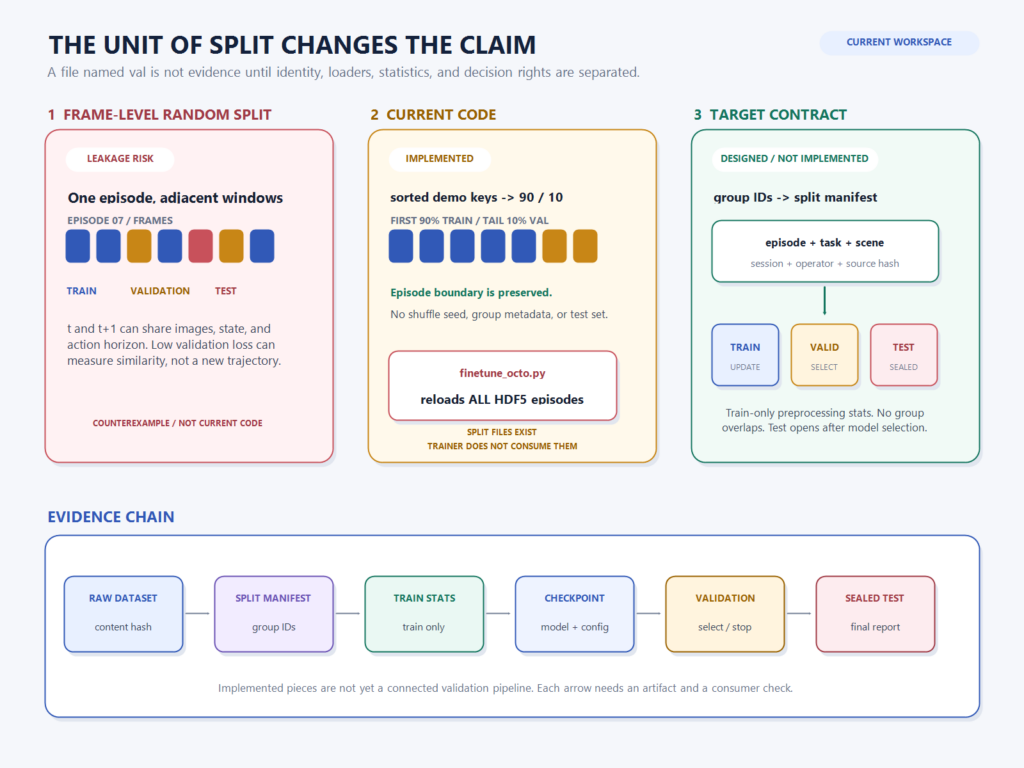
현재 로봇 데이터 변환기와 Octo fine-tuning 경로를 따라 train·validation·test의 역할, episode leakage, train-only 통계와 split manifest의 필요성을 설명합니다.
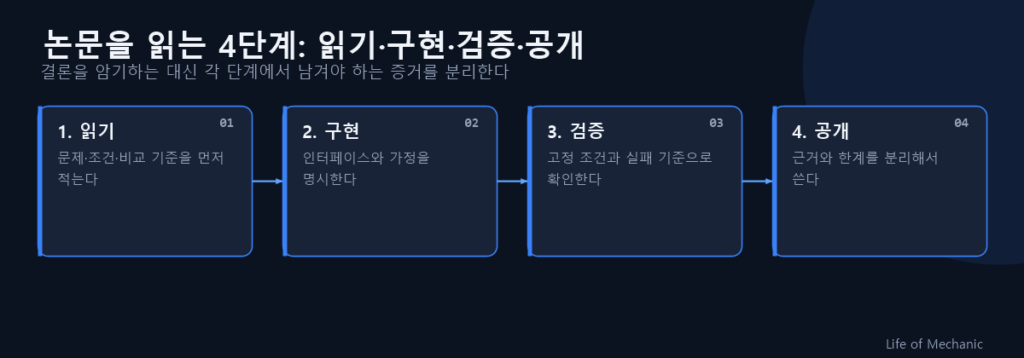
논문을 읽을 때 가장 먼저 봐야 하는 것은 무엇일까요. 예전에는 마지막 표에 적힌 성능 수치부터 찾았습니다. 그런데 숫자가 좋아 보여도