
Epoch·Iteration·Step은 무엇이 다른가: G1 PPO와 Octo 학습 횟수 읽는 법
Epoch·iteration·step을 같은 학습 횟수로 비교하면 왜 틀리는지, 현재 Octo 모방학습과 G1 RSL-RL PPO 코드의 sample·batch·optimizer update 경계를 실제 설정값으로 계산해 정리합니다.

Epoch·iteration·step을 같은 학습 횟수로 비교하면 왜 틀리는지, 현재 Octo 모방학습과 G1 RSL-RL PPO 코드의 sample·batch·optimizer update 경계를 실제 설정값으로 계산해 정리합니다.
로봇이 몇 걸음 움직이는 장면을 보면, 사람은 먼저 “됐다”는 말을 하고 싶어집니다. 저 역시 보행 정책을 다룰 때 처음에는 넘어지지

로봇에게 “앞으로 걸어”라고 말하면, 실제로는 무엇이 그 말을 움직임으로 바꾸는 걸까요? 처음에는 언어를 이해하는 AI 모델 하나를 잘 고르면 될

자연어 명령을 로봇 행동으로 연결하는 논문을 읽을 때, 처음에는 SayCan과 RT-2를 같은 계열로 묶어 두었습니다. 둘 다 사람이 말한 목표를

프로젝트를 기록하다 보면 “어차피 같은 로봇 작업인데 한곳에 모으면 되지 않을까”라는 생각이 듭니다. 저도 처음에는 설계 메모와 실험 결과, 다음

연구 과정을 글로 옮길 때 가장 어려운 일은 내용을 많이 쓰는 일이 아니었습니다. 아직 해 보지 않은 계획, 코드는 만들었지만
로보틱스 분야를 따라가다 보면 새 모델과 새로운 학습 방법이 거의 매달 나옵니다. 이름만 보면 지금 쓰는 도구를 곧바로 바꾸지 않으면
로봇 학습은 버튼을 누르고 오래 기다리면 저절로 좋아질까요? PPO는 시행착오를 반복하며 행동 정책을 다듬는 강화학습 방법이지만, 실제 작업에서 더 어려운
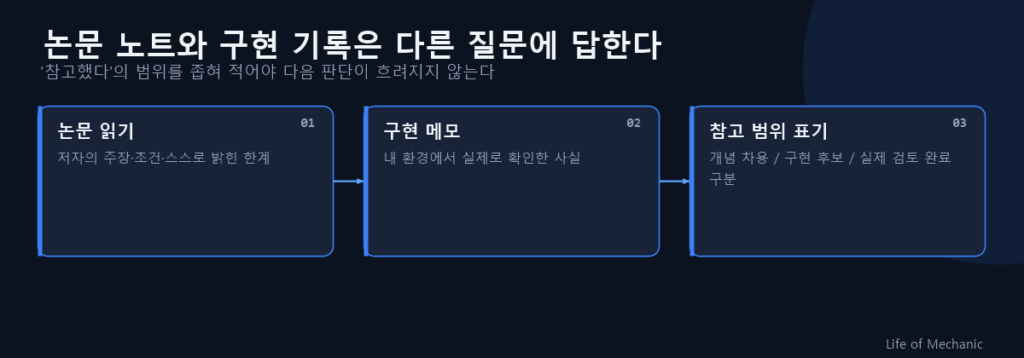
논문을 읽고 나면, 그 방법을 이미 이해한 것처럼 말하고 싶어질 때가 있습니다. 특히 로봇 분야에서는 그림 한 장과 데모 영상만으로도
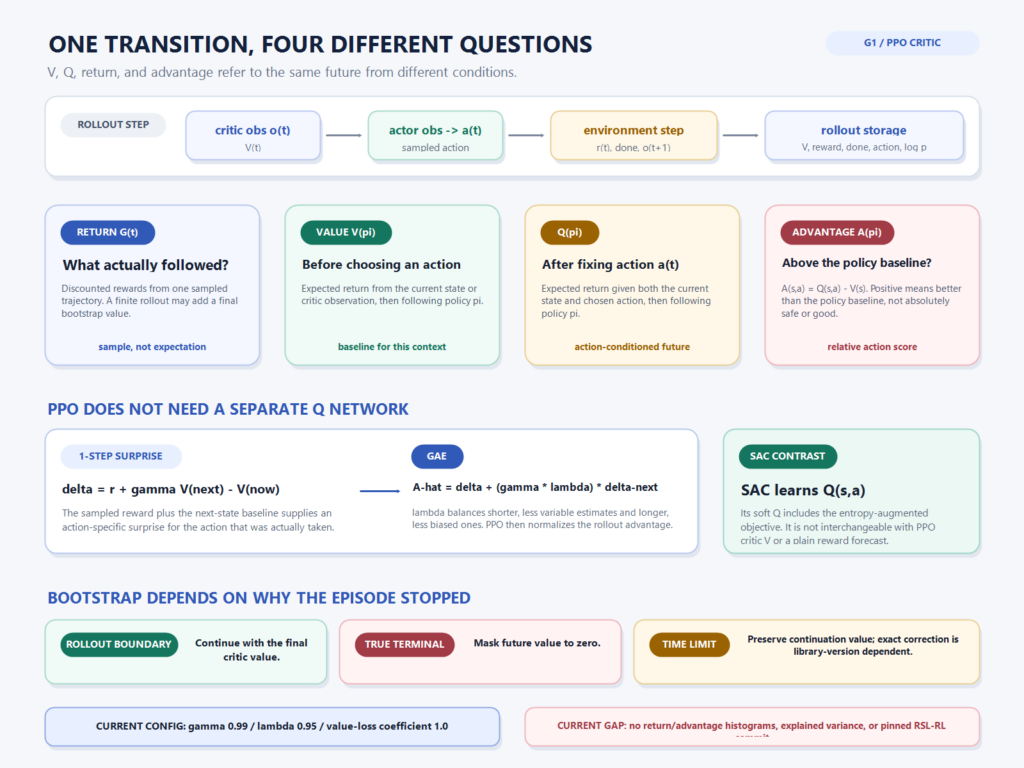
G1 학습 코드를 처음 따라가면서 이상했던 부분이 하나 있었습니다. PPO 설정에는 actor와 critic이 있고, critic의 은닉층 크기와 value loss 계수도