Git과 Obsidian으로 로컬 연구 워크스페이스 만들기 — 노트와 코드를 같은 시간축에 두는 법
논문 메모는 Obsidian에 있고 코드는 다른 폴더에 있다면, 몇 주 뒤에는 어떤 판단이 어느 구현으로 이어졌는지 찾기 어려워집니다. 저는 노트 […]

논문 메모는 Obsidian에 있고 코드는 다른 폴더에 있다면, 몇 주 뒤에는 어떤 판단이 어느 구현으로 이어졌는지 찾기 어려워집니다. 저는 노트 […]
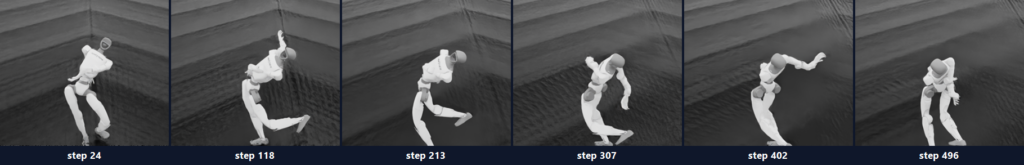
강화학습을 3주 넘게 돌렸는데도 휴머노이드가 제대로 걷지 못했다면, 단순히 학습 시간이 부족했던 걸까요? 저도 처음엔 더 오래 학습시키거나 보상 계수를
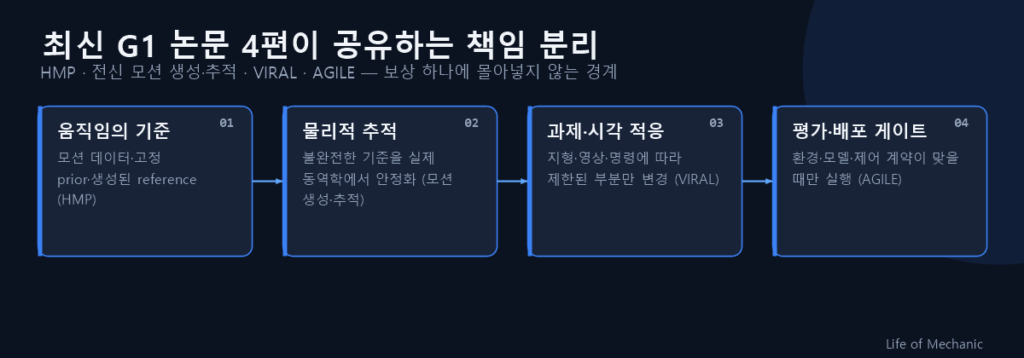
휴머노이드의 걸음이 마음에 들지 않을 때 보상 계수를 더 고치면 결국 원하는 움직임에 도달할 수 있을까요? 최근 G1 전신 제어
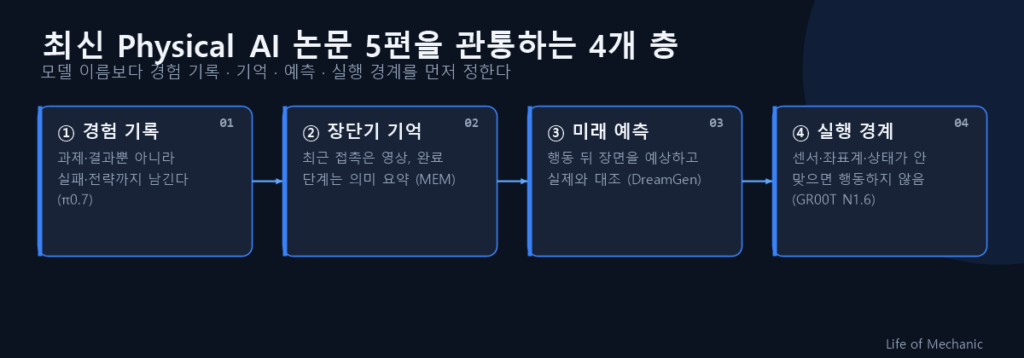
새로운 로봇 모델이 발표될 때마다 바로 설치해 보면 프로젝트가 더 빨리 나아갈까요? 최근 공개된 Physical AI 연구를 따라가면서 저도 처음에는

로봇이 원하는 대로 걷지 못할 때, 가장 먼저 해야 할 일은 보상을 바꾸거나 학습을 더 오래 돌리는 일일까요? 저도 한동안은
Physical AI, 자연어 명령, 시뮬레이션, 강화학습이라는 말을 한꺼번에 들으면 “그래서 이 프로젝트는 정확히 무엇을 만드는 건가?”라는 질문이 남습니다. 그 질문은
컴퓨터 안에서 잘 걷던 로봇이 실제 바닥에 내려오면 그대로 걸을 수 있을까요? 답은 “그럴 수도 있지만, 자동으로 그렇지는 않다”에 가깝습니다.
로봇을 배우게 하려면 꼭 실제 로봇을 사서 넘어뜨려 봐야 할까요? 실제 장비는 비싸고, 사람이나 장비가 다칠 위험도 있으며, 같은 조건을
로봇에게 걷는 모습을 수천 장 보여 주는 방법만으로는, 미끄러질 때 어떻게 회복할지까지 가르치기 어렵습니다. 강화학습은 로봇이 직접 시도하고 그 결과에
사람은 걷는 법을 의식하지 않아도, 미끄러운 바닥이나 계단 앞에서는 걸음걸이를 바꿉니다. 휴머노이드 로봇도 두 발로 서 있는 것만으로는 부족하고, 몸이