
모델 기반 강화학습과 모델 프리 강화학습은 무엇이 다른가: Isaac Sim이 있는데도 world model을 배우는 이유
현재 G1 PPO는 Isaac Sim에서 한 iteration마다 4,096개 환경 × 24 step, 총 98,304개의 transition을 만듭니다. 시뮬레이터는 action을 받은 로봇의 […]

현재 G1 PPO는 Isaac Sim에서 한 iteration마다 4,096개 환경 × 24 step, 총 98,304개의 transition을 만듭니다. 시뮬레이터는 action을 받은 로봇의 […]

현재 G1 기본 설정은 PPO iteration 하나를 위해 4,096개 환경에서 각각 24 step을 수집합니다. 한 번에 생기는 transition은 98,304개입니다. 이

G1 PPO의 seed 재현성을 확인하던 M68 실험에서는 seed 42·43·44가 모두 목표로 삼은 두 지표를 개선했습니다. vertical CAM z RMSE는 3.67~4.09%,
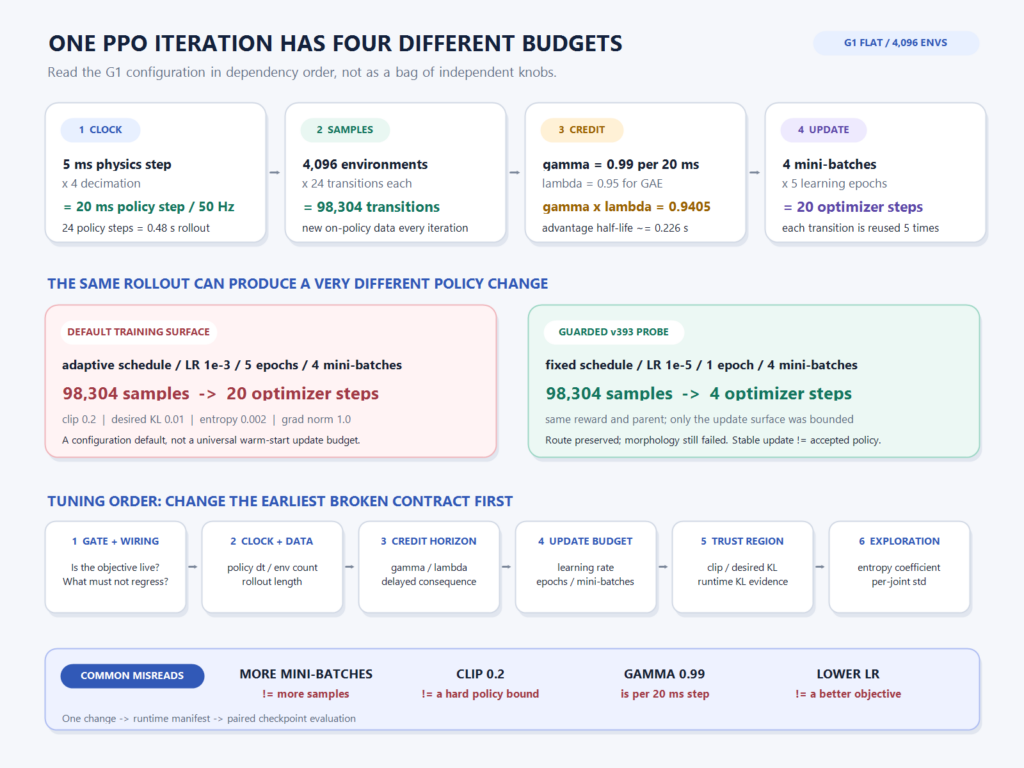
현재 G1 기본 설정은 한 번의 PPO iteration에서 98,304개의 transition을 모은 뒤 20번의 optimizer step을 수행합니다. 경로가 갑자기 무너지는 현상을
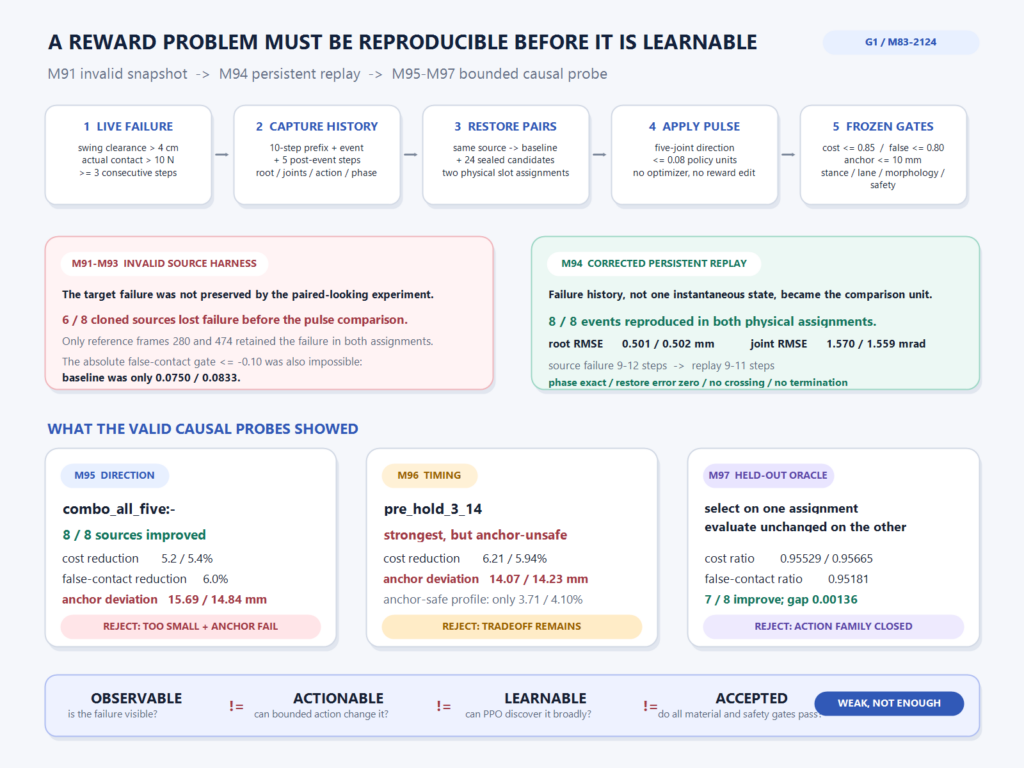
M95에서 다섯 관절에 작은 pulse를 넣자, 재현해 둔 여덟 개의 접촉 실패가 8개 모두 같은 방향으로 줄었습니다. 보통이라면 “유효한 방향을
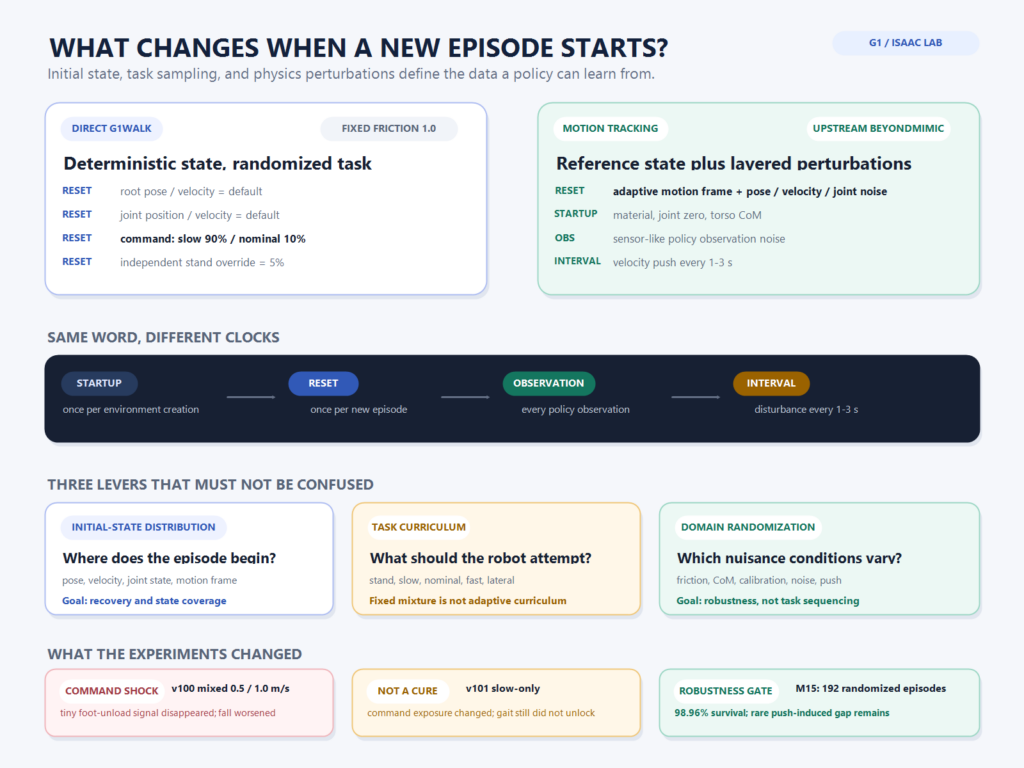
v99의 G1 정책은 아직 걷지 못했지만, nominal 명령에서 처음으로 아주 작은 single-support 신호를 만들었습니다. 두 발 중 하나가 떠 있던
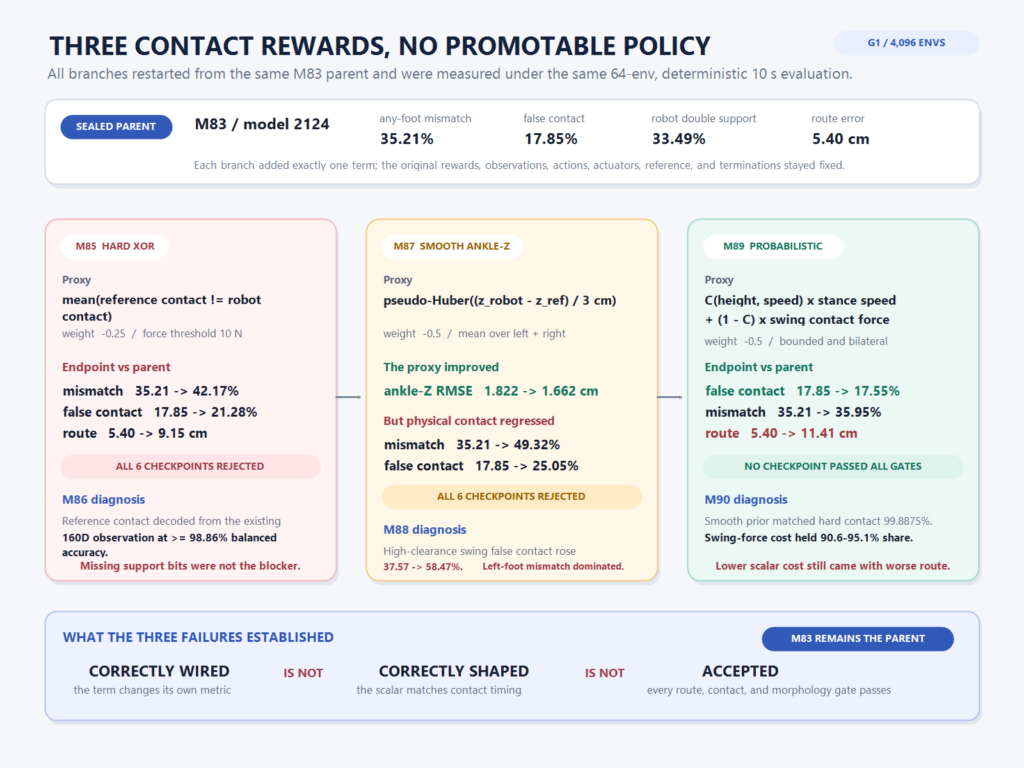
발목 높이 오차는 1.822cm에서 1.662cm로 줄었습니다. 제가 추가한 reward가 계산되고, PPO가 그 값을 실제로 최적화했다는 뜻이었습니다. 그런데 같은 정책의 false
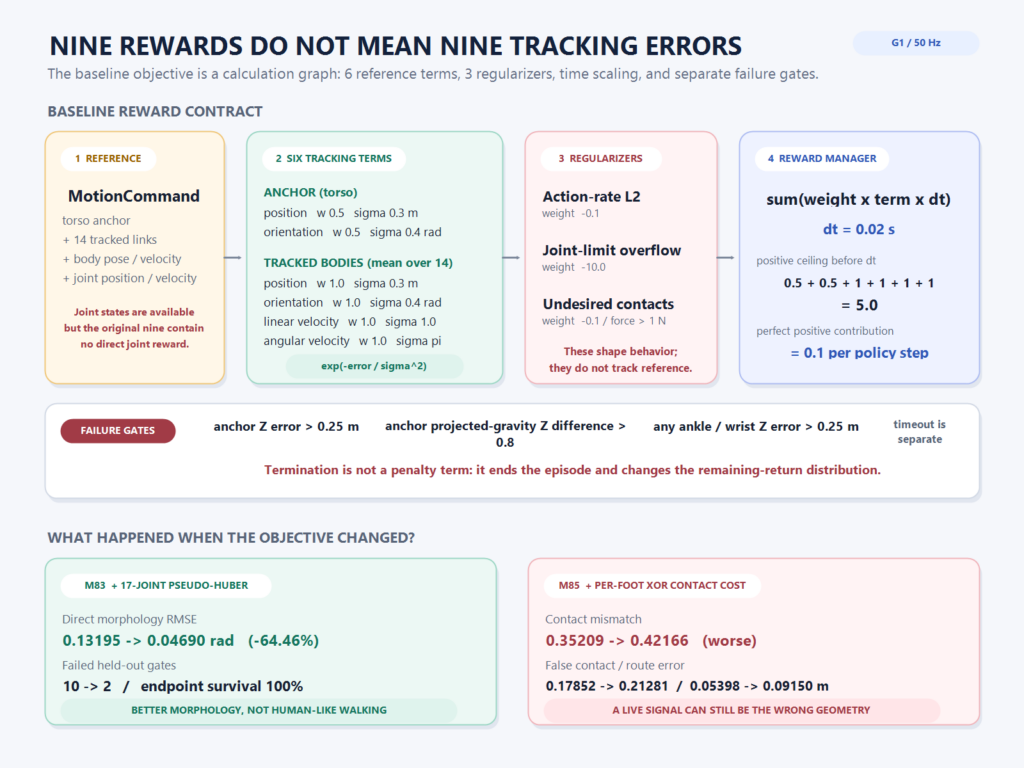
G1 모션 트래킹 정책을 처음 학습했을 때, 환경에는 이미 9개의 reward term이 있었습니다. 몸통의 위치와 자세, 여러 링크의 위치와 자세,
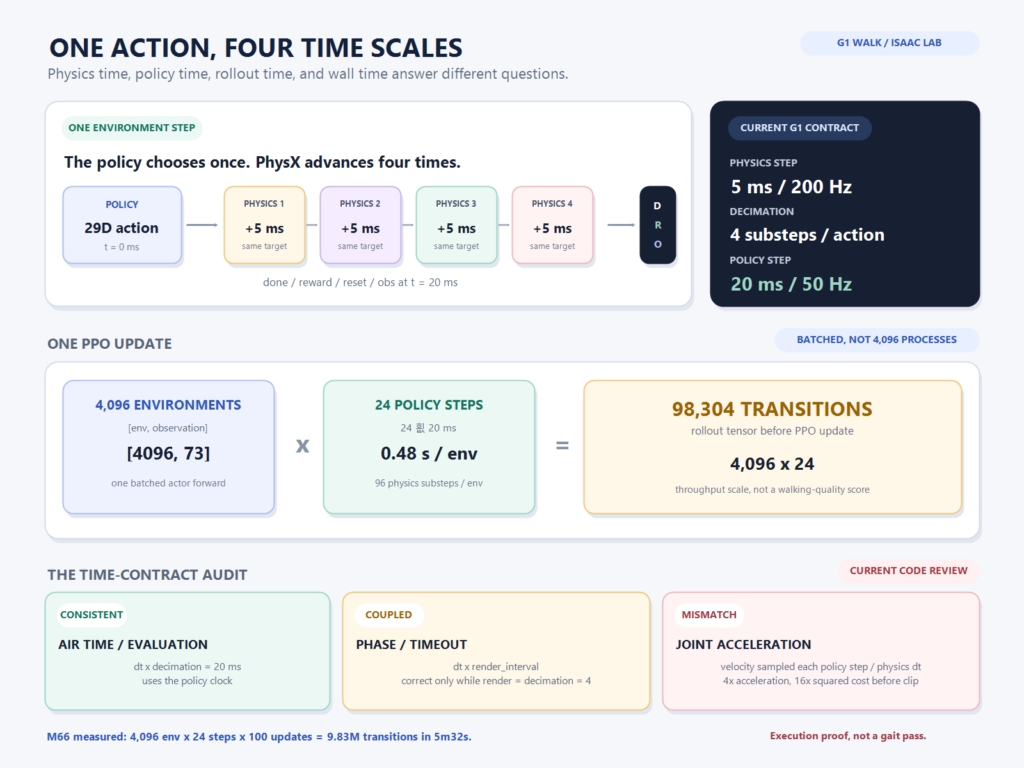
G1 motion-tracking 실험 M66은 4,096개 환경에서 PPO 100 update를 실행했습니다. 처리한 transition은 9,830,400개였고 wall-clock time은 5분 32초였습니다. 숫자만 보면 로봇
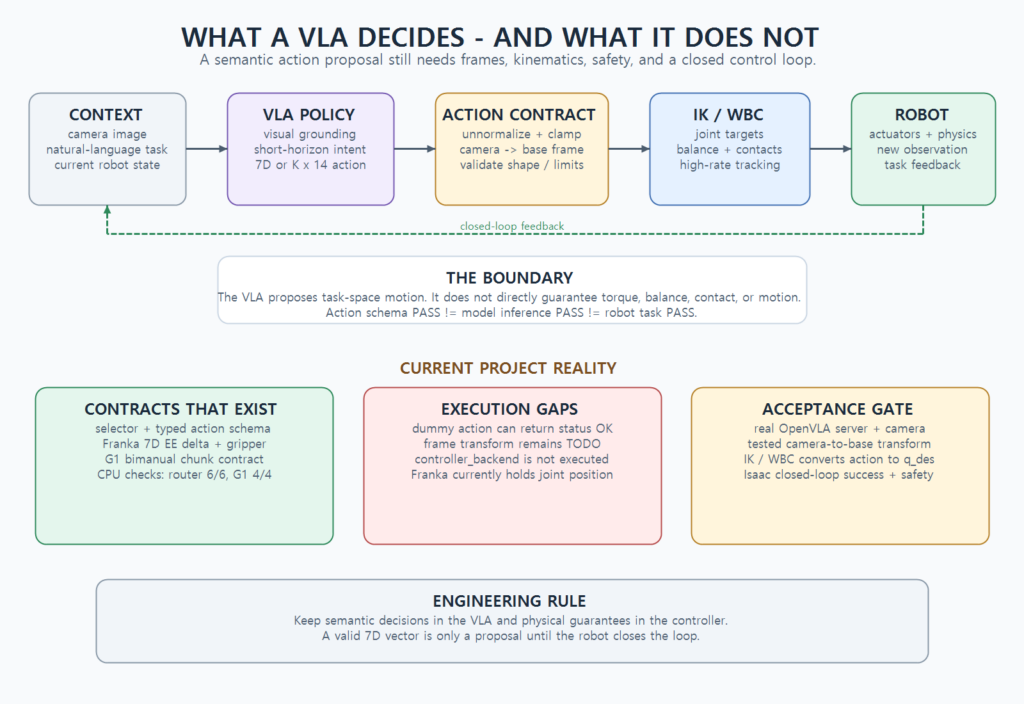
VLA 경로의 계약 테스트를 처음 돌렸을 때 결과는 6개 시나리오 모두 PASS였습니다. 그런데 테스트에 사용한 이미지 경로 중에는 실제 파일이