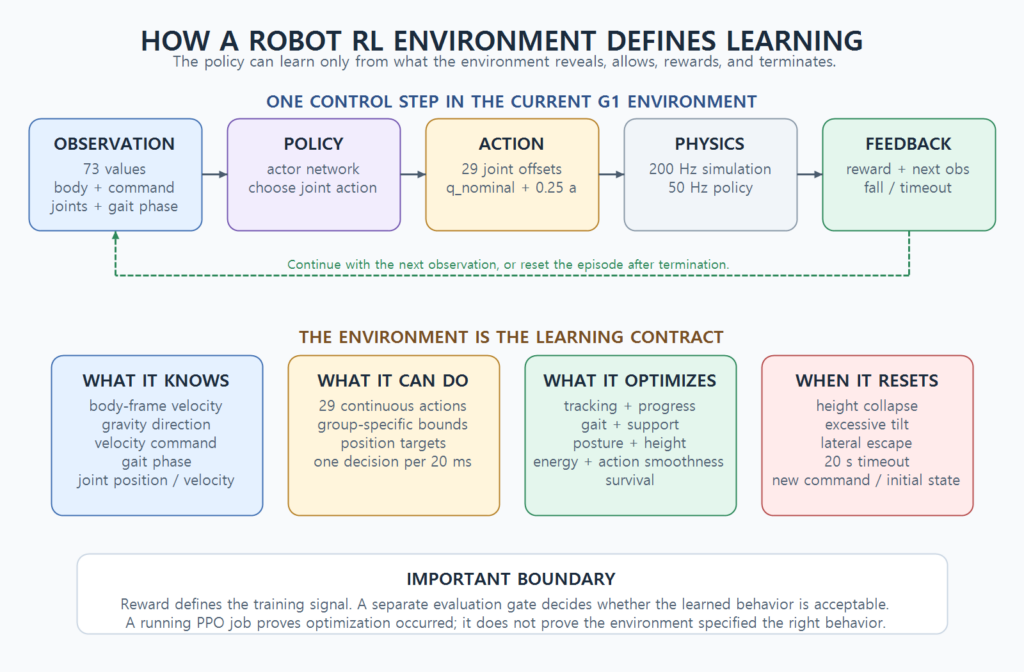
로봇 강화학습 환경 읽기 — G1의 관측·행동·보상
초기 G1 보행 환경에서는 발을 조금 들어도 공중 시간 보상이 음수가 되는 구간이 있었습니다. 정책은 발을 들지 않는 쪽으로 움직였습니다. […]

초기 G1 보행 환경에서는 발을 조금 들어도 공중 시간 보상이 음수가 되는 구간이 있었습니다. 정책은 발을 들지 않는 쪽으로 움직였습니다. […]
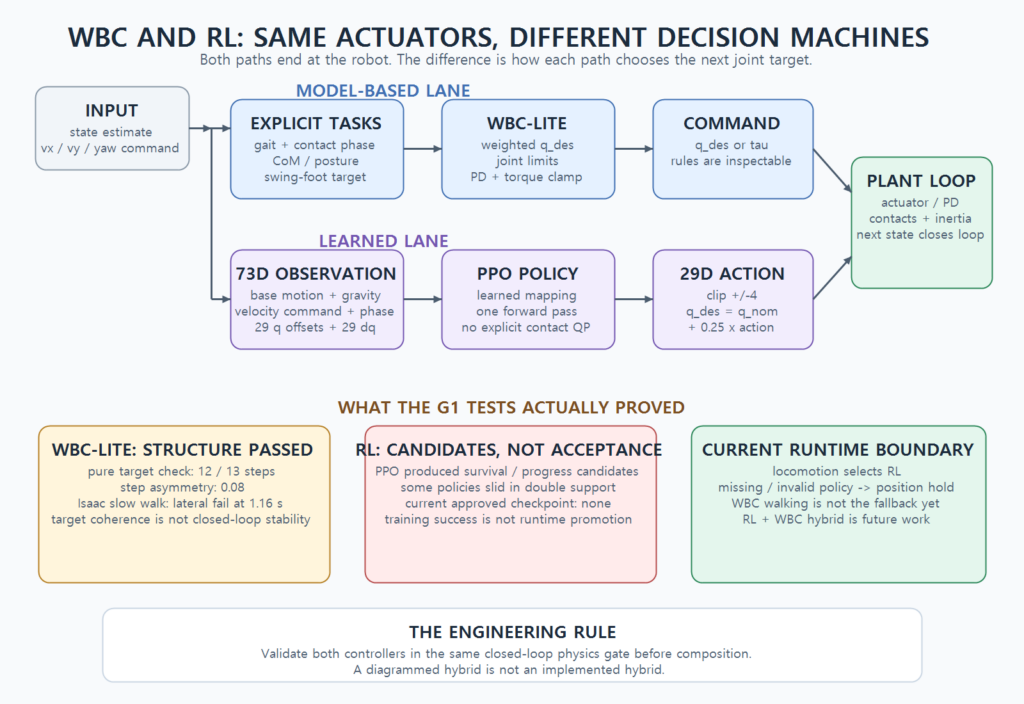
G1용 WBC-lite 보행 목표 생성기는 순수 Python 검사에서 왼발 12회, 오른발 13회의 교대 스텝을 만들었습니다. 스텝 수 비대칭은 0.08이었고, single
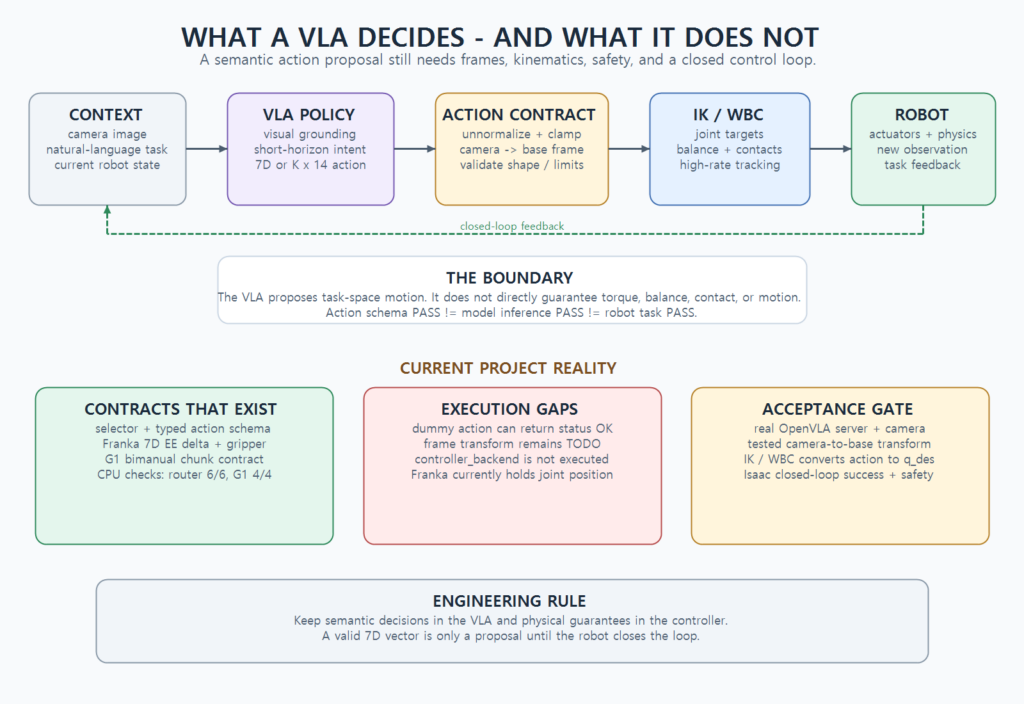
VLA 경로의 계약 테스트를 처음 돌렸을 때 결과는 6개 시나리오 모두 PASS였습니다. 그런데 테스트에 사용한 이미지 경로 중에는 실제 파일이
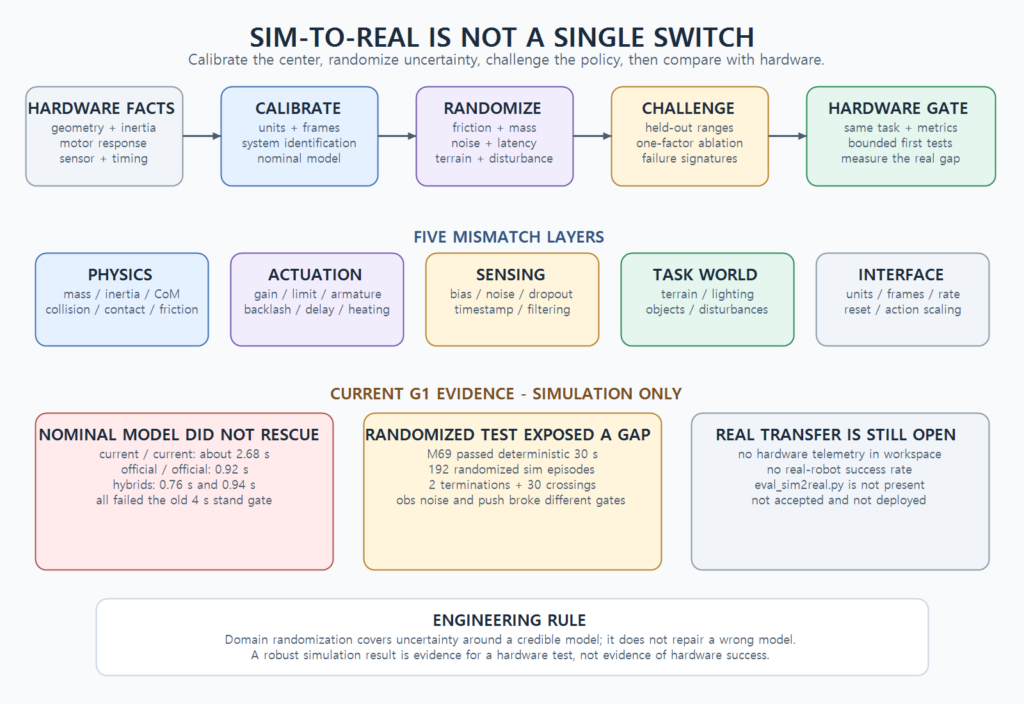
G1의 자체 변환 USD와 자체 actuator 설정을 사용했을 때 zero policy는 평균 약 2.68초 뒤 무너졌습니다. 정책 action을 모두 0으로

로봇 학습 코드를 정리하다가 흥미로운 비대칭을 발견했습니다. training/rl/에는 G1 보행을 학습하고 재생하고 평가하기 위한 코드와 실험별 검증 도구가 빽빽하게 쌓여
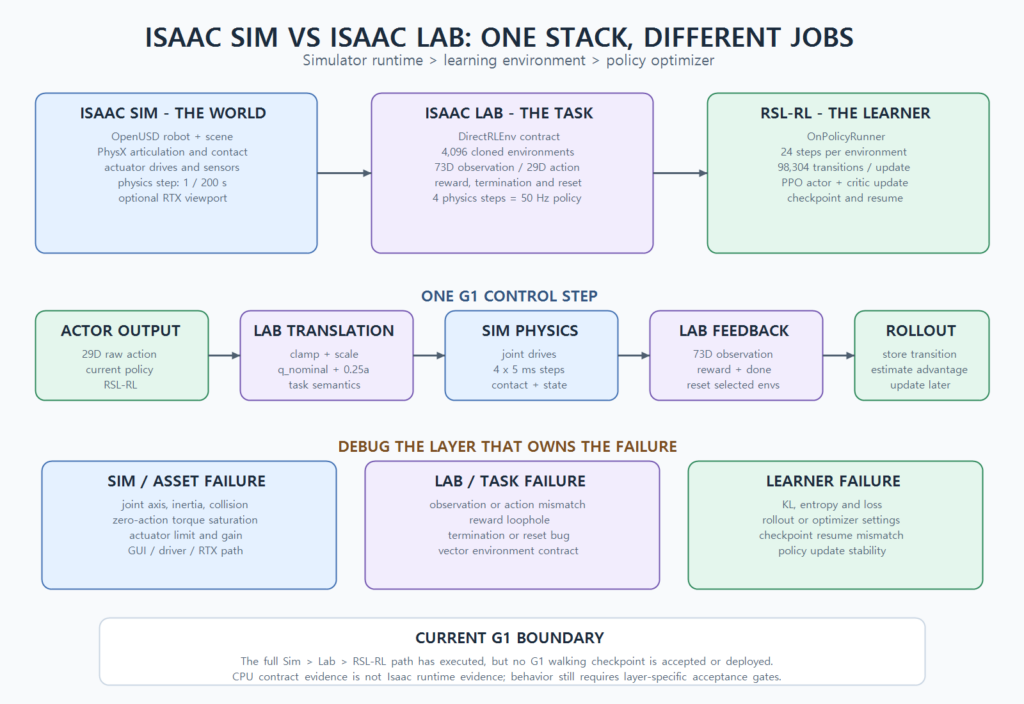
training/rl/train.py의 시작 부분을 보면 Isaac Sim과 Isaac Lab의 관계가 드러납니다. 스크립트는 먼저 AppLauncher로 simulation app을 띄웁니다. 그 다음에야 Gym 환경과

finetune_octo.py –dry_run을 실행하면 마지막에 PASSED가 나옵니다. 합성 HDF5 네 개를 만들고, 각 episode에 30장의 카메라 영상과 14차원 robot state, 7차원
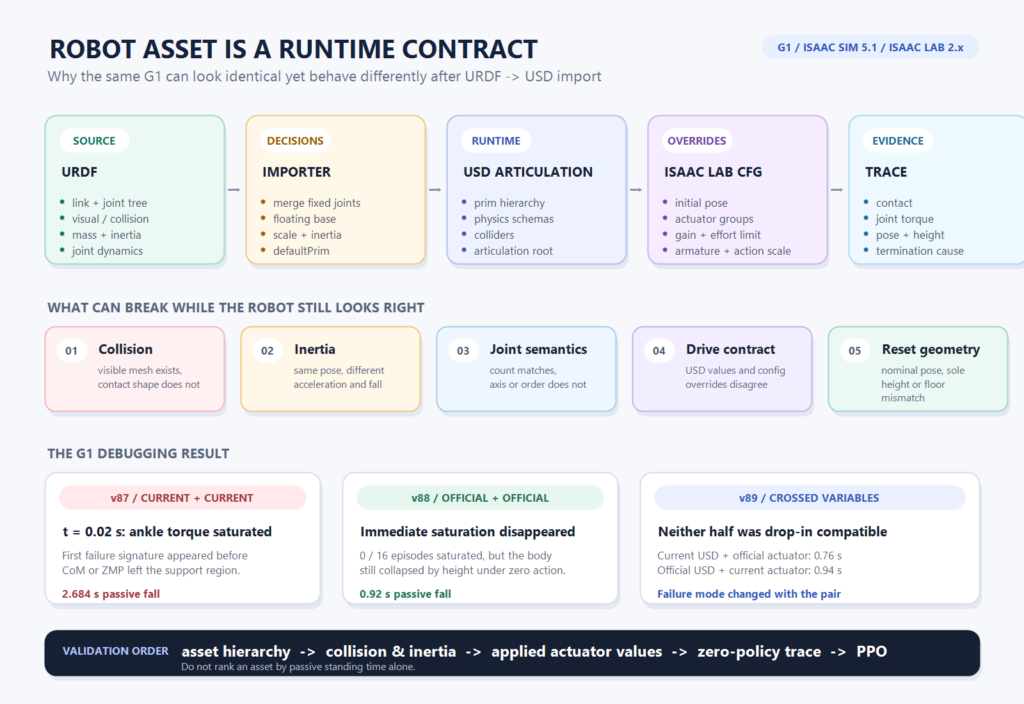
G1에 아무 행동도 주지 않은 zero-policy 검사에서, 양쪽 발목 토크는 시작 후 0.02초 만에 한계에 도달했습니다. 몸의 무게중심이나 ZMP가 지지
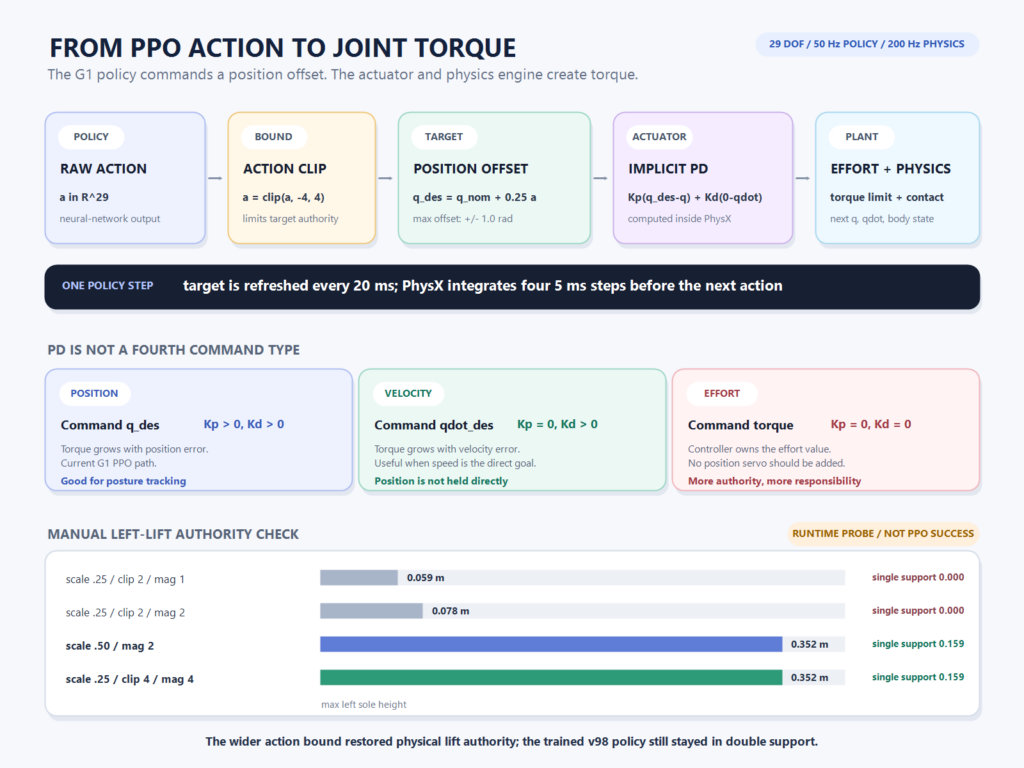
G1 PPO 실험에서 정책은 한동안 두 발을 바닥에 붙인 채 움직였습니다. reward를 여러 차례 바꿔도 single_support는 0이었습니다. 정책이 발을 들기
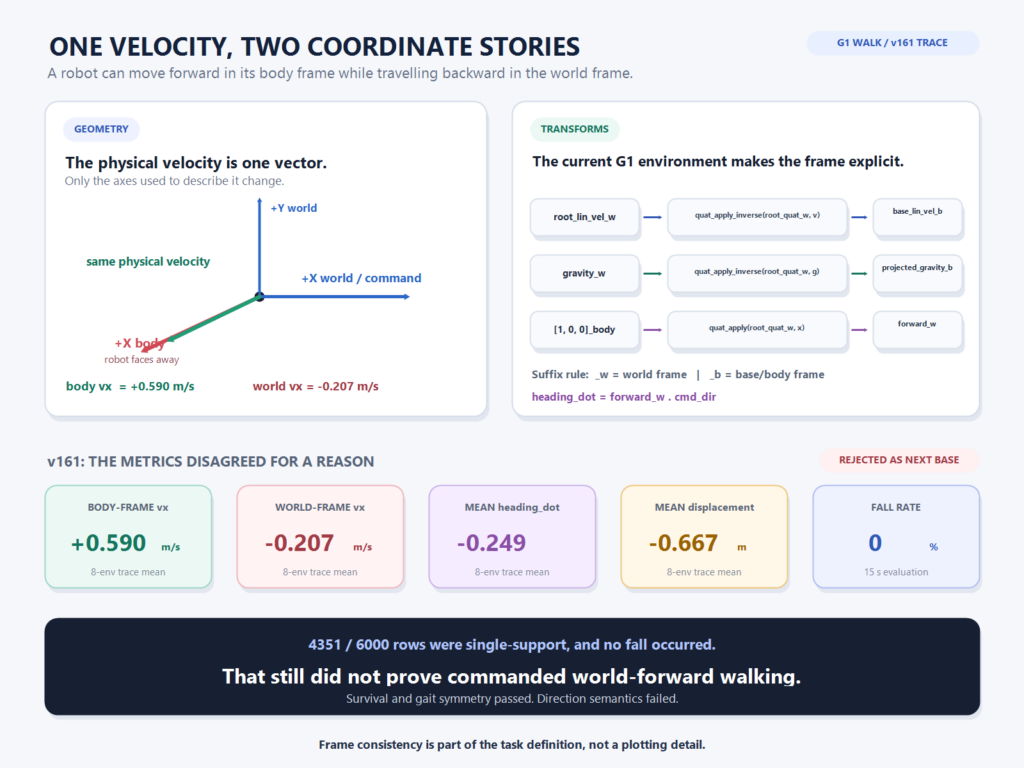
G1 PPO 보행 실험 v161의 15초 trace를 정리하다가 서로 양립하기 어려워 보이는 숫자를 만났습니다. 로봇 기준 전진 속도는 평균 +0.590m/s였는데,