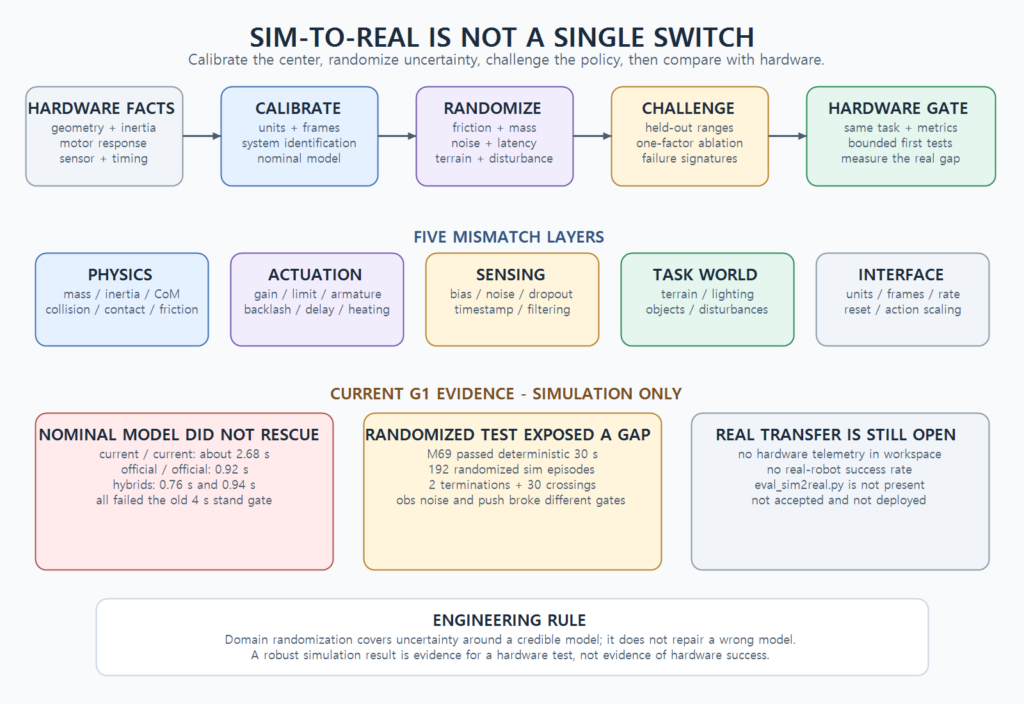
Sim-to-real은 무엇을 맞추는가 — G1 시뮬레이션이 현실이 되기 전 필요한 검증
G1의 자체 변환 USD와 자체 actuator 설정을 사용했을 때 zero policy는 평균 약 2.68초 뒤 무너졌습니다. 정책 action을 모두 0으로 […]

G1의 자체 변환 USD와 자체 actuator 설정을 사용했을 때 zero policy는 평균 약 2.68초 뒤 무너졌습니다. 정책 action을 모두 0으로 […]
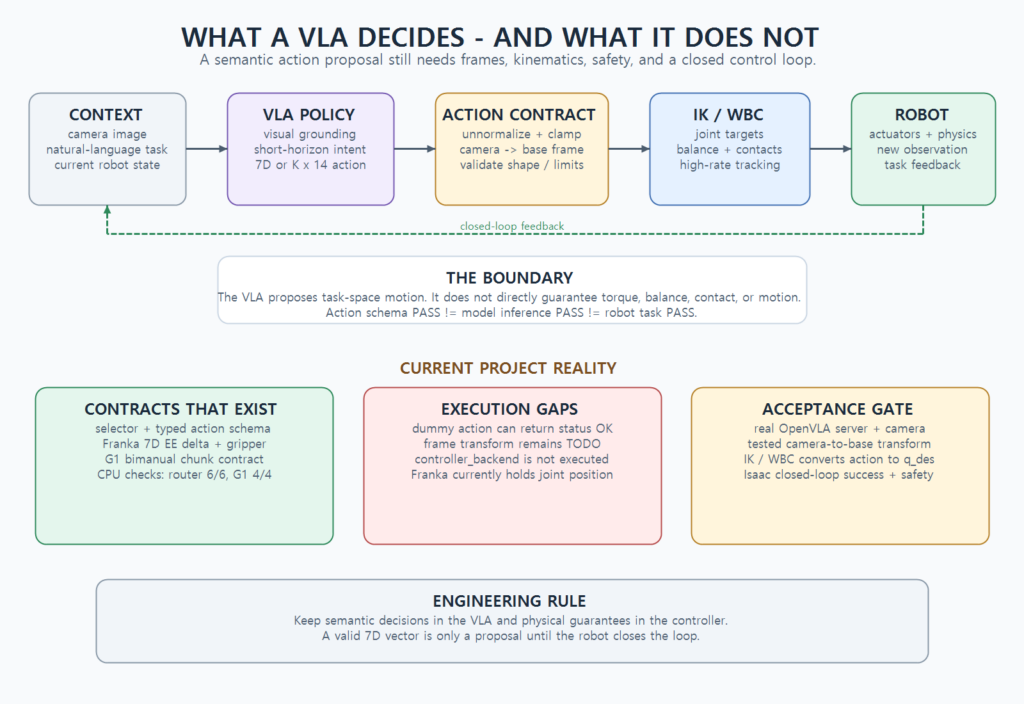
VLA 경로의 계약 테스트를 처음 돌렸을 때 결과는 6개 시나리오 모두 PASS였습니다. 그런데 테스트에 사용한 이미지 경로 중에는 실제 파일이
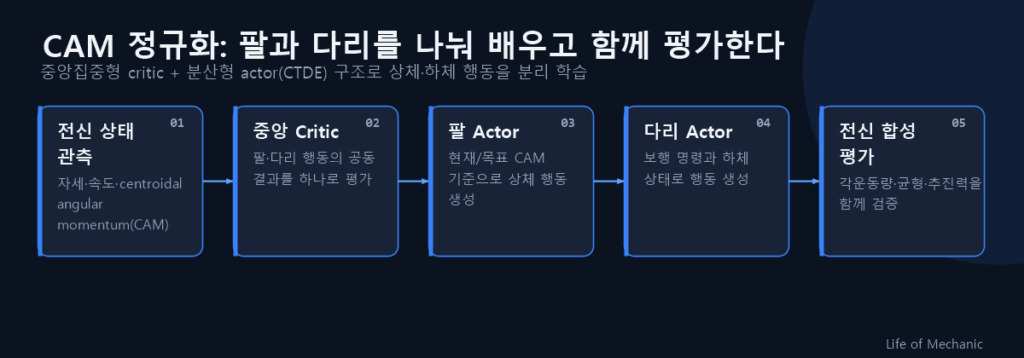
보행 중 팔 흔들기는 보기 좋은 동작을 위한 장식일까요, 아니면 균형 제어의 일부일까요. Learning Humanoid Arm Motion via Centroidal Momentum
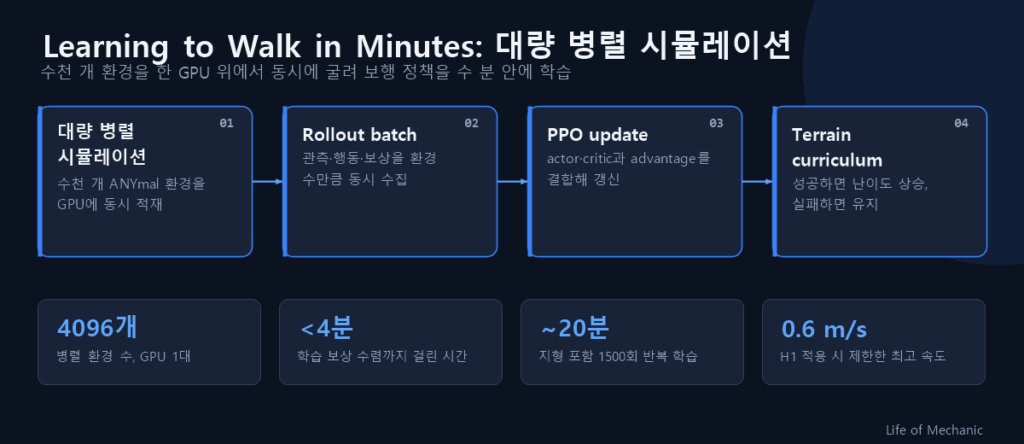
보행 정책을 빨리 학습했다는 말은 매력적이지만, 연구자에게 더 중요한 질문은 따로 있습니다. Learning to Walk in Minutes Using Massively Parallel
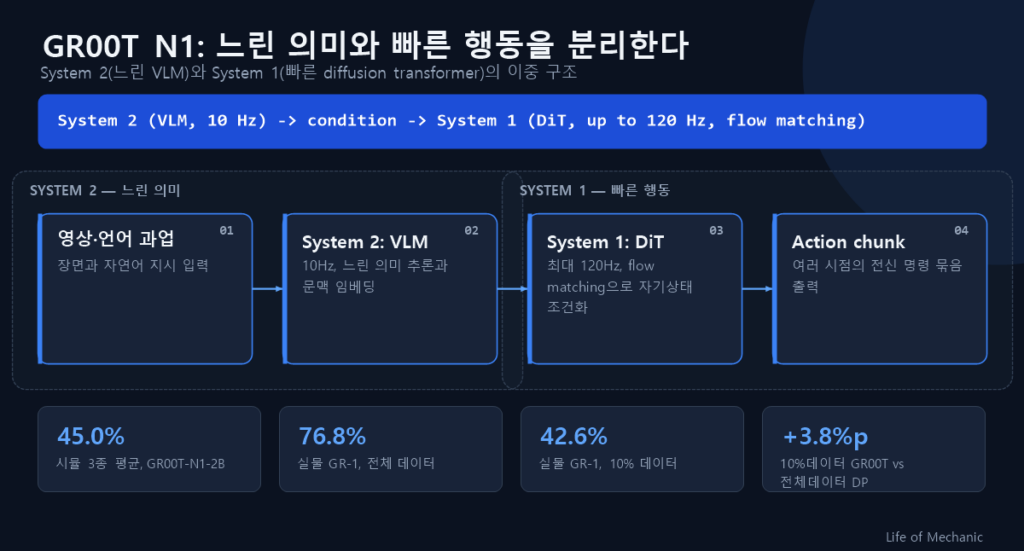
휴머노이드에게 필요한 것은 좋은 언어 이해일까요, 아니면 빠르고 안정적인 전신 동작일까요. GR00T N1은 이 질문을 둘 중 하나로 고르지 않고,
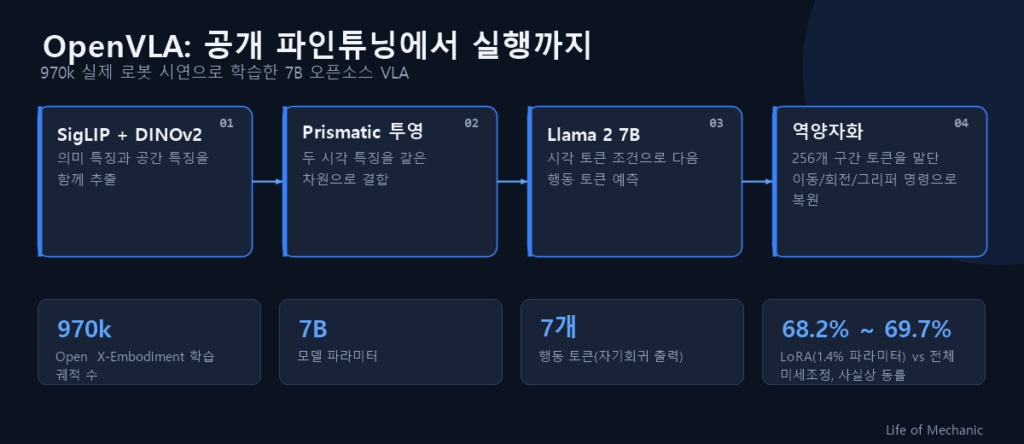
OpenVLA를 처음 보았을 때 제가 관심을 가진 이유는 ‘오픈소스 VLA’라는 이름보다, 공개된 모델을 새 로봇 과제에 맞게 적응시키려면 무엇이 필요한지
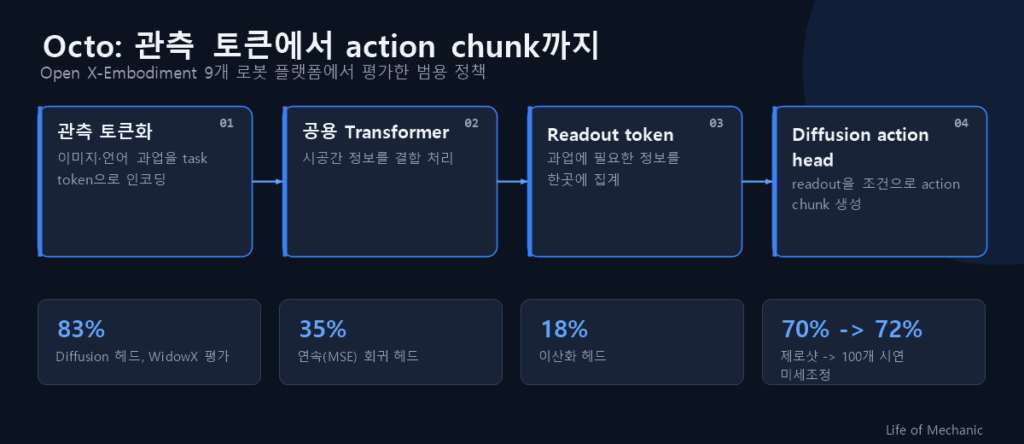
새 로봇 과제를 시작할 때, 처음부터 정책을 학습해야 할까요. Octo는 다양한 로봇 시연으로 미리 학습한 정책을 새로운 관측과 행동 공간에
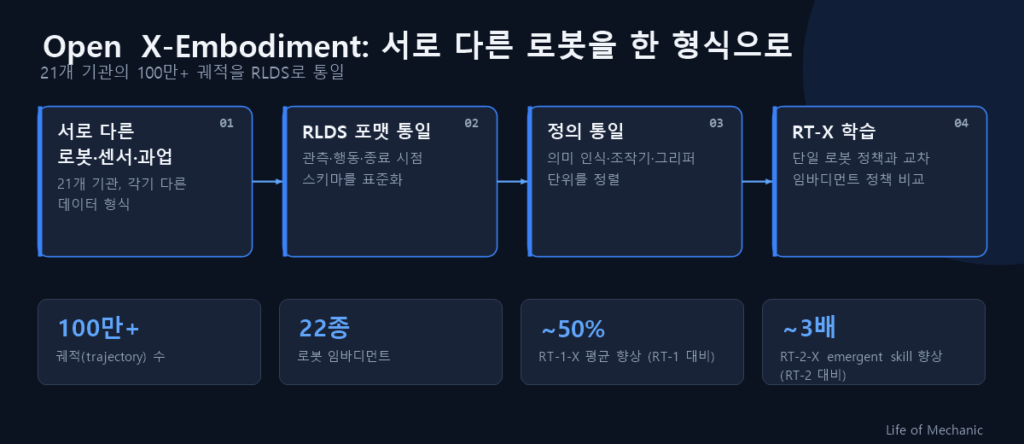
로봇 데이터가 많아지면 서로 다른 로봇의 시연을 한데 모아도 될까요. 사람에게는 같은 ‘집기’처럼 보여도, 카메라 위치와 관절 구조, 행동 단위가
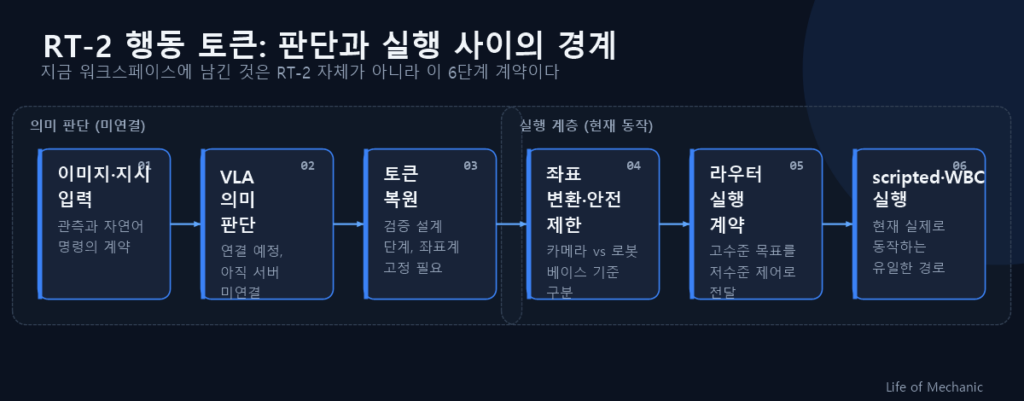
RT-2를 읽으면서 제게 가장 오래 남은 것은 웹 지식이 로봇 행동으로 옮겨간다는 큰 주장보다, 그 사이에 행동을 토큰으로 바꾸는 얇은
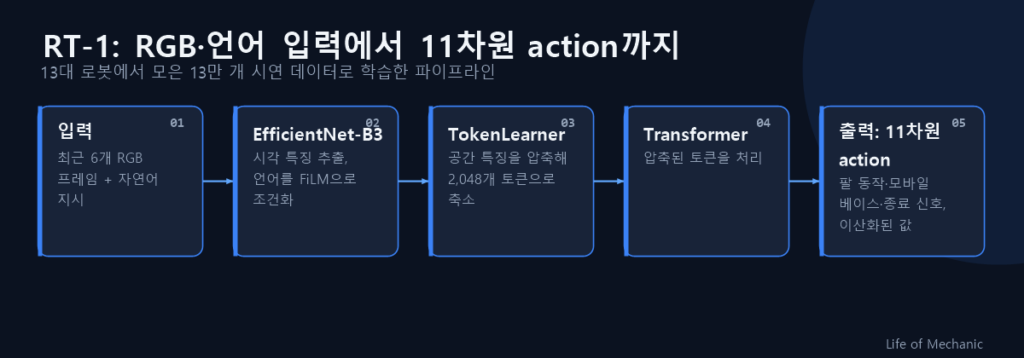
RT-1은 35M 규모의 Transformer 정책보다도 13대의 로봇에서 13만 개 이상 쌓은 시연과 태스크 다양성으로 더 자주 기억됩니다. 현재 제 데이터